Ya están las puntuaciones oficiales de Claude Haiku 5.5. Puestas junto a Haiku 4.5, GPT-6 Luna y Sonnet 5.5, la pregunta que de verdad merece discutirse no es si ganó cada partida. Es hasta dónde empujó el límite de lo que puede hacer un modelo pequeño.
El modelo que publicó Anthropic es Claude Haiku 5.5. El ID del modelo es claude-haiku-5-5. La fecha de publicación es el 7 de octubre de 2026.
Anthropic lo sitúa sin rodeos. Es su modelo pequeño más rápido, más barato y más capaz hasta ahora, pensado para tareas de mucho volumen, baja latencia y coste sensible. Los usos típicos que nombra son la clasificación, la extracción de información, el resumen, la compactación de contexto, las consultas a bases de datos, el uso del navegador y el papel de subagente de Sonnet 5.5 o de Opus 5.5.
Este artículo usa solo los benchmarks, los precios y la información de producto que publicó Anthropic. No convierte ese boletín en un experimento independiente. Lo que hay que hacer es devolver las cifras al tipo de tarea, al precio y al lugar del modelo, y ver dónde es fuerte Haiku 5.5 y qué trabajo todavía no se le puede encargar.
La conclusión primero: Haiku 5.5 ya cruzó la línea en la que un modelo pequeño solo hace trabajo simple
Juntas, las cifras oficiales dibujan un contorno claro:
- Frente a Haiku 4.5, sube con claridad en cada benchmark principal que publicó Anthropic;
- En los ítems que el anuncio informa a la vez, supera a GPT-6 Luna;
- En trabajo de conocimiento, uso del ordenador y parte del razonamiento, ya está cerca de Sonnet 5.5;
- En programación de agente compleja, sigue claramente por detrás de Sonnet 5.5;
- Donde más compite es en la suma de velocidad, precio y una capacidad de terminar tareas que ya es bastante alta.
Haiku 5.5 se entiende mejor como una capa de ejecución cuya capacidad dio un salto, no como un modelo que sustituye a Sonnet 5.5 en todo.
Comparación horizontal de los benchmarks oficiales
Anthropic publicó estas cifras en la página de lanzamiento de Haiku 5.5. Los valores de GPT-6 Luna y de Sonnet 5.5 salen de la misma tabla de contraste.
| Prueba | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: trabajo de conocimiento | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: trabajo de conocimiento | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: uso del ordenador | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam: sin herramientas | 45.9% | 10.2% | — | 56.9% |
| Humanity's Last Exam: con herramientas | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0: programación de agente | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1: programación de agente | 46.4% | — | 42.4% | 52.1% |
| Chartography: razonamiento visual | 46.4% | 6.4% | 29.1% | 61.6% |
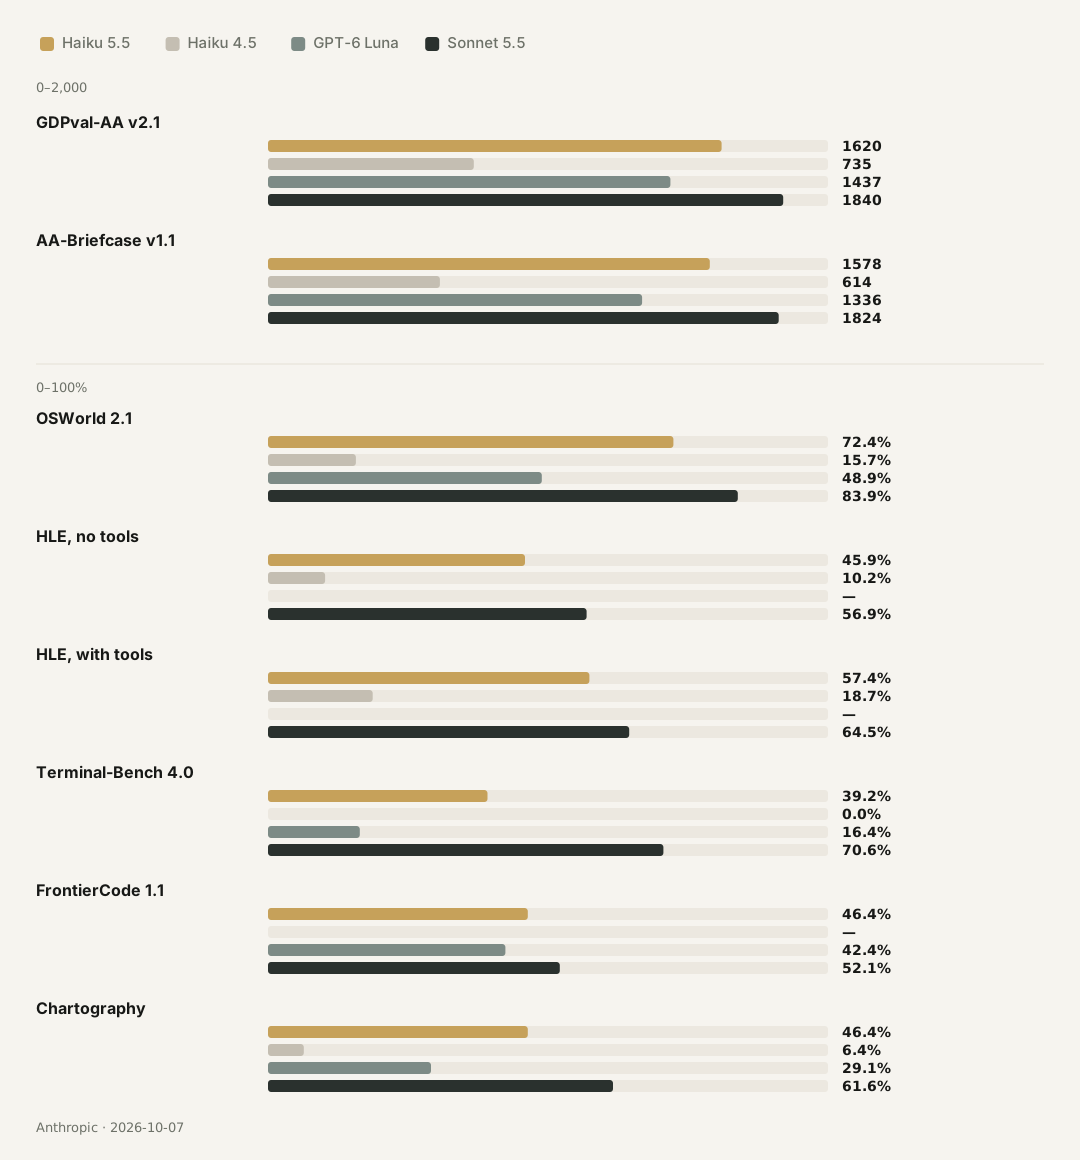
Estas cifras no se comprimen bien en “Haiku 5.5 queda segundo”. Cada benchmark mide una capacidad distinta. El trabajo de conocimiento mira la calidad de lo entregado. OSWorld mira si el modelo puede manejar un ordenador real. Terminal-Bench mira si puede terminar tareas profesionales de varios pasos en la línea de comandos. Humanity's Last Exam se inclina hacia el conocimiento difícil y el razonamiento.
Que el mismo modelo rinda de forma muy distinta según la tarea forma parte del resultado.
El primer cambio: Haiku 5.5 dejó atrás a la generación anterior
Si solo se miran Haiku 4.5 y Haiku 5.5, el tamaño de la mejora es muy claro.
GDPval-AA v2.1 pasa de 735 a 1620, cerca de 2.2 veces la generación anterior. AA-Briefcase pasa de 614 a 1578, cerca de 2.6 veces. OSWorld pasa de 15.7% a 72.4%. Terminal-Bench pasa de 0.0% a 39.2%.
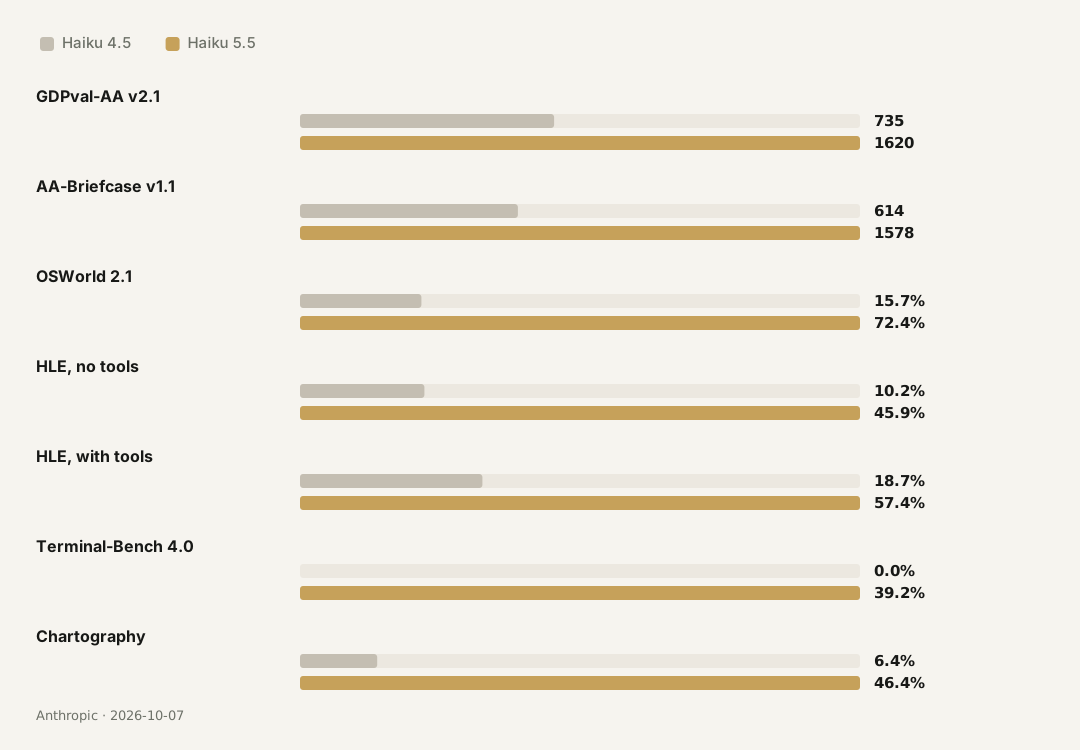
No es un cambio del tipo “la redacción quedó más bonita”. OSWorld y Terminal-Bench implican cadenas largas de acciones. El modelo tiene que entender la tarea, llamar herramientas, tratar la respuesta y seguir después de equivocarse a mitad de camino. La subida en esas pruebas dice que Haiku 5.5 ya no es solo un modelo para clasificar textos cortos y resumir.
OSWorld es el caso más marcado. Entre el 15.7% de Haiku 4.5 y el 72.4% de Haiku 5.5 hay un corte claro. Incluso teniendo en cuenta la configuración del benchmark, el subconjunto offline y las condiciones oficiales de la prueba, el resultado sigue diciendo que el uso del ordenador cambió de generación.
Una subida en un ítem no permite deducir que todas las tareas de producción subieron en la misma proporción. Un benchmark mide un conjunto concreto de tareas. Un producto real también depende de la longitud del contexto, de cómo se definen las herramientas, de la recuperación ante errores, de la latencia de red y de la calidad de los datos del negocio.
El segundo cambio: ya entró en el intervalo de GPT-6 Luna
En los ítems que publicó Anthropic, Haiku 5.5 queda por encima de GPT-6 Luna:
- GDPval-AA: 1620 frente a 1437;
- AA-Briefcase: 1578 frente a 1336;
- OSWorld: 72.4% frente a 48.9%;
- Terminal-Bench: 39.2% frente a 16.4%;
- Chartography: 46.4% frente a 29.1%.
Este grupo basta para un juicio prudente. Haiku 5.5 ya entró en el intervalo en el que compiten los modelos generales de buena relación entre capacidad y precio.
Hay que conservar dos límites.
Primero, las cifras salen de la página de lanzamiento de Anthropic. Las empresas no ejecutan un benchmark, no configuran el modelo, no conectan las herramientas ni calculan la estadística de la misma manera. Sirven para ver el lugar de capacidad que muestra quien hace el producto. No sirven como un ranking de terceros del todo independiente y del todo simétrico.
Segundo, “por encima de GPT-6 Luna” no significa “mejor que GPT-6 Luna en todas las tareas”. La tabla oficial solo sostiene la comparación de los ítems publicados. No permite extender el resultado a tareas que no se probaron.
Una forma razonable de decirlo es:
En las comparaciones que publicó Anthropic, Haiku 5.5 obtuvo puntuaciones más altas que GPT-6 Luna. Elegir un modelo en la práctica sigue dependiendo del tipo de tarea, del precio, de la velocidad y de la forma de llamarlo.
El tercer cambio: está cerca de Sonnet, y los niveles del modelo siguen ahí
La distancia entre Haiku 5.5 y Sonnet 5.5 también informa.
En GDPval-AA v2.1, Haiku 5.5 saca 1620 y Sonnet 5.5 saca 1840. En AA-Briefcase las dos puntuaciones son 1578 y 1824. En OSWorld, Haiku 5.5 está en 72.4% y Sonnet 5.5 en 83.9%. En Humanity's Last Exam sin herramientas las cifras son 45.9% y 56.9%. Con herramientas, 57.4% y 64.5%.
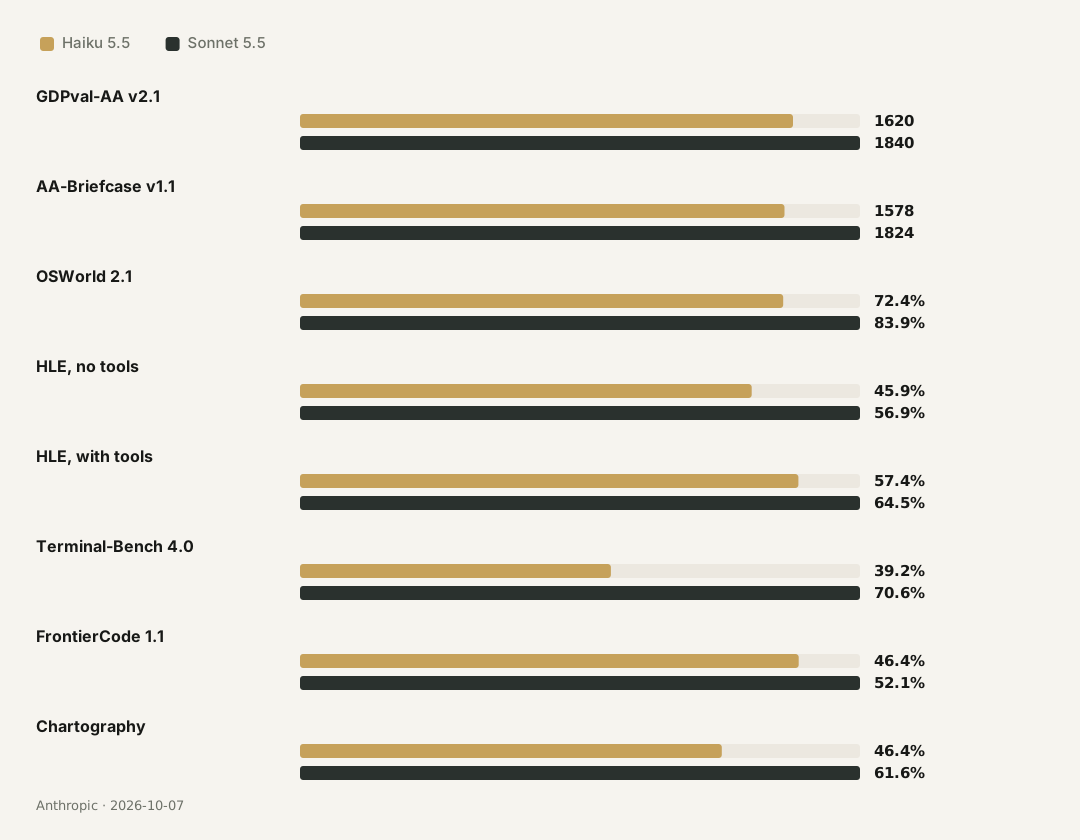
Esas distancias dicen que Haiku 5.5 ya puede encargarse de una parte considerable del trabajo de conocimiento y del uso del ordenador. Cuando la complejidad sigue subiendo, Sonnet 5.5 conserva una ventaja estable.
La distancia de Terminal-Bench es la que más merece atención. Haiku 5.5 está en 39.2% y Sonnet 5.5 en 70.6%. Esa prueba pide al modelo terminar tareas profesionales complejas y de varios pasos en un entorno de línea de comandos, más cerca de la programación de agente de largo recorrido. Haiku 5.5 queda muy por encima de Haiku 4.5, y todavía lejos de Sonnet 5.5.
Eso deja un límite claro para elegir modelo:
- Para el trabajo local, repetido y verificable, Haiku 5.5 resulta atractivo;
- Para las tareas que piden planificación larga, cambios en varios archivos y una recuperación continua de errores, Sonnet 5.5 sigue encajando mejor;
- Que Haiku 5.5 se acerque a Sonnet en algunos benchmarks no autoriza a tratarlos como dos precios del mismo modelo.
Después de la bajada de precio, lo que hay que mirar es el coste por tarea
El precio de Haiku 5.5 es el otro punto de este lanzamiento.
Para una petición de hasta 100K tokens, el precio de entrada de Haiku 5.5 es 0.10 dólares por millón de tokens y el de salida es 0.50 dólares. Por encima de 100K tokens, los precios pasan a 0.50 y 2.50 dólares. Anthropic dice que el coste medio de ejecutar Haiku 5.5 es cerca de un 75% más bajo que el de Haiku 4.5.
| Tamaño de la petición | Precio de entrada | Precio de salida | Cache read |
|---|---|---|---|
| Hasta 100K tokens | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| Más de 100K tokens | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
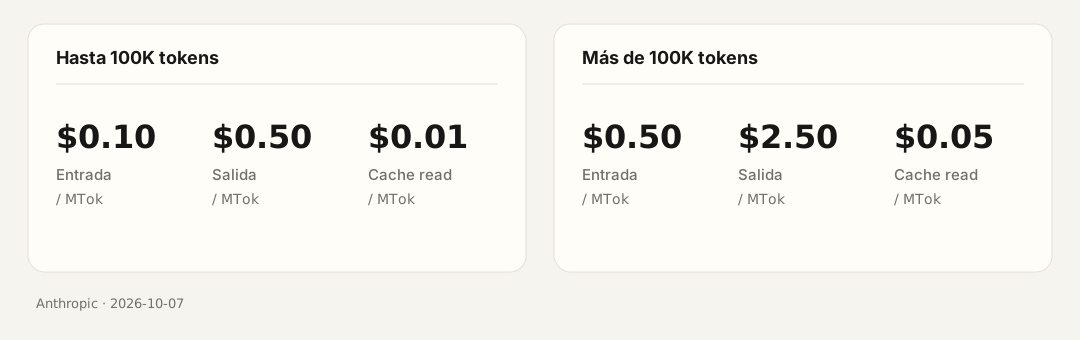
A simple vista, la entrada por debajo de 100K baja de 1 dólar en Haiku 4.5 a 0.10 dólares, y la salida baja de 5 dólares a 0.50 dólares: el precio unitario de lista cae un 90%. Anthropic también explica que Haiku 5.5 usa un tokenizer nuevo, así que la misma tarea puede consumir un poco más de tokens. La bajada del coste medio de ejecución es de cerca del 75%, no de un 90% plano.
En un producto real todavía hay que mirar tres cosas:
- Con qué probabilidad termina Haiku 5.5 la tarea en una sola llamada;
- Cuántos reintentos hace falta tras un fallo;
- Si todavía hay que llamar a Sonnet o a Opus para revisar y corregir.
La medida más útil es:
Coste por tarea completada con éxito
= gasto total para terminar el trabajo ÷ número de tareas terminadas con éxito
Supón que una llamada a Haiku 5.5 cuesta la décima parte de una llamada a Sonnet, pero esa clase de tarea necesita dos reintentos, o el 20% de las peticiones acaba escalándose a Sonnet. El ahorro real queda por debajo de la distancia que muestra la tabla de precios.
Al revés: si una tarea se puede verificar sola, y un fallo se puede reintentar a bajo coste, Haiku 5.5 puede tener una ventaja económica muy fuerte.
Pasados los 100K tokens, el límite de precio cambia la arquitectura del producto
En la tabla de precios de Haiku 5.5, 100K tokens es un corte importante.
En peticiones cortas y de longitud media, el precio bajo se nota enseguida. En repositorios de código, conversaciones largas, bases de conocimiento de empresa y grandes conjuntos de documentos, el producto se acercará a menudo a 100K tokens o los pasará. Meter todo el contenido en una sola petición no tiene por qué ser el mejor diseño.
Una arquitectura más razonable suele incluir esto:
- Usar primero Haiku 5.5 para clasificar documentos y filtrar por relevancia;
- Comprimir el material original en un resumen estructurado;
- Entregar al modelo más grande solo los fragmentos que importan para la pregunta actual;
- Usar caché para el contexto que se repite;
- Guardar la conversación de varios turnos como un estado que se pueda recuperar, en lugar de reenviar el hilo completo cada vez.
Aquí es también donde Haiku 5.5 se ata con más fuerza a la arquitectura de agentes. No es solo un modelo barato para responder. Puede ser la capa de base para compactar contexto, ordenar resultados de recuperación y ejecutar subtareas.
El ajuste de effort vuelve poco útil una clasificación estática
Haiku 5.5 es el primer modelo de la serie Haiku con un effort ajustable. Con el mismo modelo, el sistema puede cambiar cuánto razonamiento invierte según la importancia de la tarea, y elegir entre calidad, latencia y coste.
Eso cambia la manera de leer un benchmark. Una puntuación fija dice cómo se portó el modelo en una configuración. Una curva completa de coste y calidad dice cómo se porta con presupuestos distintos.
Las tareas simples pueden quedarse en un effort más bajo:
- Clasificación;
- Conversión de formato;
- Extracción de campos fijos;
- Reescritura de un texto corto.
Las tareas de complejidad media pueden subir el effort:
- Resumen de un texto largo;
- Integración de información entre párrafos;
- Operaciones de varios pasos en el navegador;
- Tareas que primero tienen que juzgar y después llamar a una herramienta.
Subir el effort en una tarea compleja no sustituye por sí solo a Sonnet. La distancia en Terminal-Bench es el recordatorio. Un presupuesto de razonamiento puede mejorar el resultado. No elimina por sí solo la distancia del modelo en planificación de largo recorrido, recuperación de errores y cadenas de herramientas complicadas.
Convertir estas cifras en un enrutado práctico
Con las puntuaciones oficiales y el lugar del producto, sale una primera tabla de enrutado bastante prudente:
| Tipo de tarea | Elección por defecto | Motivo |
|---|---|---|
| Clasificación, enrutado, etiquetas | Haiku 5.5 | Mucho volumen, una salida de forma clara y fácil de verificar |
| Extracción de campos y ordenación de datos | Haiku 5.5 | El límite de la tarea es explícito y el trabajo admite mucha concurrencia |
| Resúmenes y compactación de contexto | Haiku 5.5 | La ventaja de precio y de velocidad es clara |
| Uso del navegador en un paso o en un flujo corto | Haiku 5.5 | La puntuación de OSWorld muestra una mejora clara en el uso del ordenador |
| Explicación de código y arreglos pequeños | Haiku 5.5 o Sonnet 5.5 | Depende de si hay pruebas automáticas y de lo que cuesta un error |
| Cambios de código en varios archivos | Sonnet 5.5 | Terminal-Bench sigue mostrando una distancia clara |
| Programación de agente de largo recorrido | Sonnet 5.5 u Opus 5.5 | Hace falta planificación sostenida y recuperación de errores |
| Revisión final y juicios de alto riesgo | Sonnet 5.5 u Opus 5.5 | Hacen falta más estabilidad y más capacidad de razonamiento |
Esta tabla no es una definición permanente del “límite de Haiku 5.5”. Es una primera sugerencia de uso, obtenida al poner juntos el benchmark oficial, el precio y el lugar del producto.
En un despliegue real todavía hay que comprobar el propio conjunto de tareas:
- Si la salida cumple el estándar del negocio;
- Si un fallo se puede descubrir solo;
- Si reintentar después de un fallo sale a cuenta;
- Si la menor latencia mejora de verdad la experiencia del producto;
- Si el precio bajo queda anulado por un coste mayor de revisión humana.
Cómo leer un benchmark oficial
Ante el benchmark de un modelo nuevo, hay dos errores fáciles.
El primero es comprimir todos los ítems en un puesto general. El trabajo de conocimiento, el uso del ordenador, el razonamiento abierto y la programación de agente son capacidades distintas. Una columna de puntuación total no las sustituye.
El segundo es tomar la puntuación oficial como una conclusión de producción. El benchmark oficial tiene una configuración de prueba explícita. Un producto real también recibe el efecto del prompt, de las herramientas, del contexto, de la red, de los datos y del mecanismo de recuperación ante errores.
Una lectura más fiable tiene tres pasos.
Primero, el salto de capacidad
¿Haiku 5.5 mejora de forma estable respecto de Haiku 4.5? En la tabla oficial, sí. El cambio se ve sobre todo en OSWorld, en el trabajo de conocimiento y en los ítems de programación de agente.
Después, el límite de la tarea
¿Ya alcanzó al modelo más grande? La respuesta depende de la tarea. En parte del trabajo de conocimiento y del uso del ordenador ya está cerca de Sonnet. En la programación de agente compleja la distancia sigue siendo clara.
Al final, el coste por unidad
Si merece usarse depende del resultado conjunto de calidad, precio, latencia y recuperación ante fallos. La puntuación de un benchmark, sola, no dice si un producto debe cambiar de modelo.
El juicio final: la fuerza de Haiku 5.5 está en que se puede usar mucho
Si la única pregunta es si Haiku 5.5 supera a Sonnet 5.5, la respuesta es simple: no. Los datos oficiales ya muestran que Sonnet 5.5 sigue por delante en trabajo de conocimiento, uso del ordenador, razonamiento general y programación de agente.
Si la única pregunta es si Haiku 5.5 es más fuerte que Haiku 4.5, la respuesta es igual de clara: sí, y la mejora es grande.
La pregunta que de verdad merece discutirse es la tercera. ¿Ya es lo bastante fuerte como para encargarse de una gran cantidad de trabajo local dentro de sistemas de producción?
Por las puntuaciones oficiales y por el precio, lo más probable es que la respuesta también sea sí.
El valor de Haiku 5.5 está en que un grupo de tareas que antes pedían un modelo mediano, y que no justificaban el precio de un modelo mediano, ya puede vivir en una capa de ejecución más rápida y más barata. La clasificación, la extracción, el resumen, la compactación de contexto, los flujos cortos en el navegador y las subtareas de un agente pueden ser su escenario principal.
No es un boletín nuevo de “campeón del ranking de modelos”. Es un boletín sobre cómo se reparte el trabajo:
- Haiku 4.5 demostró que un modelo pequeño puede hacer trabajo simple a bajo precio;
- Haiku 5.5 empieza a demostrar que un modelo pequeño también puede encargarse de una parte del trabajo que pide herramientas y varios pasos;
- Sonnet 5.5 sigue con la planificación, la programación y el trabajo de conocimiento más complejos;
- Opus 5.5 sigue con las tareas de largo recorrido, de alta dificultad y de alto coste cuando hay un error.
El centro de la evaluación de modelos también se está moviendo: de “quién tiene la puntuación más alta” a “a quién merece la pena llamar en cada tarea”.