Lo interesante de Kimi K3.1 Pro es su capacidad para sostener una tarea larga: entender un proyecto, modificar código, utilizar herramientas y corregir el rumbo cuando algo falla. Una primera pantalla atractiva representa solo una parte del trabajo. Tras la décima revisión, ¿siguen funcionando las prestaciones originales y cumple el resultado los criterios de aceptación?
Este artículo trata de Kimi K3.1 Pro y Kimi K3.1 Pro Highspeed. Las fuentes se comprobaron el 23 de octubre de 2026. Las cifras proceden de material oficial. Folkbench no llamó a estos modelos ni repitió sus pruebas para este artículo, y no les asigna una puntuación independiente.
Identificar primero el modelo
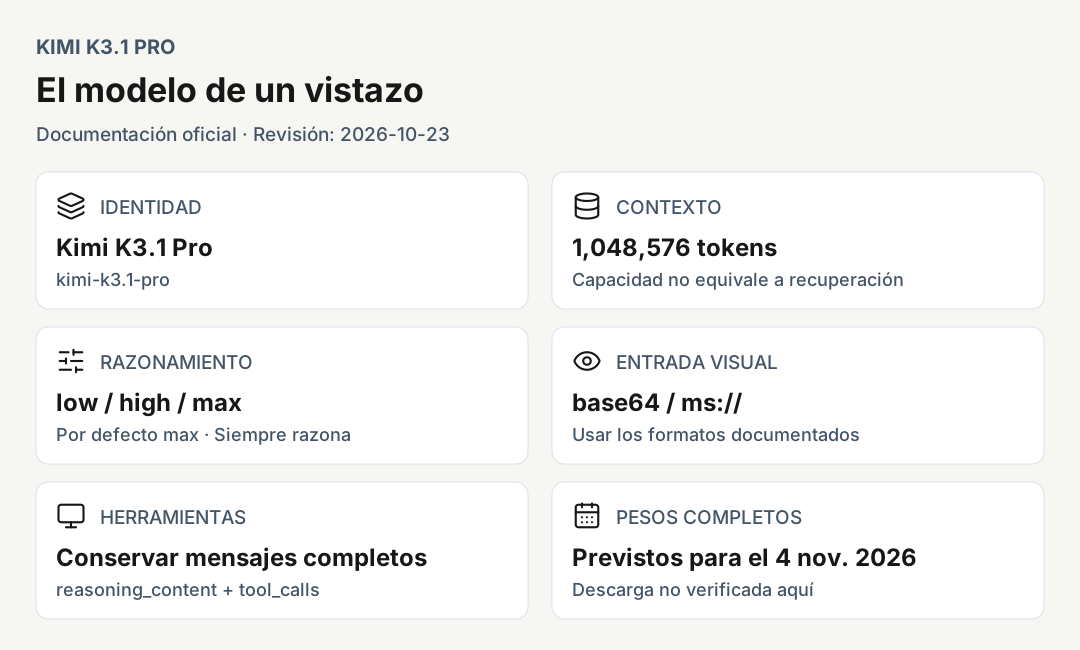
| Aspecto | Documentación comprobada |
|---|---|
| ID de API estándar | kimi-k3.1-pro |
| ID de API Highspeed | kimi-k3.1-pro-highspeed |
| Posicionamiento oficial | Modelo insignia para programación, creación 3D e investigación financiera |
| Escala declarada | Clase 3T; no determina los parámetros activos por petición |
| Ventana de contexto | 1,048,576 tokens |
| Esfuerzo de razonamiento | low, high, max; por defecto, max |
| Visión y herramientas | Entrada visual, llamadas a herramientas y transmisión progresiva |
| Pesos | El artículo técnico prevé los pesos completos para el 4 de noviembre de 2026 como máximo; aquí no se verificó su descarga |
La identidad y el posicionamiento aparecen en la lista de modelos; el contexto exacto, en la documentación de facturación; y las funciones de la interfaz, en la guía de inicio. El artículo técnico describe un entrenamiento posterior sobre K3 y el plan de publicación de pesos. El número de versión no demuestra un cambio de arquitectura, ni un plan de publicación demuestra que el despliegue local ya esté disponible.
Dos pruebas para dos preguntas distintas
Estas cifras son las publicadas en el artículo técnico de Kimi. Las columnas de competidores también proceden de esa página, no de un experimento de Folkbench con un entorno común.
| Evaluación | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% |
| BenchCAD, con herramientas, Voxel IoU | 92.7% | 96.2% | 95.9% |
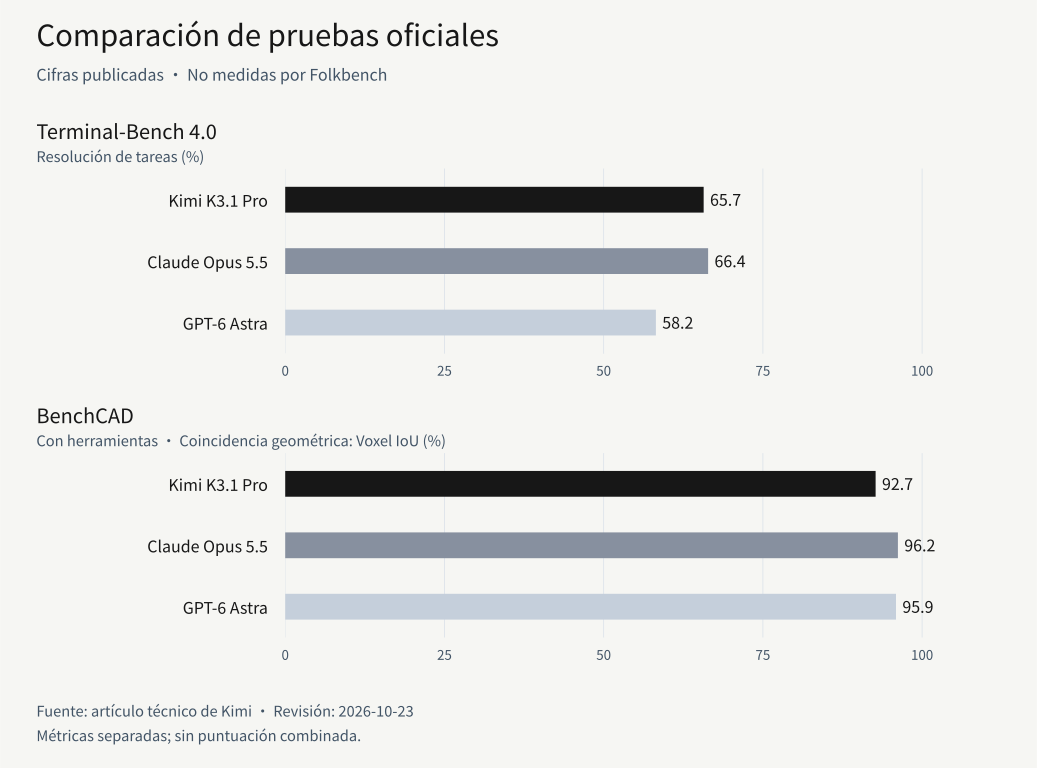
Las notas especifican esfuerzo max por defecto. Kimi utiliza Claude Code en Terminal-Bench; los resultados de competidores se recopilan de publicaciones o clasificaciones. BenchCAD evalúa los modelos abiertos sobre un subconjunto de 1,000 casos y también usa Claude Code en el modo con herramientas. Estas condiciones deben acompañar a las puntuaciones.
Programación: una puntuación cercana todavía necesita aceptación por proyecto
Entre 65.7% y 66.4% hay 0.7 puntos porcentuales. Son resultados cercanos dentro de esta tabla. Sin presupuestos equivalentes, número de repeticiones e intervalos de incertidumbre, no basta para afirmar que las capacidades sean iguales. Superar a otro modelo en una prueba tampoco demuestra superioridad en todas las tareas de programación.
La recuperación ante errores importa en proyectos reales. Una petición puede exigir cambiar una interfaz, actualizar sus consumidores y conservar compatibilidad sin romper el comportamiento existente. La cantidad de código generada al primer intento dice poco sobre esas obligaciones. El modelo debe entender una comprobación fallida, en lugar de borrar una aserción, debilitar una condición o eliminar una función para conseguir un aprobado.
Antes de migrar, conviene repetir una tarea histórica ya resuelta y con criterios claros. Fija la revisión del repositorio y los requisitos, deja trabajar a cada candidato y comprueba pruebas, alcance de cambios y reparación manual. Ese registro permite decidir mejor que una demostración vistosa. Es un ejercicio de aceptación propuesto, no un experimento realizado para este artículo.
3D: la coincidencia geométrica es solo parte de la entrega
La métrica de BenchCAD aquí es Voxel IoU. Un 92.7% no significa que se resuelva el 92.7% de las tareas ni expresa una nota artística. Geometría, materiales, iluminación, animación, editabilidad y tolerancias de fabricación necesitan comprobaciones distintas.
En una escena de Three.js hay que revisar interacción, rendimiento en el dispositivo y carga de recursos. En una pieza editable, dimensiones, comportamiento al cambiar parámetros y archivos exportados. Una imagen convincente desde un ángulo puede ocultar superficies ausentes, geometría que se cruza o topología inutilizable.
Nuestra valoración editorial es que estos resultados oficiales justifican considerar K3.1 Pro para programación prolongada y modelado mediante código. Su capacidad para sustituir una solución existente debe decidirse con los entregables del proyecto concreto.
Un millón de tokens responde a una pregunta de capacidad
Los archivos que caben en 1,048,576 tokens dependen del contenido y de su tokenización. No equivalen a un número fijo de palabras o líneas de código. La capacidad tampoco garantiza encontrar la evidencia correcta, conservar todas las restricciones o mantener el objetivo tras muchas llamadas a herramientas.
Enviar un repositorio entero puede introducir archivos generados, documentación obsoleta e instrucciones contradictorias. Especifica la revisión vigente, los archivos relevantes, el comportamiento que debe conservarse y cómo ejecutar la aceptación. Un contexto útil aporta más que aumentar su tamaño indiscriminadamente.
Además existe un coste recurrente. La documentación de modelos de razonamiento exige conservar el razonamiento histórico del asistente; este sigue ocupando contexto y participa en la facturación. Una respuesta visible corta puede acompañar un consumo mucho mayor.
La configuración de API cambia la experiencia
La guía de esfuerzo indica que K3.1 Pro siempre razona y utiliza max por defecto. Elegir low reduce el esfuerzo; no desactiva el razonamiento. Iguala este parámetro antes de comparar latencias, porque una diferencia aparente de velocidad puede reflejar presupuestos distintos.
Comprueba tres aspectos durante una migración:
- Utiliza
reasoning_efforten el nivel superior, sin trasladar la configuraciónthinkingde K2. - Conserva los mensajes completos del asistente en los ciclos de herramientas, incluidos
reasoning_contentytool_calls. Guardar solo el texto final elimina historial requerido. - Sigue la guía de inicio para visión: usa base64 o referencias
ms://, sin asumir que se aceptan URL públicas arbitrarias de imágenes.
Un servicio intermediario añade preguntas: ¿conserva los campos, trunca respuestas, cambia el nombre del modelo u omite consumo? Obtener una respuesta de texto no demuestra que funcione correctamente el ciclo de herramientas del agente.
El coste empieza por la tarea completa
La página oficial de precios y su versión Markdown no devolvieron una fila completa y verificable de tarifas de K3.1 Pro durante esta comprobación. Por ello no publicamos tarifas en dólares ni las sustituimos por precios de K3 o de intermediarios. Esto no demuestra que los precios oficiales no estén publicados; describe lo que pudo verificar este artículo.
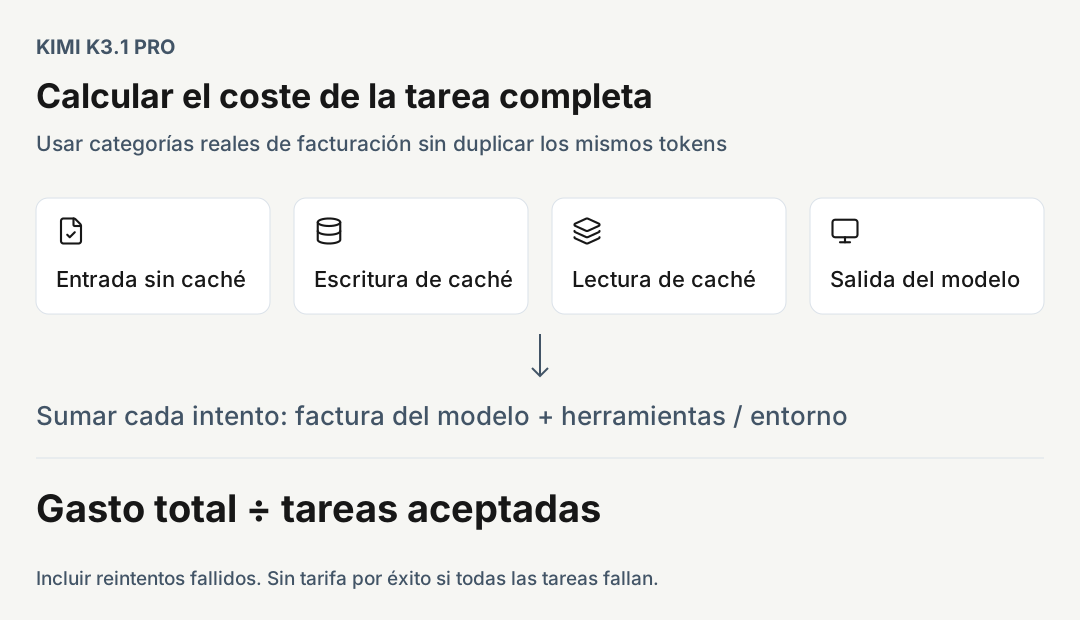
Sí está documentada la estructura de facturación: la API se cobra por uso, aparte de la membresía de Kimi y Kimi Code; las escrituras de caché varían por TTL, y las lecturas con acierto y la entrada sin caché tienen categorías distintas. La guía de inicio describe precios sin tramos por longitud de contexto. La guía de caché permite comprobar reutilización y conservación.
Separa fallos de caché, escrituras, lecturas y salida generada al evaluar tareas largas. Herramientas externas, entornos de ejecución y reintentos fallidos pueden añadir gasto. Sigue las categorías reales de la factura para no contar los mismos tokens dos veces.
Una medida útil para compras es el gasto total del lote dividido por las tareas aceptadas. Los intentos fallidos permanecen en el numerador; si todo falla, no existe un precio por tarea exitosa que publicar. Es un método de comparación propuesto, no un resultado medido por Folkbench.
La lista oficial describe Highspeed con la misma capacidad y aproximadamente 2–3 veces la velocidad. Es una afirmación del proveedor, no una medición del flujo completo. Si generar ocupa la mitad del tiempo, reducir esa mitad a un tercio lleva el total de 1 a aproximadamente 0.67: unas 1.5 veces la velocidad global. Este cálculo hipotético ilustra un cuello de botella, no una latencia observada de Kimi.
Por dónde empezar a evaluarlo
| Trabajo | Capacidad que observar | Resultado de aceptación útil |
|---|---|---|
| Cambios entre archivos de código | Restricciones, herramientas y recuperación | Pruebas superadas, funciones conservadas y reparación manual aceptable |
| 3D mediante código e interacción web | Relaciones espaciales, scripts e iteración | Archivos editables, interacción funcional y rendimiento suficiente |
| Investigación documental y hojas de cálculo | Recuperación y contraste de evidencia | Citas trazables, unidades coherentes y cálculos reproducibles |
| Extracción sencilla o clasificación frecuente | Latencia y coste por tarea | Mejor gasto con el mismo umbral de calidad |
Los tres primeros encajan con su posicionamiento, pero este no garantiza calidad. En investigación, una redacción fluida y muchas citas no sustituyen comprobar si cada fuente respalda la afirmación, si coinciden fechas y unidades y si las fórmulas pueden recalcularse. Para clasificar datos sencillos, un modelo insignia con max por defecto quizá no sea económico.
La valoración de Folkbench
El material oficial ofrece motivos para evaluar K3.1 Pro seriamente: sus resultados en programación y modelado mediante código están cerca de competidores fuertes. Su valor práctico depende de convertir esas capacidades en entregables aceptados con tus entradas, herramientas y presupuesto.
Este artículo carece de registros propios de llamadas, repeticiones, distribuciones de fallos y tarifas verificadas. Por tanto, no ofrece una nota global ni afirma que sea la mejor relación calidad-precio. Algunos pasajes de pruebas en la guía de inicio todavía contienen marcadores provisionales y difieren de la versión del artículo técnico. Las dos comparaciones anteriores utilizan este último de forma coherente, sin mezclar versiones.
Para flujos de código, consulta la [guía de evaluación de ingeniería de software de Folkbench](/es/blog/ai-api-relay-software-engineering-evaluation-guide). También puedes leer sobre [Claude Opus 5.5](/es/blog/claude-opus-5-5-review-pricing) y [GPT-6.1 Sol](/es/blog/gpt-6-1-sol-review-pricing). Sol no es el GPT-6 Astra de la tabla; sus nombres y puntuaciones no son intercambiables.