第一篇讨论“别轻信一张截图”。这一篇继续追问:为什么连一个分数,也不能轻信?
假设现在有三只骑自行车的鹈鹕。第一只画得非常精致:羽毛有层次,车轮有高光,背景甚至带着落日。但仔细一看,两只脚都悬在踏板上方。第二只像几笔画出来的简笔画,没有阴影,也没有漂亮的配色。不过车架连接合理,身体坐在车座上,脚确实踩着踏板。第三只的静态截图挑不出什么问题。一按播放,脚却开始沿着自己的轨迹飘,踏板转踏板的,鹈鹕蹬鹈鹕的。谁应该得最高分?如果答案是“第一只最漂亮”,我们在评审美;如果答案是“第二只最可靠”,我们在评任务完成度;如果只看截图,第三只可能连错误都不会被发现。
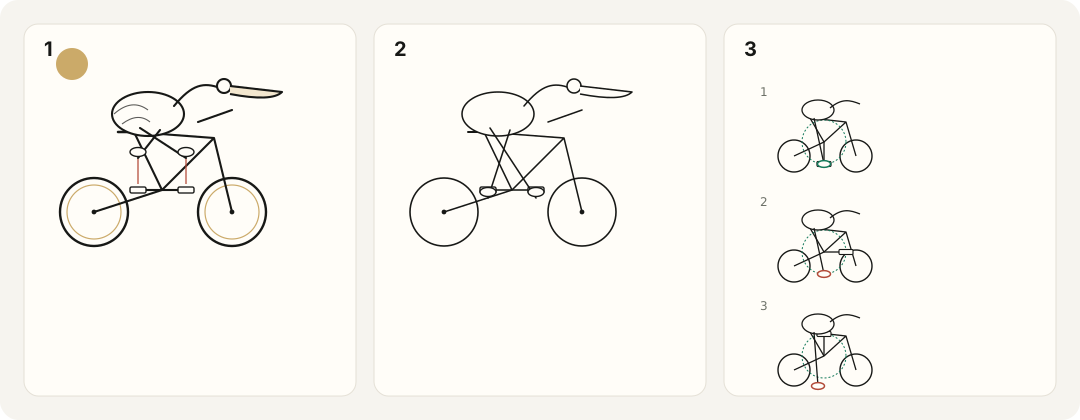
上一篇文章谈到,要判断模型是否真的变差,不能只挑一次输出,而应在可比条件下重复测试。但那里面藏着一个尚未解决的前提:我们已经知道,什么叫合格。如果这个前提不成立,重复测试并不会自动让结论变得可信。它可能只是让一把有偏差的尺子,测得越来越稳定。这篇文章就从这里开始:怎样把“这只鹈鹕看起来还行”,变成一套有依据、能复查、也能逐步自动化的评测方法?
说明:文中的样本、数字、评分方案和配置均为方法示例,不对应真实模型排名,也不表示 Folkbench 已经实现这些流程。引用研究用于说明相关方法与风险,不代表本文方案已经通过实验验证。
一、先写清楚题目,再讨论怎么打分
鹈鹕测试很有吸引力,因为它把错误画在了脸上:多出来的腿、接不上的车架、踩不到的踏板,都不太容易被漂亮话掩盖。但它究竟在测什么,需要说得更具体。让模型“用 SVG 画一只骑自行车的鹈鹕”,直接观察到的是:它能否把文字要求转成代码,并通过这些代码生成符合要求的图形。单靠这个结果,不能确定它内部采用了什么空间表征,也不能把“这道题做得好”直接等同于“拥有完整的空间理解能力”。如果允许模型先渲染、看图,再反复修改,测到的又是带反馈的工作流,而不再只是一次代码生成。两者都有价值,但不应该混在同一个首答榜单里。更实际的问题是,题目没有写出来的要求,不应该在评分时突然出现。
原题只有一句“画一只骑车的鹈鹕”,我们就不该事后要求它必须使用标准公路车、两个车轮完全等大、两只翅膀都扶着车把,或者所有零件都清晰露在外面。合理的透视、遮挡和卡通化,本来就是开放式绘画的一部分。我的建议是,把测试分成两种。一种保留开放题,观察模型如何理解和表达“骑车”。评分只抓清楚、必要的要求,承认边界样本存在争议。另一种是约束题,提前规定视角、可见关系、输出格式,以及允许使用的技术。例如:画面以侧面为主,允许轻微错位以展示两只脚;脚和各自踏板的接触处必须可见;只交付自包含 SVG;不使用外部图片或脚本。
约束题会改变原题,但这不是缺点。只要明确标注题目版本,它能让我们更具体地排查:模型究竟是没有满足视角要求、没有表达清楚接触关系,还是连自行车结构都画错了。关键不在于哪一种更“正宗”,而在于:开放题按开放题评,约束题按约束题评,不能拿一个模糊题目,配上一套事后发明的严格标准。
二、别急着给总分,先把“骑车”拆开
“整体不错,给 8 分。”这是最方便的评分方式,也是最难复查的评分方式。8 分究竟是因为主体正确、结构合理,还是配色讨喜?下一次遇到同样的错误,裁判会不会又给 9 分?我会先沿用四个维度,但不把它们理解为四个凭感觉填写的数字。
| 维度 | 主要检查什么 | 不应该混入什么 |
|---|---|---|
| Pelican:主体 | 是否能辨认为鹈鹕;身体与肢体是否出现明显异常;是否满足题目明确要求的可见性 | 没有要求的写实程度、羽毛细节和个人画风偏好 |
| Bicycle:自行车 | 车轮、车架、曲柄、踏板等是否构成题目要求的合理结构 | 没有要求的品牌、车型、装饰,以及特定 SVG 写法 |
| Riding:骑乘关系 | 身体是否得到合理支撑;脚是否对应踏板;题目要求的操控关系是否成立 | 仅仅“鸟在车旁边”或“两个对象都存在” |
| Animation:时序关系 | 要求的动作是否发生;接触和连接是否在动作中保持;是否出现不合理的突变或穿模 | 静态题中根本没有要求的动画;与任务无关的特效 |
对象存在,不等于关系成立。“有脚”和“有踏板”是两个对象判断;“脚踩在踏板上”是关系判断。再往前一步,“脚在踏板转动时仍然踩着它”,是跨时间的关系判断。这也是为什么只检查“鹈鹕、自行车、两个轮子是否齐全”,还远远不够。真正应该拆出来的,是身体与车座、脚与踏板、踏板与曲柄、车架与轮轴之间的联系。
这类拆解有相关研究可以借鉴。TIFA 将文本中的要求转成多个问题,再用视觉问答检查生成图像是否满足要求。它并不是一套现成的鹈鹕评分器,但说明了一个有用方向:与其只给整体印象分,不如逐条检查图像与要求是否一致。1 具体到实现,我建议每条检查先保留四种状态:pass、fail、uncertain 和 not_applicable,分别表示通过、失败、证据不足和不适用。这里最重要的是区分最后两种。静态题没有要求动画,Animation 是“不适用”;动画已经要求了,但材料不足以判断是否穿模,那是“证据不足”。前者不应扣分,后者不能自动算通过。
再把条目分成必要条件和附加质量项。必要条件决定是否合格,附加项负责描述细节与美观。存在明确的必要条件失败,就不能靠漂亮的羽毛、背景和渐变把它补回去。一份起步报告完全可以只写:主体检查通过了几项,自行车结构失败在哪一项,骑乘关系有没有未决问题,动画是否适用。它不一定需要一个精确到小数点后两位的总分。如果确实需要综合分,就提前公布适用条目、权重和缺失值处理方式,并把必要条件的失败单独展示。不同权重算出的排序,本身也值得检查是否稳健。总分是压缩后的摘要,不是取代原始证据的理由。
三、SVG DOM 能帮忙,但它不是一张自带答案的结构图
看到 SVG,最容易冒出的工程直觉是:既然它有源码,直接解析不就行了?于是规则很快写出来:找到两个 circle,说明有两个车轮;找到一个叫 foot 的元素,说明有脚;看脚和踏板的包围盒是否相交,说明踩上去了。问题是,这几步都把“代码中的表达方式”,误当成了“画面中的语义事实”。一个车轮可以用圆形元素画,也可以用路径画;两个车轮可以分别写出来,也可以通过 use 复用;同一个视觉对象,还可能由多个分组和路径组成。SVG 规范允许这些不同的表达方式,并不要求一个现实对象对应一个 DOM 节点。2
因此,数不到两个 circle,不能证明少了车轮;数到了两个,也不能证明它们真的位于合理的位置。元素叫 foot,更只是生成者给它起的名字,不是独立验证。
静态规则最适合检查可确定的约束
例如,输出能否按约定格式解析,是否包含题目禁止的外部引用,是否存在不允许的脚本,是否能够在指定环境中渲染出非空内容。这些检查有明确依据,也容易保留日志。但它们回答的是“是否符合交付和技术约束”,而不是“这只鸟是否骑对了车”。同样,渲染成功也不能替代格式合规检查。SVG 规范区分不同的文档形态和处理模式;网页内嵌片段和独立 SVG 文件,不应未经说明就按同一种解析要求验收。3
几何检查必须先解决“你量的到底是什么”
如果已经可靠地识别出脚和踏板对应的可见几何区域,就可以计算距离、重叠范围和轨迹关系。例如,把脚底与踏板接触面的距离,除以同一画面中约定的参考轮径,得到一个相对距离。这样讨论“离开踏板有多远”,比直接套一个固定像素阈值更有解释性。但接触面怎么定义、误差容许多大,仍需要在标注样本上校准,不能凭空宣布“相差五个像素就一定错误”。测量还要考虑坐标变换、描边、裁剪和实际可见性。SVG 元素可能处于嵌套坐标系中;规范中也存在未实际渲染的元素仍具有包围盒的情况。拿到一个包围盒,不代表已经拿到了画面上那个可见对象的边界。4 更不用说,两个包围盒相交,不等于脚底接触踏板;两个二维区域重叠,也可能只是前后遮挡,并不表示合理支撑。
所以,在通用 SVG 上,几何规则更适合作为经过验证后的辅助证据,而不是未经校准就一票否决的裁判。如果为了自动化,要求模型必须输出统一的部件 ID、关键点和分组结构,也不是不可以。但那应当作为一个单独的“结构化输出赛道”:检查这些声明是否对应真实画面,而不是让模型自己写上“接触正确”,评测程序就直接相信。DOM 给了我们更多可检查的信息,却没有免费解决语义识别。
四、视觉 Judge 上岗之前,先给裁判出一套考卷
既然静态规则不够,就让能看图的模型来评。这条路值得走,但不能把“模型能描述图片”,直接等同于“模型能稳定判定细微空间错误”。 2023 年关于 MT-Bench 与 Chatbot Arena 的研究,讨论了 LLM 裁判的位置偏好、冗长偏好和自我偏好等问题,也报告了强模型在特定文本评测中与人类偏好较好的一致性。因此,合理结论不是“模型裁判全都不可信”,而是“它的可信度依赖具体任务,需要验证”。这些文本评测结果,也不能直接当作视觉评分的准确率。5
视觉能力本身同样需要检查。2024 年的 BlindTest 研究发现,当时受测的视觉语言模型在圆是否重叠、线是否相交等简单几何任务上仍会出错。这不代表今天所有模型都停留在当年的水平,但足以提醒我们:精细接触关系,不能只凭模型的名气就默认它看得准。6 我的做法会是先建立一批人工参考样本,而不是直接让 Judge 接管榜单。样本里既要有明显正确与明显错误,也要有边界情况:简笔画、细线条、合理遮挡、复杂路径,以及静态正常但运动出错的作品。尽量安排至少两位标注者先独立盲评,再对分歧进行复核。
人工也不是天然真值。如果两个人看同一条规则,总是得出相反结论,可能首先该修改的是题目或评分说明。无法澄清的样本,可以继续保留争议,而不是硬造一个“标准答案”。
Judge 应该回答具体问题,而不是发表审美感言
给它原始任务、冻结的评分规则和统一渲染的图像。动画题再提供有时间标记的帧或视频。不要同时给出服务商名字、榜单位置,或者生成模型自己的“本图完全符合要求”说明。让 Judge 逐条判断:“两只脚是否分别接触各自的踏板?”“可见的车架是否与前后轮轴形成合理连接?”“在这些时刻,脚和踏板之间的联系是否保持?”每个判断附上一条简短、可定位的证据,例如“第 2.0 秒,靠近观察者的脚与踏板之间有明显间隙”。证据不足时就返回 uncertain,不要用一段流畅说明掩盖看不清。
图像中的文字、SVG 注释和元数据也只能作为被测内容,不能成为改变评分规则的指令。遮去文件名或隐藏渠道标签,不等于可以擅自修改作品;需要裁剪或标注辅助图时,应同时保留原图和处理记录。
校准不能只看一个“总体一致率”
假设一批参考样本中,90 张合格,10 张存在严重错误。一个永远回答“通过”的裁判,也能获得 90% 的总体准确率,但它会放过全部严重错误。因此,我会分别检查:关键错误有多少被漏掉,正确作品有多少被误杀,各种画风上的表现是否一致,以及同一作品重复评分时是否稳定。边界样本还要看它是否愿意承认证据不足。可以额外制作少量“只改一个因素”的样本:保持原图不变,把一只脚移离踏板;或者只改变背景,不动结构。前一种改动应影响相关评分,后一种不应无故改变结构判断。这些人工构造样本适合诊断,但不能完全替代真实模型输出。用于修改评分 Prompt 的样本,与最终检验裁判的留出样本,也要分开。不能一直对着同一批答案调到满意,再把这批成绩当作泛化能力证明。
至于多裁判投票,可以作为发现分歧的办法,却不能因为用了三家模型,就认定三份判断相互独立。它们可能犯同一种错。Judge 自己声称“我有 95% 把握”,也不能未经校准就当成 95% 的实际正确率。裁判需要证明的是它能识别错误,而不只是它能解释自己的分数。
五、动画不是多截几张图,而是检查关系有没有在时间里断掉
静态评分问的是“现在有没有踩上”。动画评分问的是“动起来之后,这种关系有没有继续成立”。一只脚在第一帧恰好碰到踏板,并不意味着它随后沿着踏板的轨迹运动。相反,把脚和踏板一起固定不动,也不能算完成了题目要求的蹬踏动作。所以动画至少有两个不同问题:该动的东西是否真的动了,以及运动过程中应当维持的联系是否保持。为此,先要约定动画场景。原地骑行、向前行进、镜头跟随,是不同的任务。题目没有要求精确的机械仿真,就不该偷偷加上齿轮比等额外约束;但如果明确要求曲柄转动、脚持续接触踏板,这些就应当进入验收。
评测环境也必须保留真实的动画状态。举个很具体的工程坑:Playwright 的截图参数 animations="disabled",会对其支持的相关动画进行停止处理,其中有限动画会被推进至结束,无限动画会被取消到初始状态。它不是“精确截取任意时刻”的同义词。7 因此,不能随手关闭动画、截出一张漂亮图片,就把它当成动画通过的证据。应当先用已知动作的测试文件,验证自己的时间控制和截图方法,再用于模型输出;所支持的动画机制也应写清楚。
假设题目要求一个 4 秒循环,一种起步方案是观察两个完整循环,按预定频率采样,并额外检查循环交界及疑似出错的时间段。具体观察窗口、采样频率和追加检查规则,都应在正式评测前固定,而不是看到哪一边出问题才临时加严。但即使如此,有限帧采样仍然可能漏掉帧间的短暂异常。报告应写成“在约定窗口和采样条件下未发现明显错误”,而不是“数学上证明全程没有穿模”。还要小心二维画面中的正常遮挡。腿经过车架后方时,轮廓交叠并不自动等于穿模;真正要检查的是前后关系、连接关系是否出现不合理变化。局部放大有助于观察,但不能丢掉全局空间背景。
如果一个自动裁判目前只能可靠处理静态图,就先公开静态成绩,把动画留给人工复核。与其把没有测到的能力塞进一个总分,不如承认这把尺子暂时量不到那里。
六、评分系统也会出错,而且会制造“模型突然变差”的假象
有了静态检查、视觉 Judge 和人工复核,问题还没有结束。因为这套系统本身,也可能发生变化。昨天的 Judge 对轻微悬空比较宽松,今天换了一个版本,开始严格扣分。模型生成的作品没有任何变化,榜单上的合格率却下降了。如果只保存“模型名字、日期、总分”,很容易把裁判变化误认成模型退化。因此,除了生成模型与请求参数,还需要记录题目版本、评分规则版本、Judge 的模型与配置、渲染器版本,以及自动检查程序版本。任何一项变化,都可能影响分数的含义。更换裁判或规则之前,我会让新旧版本对同一批已保存作品同时评分,看看差异集中在哪里。必要时重评历史作品,但应把它标为“同一产物的新版重评分”,不能伪装成模型刚刚重新作答。
另一类问题是评测没完成。服务超时、SVG 本身损坏、截图程序崩溃、Judge 请求失败,不能全混成“模型画错”。作品自身不合规,可以按预定规则判失败;评测基础设施出故障,则应记录为评测未决,并按固定流程补评。对一份作品而言,只要某个必要条件已经明确失败,整体就可以判不合格。反过来,如果尚无明确失败,但仍有必要条件看不清,不能直接放行。假设 100 个预定请求中,有 72 个确认合格,18 个确认不合格,另有 10 个尚未判定。报告可以先写清这三项,而不是删除未决样本,再宣布“合格率 80%”。
在暂时把已确定标签视为正确的前提下,这批样本最终的合格比例可能介于 72% 和 82%:下界把未决项全部算失败,上界把它们全部算通过。这是未决标签带来的范围,不是统计置信区间,也没有包含裁判误判和向其他样本推广的不确定性。人工复核也不能只看 Judge 标出的失败和争议。自动通过的作品里,应按预定方式随机抽取一部分检查,否则最危险的漏判可能一直藏在“通过”区。没有哪套自动评测可以靠“从来没发现自己出错”,证明自己没有错。它需要一套能主动发现自身失误的审计流程。
七、题目会过时,但每天换题也不等于更科学
一旦某道题成为网红,接下来就会出现示例、教程、修复建议,以及专门围绕它进行的优化。这不意味着看到模型鹈鹕画得好,就能断言它作弊。公开题目的暴露、对题型的学习,以及测试样本进入训练数据,是不同层次的问题。具体模型是否接触过具体测试材料,需要证据,不能靠“这个题太火了”直接判定。不过,测试材料进入训练数据确实是评测要面对的风险。LiveBench 的做法包括使用较新的信息来源、持续更新题目,以及依据可核验答案自动评分。它提供的是降低相关风险的一种实践,而不是“只要每月换题,就绝对没有污染”的保证。8
对鹈鹕这类开放生成题,我更倾向于保留三种用途不同的题目:稳定的核心题,用于观察长期变化;定期轮换的扩展题,用于观察迁移;暂不公开的留出题,用于在流程冻结后检验,而不是不断拿来调规则。核心题的价值是可比,不是免疫训练污染。扩展题的价值是扩大覆盖,也不是题面越怪越好。
真正值得变化的,是约束,而不只是主角的名字
把鹈鹕换成鸭子,可以是一种变化,但它没有自动改变关系结构。更有诊断价值的变体,是有计划地改变一个条件:朝向相反时,连接关系是否仍然正确;遮挡增加时,关键部件是否仍然完整;要求“站在车旁推车”时,模型会不会仍然套用骑乘姿势;同样的接触关系进入动画后,会不会失效。也可以换成不同的关系任务,例如手握杯柄、物体被托盘支撑、多个部件按指定顺序连接。关键不是把所有罕见要求堆在一张图里,而是知道每个变体在检验什么。由同一个模板机械替换一百种动物,当然能产生一百道题,却不能因此宣称获得了一百种独立的能力证据。汇总时应保留任务类别和模板家族,避免某个模板因为变体特别多,就占据总分的大半。
自动生成新题也需要验收。题目可能含糊、矛盾,或者根本无法从最终图像核验。若题目、答案和裁判规则全部由同一个模型提出,再由它自己确认正确,就更应该增加独立检查。
更新题库时,别把难度变化画成模型进步
这个月 80 分,下个月 90 分,不一定说明模型变强了,也可能只是新题更简单。因此,新旧题库切换时,最好保留共同题,并在相近条件下让一组参照系统同时跑旧题与新题,分别报告各任务类别的变化。共同题和参照系统都不是永远稳定的真值。它们有助于识别变化,却不会自动完成严格的难度等值。证据不足时,最诚实的做法是分版本展示成绩,而不是把不同试卷的原始分数硬接成一条曲线。题目退役后可以公开,帮助别人复查、学习和改进。只是公开之后,它的角色可能从“暂未见过的检验”,转向“可重复的回归测试”。题目不是只能用一次,也不是能够永远担任同一种测量工具。动态题库的重点,不是永远追逐新鲜,而是管理题目在不同阶段能支持什么结论。
八、真正值得自动化的,是一条能回头查账的流程
讨论到这里,很容易把方案越做越大:多裁判、轨迹分析、动态题库、自动仲裁,一个都不能少。但最小可用版本,不必从一座全自动工厂开始。先选一小组题,写清验收条件,收集真实输出,建立人工参考,再验证哪些条目可以交给规则、哪些可以交给视觉 Judge。尚未可靠自动化的部分,就保留人工处理。数据量小的时候,目标是发现规则漏洞,而不是急着对外宣布“评分准确率已经达到某个水平”。对自动化能力的正式验证,需要另外保留样本,并报告不确定性。一条合理的流程可以是:
冻结题目与验收规则 → 按计划生成 → 保存完整原始输出
→ 受控解析与渲染 → 静态检查 / 视觉逐项评分
→ 按规则复核争议,并抽查自动通过项
→ 汇总首次交付结果、分项表现和未决状态
每一步都应能够追溯到前一步。原始响应、提取的 SVG、实际渲染图、动画观察记录、Judge 的原始返回和复核结论,通过同一个运行标识关联起来。提取或规范化文件时,保存处理前后的版本。修复了一段 SVG 才渲染成功,应当被记录为修复流程的结果,不能悄悄覆盖首答。评分规则升级,也应增加新的评测记录,而不是把旧记录抹掉。还有一个不能省掉的工程前提:把模型输出当作不受信任的内容。SVG 的处理模式可能涉及脚本、事件和外部资源;“扩展名是图片”并不意味着可以放心在日常登录的浏览器里执行。3
渲染环境应隔离账户凭据、网络和宿主文件,限制资源使用,并采用适合不受信任内容的沙箱配置。若使用 Playwright,也不能把“套进 Docker”当成安全已经解决;其官方文档明确提醒默认容器镜像的用途限制,以及 root 运行与 Chromium 沙箱的关系。9 具体安全措施还需要按运行环境验证。题目允许什么功能,与执行环境允许什么功能,也应提前一致,不能先让模型使用脚本,评分时再不加说明地全部禁用。真正需要省下的,不是“认真验证”本身,而是每次验证都要重新找文件、对参数、补时间戳的重复劳动。
九、一个值得看的榜单,应该让人能够追问它
看到一个分数时,我希望能继续查到:它对应哪个模型服务、哪份题库、什么时间窗口;样本有多少,失败与未决有没有保留;谁在评分,怎么校准,能否找到判定依据。这些信息比一个看起来很精密的总分,更能说明评测有没有认真对待自己的边界。不准备亲自搭建流程的人,可以先从 Folkbench 的公开榜单、报告和评测说明入口开始,确认关心的模型与服务是否已有适用的已发布结果。其公开首页将比较范围描述为同一模型下的不同服务;具体覆盖情况、功能状态和结论依据,仍应以当时公开的信息为准。10
对 Folkbench 如此,对其他榜单也一样:缺少的信息继续保留为未知,平台的介绍不替代实际报告,本文提出的评测方案也不等同于任何平台已经具备的能力。好的评测不是要求读者“相信我这个分数”,而是允许读者沿着分数,找到作品、条件、规则和分歧。回到那三只鹈鹕。我们不必争论第一只是不是最好看,也不用因为第三只某一帧很漂亮,就替它的整段动画放行。只要先约定测什么,再把证据记录清楚,很多所谓玄学,就会变成能够逐项讨论的问题。第一篇说,一张截图可以提出一个好问题,但回答它需要一场像样的实验。这一篇想补上的是:一场像样的实验,还需要一把经过检验的尺子。
附录一:一份可以起步的约束题与验收表
下面是本文设计的静态题示例,不是行业标准,也不是任何平台的正式题目。使用前应经过试运行与标注校准;正式比较开始后,不要根据结果临时改题。
示例 Prompt
请只输出一份可独立打开的、自包含的静态 SVG 文件内容,
viewBox 为 "0 0 800 600",不附带 Markdown 代码围栏或解释。

画一只卡通鹈鹕骑在普通双轮自行车上。
画面以侧面为主,允许部件轻微错位,以清楚展示骑乘关系。

必须满足:
1. 鹈鹕和自行车完整位于画面内,不出现额外的腿。
2. 前后两个车轮、车架、车座、车把、曲柄和两个踏板可辨认,
   车架与前后轮轴连接合理,踏板与曲柄关系合理。
3. 身体坐在车座上;两只脚分别接触各自的踏板,
   两处接触都必须清楚可见;至少一只翅膀接触车把。
4. 只使用 SVG 矢量图形与内联样式,不使用嵌入位图、外部资源、
   脚本、foreignObject 或动画。

不要求写实、复杂背景、羽毛纹理或装饰性特效。
示例验收表
| 编号 | 检查项 | 性质 |
|---|---|---|
| F1 | 满足约定的独立文件格式、视口与资源限制 | 必要条件 |
| P1 | 主体可辨认为鹈鹕,画面完整,无明确的额外腿 | 必要条件 |
| B1 | 两个车轮、车架、车座、车把、曲柄和两个踏板可辨认 | 必要条件 |
| B2 | 车架与前后轮轴、踏板与曲柄的连接关系合理 | 必要条件 |
| R1 | 身体与车座形成明确的骑坐支撑关系 | 必要条件 |
| R2 | 两只脚分别接触各自踏板,接触处符合可见性要求 | 必要条件 |
| R3 | 至少一只翅膀接触车把 | 必要条件 |
| A | 本题为静态题,动画能力未测试 | 不适用 |
| Q1 | 配色、线条和细节表现 | 可选展示项,不抵消必要条件失败 |
这里的“可辨认”“合理”“明确”仍需要配套的正反例与边界说明。表格只是规则骨架,不是仅靠几句文字就消除了主观判断。必要条件全部通过,才判合格;有必要条件明确失败,判不合格;没有明确失败但存在未决必要条件,进入复核。R3 之所以需要检查,是因为这份示例 Prompt 明确要求了它,不能把它未经说明地套到所有鹈鹕题上。
附录二:一份 Judge 输出记录的示例
下面的 JSON 是虚构的单项记录,用于展示字段关系,不对应真实图片。它不是完整报告,也不是某个库可以直接运行的配置。
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "靠近观察者的脚与其对应踏板之间存在清楚可见的间隙。"
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id 应能找到裁判的具体模型、Prompt、参数和版本记录;render_profile_id 应能找到浏览器、视口及其他相关设置。动画证据应填写实际时间点,不能只写“中间有一帧”。 review_required 由评测系统按既定规则设置,不由 Judge 单方面决定。即使该字段为 false,样本仍可能进入随机审计。自动评分失败、视觉材料不足和任务不合格,应分别记录,不能共用一个模糊的“失败”状态。
注释与参考资料
- Yushi Hu 等,TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering,ICCV 2023。论文将文本要求转为问答检查,用于评价图文一致性。本文借鉴其分解思路,不将原论文的实验成绩移植到鹈鹕 SVG 或动画任务。论文↩
- W3C,Scalable Vector Graphics (SVG) 2,Document Structure 与 Paths 章节。参见分组、
use复用与路径表达;“DOM 节点不天然对应现实语义对象”是本文据此给出的评测设计判断。文档结构;路径↩ - W3C,SVG 2 — Conformance Criteria,处理模式与文档符合性章节。规范区分脚本执行、外部资源、声明式动画等能力,以及不同文档形态。具体浏览器支持与执行限制仍须在实际环境验证。规范↩
- W3C,SVG 2 — Coordinate Systems, Transformations and Units,坐标变换及 Bounding boxes 相关段落。本文关于接触距离、阈值和语义识别的建议,是评测设计示例,不是 SVG 规范定义的“骑乘正确性”算法。规范↩
- Lianmin Zheng 等,Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena,NeurIPS 2023 Datasets and Benchmarks Track,arXiv v4。本文仅据其说明特定文本评测中的裁判能力与偏差,不推定全部视觉裁判具有同样的偏差幅度或准确率。论文↩
- Pooyan Rahmanzadehgervi 等,Vision language models are blind,2024。本文对应 2024 年的原始研究,固定引用 arXiv v1,以避免将后续修订的模型、标题与结果混用;该研究不能充当 2026 年模型的现时排名。论文版本↩
- Playwright 官方文档,
page.screenshot的animations选项,查阅日期:2026 年 10 月 5 日。文档描述该选项对 CSS animations、CSS transitions 与 Web Animations 的处理;不能将它未经验证地推广为所有 SVG 动画机制的统一时间控制方案。文档↩ - Colin White 等,LiveBench: A Challenging, Contamination-Limited LLM Benchmark,ICLR 2025,arXiv v2。初始版本标题使用过 “Contamination-Free”,本文依据 2025 年修订版关于持续更新、可核验评分与降低污染风险的表述,不作绝对无污染承诺。论文↩
- Playwright 官方 Docker 文档,查阅日期:2026 年 10 月 5 日。文档提醒默认镜像不建议用于访问不受信任的网站,并说明默认 root 运行会禁用 Chromium 沙箱。本文没有提供完整安全部署方案;实际隔离、网络和权限策略仍须按运行环境落实与测试。文档↩
- Folkbench 公开首页,查阅日期:2026 年 10 月 5 日。首页提供榜单、报告及相关说明入口,并自述同一模型下比较不同服务;其检测入口同时标注“Beta 准备流程”和“真实探测尚未启用,当前入口用于展示准备流程”。本文仅指向公开信息入口,不将展示入口等同于已完成实测,不独立背书具体排名,也不声称其已实现本文的四维评分、裁判校准或动态题库方案。首页↩