Una falla puede demostrar que un modelo se equivocó. Por sí sola, no puede demostrar que ahora se equivoque con más frecuencia que antes.
“¿Este modelo se volvió más tonto otra vez?” Un pelícano con una pata colgando fuera del pedal, una bicicleta con el cuadro retorcido como un nudo y, al lado, una captura de la semana pasada que había salido bastante bien: con eso basta para que surja la pregunta.
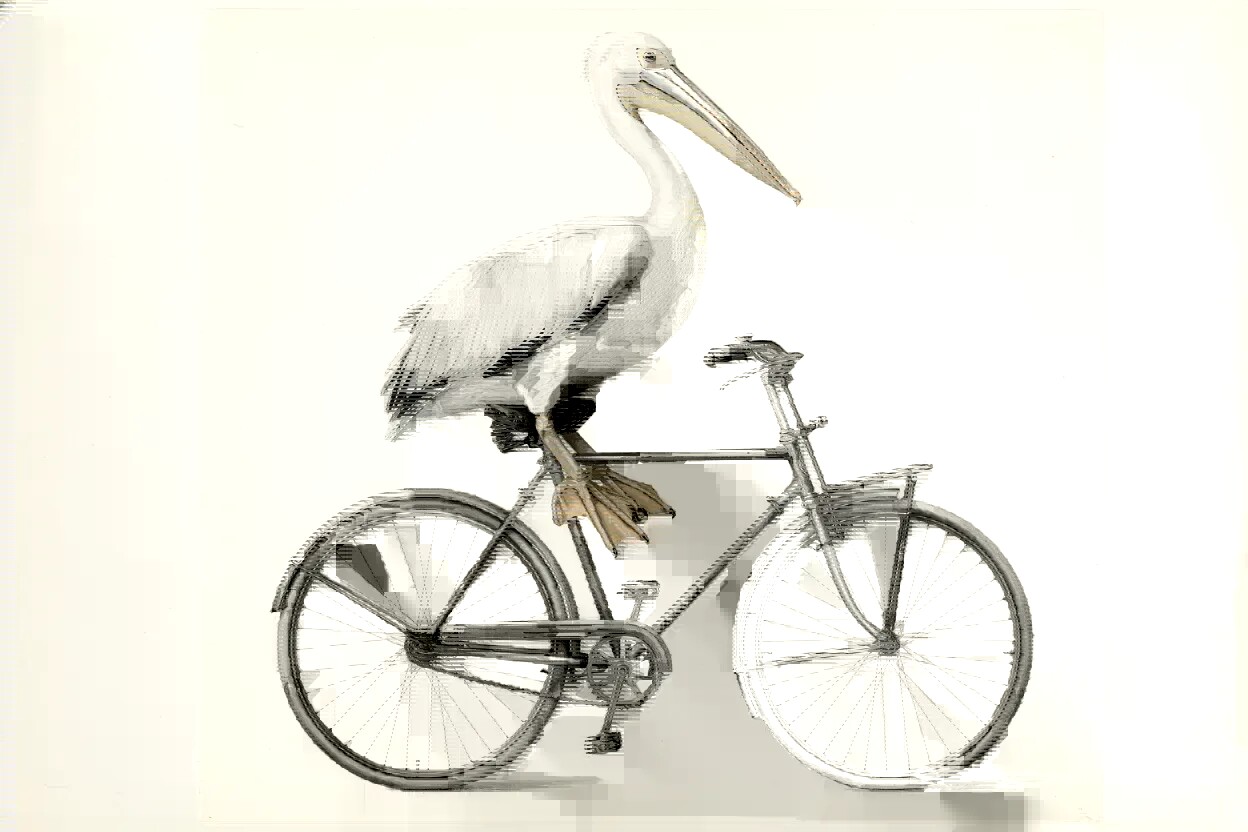
Esa sospecha no debería descartarse con un “los modelos son aleatorios”. Alguien pagó por una tarea que el servicio antes resolvía y que ahora no resuelve. Vale la pena preguntar por qué. Sin embargo, dos capturas no bastan para demostrar que cambiaron el modelo, que recortaron el presupuesto de razonamiento o que un servicio en particular está “rebajado”.
Hace un tiempo ejecuté la prueba del pelícano decenas de veces. Lo que hace útil esta tarea es que muchos de sus errores quedan dibujados a la vista. Que el código se ejecute no significa que la estructura de la bicicleta sea correcta. Que aparezcan el ave y la bicicleta no significa que la pata esté realmente sobre el pedal. Esas relaciones espaciales se detectan a simple vista con más facilidad que una respuesta fluida que, aun así, puede esconder un hueco lógico. Cuantas más ejecuciones guardaba, más claro me quedaba otro punto: muchas veces juzgamos un servicio entero por un solo dibujo.
Este artículo no pretende justificar a ningún modelo ni enseñar a detectar un “modelo falso” a partir de unos pocos rasgos superficiales. La pregunta que me interesa es más acotada: cuando sospechamos que un modelo empeoró, ¿cómo convertimos esa sensación en evidencia que otra persona pueda volver a verificar?
Nota: los servicios A y B que aparecen más abajo, y todas las cifras de prueba asociadas a ellos, son ejemplos didácticos. No corresponden a ningún servicio real ni son una medición o un ranking de Folkbench.
1. Primero separa la pregunta: ¿qué quieres decir con “más tonto”?
“Se volvió más tonto” es una expresión cómoda, pero mete varias preguntas distintas en una sola. La capa más directa es: esta respuesta en particular está mal. Al pelícano le salió una pata de más, el pie no llegó al pedal o las ruedas se separaron del cuadro. Cada una de esas es una falla concreta que puedes verificar. Una sola muestra basta para demostrar que “este tipo de error ocurrió” y para desmentir la promesa de que “nunca cometería este tipo de error”. La segunda capa es: en las mismas condiciones, o en condiciones lo bastante parecidas, este servicio falla con más frecuencia.
Eso ya no es una pregunta sobre si el error existe, sino sobre con qué frecuencia aparece. La parte de “la experiencia empeoró” que más vale la pena medir es el paso de “casi siempre funcionaba” a “casi nunca funciona”. La tercera capa es: el cambio se debe a una modificación del propio modelo o de la configuración del lado del servidor. Eso ya es una afirmación sobre la causa. El mismo mal resultado puede tener explicaciones distintas: parámetros de solicitud diferentes, otro contexto, una salida truncada o un cambio real en el modelo subyacente y en la configuración de inferencia. Ver solo el resultado, por lo general, no permite quedarse con una única explicación.
Por eso, “esta salió mal”, “este servicio es menos confiable” y “este servicio cambió el modelo a escondidas” no exigen evidencia de la misma fuerza. Reconocer esa diferencia no le pone más trabas a la queja de un usuario. Hace lo contrario. Nombrar con claridad la pregunta impide que quien ofrece el servicio explique cada falla como “aleatoriedad” y que quien evalúa explique cada diferencia como “cambiaron el modelo”.
2. ¿Estás viendo un solo dibujo o una distribución de salidas?
Con una configuración de generación que muestrea al azar, la misma entrada puede producir salidas distintas. Incluso si usas algún control pensado para mejorar la reproducibilidad, “lo más consistente posible” no debe leerse como “idéntico cada vez”. Una nota técnica antigua de OpenAI lo decía explícitamente: con la misma semilla, los mismos parámetros y la misma huella del backend, sigue sin garantizarse que la salida sea idéntica. Ese es un límite de la reproducibilidad. No significa que todos los modelos actuales acepten los mismos parámetros.1
En la prueba del pelícano, lo que normalmente queremos saber no es “¿puede dibujar una buena imagen de vez en cuando?”, sino “en las condiciones que fijé, si le doy la tarea una vez más, ¿qué tan probable es obtener un resultado aprobado?”. Un ejemplo simplificado muestra el problema de una sola captura. Supón que la tasa real de aprobación de un servicio en un solo intento es del 80%, que cada generación es independiente y que su estado no cambia durante la prueba. La probabilidad de al menos una falla en 20 intentos seguidos es: 1 − 0.8²⁰ ≈ 98.85% Un servicio que casi siempre hace bien el trabajo dejará, casi con seguridad, alguna falla para capturar en algún punto de esos 20 intentos.
Ahora al revés. Supón que la tasa real de aprobación de otro servicio en un solo intento es de apenas el 40%. Con los mismos supuestos de independencia y estabilidad, la probabilidad de obtener al menos un resultado aprobado en 20 intentos es: 1 − 0.6²⁰ ≈ 99.996% Este también producirá, casi con seguridad, un dibujo para presumir. Estos dos cálculos no dicen que todas las llamadas reales sean independientes ni que las tasas reales de aprobación sean exactamente esas cifras. Apuntan a un problema de selección: mostrar solo el mejor intento facilita sobrestimar la confiabilidad, y mostrar solo el peor facilita exagerar un deterioro.
Por eso, el mismo servicio puede aparecer en una publicación que toma una imagen como prueba de que funciona a plena capacidad y en otra que toma una imagen como prueba de que se volvió más tonto. Las dos capturas pueden ser reales. La inferencia no necesariamente lo es. Hay otra distinción que es fácil pasar por alto. Acertar en la primera generación y generar diez veces para luego elegir el acierto no son la misma capacidad. Lo segundo incluye llamadas adicionales, espera y el costo de seleccionar. Si comparas dos flujos de trabajo, dales a ambos el mismo presupuesto de intentos. No compares el primer intento de A con el favorito seleccionado de B.
3. ¿Con 20 ejecuciones una diferencia ya es estadísticamente significativa?
No. Veinte ejecuciones pueden ser un presupuesto experimental razonable, pero no son un permiso estadístico. Tomemos el mismo ejemplo concreto. El canal A se ejecuta 20 veces y aprueba 16. El canal B se ejecuta 20 veces y aprueba 8. Ambos usan una misma tarea fija y la misma regla de puntuación, y se conservan todas las muestras.
| Canal | Aprobados / total | Tasa en la muestra | Intervalo de Wilson del 95% para la tasa |
|---|---|---|---|
| A | 16 / 20 | 80% | 58.4%–91.9% |
| B | 8 / 20 | 40% | 21.9%–61.3% |
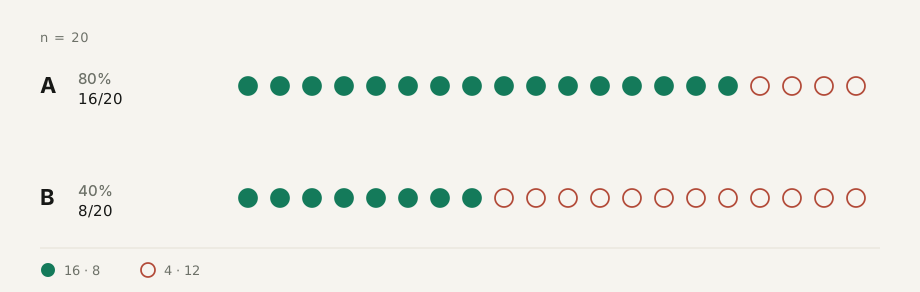
Los intervalos son intervalos de Wilson bilaterales del 95% para una proporción binomial. Expresan la incertidumbre de la tasa de aprobación estimada. No son un rango de puntuación de la calidad del dibujo.2 La diferencia en la muestra es de 40 puntos porcentuales. Con solo 20 intentos de cada lado, la estimación todavía es poco precisa. No hay que tratar el 80% y el 40% como una capacidad real medida con exactitud que nunca va a cambiar.
Si además suponemos que las llamadas son independientes, que la probabilidad de aprobación de cada canal es estable dentro de la ventana y que esta comparación se eligió de antemano, una prueba exacta de Fisher bilateral sobre los conteos de aprobados y no aprobados da p ≈ 0.0225. Con un nivel de significancia del 5% fijado de antemano, este ejemplo respalda que “las tasas de aprobación difieren en estas condiciones”.3 Esa cifra no significa “un 97.75% de probabilidad de que B esté rebajado”, ni “un 97.75% de probabilidad de que A sea mejor para siempre”. Un valor p es la probabilidad de obtener datos así de extremos, o más, bajo la hipótesis de que no hay diferencia y en las condiciones de la prueba. No es la probabilidad de una causa oculta.3
No reemplaces una prueba de la diferencia con una mirada a si los dos intervalos se superponen. Cada intervalo estima una tasa; la prueba trata sobre la diferencia entre ambas. Hay tres límites que importan más que memorizar una prueba. Mira juntos el tamaño de la brecha y el tamaño de la muestra. Un 16 contra 8 no debería sostener una conclusión de la misma fuerza que un 16 contra 15. Cuántas muestras necesitas depende de qué tan pequeña es la brecha que esperas detectar y de cuánto riesgo de equivocarte aceptas. No existe un “ejecútalo al menos tantas veces” que sirva para todas las tareas.
No encontrar una diferencia significativa no demuestra que los dos sean iguales. Puede que simplemente haya muy pocos datos, o que sean demasiado inestables, para llegar todavía a una conclusión. Para demostrar que una diferencia es lo bastante pequeña como para ignorarla, define de antemano qué es “lo bastante pequeña”. Un resultado no significativo no es una prueba de equivalencia. Una diferencia estadística no es, por sí sola, una razón para cambiar de servicio. El usuario todavía tiene que sopesar el costo de una falla, el precio de cada llamada, la latencia y el costo de rehacer el trabajo. Una diferencia puede ser real y, aun así, demasiado pequeña para cambiar la decisión. Aquí, el trabajo de la estadística no es producir un valor p que se vea profesional. Es evitar que afirmemos más de lo que la evidencia puede sostener.
4. Una línea base es un contrato experimental, no la frase “el prompt era el mismo”
Muchas comparaciones fallan antes de que el tamaño de la muestra sea el problema: las muestras no eran comparables desde el principio. A ambos lados se les pide “dibuja un pelícano en bicicleta”. Una llamada es una solicitud a la API en una sesión nueva. La otra ocurre en una ventana de chat con decenas de turnos y con herramientas activadas. Un lado puede escribir una salida larga; el otro llega al límite de longitud a mitad de camino. Repetir eso cien veces sigue sin permitir atribuir el resultado a una diferencia de capacidad del modelo.
La investigación sobre el estándar de evaluación OLMES señala que decisiones de evaluación como el formato del prompt, los ejemplos en contexto y la redacción de la tarea cambian el desempeño medido. Una comparación reproducible tiene que registrar esas configuraciones. Las tareas de ese trabajo no son el SVG del pelícano, pero vale la pena tomar en cuenta su advertencia sobre la configuración experimental.4 Yo trataría la línea base como un contrato sobre “qué se está midiendo realmente en esta ronda”.
Lo que se compara debe ser específico: el servicio, el grupo o la ruta, y la versión del modelo que realmente puedes obtener. Si lo único que tienes es un alias de modelo que puede cambiar con el tiempo, registra el alias. Si no conoces la instantánea subyacente, escribe “desconocida”. No tomes la cadena de modelo que devuelve la interfaz como una verificación independiente de la identidad subyacente. Guarda la entrada de la forma más completa posible. Eso es más que el prompt final: incluye el prompt de sistema, el historial, los archivos adjuntos y la configuración de herramientas que puedes controlar y observar. Que las condiciones visibles coincidan no demuestra que las invisibles también coincidieran.
En la configuración de generación, registra el nivel de razonamiento, el límite de salida y los parámetros de muestreo que la interfaz realmente admite. Escribe “no admitido” en un campo que la interfaz no ofrece y “desconocido” en uno cuyo efecto no puedes confirmar. No los des por iguales sin decirlo. Tampoco asumas que un ajuste llamado “high” significa el mismo presupuesto de cómputo en dos modelos distintos.
El entorno de evaluación incluye cómo renderizas y cómo puntúas. Revisa el mismo SVG con el mismo viewport y el mismo renderizador. En una tarea de animación, usa la ventana de observación acordada. No veas el movimiento completo de un lado y elijas un solo fotograma del otro. Si la tarea no pedía animación, no descuentes puntos porque la salida sea una imagen estática. Por último, escribe la regla de reintentos antes de empezar la prueba. Si se puede reintentar después de una primera falla, cuántas veces y si se permite dar retroalimentación forman parte de las condiciones de la prueba. No son algo para improvisar cuando ya llegaron los resultados.
Fijar estas cosas no es un intento de construir un “modelo de laboratorio” desconectado del mundo real. Puedes perfectamente comparar la experiencia predeterminada de dos productos de chat. En ese caso, la conclusión debe ser “estos dos productos difieren en lo que entregan con la configuración predeterminada”, no “aislé cuáles pesos del modelo subyacente son mejores”. Una condición que no puedes controlar puede quedar como desconocida. Una condición desconocida no puede registrarse como controlada.
5. Cómo organizas la prueba suele importar más que simplemente repetirla más veces
No ates el canal a la hora del día
Ejecutar todo A en la mañana y luego todo B a altas horas de la noche mezcla “una diferencia entre canales” con “una diferencia en el tiempo”. Aunque veas una brecha, es difícil decir cuánto depende de esa ventana. Para una comparación ligera lado a lado, yo intercalaría A y B dentro de una ventana elegida de antemano y aleatorizaría el orden. Mantén la concurrencia lo más parecida posible. No dejes que un lado genere una solicitud a la vez mientras el otro recibe una ráfaga.
Puedes ir un paso más allá y dividir la ventana en lotes pequeños, con A y B en cada lote. Además del resultado global, así puedes ver si la diferencia se concentra en un solo lote. Un orden aleatorio ayuda a reducir la confusión con el factor tiempo. No elimina automáticamente la correlación que puede venir de un backend compartido, una interrupción breve o algo parecido.
Una pregunta longitudinal, “¿está peor que la semana pasada?”, es distinta. El tiempo es la variable que estás estudiando, así que no puedes fijar ambos lados en el mismo momento. Conserva en lo posible la misma tarea central, la misma configuración y la misma regla de puntuación, y vuelve a ejecutar un servicio de referencia en cada ventana de observación. No compares eternamente los resultados de hoy con la mejor imagen de la semana pasada. Al leer un resultado longitudinal, conserva tanto la tasa absoluta de aprobación como la brecha relativa. Si el servicio evaluado y el de referencia bajan a la vez, la brecha entre ellos puede mantenerse igual. Eso no significa que la experiencia del usuario no haya empeorado. Una referencia no es una verdad siempre correcta y siempre estable.
No decidas cuándo detenerte mientras miras los resultados
“Ejecútalo cinco veces. Si gana A, publícalo. Si A no gana, sigue hasta que la diferencia sea significativa.” Eso parece agregar muestras, pero cambia la regla estadística. Revisar una y otra vez una prueba de muestra fija y detenerse por lo que ves rompe el control de falsos positivos para el que se diseñó esa prueba. Una prueba que necesita observar los datos de forma continua debe usar un método diseñado para el análisis secuencial.5 La mayoría de las personas no necesita empezar por la estadística secuencial. La práctica más sencilla es dejar por escrito, antes de la ronda, cuántas ejecuciones harás, qué métrica principal usarás y qué comparaciones principales harás. Después, conserva todos los resultados.
Hacer algunas llamadas de prueba para confirmar que la interfaz y el proceso de puntuación funcionan está bien. Esas son ejecuciones piloto. Cuando termines de ajustar el procedimiento, empieza la prueba formal por separado. No mezcles los resultados de la etapa en que afinabas la tarea con los resultados formales. Lo mismo aplica a otros dos hábitos. Probar decenas de tareas y publicar solo la que se ve mejor, o ver que vas perdiendo en la puntuación total y entonces declarar la victoria en una subescala, no es la comparación que se acordó de antemano.
No trates cien repeticiones de una tarea como cien tareas
La generación repetida te dice qué tan confiable es el servicio en esta tarea. No amplía automáticamente el alcance de la afirmación. Que el pelícano salga bien de forma constante no significa, por sí solo, que la depuración de código, el análisis de textos largos y el seguimiento de instrucciones complejas sean igual de confiables. Cuando haces inferencias sobre una clase de tareas, la variación entre tareas y la variación entre repeticiones de una misma tarea son dos tipos distintos de incertidumbre. La investigación sobre evaluación distingue entre el muestreo repetido, las comparaciones a nivel de tarea y el tratamiento de muestras agrupadas y dependientes.6
Por eso, yo usaría primero una sola sonda para observar la repetibilidad y luego agregaría un pequeño conjunto de tareas fijas ligadas al uso real. Ambos lados responden el mismo conjunto. Calcula el resultado de cada tarea, y la diferencia en cada tarea, antes de consolidar los resultados. No te limites a presentar una puntuación total. Si haces un análisis formal con varias tareas, conserva el emparejamiento por tarea y por lote. No puedes tratar “10 tareas, 10 veces cada una” como “100 tareas independientes” y reutilizar el cálculo de una sola tarea que vimos antes.
Hay una trampa más pequeña. Una semilla fija es útil cuando estás persiguiendo un problema de reproducción. Copiar veinte veces una salida casi idéntica obtenida con la misma semilla no equivale a veinte observaciones independientes de la distribución aleatoria de salidas. Cuando mides estabilidad, acuerda de antemano la estrategia de muestreo. Una interfaz que admite semillas puede usar varias semillas generadas por adelantado. En una que no las admite, hay que registrar ese límite. Cómo debería actualizarse un conjunto de tareas a largo plazo es otra cuestión. Al menos dentro de esta comparación, no cambies las tareas para luego unir las puntuaciones viejas y nuevas en una curva de “el modelo está mejorando”.
6. Tiempos de espera agotados, salidas truncadas y dibujos equivocados no se meten en el mismo saco
Una distorsión estadística común es puntuar solo los dibujos que regresaron con éxito y eliminar los tiempos de espera agotados y los errores. La puntuación que obtienes responde a “una vez que tengo una salida completa, ¿con qué frecuencia se aprueba?”. No responde a la pregunta que más le importa a un usuario: “si envío una solicitud, ¿obtengo un resultado aprobado?”. Supón que se programaron de antemano 20 solicitudes y que 4 agotaron el tiempo de espera. Las otras 16 devolvieron un dibujo completo, y 8 de ellos se aprobaron. La tasa de aprobación entre las salidas completas es del 50%. La tasa de primeras entregas aprobadas, contada sobre las 20 solicitudes, es del 40%. Publicar solo la primera cifra deja fuera las cuatro veces en que el usuario no recibió nada.
Yo conservaría al mismo tiempo tres tipos de resultado: una falla técnica de entrega, una respuesta completa que no cumple la tarea y una respuesta completa que sí la cumple. Los tiempos de espera agotados, los errores de la interfaz, los streams interrumpidos y los casos que llegan al límite de longitud deberían conservar cada uno su propio motivo. Registrarlos por separado no exime al servicio de una falla. Para quien elige un servicio, un tiempo de espera agotado y un dibujo equivocado le cuestan tiempo por igual. Sin embargo, cuando buscas la causa, no deberían describirse todos como “bajó la inteligencia del modelo”. Una falla de la red local o del script de prueba debe registrarse aparte. Para excluirla hace falta una regla escrita de antemano. No puedes eliminar una muestra después de ver qué lado perdió.
Prefiero que la métrica principal sea la proporción de primeras solicitudes que devuelven un resultado aprobado, y mantener junto a ella, como explicación, la tasa de aprobación del contenido entre las salidas completas, la tasa de fallas técnicas, la latencia y el costo. La tasa de aprobación del contenido en las salidas completas tampoco es una puntuación de “capacidad pura” libre de sesgo. Si las solicitudes complejas tienen más probabilidad de agotar el tiempo de espera, los dibujos que quedan pueden haber sido más fáciles desde el principio. Esa tasa puede ayudar a localizar un problema. No puede reemplazar el resultado contado sobre todas las solicitudes.
“¿Puede salir bien después de una corrección?” puede ser una prueba aparte, con la misma oportunidad de corregir para ambos lados. No guíes a un lado durante cinco rondas de correcciones para luego condenar al otro al primer error.
7. Una comparación mínima que cualquier persona puede hacer
No necesitas construir una plataforma de evaluación antes de probar un pelícano. Aquí tienes un plan inicial. Sirve para verificar una diferencia evidente en una sonda fija. No es un diseño de tamaño de muestra que garantice detectar un deterioro pequeño.
| Elemento | Acuerdo para esta ronda |
|---|---|
| Pregunta | En esta tarea fija, ¿difieren los servicios A y B en la proporción de primeras entregas aprobadas? |
| Entrada y configuración | Guardar la solicitud visible completa. Igualar los parámetros que se pueden controlar. Registrar las diferencias que no se pueden confirmar. |
| Muestra | Programar de antemano 20 solicitudes formales por lado. Dejar las ejecuciones piloto fuera de la muestra formal. |
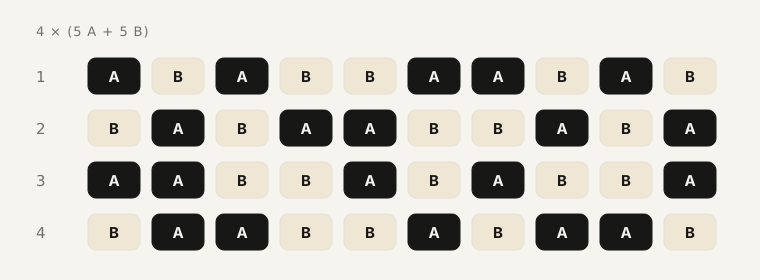
| Tiempo y orden | Dividir una ventana declarada de antemano en 4 lotes, con 5 llamadas de A y 5 de B en cada uno. Intercalarlas al azar dentro del lote, con la misma regla de concurrencia. |
| Reintentos | La prueba formal de primera respuesta no agrega reintentos. Para medir la capacidad de corregir, abrir un experimento aparte. |
| Puntuación | Fijar la regla de aprobación antes de la primera ejecución. Después de renderizar, ocultar el nombre del canal, mezclar el orden y luego puntuar. |
| Salida | Guardar todos los resultados originales, el estado de cada llamada, el motivo de cada puntuación y las estadísticas por lote y globales. |
Una regla de aprobación sencilla es un buen punto de partida para la tarea del pelícano. ¿El archivo se renderiza en el entorno acordado? ¿El sujeto y la bicicleta están lo bastante completos para reconocerlos? ¿Hay una estructura clave con un error evidente? ¿Se cumplen los contactos que exige la tarea, como el de la pata con el pedal? Puedes anotar la estética por separado. Un color cuidado no compensa un error estructural.
Si alguien duda ante una muestra límite, márcala como en disputa y sigue la regla de revisión que fijaste de antemano. No decidas si se aprueba después de ver el nombre del canal. Una prueba pequeña se puede puntuar a mano y a ciegas. Cuando crece la escala, la puntuación automática y la calibración de jueces son la siguiente cuestión. No hace falta resolverlo todo en la primera ronda. El registro es mucho más fácil si separas la configuración que pertenece a la ronda del log que tiene una fila por llamada. La configuración de la ronda guarda la plantilla original de la solicitud, los parámetros, la versión de la tarea, la versión de la regla de puntuación, la ventana de tiempo y el acuerdo sobre tiempos de espera y reintentos. Cada llamada debería registrar al menos estos campos:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathEscribe las horas con zona horaria. Relaciona la respuesta original, el SVG extraído y la imagen renderizada mediante artifact_path. El conteo de tokens, la huella del backend y cualquier otro dato que exponga la interfaz se pueden guardar junto con lo demás. Si no se proporcionó, regístralo como vacío o desconocido. request_hash sirve para verificar que la solicitud se mantuvo igual. No reemplaza a la solicitud original. Cuando guardes o compartas el log, elimina las claves de API y oculta el contexto privado y cualquier otro contenido sensible. Lo que necesita una verificación pública son las condiciones del experimento, no las credenciales de la cuenta entregadas junto con ellas.
Al resumir, mira primero la brecha global y el resultado de cada lote. El intervalo binomial y la prueba exacta de Fisher de antes se aplican cuando sus supuestos, como la independencia y la estabilidad, se cumplen aproximadamente. Si el resultado depende claramente del lote, o si después amplías la prueba a repeticiones sobre varias tareas, analiza el diseño emparejado. No reutilices de forma mecánica la fórmula de una sola tarea. Si vale la pena seguir la pista de una primera diferencia, vuelve a probarla en una ventana nueva declarada de antemano y agrega tareas relacionadas con el uso que realmente le das. La primera ronda es una pista sobre una anomalía. Una ronda nueva e independiente es lo que te ayuda a juzgar si sigue ahí.
8. Después de encontrar una diferencia, ¿cómo debería redactarse la conclusión?
Con las mismas cifras didácticas, una conclusión prudente y aun así útil podría decir lo siguiente:
Con la tarea fija de esta ronda, la configuración visible igualada y la ventana de tiempo declarada de antemano, A y B se probaron 20 veces cada uno. Las primeras entregas aprobadas fueron 16 y 8. Las tasas de aprobación de la muestra difieren en 40 puntos porcentuales. Bajo supuestos que incluyen el muestreo independiente, una prueba exacta de Fisher bilateral da un valor p de aproximadamente 0.0225, lo que respalda una diferencia en las condiciones de esta ronda. El resultado todavía debe verificarse en otras ventanas y en tareas relacionadas. Por sí solo, no permite identificar la causa concreta de un cambio en el modelo subyacente o en la configuración del servidor.
Es menos emocionante que “la prueba de que funciona a plena capacidad”. A cambio, le entrega a la siguiente persona las condiciones que necesita para volver a verificarlo. Si las pruebas posteriores, en distintos momentos y en tareas relacionadas, siguen apuntando en la misma dirección, tendremos una razón más sólida para decir que este servicio es menos confiable que la referencia para estos usos, o que realmente quedó por debajo de su propia línea base histórica. Saltar de “la entrega empeoró” a “lo cambiaron a escondidas por un modelo más pequeño” sigue siendo un paso adicional. Confirmar un mecanismo concreto requiere evidencia independiente capaz de distinguir entre explicaciones, como un registro de rutas o de configuración que se pueda verificar. El estilo de la salida no basta para adivinar el modelo.
Eso tampoco significa que un usuario tenga que esperar a conocer la causa para poder cambiar de servicio. Elegir un servicio depende de si cumple con lo que necesitas. Acusar una causa concreta depende de la evidencia sobre esa causa. Las dos cosas pueden ir por separado.
9. Lo que de verdad vale la pena ahorrar es el costo de demostrar la pregunta con claridad
Lo agotador de una prueba manual no suele ser hacer clic en ejecutar, sino el trabajo repetitivo que viene después. ¿Dónde quedó el archivo? ¿Cambiaron los parámetros? ¿De qué generación es esta imagen? ¿Fue un reintento? ¿La captura todavía se puede relacionar con la respuesta original? Sin esos registros, la convicción de que “de verdad se volvió más tonto” puede quedar reducida, una semana después, a unas pocas capturas que nadie puede volver a verificar.
Si solo quieres una primera idea de cómo se comportan distintos servicios, no hace falta que cada persona organice todo desde cero. Puedes empezar en Folkbench, revisar los rankings públicos y el acceso a los informes, y ver si el modelo, el grupo del servicio y la métrica que te interesan ya tienen un resultado. Las páginas públicas ponen énfasis en comparar servicios con el mismo modelo, y los rankings también aclaran que los datos del grupo de una fila no representan a todos los grupos de ese intermediario.7
Un ranking publicado debería reducir el costo de recopilar y organizar. No debería ser un motivo para dejar de verificar las condiciones. Folkbench incluido, siempre vale la pena seguir preguntándole a cualquier ranking: ¿cuándo se midió?, ¿qué se midió?, ¿qué tan grande fue la muestra?, ¿se conservaron las fallas?, ¿qué alcance tiene la conclusión? La información que no es pública sigue siendo desconocida. Volvamos a la pregunta inicial. ¿Cuánto de “el modelo se volvió más tonto” es real y cuánto es la ilusión de un solo intento al azar?
Antes de contar con una definición compartida, una muestra completa y condiciones comparables, publicar un único porcentaje general solo crea una nueva pieza de folclor. Lo que sí podemos hacer mejor es tomar cada sospecha concreta y convertirla, paso a paso, en un juicio que se pueda verificar. Cuando veas una falla, conserva el resultado original. Cuando sospeches un deterioro, inicia una comparación. Cuando encuentres una diferencia, entonces busca la causa. No intentes completar todos esos pasos dentro de una sola captura. Una captura puede plantear una buena pregunta. Para responderla, todavía hace falta un experimento decente.
Notas y fuentes
- OpenAI, How to make your completions outputs consistent with the new seed parameter, un ejemplo archivado del Cookbook. La nota describe una semilla fija como un esfuerzo por lograr determinismo, no como una garantía. Este artículo cita solo ese límite de la reproducibilidad. No toma los nombres de modelos antiguos ni los parámetros admitidos en esa página como una descripción actual del producto. Fuente↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, sección 7.2.4.1, Confidence intervals, intervalo de Wilson para una proporción. Este artículo usa intervalos de Wilson bilaterales del 95% para 16/20 y 8/20. La autora los calculó con la fórmula y los redondeó a un decimal en porcentaje. El nivel de confianza describe la cobertura a largo plazo del método de construcción del intervalo. El método de Wilson es una aproximación. Fuente↩
- Documentación de SciPy,
scipy.stats.fisher_exact. Este artículo usa la tabla de contingencia[[16, 4], [8, 12]]conalternative="two-sided"y obtienep = 0.0224774273717544. Es un cálculo sobre los datos del ejemplo, no un resultado medido en un artículo académico ni en un informe de una plataforma. El ejemplo compara resultados binomiales independientes. Los datos emparejados, el agrupamiento entre tareas, la dependencia temporal o las comparaciones múltiples requieren un análisis acorde con el diseño. Fuente↩ - Yuling Gu et al., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. El artículo analiza detalles de evaluación como el formato del prompt, la elección de ejemplos en contexto y la redacción de la tarea, y lo que requiere una comparación reproducible. Fuente↩
- Ramesh Johari, Leo Pekelis y David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, revisión de 2019. El artículo analiza el problema de observar los resultados de forma continua y dejar que eso determine el tamaño de la muestra, así como los métodos de inferencia secuencial que lo resuelven. Fuente↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Sobre la incertidumbre a nivel de tarea, el muestreo repetido, las comparaciones emparejadas y las muestras agrupadas, consulta las secciones 2, 3 y 4. Sobre la planificación del tamaño de muestra, consulta la sección 5. Fuente↩
- Páginas públicas de inicio y de rankings de Folkbench, consultadas el 5 de octubre de 2026. Este artículo usa esas páginas públicas solo para describir el punto de acceso, el alcance de la comparación y el aviso sobre los grupos. No respalda de forma independiente ninguna cifra concreta de los rankings ni afirma que Folkbench ya implemente todos los procedimientos experimentales que aquí se proponen. Inicio; Rankings↩