El primer artículo decía que no hay que confiar en una sola captura de pantalla. Este se pregunta por qué tampoco hay que confiar en una puntuación.
Supongamos que hay tres pelícanos en bicicleta. El primero está dibujado con mucho cuidado: plumas en capas, brillos en las ruedas y hasta un atardecer de fondo. Pero si lo miras de cerca, los dos pies quedan suspendidos por encima de los pedales. El segundo parece un boceto de unos cuantos trazos: no tiene sombras ni una paleta de colores atractiva. Aun así, el cuadro está bien conectado, el cuerpo va sentado en el asiento y los pies sí están sobre los pedales. En una captura estática, al tercero no se le ve ningún problema. Pero en cuanto le das reproducir, un pie empieza a flotar por su propia trayectoria: el pedal gira por un lado y el pelícano pedalea por otro. ¿Cuál debería obtener la puntuación más alta?
Si la respuesta es “el primero es el más bonito”, estamos evaluando el gusto. Si la respuesta es “el segundo es el más confiable”, estamos evaluando si se cumplió la tarea. Y si solo miramos una captura, quizá nunca descubramos el error del tercero.
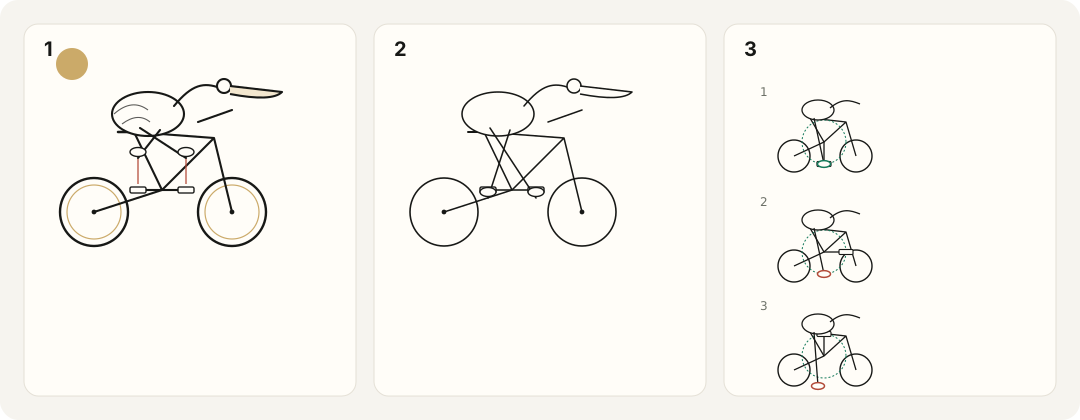
El artículo anterior sostenía que, para saber si un modelo de verdad empeoró, no basta con elegir una sola salida: hay que repetir la prueba en condiciones comparables. Pero ese argumento esconde una premisa que todavía no está resuelta: ya sabemos qué cuenta como apto. Si esa premisa es falsa, repetir la prueba no vuelve creíble la conclusión por sí solo. Quizá solo consiga que una vara de medir sesgada mida cada vez de forma más estable. Este artículo empieza ahí. ¿Cómo convertimos “este pelícano se ve bien” en un método de evaluación que tenga fundamento, se pueda revisar y se pueda automatizar paso a paso?
Nota: las muestras, cifras, esquemas de puntuación y configuraciones de este artículo son ejemplos metodológicos. No corresponden a un ranking real de modelos ni significan que Folkbench ya haya implementado estos procedimientos. Las investigaciones citadas sirven para explicar métodos y riesgos relacionados; no implican que la propuesta de este artículo se haya validado experimentalmente.
1. Escribe el enunciado antes de discutir cómo puntuarlo
La prueba del pelícano atrae porque deja el error dibujado a la vista. Una pata de más, un cuadro que no conecta o un pie que no alcanza el pedal son difíciles de disimular con una frase bien redactada. Aun así, hay que precisar qué mide en realidad. Pedirle a un modelo que “dibuje en SVG un pelícano en bicicleta” permite observar directamente si puede convertir una instrucción escrita en código, y si ese código produce una imagen que cumple lo pedido. Ese resultado, por sí solo, no establece qué representación espacial usó internamente. Tampoco permite que “le fue bien en este ítem” equivalga a “tiene una capacidad completa de comprensión espacial”.
Si el modelo puede renderizar, ver la imagen y corregirla una y otra vez, lo que se mide es un flujo de trabajo con retroalimentación, no una sola generación de código. Las dos cosas vale la pena medirlas, pero no deberían mezclarse en el mismo ranking de primera respuesta. El punto más práctico es este: un requisito que no estaba escrito en el enunciado no debería aparecer de pronto a la hora de puntuar. Si el enunciado original solo dice “dibuja un pelícano en bicicleta”, no deberíamos exigir después una bicicleta de ruta estándar, dos ruedas exactamente del mismo tamaño, las dos alas sobre el manubrio o que todas las piezas queden claramente a la vista. Una perspectiva razonable, la oclusión y el estilo caricaturesco forman parte del dibujo libre. Yo dividiría la prueba en dos tipos.
Uno conserva el enunciado abierto y observa cómo el modelo entiende y expresa “montar” en bicicleta. La puntuación solo recoge los requisitos claros y necesarios, y acepta que las muestras límite pueden ser discutibles. El otro es un enunciado restringido: antes de ejecutarlo, se fijan el punto de vista, las relaciones visibles, el formato de salida y las técnicas permitidas. Por ejemplo: la vista es principalmente lateral; se permite un leve desfase para mostrar los dos pies; el contacto de cada pie con su pedal debe verse; la entrega es un único SVG autocontenido; no se usan imágenes externas ni scripts.
Un enunciado restringido modifica el original. Eso no es un defecto. Una vez que se etiqueta la versión del enunciado, permite hacer una pregunta más concreta: ¿el modelo no respetó el punto de vista, no dejó claro el contacto o dibujó mal la estructura de la bicicleta? Lo importante no es cuál versión es más “auténtica”. Un enunciado abierto se puntúa como abierto, y uno restringido, como restringido. No combines un enunciado vago con un criterio estricto inventado después.
2. No te apresures con el total. Primero descompón “montar”
“En general está bien. Ocho puntos.” Es la forma más cómoda de puntuar y la más difícil de revisar. ¿El 8 se debe a que el sujeto es correcto, a que la estructura es razonable o a que la paleta es agradable? La próxima vez que aparezca el mismo error, ¿el juez le dará un 9? Yo empezaría con cuatro dimensiones, pero sin tratarlas como cuatro números que se llenan a ojo.
| Dimensión | Qué verifica principalmente | Qué no debe mezclarse |
|---|---|---|
| Pelican: el sujeto | Si se reconoce como pelícano; si el cuerpo o las extremidades presentan anomalías evidentes; si cumple la visibilidad que el enunciado exigió explícitamente | Un grado de realismo, detalle del plumaje o preferencias personales de estilo que el enunciado no pidió |
| Bicycle: la bicicleta | Si las ruedas, el cuadro, la biela, los pedales y demás forman la estructura razonable que pidió el enunciado | Una marca, un modelo, adornos o una forma particular de escribir el SVG que el enunciado no pidió |
| Riding: la relación de montar | Si el cuerpo tiene un apoyo razonable; si los pies corresponden a los pedales; si se cumple la relación de control que pidió el enunciado | Solo que “el ave está junto a la bicicleta” o que “los dos objetos existen” |
| Animation: la relación en el tiempo | Si ocurre el movimiento exigido; si el contacto y la conexión se mantienen durante el movimiento; si hay saltos o interpenetraciones poco razonables | Una animación que un enunciado estático nunca pidió; efectos ajenos a la tarea |
Que un objeto exista no significa que una relación se cumpla. “Hay un pie” y “hay un pedal” son dos juicios sobre objetos. “El pie está sobre el pedal” es un juicio sobre una relación. Un paso más allá, “el pie sigue sobre el pedal mientras el pedal gira” es un juicio sobre una relación a lo largo del tiempo. Por eso no basta en absoluto con verificar “si están el pelícano, la bicicleta y las dos ruedas”. Lo que hay que separar es el vínculo entre el cuerpo y el asiento, el pie y el pedal, el pedal y la biela, y el cuadro y el eje de la rueda.
Hay trabajos relacionados de los que se puede aprender. TIFA convierte los requisitos de un texto en varias preguntas y luego usa respuesta visual a preguntas para verificar si una imagen generada los cumple. No es un evaluador de pelícanos listo para usar, pero sí muestra una dirección útil: verificar la imagen contra los requisitos uno por uno, en lugar de dar solo una impresión general.1 Para la implementación, yo mantendría cuatro estados en cada verificación: pass, fail, uncertain y not_applicable, que significan aprobado, fallido, evidencia insuficiente y no aplicable.
La distinción clave está entre los dos últimos. Si un enunciado estático no pidió animación, Animation es “no aplicable”. Si se pidió animación pero el material no alcanza para juzgar si hay interpenetración, eso es “evidencia insuficiente”. Lo primero no debería restar puntos; lo segundo no puede contarse automáticamente como aprobado. Después, separa los ítems en condiciones necesarias y criterios de calidad adicionales. Las condiciones necesarias deciden si el resultado es apto; los criterios adicionales describen el detalle y la apariencia. Una falla clara en una condición necesaria no se compensa con plumas bonitas, un fondo o un degradado.
Un informe inicial puede limitarse a decir cuántas verificaciones del sujeto se aprobaron, en qué ítem falló la estructura de la bicicleta, si la relación de montar tiene alguna duda pendiente y si la animación aplica. No necesita un total con dos decimales de precisión. Si de verdad hace falta una puntuación combinada, publica de antemano los ítems aplicables, los pesos y el tratamiento de los valores faltantes, y muestra por separado las fallas en condiciones necesarias. También vale la pena verificar si los ordenamientos que resultan de pesos distintos son robustos. El total es un resumen comprimido. No es una razón para reemplazar la evidencia original.
3. El DOM del SVG ayuda, pero no es un diagrama estructural que venga con la respuesta
Ante un SVG, el instinto de ingeniería es fácil: tiene código fuente, así que ¿por qué no analizarlo directamente? Las reglas se escriben rápido. Si hay dos elementos circle, hay dos ruedas. Si hay un elemento llamado foot, hay un pie. Si los cuadros delimitadores del pie y del pedal se cruzan, el pie está sobre el pedal. El problema es que cada uno de esos pasos confunde “una forma de expresarlo en el código” con “un hecho semántico de la imagen”.
Una rueda puede ser un elemento de círculo o un trazado. Dos ruedas pueden escribirse por separado o reutilizarse con use. Un mismo objeto visual también puede estar formado por varios grupos y trazados. La especificación de SVG permite estas expresiones distintas y no exige que un objeto del mundo real corresponda a un solo nodo del DOM.2 Así que no encontrar dos elementos circle no demuestra que falte una rueda, y encontrar dos no demuestra que estén en un lugar razonable. Que un elemento se llame foot es solo el nombre que le dio quien lo generó, no una verificación independiente.
Las reglas estáticas sirven sobre todo para restricciones que se pueden determinar
Por ejemplo: si la salida se puede analizar en el formato acordado, si contiene alguna referencia externa que el enunciado prohíbe, si contiene un script no permitido y si renderiza contenido no vacío en el entorno indicado. Estas verificaciones tienen una base clara y es fácil dejar registro de ellas. Responden a “si cumple las restricciones de entrega y técnicas”, no a “si esta ave montó bien la bicicleta”. Que se renderice correctamente tampoco reemplaza la verificación de formato. La especificación de SVG distingue formas de documento y modos de procesamiento. Un fragmento incrustado en una página web y un archivo SVG independiente no deberían aceptarse con el mismo requisito de análisis, salvo que esa decisión se haya explicitado.3
Una verificación geométrica primero tiene que aclarar qué está midiendo
Una vez identificadas de forma confiable las regiones geométricas visibles que corresponden al pie y al pedal, se pueden calcular la distancia, la superposición y la trayectoria. Por ejemplo, si divides la distancia entre la planta del pie y la superficie de contacto del pedal por un diámetro de rueda de referencia acordado en la misma imagen, obtienes una distancia relativa. Hablar de “qué tan lejos está del pedal” de esa forma es más interpretable que aplicar un umbral fijo en píxeles. Aun así, cómo se define la superficie de contacto y cuánto error se tolera todavía hay que calibrarlo con muestras anotadas. No se puede anunciar de la nada que “cinco píxeles de diferencia son sin duda un error”.
La medición también tiene que considerar las transformaciones de coordenadas, el trazo, el recorte y la visibilidad real. Un elemento SVG puede estar en un sistema de coordenadas anidado, y la especificación también contempla casos en que un elemento que no se renderiza sigue teniendo un cuadro delimitador. Tener un cuadro delimitador no es lo mismo que tener el contorno del objeto visible en la imagen.4 Que dos cuadros delimitadores se crucen no significa que la planta del pie toque el pedal. Dos regiones planas que se superponen pueden ser solo una oclusión en profundidad, no un apoyo razonable. En un SVG cualquiera, las reglas geométricas sirven mejor como evidencia auxiliar, una vez validadas, que como un juez sin calibrar con poder de veto.
Para automatizar, se puede exigir un conjunto uniforme de ID de piezas, puntos clave y estructura de grupos. Pero eso debería ser una vía aparte de “salida estructurada”: verificar si esas declaraciones corresponden a la imagen real. No se trata de que el modelo escriba “el contacto es correcto” y el programa de evaluación se lo crea. El DOM nos da más información verificable. No resuelve gratis el reconocimiento semántico.
4. Antes de poner a trabajar a un juez visual, hazle un examen
Si las reglas estáticas no bastan, que puntúe un modelo capaz de ver imágenes. Vale la pena seguir ese camino. Pero “el modelo puede describir una imagen” no debería tomarse como “el modelo puede juzgar de forma estable un error espacial sutil”. El trabajo de 2023 sobre MT-Bench y Chatbot Arena analiza el sesgo de posición, el sesgo de verbosidad y la autopreferencia de los jueces basados en LLM, y también informa que los modelos fuertes coincidían bastante bien con la preferencia humana en ciertas evaluaciones de texto. La conclusión razonable no es “ningún juez basado en modelos es confiable”, sino “su credibilidad depende de la tarea y hay que verificarla”. Esos resultados de evaluación de texto tampoco pueden usarse directamente como tasa de acierto de la puntuación visual.5
La capacidad visual también hay que verificarla. El estudio BlindTest de 2024 encontró que los modelos de visión y lenguaje que evaluó todavía se equivocaban en geometría simple, como si dos círculos se superponen o si dos líneas se cruzan. Eso no significa que todos los modelos actuales sigan en el nivel de aquel año, pero basta para recordar que no hay que dar por bien juzgada una relación de contacto sutil solo porque el modelo es conocido.6 Yo construiría primero un conjunto de muestras de referencia anotadas por personas, en lugar de entregarle el ranking a un juez de inmediato.
El conjunto necesita aciertos evidentes y errores evidentes, pero también casos límite: bocetos, líneas finas, oclusiones razonables, trazados complejos y obras que se ven bien en reposo pero fallan en movimiento. Procura que al menos dos anotadores puntúen de forma independiente y a ciegas, y luego revisen los desacuerdos. Las personas tampoco son una verdad absoluta. Si dos personas que leen la misma regla llegan una y otra vez a conclusiones opuestas, quizá lo primero que haya que corregir sea el enunciado o las instrucciones de puntuación. Una muestra que no se puede aclarar puede quedar como disputada; no hace falta inventarle una “respuesta correcta”.
El juez debe responder preguntas concretas, no opinar sobre estética
Dale el enunciado original, las reglas de puntuación congeladas y una imagen renderizada de forma uniforme. En un ítem de animación, también fotogramas con marca de tiempo o un video. No le des además el nombre del servicio, la posición en un ranking ni la declaración del propio modelo generador de que “esta imagen cumple por completo los requisitos”. Pídele que juzgue ítem por ítem: “¿Cada pie toca su propio pedal?”, “¿El cuadro visible se conecta de forma razonable con los ejes delantero y trasero?”, “En estos momentos, ¿se mantiene el vínculo entre el pie y el pedal?”.
Cada juicio debe ir acompañado de una evidencia breve y localizable, por ejemplo: “en el segundo 2.0, el pie más cercano al observador tiene una separación evidente del pedal”. Cuando la evidencia no alcance, el juez debe devolver uncertain, en lugar de disimular con un párrafo fluido lo que no se ve con claridad. El texto dentro de la imagen, los comentarios del SVG y los metadatos solo pueden ser contenido evaluado, nunca instrucciones que cambien las reglas de puntuación. Ocultar un nombre de archivo o una etiqueta de canal no autoriza a modificar la obra. Si hace falta un recorte o una imagen auxiliar anotada, conserva el original junto con un registro del procesamiento.
La calibración no puede apoyarse en una sola “tasa de acuerdo global”
Supongamos que un conjunto de referencia tiene 90 imágenes aptas y 10 con un error grave. Un juez que siempre responde “aprobado” obtiene igualmente un 90% de exactitud global y deja pasar todos los errores graves. Por eso yo verificaría por separado cuántos errores críticos se pasaron por alto, cuántas obras correctas se rechazaron, si el desempeño es parejo entre estilos y si las puntuaciones repetidas de una misma obra son estables. En las muestras límite, también hay que ver si el juez está dispuesto a admitir que la evidencia no alcanza.
Son útiles unas pocas muestras que “cambian un solo factor”: conservar el original y separar un pie del pedal, o cambiar solo el fondo sin tocar la estructura. El primer cambio debería afectar la puntuación correspondiente; el segundo no debería alterar sin motivo un juicio estructural. Estas muestras construidas sirven para diagnosticar, pero no pueden reemplazar del todo la salida real de los modelos. Las muestras que se usan para ajustar el prompt de puntuación y las muestras reservadas para la verificación final del juez tienen que mantenerse separadas. No hay que ajustar contra las mismas respuestas hasta que el resultado se vea satisfactorio y luego presentar esa puntuación como prueba de generalización.
Una votación entre varios jueces puede sacar a la luz los desacuerdos, pero usar tres modelos no vuelve independientes los tres juicios: pueden compartir el mismo error. Que un juez afirme “tengo un 95% de certeza” no puede, sin calibración, tomarse como un 95% de exactitud real. Lo que un juez tiene que demostrar es que sabe reconocer un error, no solo que sabe explicar su puntuación.
5. La animación no son unas capturas de más. Verifica si una relación se rompe con el tiempo
Una puntuación estática pregunta “¿está sobre el pedal ahora?”. Una puntuación de animación pregunta “cuando empieza a moverse, ¿esa relación se sigue cumpliendo?”. Que un pie toque el pedal justo en el primer fotograma no significa que después siga la trayectoria del pedal. Y al revés: dejar fijos el pie y el pedal para que ninguno se mueva no completa el pedaleo que el enunciado haya exigido. Por eso la animación plantea al menos dos preguntas distintas: si lo que debe moverse se mueve de verdad, y si la conexión que debe mantenerse durante el movimiento se mantiene.
Primero hay que acordar la escena de la animación. Pedalear sin desplazarse, avanzar y una cámara que sigue al ciclista son tareas distintas. Si el enunciado no pidió una simulación mecánica precisa, no hay que agregar a escondidas restricciones extra, como una relación de transmisión. Si pide explícitamente que la biela gire y que el pie siga en contacto con el pedal, esos requisitos forman parte de la aceptación.
El entorno de evaluación también tiene que conservar el estado real de la animación. Aquí hay una trampa de ingeniería muy concreta. La opción de captura de Playwright animations="disabled" detiene las animaciones compatibles: las finitas se adelantan hasta el final y las infinitas se cancelan y vuelven a su estado inicial. No es sinónimo de “capturar con exactitud un instante cualquiera”.7 Por eso no se puede dar por aprobada una animación porque alguien la desactivó y capturó una imagen bonita. Primero usa un archivo de prueba con un movimiento conocido para verificar el control del tiempo y el método de captura, y solo después aplícalo a la salida del modelo. También conviene dejar por escrito qué mecanismos de animación se admiten.
Supongamos que el enunciado pide un bucle de 4 segundos. Un plan inicial es observar dos bucles completos, muestrear a una frecuencia fijada de antemano y revisar además la transición entre bucles y cualquier tramo que parezca fallar. La ventana de observación, la frecuencia de muestreo y las reglas de verificación adicional deberían fijarse antes de la evaluación formal, no endurecerse después de ver de qué lado aparece el problema. Aun así, un conjunto finito de fotogramas puede pasar por alto una anomalía breve entre un fotograma y otro. El informe debería decir “no se encontraron errores evidentes con la ventana y las condiciones de muestreo acordadas”, no “queda demostrado matemáticamente que nunca hubo interpenetración”.
También hay que tener cuidado con la oclusión normal en una imagen plana. Cuando una pata pasa por detrás del cuadro, que los contornos se superpongan no significa automáticamente que haya interpenetración. Lo que hay que verificar es si el orden de profundidad o la conexión cambian de forma poco razonable. Ampliar una zona ayuda a observar, pero no debería hacer perder el contexto espacial general. Si, por ahora, un juez automático solo maneja de forma confiable imágenes estáticas, publica los resultados estáticos y deja la animación a la revisión humana. Es mejor admitir que esta vara de medir todavía no llega hasta ahí que meter en un total una capacidad que no se midió.
6. El sistema de puntuación también se equivoca, y puede crear la ilusión de que un modelo empeoró de repente
Las verificaciones estáticas, un juez visual y la revisión humana no cierran el problema, porque el propio sistema también puede cambiar. Ayer, el juez era indulgente con una separación leve. Hoy, una versión nueva descuenta con rigor. La obra generada no cambió en nada, pero la tasa de aptos del ranking baja. Si solo se guarda “nombre del modelo, fecha, total”, es fácil confundir un cambio del juez con una degradación del modelo. Además del modelo generador y de los parámetros de la solicitud, registra la versión del enunciado, la versión de la rúbrica, el modelo y la configuración del juez, la versión del renderizador y la versión del verificador automático. Un cambio en cualquiera de ellos puede cambiar lo que significa una puntuación.
Antes de reemplazar un juez o una regla, yo haría que la versión anterior y la nueva puntuaran las mismas obras guardadas, y vería dónde se concentran las diferencias. Las obras históricas se pueden volver a puntuar cuando haga falta, pero eso debe etiquetarse como “una nueva puntuación del mismo artefacto”, no disfrazarse como si el modelo acabara de responder otra vez.
Otro tipo de problema es una evaluación que no terminó. Un tiempo de espera agotado en el servicio, un SVG dañado, un programa de captura que se cae o una solicitud al juez que falla no deberían agruparse todos como “el modelo lo dibujó mal”. Si la propia obra incumple las reglas, se puede marcar como fallida según la regla fijada de antemano. Si falló la infraestructura de evaluación, registra la evaluación como sin resolver y complétala mediante un procedimiento fijo. En una obra, basta con que una condición necesaria haya fallado claramente para marcar el resultado completo como no apto. Y en sentido inverso: si nada ha fallado claramente, pero una condición necesaria sigue sin poder determinarse, no se puede dejar pasar sin más.
Supongamos que, de 100 solicitudes programadas, 72 se confirmaron como aptas, 18 como no aptas y 10 siguen sin decidirse. El informe puede presentar primero esas tres cifras, en lugar de eliminar las muestras sin resolver y anunciar “una tasa de aptos del 80%”. Si por ahora se dan por correctas las etiquetas ya decididas, la proporción final de aptos de este lote puede quedar entre el 72% y el 82%: el límite inferior cuenta como fallido cada ítem sin resolver, y el superior, como aprobado. Ese rango proviene de las etiquetas sin resolver. No es un intervalo de confianza estadístico, y no incluye el error del juez ni la incertidumbre de generalizar a otras muestras.
La revisión humana tampoco puede limitarse a las fallas y disputas que marcó el juez. También hay que revisar una muestra aleatoria, definida de antemano, de las obras que se aprobaron automáticamente. De lo contrario, los errores no detectados más peligrosos pueden quedar escondidos en la zona de “aprobado”. Ninguna evaluación automática puede demostrar que no se equivoca alegando que nunca se ha descubierto en un error. Necesita un procedimiento de auditoría capaz de encontrar activamente sus propios errores.
7. Los enunciados envejecen, pero cambiarlos todos los días no es más científico
Cuando un ítem se vuelve viral, aparecen ejemplos, tutoriales, consejos para corregirlo y optimizaciones hechas específicamente para él. Ver que un modelo dibuja bien un pelícano no basta, por sí solo, para afirmar que hizo trampa. La exposición de un ítem público, el aprendizaje de un tipo de tarea y la entrada de muestras de prueba en los datos de entrenamiento son problemas de niveles distintos. Saber si un modelo concreto vio un material de prueba concreto requiere evidencia. “Este ítem es demasiado famoso” no es esa evidencia.
Aun así, que el material de prueba entre en los datos de entrenamiento es un riesgo que la evaluación tiene que enfrentar. Entre las prácticas de LiveBench están usar fuentes de información más recientes, actualizar los ítems de forma continua y puntuar automáticamente contra respuestas verificables. Es una práctica para reducir ese riesgo, no una garantía de que “si cambias los ítems cada mes, no hay contaminación en absoluto”.8 Para un ítem de generación abierta como el pelícano, prefiero mantener tres usos distintos de los ítems: ítems centrales estables, para observar el cambio a largo plazo; ítems de ampliación que rotan, para observar la transferencia; e ítems reservados que todavía no son públicos, para verificar después de congelar el procedimiento, no para retocar las reglas sin fin.
El valor de un ítem central es la comparabilidad, no la inmunidad a la contaminación del entrenamiento. El valor de un ítem de ampliación es cubrir más terreno, no un enunciado más extraño.
Lo que vale la pena cambiar es la restricción, no solo el nombre del protagonista
Cambiar el pelícano por un pato es un cambio, pero no modifica automáticamente la estructura de la relación. Una variante con más valor diagnóstico cambia una condición a propósito. Si se invierte la orientación, ¿la conexión sigue siendo correcta? Si aumenta la oclusión, ¿las piezas clave siguen completas? Si el enunciado dice “de pie junto a la bicicleta, empujándola”, ¿el modelo sigue aplicando una postura de montar? Cuando la misma relación de contacto pasa a una animación, ¿falla?
La tarea también puede cambiar a otra relación: una mano que sostiene el asa de una taza, un objeto apoyado en una bandeja o varias piezas conectadas en un orden indicado. Lo importante no es amontonar todos los requisitos raros en una sola imagen, sino saber qué pone a prueba cada variante. Sustituir mecánicamente cien animales en una misma plantilla puede, claro, producir cien ítems, pero eso no significa que se obtuvieron cien evidencias independientes de una capacidad. Al consolidar los resultados, hay que conservar la categoría de la tarea y la familia de plantillas, para que una plantilla no acapare la mayor parte del total solo porque tiene muchas variantes.
Los ítems nuevos generados automáticamente también necesitan aceptación. Un ítem puede ser vago, contradictorio o imposible de verificar a partir de la imagen final. Si el ítem, la respuesta y las reglas del juez los propone un mismo modelo, y luego ese mismo modelo confirma que son correctos, una verificación independiente es todavía más necesaria.
Al actualizar el banco de ítems, no hagas pasar un cambio de dificultad por progreso del modelo
Ochenta puntos este mes y noventa el próximo no significan necesariamente que el modelo haya mejorado: puede que los ítems nuevos simplemente sean más fáciles. Cuando un banco anterior se reemplaza por uno nuevo, es mejor conservar ítems en común y hacer que un conjunto de sistemas de referencia resuelva ambos bancos en condiciones similares. Informa por separado el cambio en cada categoría de tarea. Ni los ítems en común ni los sistemas de referencia son una verdad que se mantenga correcta para siempre. Ayudan a identificar el cambio, pero no completan automáticamente una equiparación estricta de dificultad. Cuando la evidencia no alcanza, lo honesto es mostrar los resultados por versión, en lugar de unir en una sola curva las puntuaciones brutas de pruebas distintas.
Un ítem retirado se puede publicar para que otras personas lo revisen, aprendan de él y lo mejoren. Una vez público, su papel puede pasar de “una verificación aún no vista” a “una prueba de regresión repetible”. Un ítem no está limitado a un solo uso, pero tampoco puede servir para siempre como el mismo instrumento de medición. El objetivo de un banco de ítems dinámico no es perseguir la novedad eternamente. Es administrar qué conclusiones puede respaldar un ítem en cada etapa.
8. Lo que de verdad vale la pena automatizar es un procedimiento que se pueda auditar después
A estas alturas, es fácil que el plan crezca cada vez más: varios jueces, análisis de trayectorias, un banco de ítems dinámico, arbitraje automático, y que nada sea opcional. Una versión mínima utilizable no tiene que empezar como una fábrica totalmente automatizada. Elige un conjunto pequeño de ítems, escribe las condiciones de aceptación, recopila salidas reales, construye una referencia humana y luego verifica qué ítems se pueden delegar a reglas y cuáles a un juez visual. Lo que todavía no se automatiza de forma confiable sigue en manos de personas.
Mientras haya pocos datos, el objetivo es encontrar huecos en las reglas, no anunciar que “la exactitud de la puntuación ya alcanzó cierto nivel”. Una verificación formal de la capacidad automatizada requiere un conjunto de muestras reservado aparte, además de informar la incertidumbre. Un procedimiento razonable es:
Congelar el enunciado y las reglas de aceptación → generar según lo planeado → guardar la salida original completa
→ analizar y renderizar de forma controlada → verificaciones estáticas / puntuación visual ítem por ítem
→ revisar las disputas según las reglas y muestrear los ítems aprobados automáticamente
→ resumir los resultados de la primera entrega, el desempeño por ítem y lo que sigue sin resolver
Cada paso debería poder rastrearse hasta el anterior. La respuesta original, el SVG extraído, la imagen renderizada real, el registro de observación de la animación, la respuesta original del juez y la conclusión de la revisión quedan vinculados por un mismo identificador de ejecución. Cuando extraigas o normalices un archivo, guarda la versión de antes y la de después. Si hubo que reparar un fragmento del SVG para que se renderizara, regístralo como resultado de un procedimiento de reparación; no sobrescribas en silencio la primera respuesta. Cuando se actualicen las reglas de puntuación, agrega un registro de evaluación nuevo en lugar de borrar el anterior.
Hay una premisa de ingeniería que no se puede omitir: tratar la salida del modelo como contenido no confiable. Los modos de procesamiento de SVG pueden involucrar scripts, eventos y recursos externos. Que “la extensión dice que es una imagen” no significa que sea seguro ejecutarla en un navegador donde alguien tiene la sesión iniciada para su uso diario.3
El entorno de renderizado debería aislar las credenciales de las cuentas, la red y los archivos del sistema anfitrión, limitar el uso de recursos y usar una configuración de sandbox adecuada para contenido no confiable. Usar Playwright no resuelve el problema solo porque el navegador “se metió en Docker”. Su documentación advierte explícitamente sobre las limitaciones de la imagen de contenedor predeterminada y sobre la relación entre ejecutar como root y el sandbox de Chromium.9 Las medidas de seguridad concretas todavía hay que verificarlas en el entorno donde se ejecutan. Lo que permite el enunciado y lo que permite el entorno de ejecución deberían acordarse de antemano. No dejes que el modelo use scripts para luego, al puntuar, desactivarlos todos sin avisar.
Lo que de verdad hay que ahorrar no es “verificar con cuidado”, sino el trabajo repetitivo de volver a buscar el archivo, comparar los parámetros y completar la marca de tiempo en cada verificación.
9. Un ranking que valga la pena leer debe permitir seguir haciéndole preguntas
Cuando veo una puntuación, quiero poder averiguar a qué servicio de modelo corresponde, a qué banco de ítems y a qué ventana de tiempo; cuántas muestras hubo y si se conservaron las fallas y los casos sin resolver; quién puntuó, cómo se calibró y si se puede encontrar la base de cada juicio. Esa información dice más sobre si una evaluación se tomó en serio sus propios límites que un total que parece muy preciso.
Si no vas a construir el procedimiento por tu cuenta, puedes empezar por el ranking público, los informes y las notas de evaluación de Folkbench, y verificar si el modelo y el servicio que te interesan ya tienen un resultado publicado aplicable. Su página de inicio pública describe la comparación como servicios distintos de un mismo modelo. La cobertura, el estado de las funciones y la base de cada conclusión deben consultarse en la información pública vigente en ese momento.10
Esto aplica tanto a Folkbench como a otros rankings. La información que falta sigue siendo desconocida. La presentación de una plataforma no reemplaza el informe real. La propuesta de evaluación de este artículo no equivale a una capacidad que alguna plataforma ya tenga. Una buena evaluación no le pide al lector “confía en esta puntuación mía”: le permite seguir la puntuación hasta la obra, las condiciones, las reglas y los desacuerdos. Volvamos a los tres pelícanos.
No hace falta discutir si el primero es el más bonito, ni aprobar toda la animación del tercero porque un fotograma se ve bien. Una vez acordado qué se mide y registrada la evidencia con claridad, mucho de lo que se llama misterio se convierte en una pregunta que se puede discutir ítem por ítem. El primer artículo decía que una captura puede plantear una buena pregunta, pero que responderla requiere un experimento serio. Lo que este quiere agregar es: un experimento serio también necesita una vara de medir que ya se haya verificado.
Apéndice A. Un enunciado restringido y una tabla de aceptación para empezar
El ítem estático siguiente es un ejemplo diseñado para este artículo. No es un estándar de la industria ni el ítem oficial de ninguna plataforma. Antes de usarlo, conviene probarlo y calibrarlo con anotaciones. Una vez que empiece una comparación formal, no cambies el ítem en función de los resultados.
Ejemplo de prompt
Devuelve solo el contenido de un único archivo SVG estático y autocontenido que se pueda abrir por sí solo.
Usa el viewBox "0 0 800 600". No agregues un bloque de código Markdown ni explicaciones.

Dibuja un pelícano caricaturesco montado en una bicicleta común de dos ruedas.
Usa una vista principalmente lateral. Se permite un leve desfase de las piezas para que la relación de montar se vea con claridad.

El dibujo debe cumplir todo lo siguiente:
1. El pelícano y la bicicleta caben completos en el encuadre, sin patas de más.
2. Se reconocen las ruedas delantera y trasera, el cuadro, el asiento, el manubrio, la biela y los dos pedales.
   El cuadro se conecta de forma razonable con los ejes de ambas ruedas, y los pedales se relacionan de forma razonable con la biela.
3. El cuerpo va sentado en el asiento. Cada pie toca su propio pedal,
   y ambos contactos deben verse con claridad. Al menos un ala toca el manubrio.
4. Usa solo gráficos vectoriales SVG y estilos en línea. No uses mapas de bits incrustados, recursos externos,
   scripts, foreignObject ni animación.

No se requiere realismo, fondo complejo, textura de plumas ni efectos decorativos.
Ejemplo de tabla de aceptación
| ID | Verificación | Tipo |
|---|---|---|
| F1 | Cumple el formato de archivo independiente, el área de visualización y los límites de recursos acordados | Condición necesaria |
| P1 | El sujeto se reconoce como pelícano, la imagen está completa y no hay patas de más evidentes | Condición necesaria |
| B1 | Se reconocen dos ruedas, el cuadro, el asiento, el manubrio, la biela y los dos pedales | Condición necesaria |
| B2 | El cuadro se conecta de forma razonable con ambos ejes, y los pedales se relacionan de forma razonable con la biela | Condición necesaria |
| R1 | El cuerpo y el asiento forman un apoyo claro en posición sentada | Condición necesaria |
| R2 | Cada pie toca su propio pedal y los contactos cumplen el requisito de visibilidad | Condición necesaria |
| R3 | Al menos un ala toca el manubrio | Condición necesaria |
| A | Este ítem es estático. No se puso a prueba la animación | No aplica |
| Q1 | Color, línea y detalle | Criterio de presentación opcional. No compensa una condición necesaria fallida |
“Reconocible”, “razonable” y “claro” todavía necesitan ejemplos positivos y negativos emparejados y una nota sobre los casos límite. La tabla es un esqueleto de las reglas; unas cuantas frases no eliminan por sí solas el juicio subjetivo. El resultado es apto solo cuando se aprueban todas las condiciones necesarias. Una falla clara en una condición necesaria lo vuelve no apto. Si nada ha fallado claramente, pero hay una condición necesaria sin resolver, pasa a revisión. R3 se verifica porque este prompt de ejemplo lo exige explícitamente; no debería aplicarse, sin decirlo, a todos los ítems del pelícano.
Apéndice B. Ejemplo de un registro de salida del juez
El JSON siguiente es un registro ficticio de un solo ítem. Muestra cómo se relacionan los campos y no corresponde a una imagen real. No es un informe completo ni una configuración que alguna biblioteca pueda ejecutar directamente.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "El pie más cercano al observador tiene una separación claramente visible del pedal que le corresponde."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id debería permitir localizar el modelo concreto del juez, el prompt, los parámetros y el registro de versión. render_profile_id debería permitir localizar el navegador, el área de visualización y las demás configuraciones relacionadas. La evidencia de animación debería registrar el tiempo real, no limitarse a decir “hay un fotograma en algún punto intermedio”. review_required lo define el sistema de evaluación según una regla establecida; el juez no lo decide por su cuenta. Aunque el campo sea false, la muestra todavía puede entrar en una auditoría aleatoria. Una puntuación automática fallida, un material visual insuficiente y una tarea no apta deben registrarse por separado, no compartir un estado vago de “falla”.
Notas y fuentes
- Yushi Hu et al., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. El artículo convierte los requisitos textuales en verificaciones mediante preguntas y respuestas para evaluar la coherencia entre imagen y texto. Este texto toma prestada la idea de descomponer, pero no traslada las puntuaciones experimentales del artículo original a tareas de SVG o de animación del pelícano. Artículo↩
- W3C, Scalable Vector Graphics (SVG) 2, capítulos sobre estructura del documento y trazados. Véanse la agrupación, la reutilización mediante
usey las expresiones de trazado. La idea de que un nodo del DOM no corresponde de forma natural a un objeto semántico del mundo real es un criterio de diseño de evaluación que este artículo plantea a partir de ello. Estructura del documento; Trazados↩ - W3C, SVG 2 — Conformance Criteria, secciones sobre modos de procesamiento y conformidad de documentos. La especificación distingue capacidades como la ejecución de scripts, los recursos externos y la animación declarativa, y también distingue formas de documento. La compatibilidad de los navegadores y los límites de ejecución todavía deben verificarse en el entorno real. Especificación↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, pasajes sobre transformaciones de coordenadas y cuadros delimitadores. Las sugerencias de este artículo sobre distancia de contacto, umbrales y reconocimiento semántico son ejemplos de diseño de evaluación, no un algoritmo de “montar correctamente” definido por la especificación de SVG. Especificación↩
- Lianmin Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Este artículo lo usa solo por lo que dice sobre la capacidad y el sesgo de los jueces en ciertas evaluaciones de texto. No infiere que todos los jueces visuales tengan la misma magnitud de sesgo ni la misma exactitud. Artículo↩
- Pooyan Rahmanzadehgervi et al., Vision language models are blind, 2024. Este artículo se refiere al estudio original de 2024 y cita específicamente arXiv v1, para no mezclar revisiones posteriores de los modelos, el título y los resultados. Ese estudio no puede servir como ranking actual de los modelos de 2026. Versión del artículo↩
- Documentación de Playwright sobre la opción
animationsdepage.screenshot, consultada el 5 de octubre de 2026. La documentación describe cómo esa opción trata las animaciones CSS, las transiciones CSS y las Web Animations. No debería extenderse, sin verificarlo, como un control de tiempo único para todos los mecanismos de animación de SVG. Documentación↩ - Colin White et al., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. Un título anterior usaba “Contamination-Free”. Este artículo sigue la redacción de la revisión de 2025 sobre actualizaciones continuas, puntuación verificable y reducción del riesgo de contaminación. No promete que no haya contaminación en absoluto. Artículo↩
- Documentación de Docker de Playwright, consultada el 5 de octubre de 2026. La documentación advierte que no se recomienda usar la imagen predeterminada para visitar sitios web no confiables, y explica que ejecutarla como root, como ocurre de forma predeterminada, desactiva el sandbox de Chromium. Este artículo no ofrece un despliegue seguro completo. El aislamiento, la red y la política de permisos todavía deben implementarse y probarse en el entorno donde se ejecutan. Documentación↩
- Página de inicio pública de Folkbench, consultada el 5 de octubre de 2026. La página de inicio ofrece accesos al ranking, a los informes y a las notas relacionadas, y describe la comparación como servicios distintos de un mismo modelo. Su sección de verificación también está marcada como un flujo de preparación beta y como una sonda real que todavía no está habilitada; el acceso actual sirve para mostrar el flujo de preparación. Este artículo solo remite a la información pública. No trata un acceso de demostración como una medición completada, no respalda de forma independiente ningún ranking concreto y no afirma que Folkbench haya implementado la puntuación en cuatro dimensiones, la calibración de jueces ni el banco de ítems dinámico que aquí se proponen. Inicio↩