Folkbench ha lanzado la detección de degradación de modelos dentro de su Monitor de integridad. Mientras los rankings tradicionales evalúan el techo de capacidad de un modelo en un entorno oficial y los directorios convencionales de relays se limitan a tarifas anunciadas, disponibilidad HTTP y latencia, ninguno responde a la pregunta operativa clave: cuando un modelo se entrega mediante un intermediario de API, ¿mantiene la misma profundidad de razonamiento, obediencia a restricciones e identidad que la API oficial directa?
Para cerrar esa brecha, Folkbench integra un conjunto automatizado de sondas en dos dimensiones—actualidad y huella del modelo (model fingerprint)—calibrado continuamente mediante claves API oficiales directas independientes en las mismas ventanas de medición. Al anclar el desempeño de cada relay frente a una línea base oficial en vivo, el sistema detecta desvíos ocultos a tiempo y transforma sospechas subjetivas en señales públicas verificables.
Aspectos clave de esta nueva capacidad:
- Sondas en dos dimensiones: Combina sondas dinámicas de actualidad con sondas de huella del modelo que registran hábitos de razonamiento, asignación de tokens y telemetría de huella, frenando tanto el caché estático como la imitación superficial.
- Calibración oficial independiente: Ejecuta las mismas sondas mediante claves API oficiales directas aisladas en cada ventana de control, separando cambios del proveedor oficial de degradaciones propias de un relay.
- Granularidad por modelo y grupo de servicio: Registra concordancia de sondas, tokens de entrada, tokens de razonamiento, huellas del modelo y controles de caché disponibles por modelo y grupo específico.
- Flujo completo de evaluación a cambio de ruta: Conecta el Monitor de integridad con los cuatro rankings públicos de Folkbench, el comparador lado a lado y el cliente desktop open source Folkbench Switch.
Por qué los rankings convencionales y el monitoreo de conectividad no detectan la degradación
En una ruta intermediada, una pasarela se sitúa entre quien realiza la llamada y el laboratorio creador del modelo. Bajo presión de costos o picos de demanda, esa capa intermedia puede introducir tres formas de degradación invisibles para las métricas de red:
- Sustitución silenciosa de modelo: Se solicita un modelo insignia, pero en horas pico o con contextos largos la petición se desvía a un modelo ligero más económico o a una instantánea anterior.
- Reducción del presupuesto de razonamiento: El modelo nominal no cambia, pero se rebaja el esfuerzo de razonamiento o se recortan pasos internos de pensamiento, entregando respuestas prematuras.
- Recorte de contexto o parámetros: Para ahorrar tokens y ancho de banda, la pasarela descarta turnos previos de la conversación o reduce la longitud máxima de salida, provocando omisiones y pérdida de coherencia.
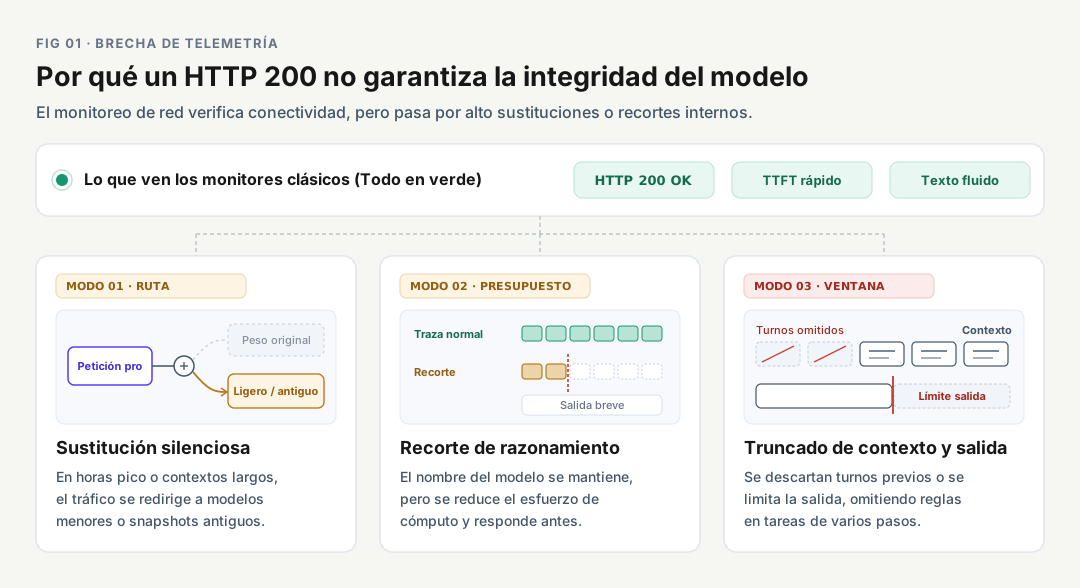
Figura 1: Que HTTP `200` y la latencia inicial estén en verde no garantiza capacidad íntegra. Las pasarelas pueden sustituir pesos, recortar pasos de pensamiento o truncar historial sin alterar la conectividad aparente.
Los tres casos comparten un rasgo: la conectividad superficial sigue intacta. El endpoint devuelve HTTP 200, los intercambios breves suenan fluidos e incluso pueden parecer más rápidos al pensar menos. Además, dado que los modelos presentan aleatoriedad natural en el muestreo—como analizamos en [¿El modelo de verdad se volvió más tonto?](/es/blog/did-the-model-get-dumber/)—una captura aislada no basta para distinguir variación normal de degradación sistemática.
Por qué fallan las comprobaciones manuales habituales
Cuando los usuarios sospechan que una ruta rinde menos de lo debido, dos comprobaciones manuales habituales fallan ante el enrutamiento moderno:
- Preguntar al modelo por su identidad: Un modelo de lenguaje no conoce qué proxy reenvía su tráfico. Basta una instrucción en el prompt de sistema o memorización básica para que un modelo menor declare el nombre del modelo insignia.
- Reutilizar acertijos clásicos estáticos: Las pruebas populares ya forman parte de los datos de entrenamiento de casi cualquier modelo compacto. Además, un cuestionario fijo permite devolver respuestas desde un caché estático o desviar los prompts de prueba conocidos hacia rutas sin recorte mientras se degrada el tráfico real.
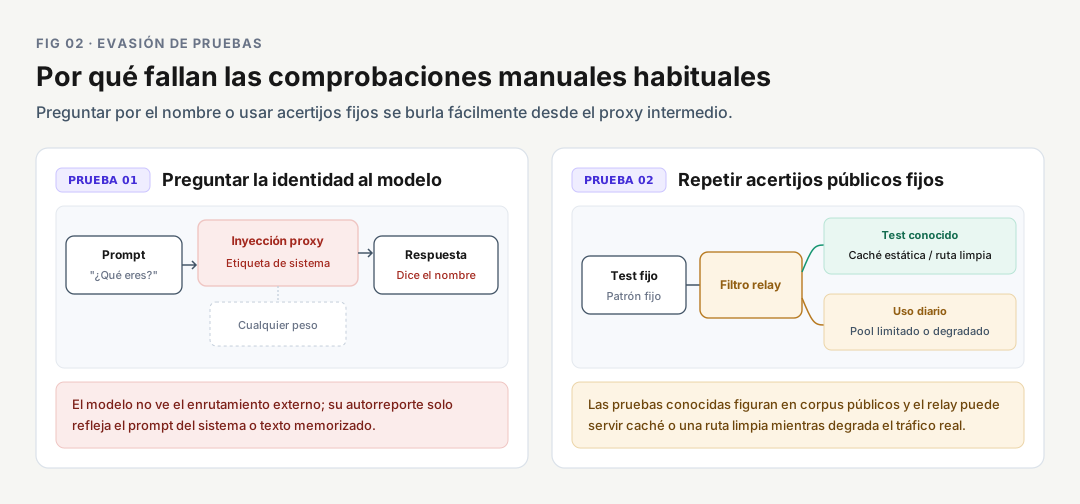
Figura 2: Dos atajos por los que fallan los chequeos manuales. Izquierda: un prompt de sistema impuesto por la pasarela declara cualquier nombre comercial sobre pesos menores. Derecha: un filtro reconoce pruebas fijas repetidas y responde desde caché estático o desvía la prueba a un pool limpio mientras degrada el tráfico real.
Arquitectura de sondas duales: actualidad y huella del modelo en paralelo
Para detectar desvíos ocultos con precisión, Folkbench divide su sistema de evaluación en dos dimensiones complementarias ejecutadas en paralelo dentro de cada ventana:
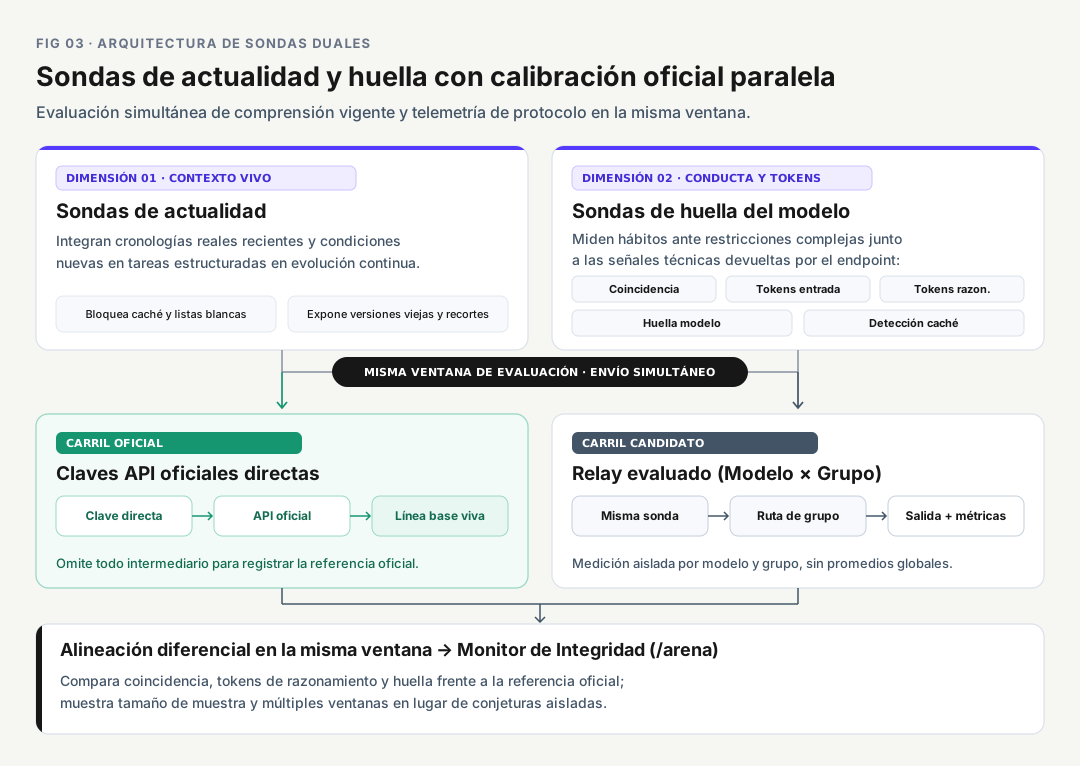
Figura 3: Despacho paralelo en la misma ventana. Las sondas de actualidad bloquean respuestas precalculadas y las sondas de huella registran concordancia, tokens de entrada, tokens de razonamiento, huella del modelo y verificación de caché en contraste directo con claves oficiales aisladas.
1. Sondas de actualidad: bloquear el caché estático y las versiones obsoletas
Las sondas de actualidad incorporan eventos recientes, cronologías actuales y relaciones dinámicas que evolucionan con el calendario real:
- Bloquea respuestas precalculadas: Al renovarse el contexto con hechos recientes, los intermediarios no pueden superar la auditoría sirviendo caché estático.
- Expone sustitutos antiguos o comprimidos: Por ejemplo, cuando la sonda exige ordenar hechos públicos recientes y razonar sobre condiciones nuevas, una versión antigua tropieza con su límite temporal de conocimiento y un modelo demasiado comprimido falla al integrar restricciones múltiples.
2. Sondas de huella del modelo: medir hábitos de ejecución y tokens de razonamiento
Cuando un relay sustituye un modelo capaz pero distinto, o reduce a la mitad el presupuesto de pensamiento del modelo correcto, la exactitud final de una pregunta simple puede no bastar para notarlo.
Las sondas de huella evalúan patrones conductuales estables ante restricciones complejas, formato estricto y razonamiento multipaso, combinados con telemetría del endpoint:
- Concordancia de sondas: Grado de alineación de respuestas frente al comportamiento esperado del modelo objetivo.
- Tokens de entrada y tokens de razonamiento: Presupuesto de tokens dedicado a procesar el contexto y razonar antes de emitir la respuesta final.
- Huellas del modelo y controles de caché: Metadatos de huella devueltos por la API y estado de verificación de caché cuando existen mediciones.
Si un endpoint reduce silenciosamente la profundidad de razonamiento, el texto resultante puede sonar correcto, pero el volumen de tokens de razonamiento y la concordancia de sondas caen en paralelo. Del mismo modo, un desvío hacia otra familia de modelos delata variaciones en disciplina de formato y huella digital.
Calibración mediante claves API oficiales directas independientes
Incluso con sondas precisas, observar solo el puntaje del relay crea ambigüedad: una caída puede deberse al propio relay, o bien a una actualización del proveedor oficial, inestabilidad general o la tasa base de aprobación de una nueva tanda de preguntas.
Para eliminar esa duda, Folkbench ejecuta todas las sondas con claves API oficiales directas e independientes que conectan directamente con los proveedores del modelo sin pasar por ningún relay, generando en la misma ventana una línea base oficial en vivo.
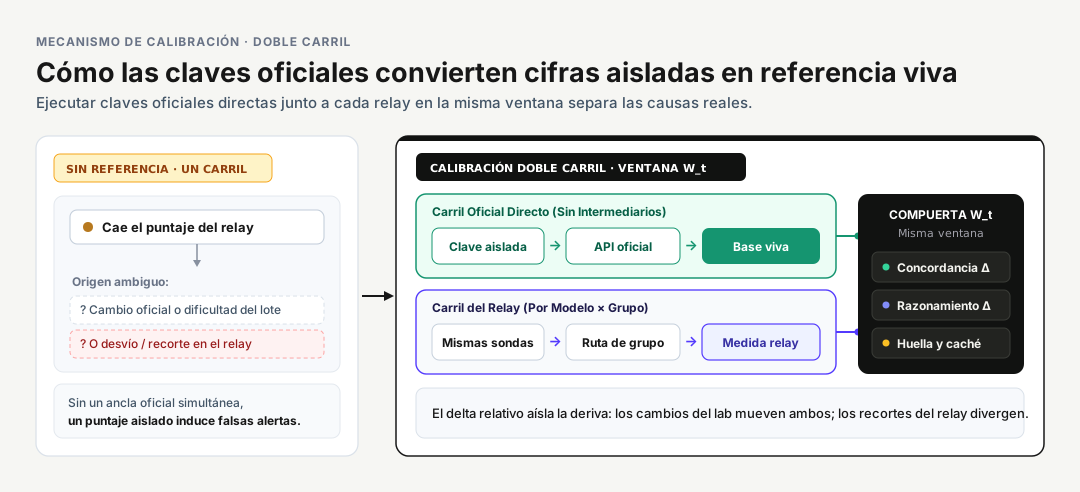
Mecanismo de calibración: Sin ancla oficial simultánea (izquierda), una caída no distingue cambios del laboratorio de recortes del relay. El doble carril síncrono (derecha) ejecuta claves oficiales aisladas junto a cada ruta `modelo × grupo` en la misma ventana `W_t` para aislar deltas relativos de concordancia, razonamiento y huella.
| Escenario observado | Monitoreo sin calibración oficial | Calibración con claves oficiales directas independientes |
|---|---|---|
| Fluctuación o ajuste del modelo oficial | Riesgo de atribuir al relay un cambio del proveedor | La línea base oficial se desplaza en paralelo y aísla el ruido global |
| Base oficial estable y caída en un relay | Sin referencia simultánea para medir el desvío | La concordancia y los tokens de razonamiento se separan claramente de la base oficial |
| Divergencia entre grupos de un mismo relay | Un grupo rápido oculta recortes en grupos baratos | Cada ruta modelo × grupo se contrasta por separado frente a la línea base |
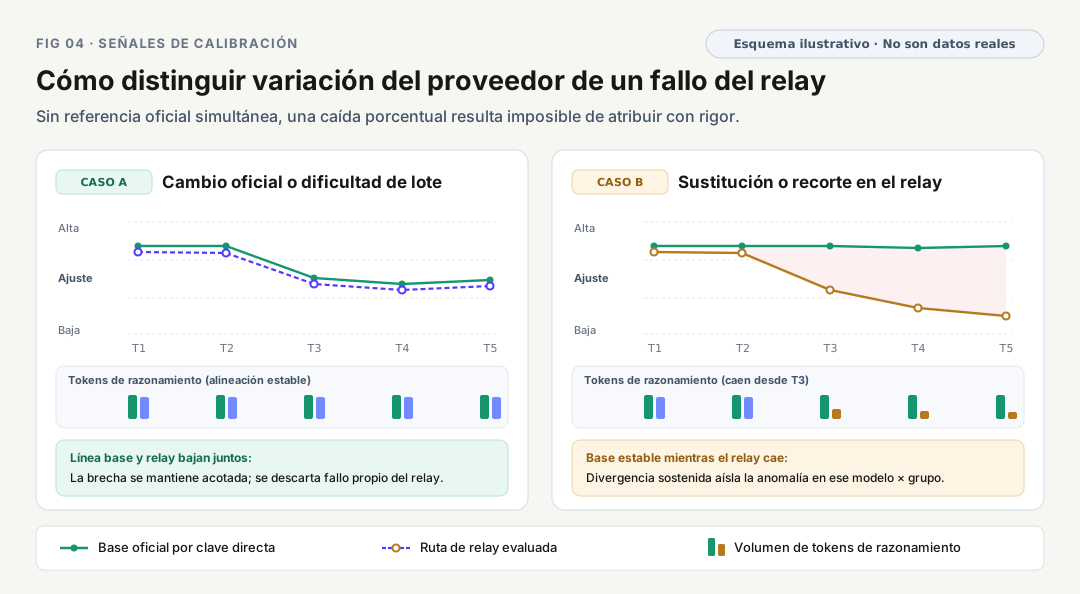
Figura 4 (esquema ilustrativo, no mediciones reales): Cómo la referencia oficial directa evita falsos positivos. En el Caso A ambas trayectorias bajan juntas ante variación del proveedor; en el Caso B la línea oficial sigue plana mientras concordancia y tokens de razonamiento del relay divergen desde `T3`.
Siguiendo la disciplina descrita en el [Monitor de integridad](/es/arena), una sola respuesta o un porcentaje aislado no demuestran por sí solos una sustitución de modelo. Los resultados deben interpretarse junto con tamaño muestral, ventanas consecutivas y distribución de tokens como señal objetiva de alerta temprana.
De la detección de degradación al flujo completo: qué diferencia a Folkbench
Mientras los sitios convencionales solo evalúan modelos oficiales en datasets fijos o listan tarifas y pings HTTP, Folkbench une integridad de capacidad, rendimiento operativo y gestión local de rutas:
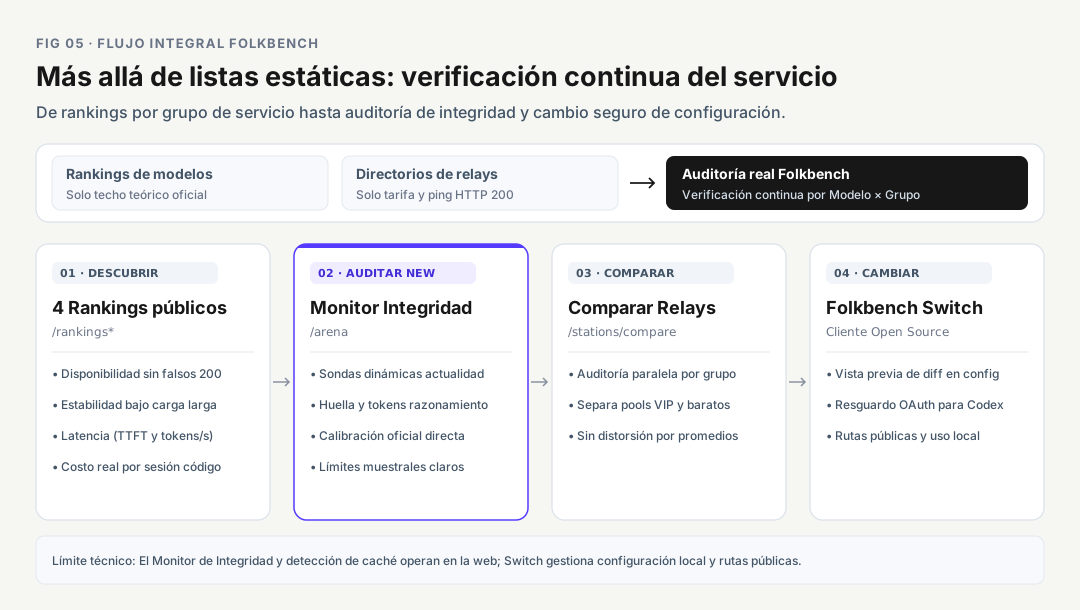
Figura 5: Del ranking estático a la verificación continua de entrega. Folkbench enlaza filtrado por grupo (`/rankings), auditoría calibrada (/arena), comparación exacta (/stations/compare) y cambio local seguro (Folkbench Switch`), manteniendo la telemetría continua en la web.*
- Medición por modelo y grupo exacto: Evalúa cada grupo comercial por separado para que los pools estables no encubran recortes en grupos promocionales.
- Cuatro rankings públicos complementarios: [Disponibilidad](/es/rankings) (descarta falsos
200, cortes de streaming y fallos de parsing), [Estabilidad](/es/rankings/stability) (cargas sostenidas y horas pico), [Latencia](/es/rankings/latency) (separa TTFT del ritmo continuo de tokens) y [Costo por sesión](/es/rankings/cost) (gasto real en sesiones de código). - [Monitor de integridad](/es/arena) y [Comparar relays](/es/stations/compare) abiertos: Telemetría calibrada y comparación lado a lado sin necesidad de mantener múltiples claves oficiales propias.
- Cliente open source [Folkbench Switch](https://github.com/Folkbench/folkbench/releases): Aplicación en Tauri + Rust (macOS
.dmgy Windows.exe) para Claude Code, Codex, Gemini CLI, Aider, OpenCode y Kimi CLI con vista previa de diff, protección de credenciales OAuth de Codex y estimación local de consumo. (La detección de degradación y caché permanecen en la web como mediciones continuas.)
Cómo aplicar estas señales en la práctica
- Filtra grupos candidatos según tu carga de trabajo en [Disponibilidad](/es/rankings), [Estabilidad](/es/rankings/stability), [Latencia](/es/rankings/latency) y [Costo por sesión](/es/rankings/cost).
- Revisa en el [Monitor de integridad](/es/arena) la concordancia, tokens de razonamiento y huella frente a la base oficial en ventanas consecutivas.
- Contrasta el grupo exacto antes de recargar en [Comparar relays](/es/stations/compare).
- Mantén una ruta principal y otra de respaldo en Folkbench Switch para cambiar en segundos tras revisar el diff de configuración.
Evaluar infraestructura de IA hoy exige comprobar no solo qué modelo lidera sobre el papel, sino si cada ruta entrega exactamente lo prometido. Con sondas de actualidad, huellas de modelo y calibración oficial directa independiente, Folkbench ofrece una referencia pública verificable para elegir rutas de API con criterio.