
Claude Haiku 5.5 の公式ベンチマークスコアが公開されました。Haiku 4.5、GPT-6 Luna、Sonnet 5.5 と並べてみると、本当に議論すべきなのは全項目で勝ったかどうかではありません。「小型モデル」にできることの限界を、Haiku 5.5 がどこまで押し広げたかです。
Anthropic が公式に発表したモデルは Claude Haiku 5.5 です。モデル ID は claude-haiku-5-5、リリース日は 2026 年 10 月 7 日です。
Anthropic による Haiku 5.5 の位置づけは明快です。同社の小型モデルとして最も速く、最も安く、最も高性能であり、大量処理・低レイテンシ・コスト重視のタスクを対象としています。公式に挙げられている代表的な用途は、分類、情報抽出、要約、コンテキスト圧縮、データベースクエリ、ブラウザ操作、そして Sonnet 5.5 や Opus 5.5 のサブエージェントとしての利用です。
本記事では Anthropic が公式に公開したベンチマーク、価格、製品情報だけを使い、公式スコアを独立した検証のように見せることはしません。ここで行うのは、これらの数字をタスクの種類、価格、モデルの位置づけの中に置き直し、Haiku 5.5 が実際にどこで強いのか、そしてどんな仕事はまだ任せられないのかを確かめることです。
結論から:Haiku 5.5 は「小型モデルは簡単な仕事しかできない」という境界線を越えた
公式データを並べると、Haiku 5.5 の輪郭はかなりはっきりしています。
- Haiku 4.5 と比べ、Anthropic が公開した主要ベンチマークのすべてで大幅に向上しています。
- 公式に並べて報告された項目では、GPT-6 Luna を上回っています。
- 知識労働、コンピューター操作、一部の推論タスクでは、すでに Sonnet 5.5 に迫っています。
- 複雑なエージェント型コーディングでは、依然として Sonnet 5.5 に明確に後れを取っています。
- 最大の強みは、速度と価格、そして十分に高いタスク完遂能力が組み合わさっている点です。
したがって Haiku 5.5 は、Sonnet 5.5 を全面的に置き換えるモデルではなく、能力が大きく強化された実行レイヤーとして捉えるのが適切です。
公式ベンチマークの横並び比較
Anthropic は Haiku 5.5 の発表ページで次のデータを公開しています。表中の GPT-6 Luna と Sonnet 5.5 の数値も、Anthropic の同じ比較表によるものです。
| ベンチマーク | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1:知識労働 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1:知識労働 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1:コンピューター操作 | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam:ツールなし | 45.9% | 10.2% | — | 56.9% |
| Humanity's Last Exam:ツールあり | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0:エージェント型コーディング | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1:エージェント型コーディング | 46.4% | — | 42.4% | 52.1% |
| Chartography:視覚推論 | 46.4% | 6.4% | 29.1% | 61.6% |
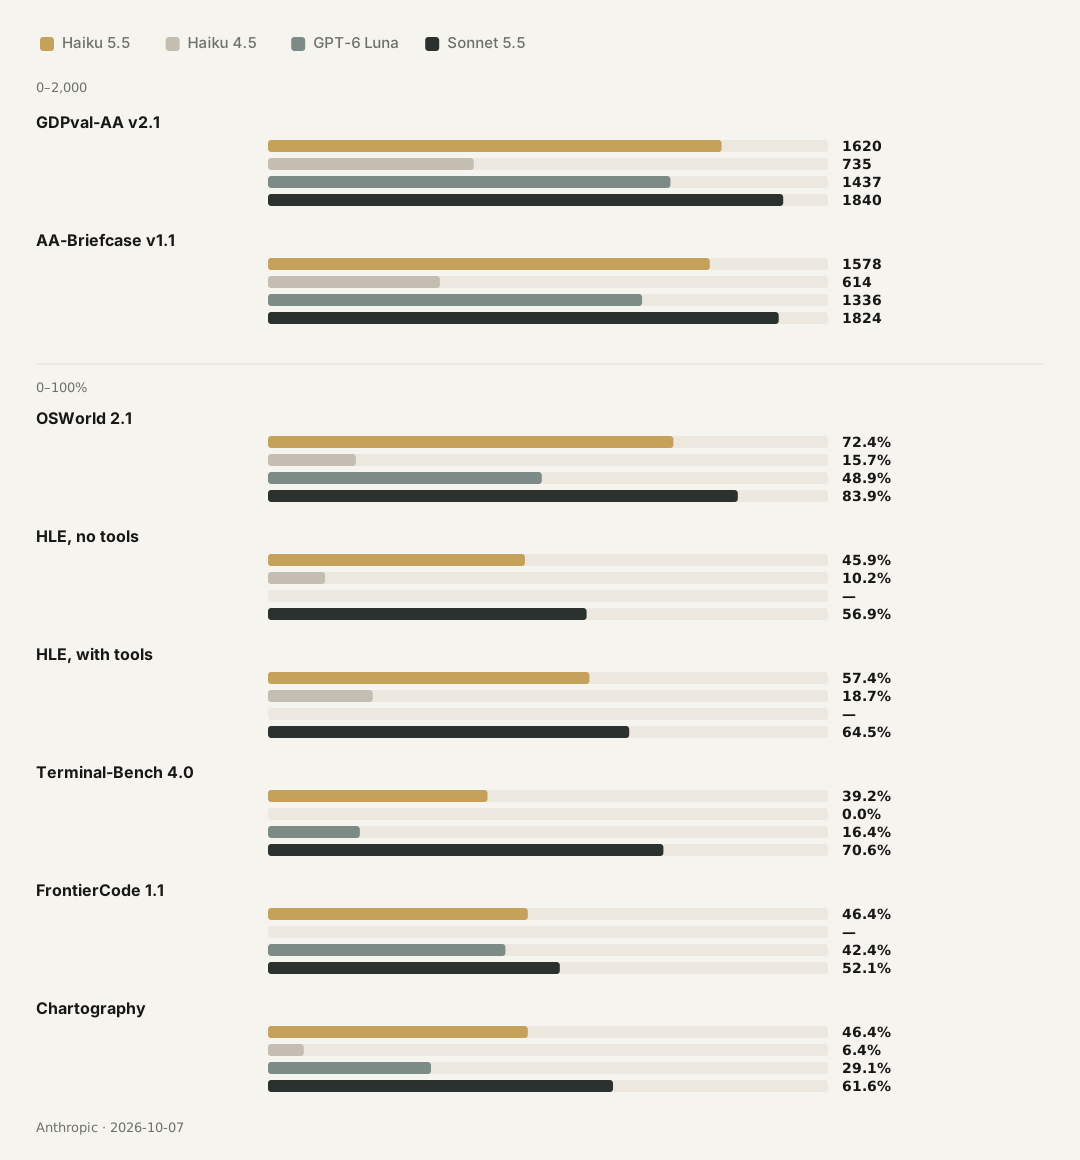
これらの数字は「Haiku 5.5 は 2 位」と単純に要約できるものではありません。ベンチマークごとに測っている能力がまったく異なるからです。知識労働は成果物の品質を、OSWorld はモデルが実際のコンピューターを操作できるかを、Terminal-Bench はコマンドライン上で複数ステップの専門的なタスクをやり遂げられるかを問います。Humanity's Last Exam は高難度の知識と推論に重心があります。
同じモデルでもタスクによって成績が大きくばらつくこと自体が、評価結果の一部です。
1 つ目の変化:Haiku 5.5 は前世代を大きく引き離した
Haiku 4.5 と Haiku 5.5 だけを比べても、向上幅は一目瞭然です。
GDPval-AA v2.1 は 735 から 1620 へと、前世代の約 2.2 倍になりました。AA-Briefcase は 614 から 1578 へと、約 2.6 倍です。OSWorld は 15.7% から 72.4% へ、Terminal-Bench は 0.0% から 39.2% へ上がっています。
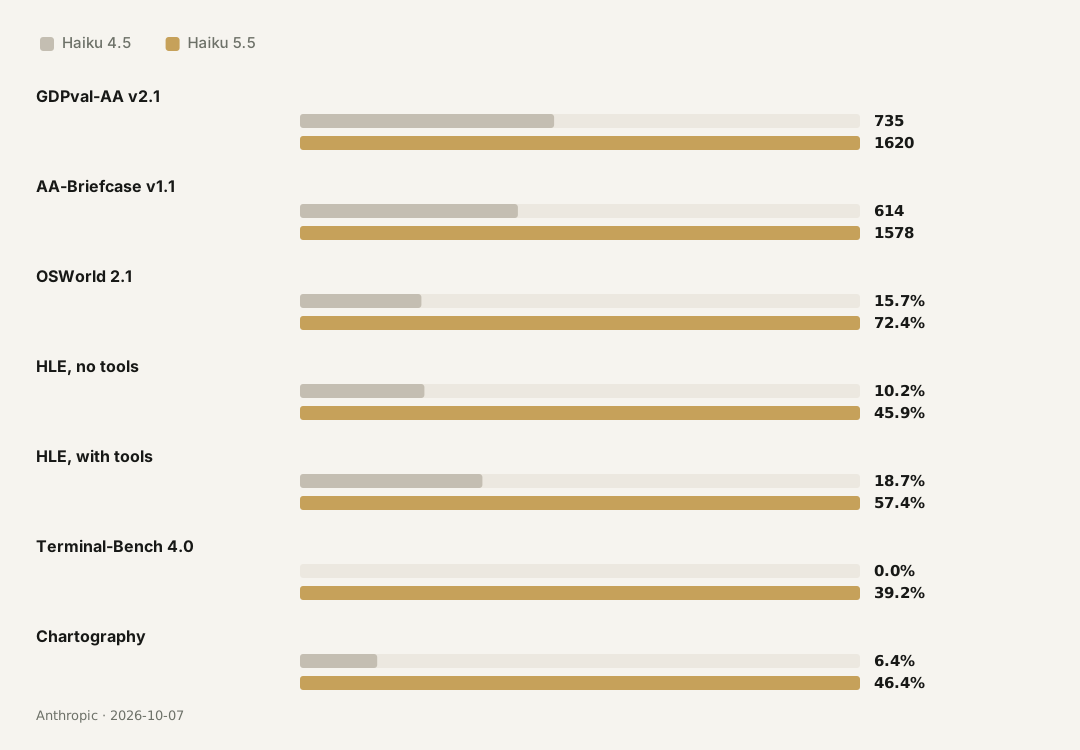
これは「回答の言い回しがきれいになった」程度の変化ではありません。OSWorld も Terminal-Bench も長い一連の操作を伴い、モデルはタスクを理解し、ツールを呼び出し、フィードバックを処理し、途中でミスをしても作業を続けなければなりません。こうしたテストでの向上は、Haiku 5.5 がもはや短いテキストの分類や要約だけに向いたモデルではないことを示しています。
とりわけ顕著なのが OSWorld です。Haiku 4.5 の 15.7% と Haiku 5.5 の 72.4% の間には、はっきりとした断絶があります。ベンチマークの設定、オフラインのサブセット、公式のテスト条件を考慮しても、この結果は Haiku 5.5 のコンピューター操作能力に、世代が変わるほどの大きな変化が起きたことを示しています。
ただし、1 つの項目の向上から「あらゆる本番タスクが同じ幅で向上した」と結論づけることはできません。ベンチマークが測るのは特定のタスク群であり、実際のプロダクトはコンテキスト長、ツールの定義、エラーからの回復、ネットワークのレイテンシ、業務データの品質にも左右されます。
2 つ目の変化:GPT-6 Luna と競り合う水準に入った
Anthropic が公開した項目では、Haiku 5.5 は GPT-6 Luna を上回っています。
- GDPval-AA:1620 対 1437
- AA-Briefcase:1578 対 1336
- OSWorld:72.4% 対 48.9%
- Terminal-Bench:39.2% 対 16.4%
- Chartography:46.4% 対 29.1%
このデータからは、慎重な判断を 1 つ導けます。Haiku 5.5 は、コストパフォーマンスに優れた主流モデルが競い合う水準に入ったということです。
ただし、ここには 2 つの条件を付けておく必要があります。
1 つ目に、これらの数字は Anthropic の発表ページから取ったものです。ベンチマークの実行方法、モデルの設定、ツールの構成、統計の取り方は企業ごとに異なる可能性があります。開発元が示す製品の立ち位置を知るには役立ちますが、完全に独立した、完全に対称な第三者ランキングとしてそのまま扱うべきではありません。
2 つ目に、「GPT-6 Luna より高い」は「あらゆるタスクで GPT-6 Luna より優れている」という意味ではありません。公式の表が裏付けるのは公開された項目どうしの比較だけで、テストされていないタスクにまで結果を当てはめることはできません。
妥当な言い方は次のようになります。
Anthropic が公開した比較項目では、Haiku 5.5 は GPT-6 Luna を上回るスコアを示しました。実際のモデル選定では、タスクの種類、価格、速度、呼び出し方式をあわせて判断する必要があります。
3 つ目の変化:Sonnet にかなり近づいたが、モデルの階層はなお残っている
Haiku 5.5 と Sonnet 5.5 の差も、それ自体が多くを語っています。
GDPval-AA v2.1 では Haiku 5.5 が 1620、Sonnet 5.5 が 1840 です。AA-Briefcase では 1578 と 1824 です。OSWorld は Haiku 5.5 が 72.4%、Sonnet 5.5 が 83.9% です。Humanity's Last Exam はツールなしで 45.9% と 56.9%、ツールありで 57.4% と 64.5% です。
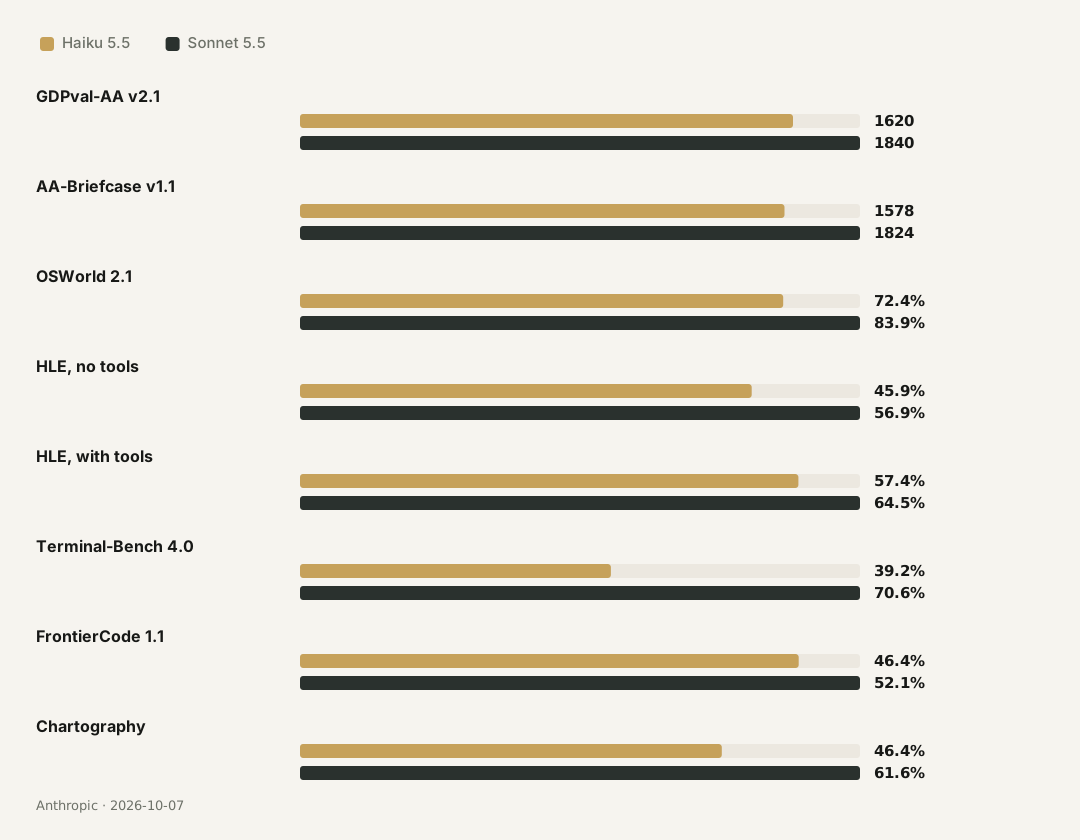
これらの差からわかるのは、Haiku 5.5 がすでに知識労働やコンピューター操作のかなりの部分をこなせる一方で、複雑さがさらに増すと Sonnet 5.5 が安定した優位を保つということです。
最も注目すべきは Terminal-Bench の差です。Haiku 5.5 は 39.2%、Sonnet 5.5 は 70.6% でした。このベンチマークはコマンドライン環境で複雑かつ複数ステップの専門的なタスクをやり遂げさせるもので、長時間にわたるエージェント型コーディングに近い内容です。Haiku 5.5 はここで Haiku 4.5 をはるかに上回っていますが、Sonnet 5.5 との距離はまだ大きく開いています。
ここから、モデル選びの明確な境界線が見えてきます。
- 局所的で、繰り返しが多く、検証可能な作業なら、Haiku 5.5 は非常に魅力的です。
- 長期的な計画、複数ファイルにまたがる修正、エラーからの継続的な回復が必要なタスクには、依然として Sonnet 5.5 のほうが適しています。
- 一部のベンチマークで Sonnet に迫っているからといって、両者を同じモデルの価格違いとして扱うことはできません。
値下げ後に本当に見るべきは「タスクあたりのコスト」
価格は、今回の発表のもう 1 つの柱です。
100K トークン以下のリクエストでは、Haiku 5.5 の入力価格は 100 万トークンあたり 0.10 米ドル、出力価格は 0.50 米ドルです。100K トークンを超えると、それぞれ 0.50 米ドルと 2.50 米ドルになります。Anthropic によると、Haiku 5.5 の平均運用コストは Haiku 4.5 より約 75% 低くなっています。
| リクエスト規模 | 入力価格 | 出力価格 | キャッシュ読み取り |
|---|---|---|---|
| 100K トークン以下 | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| 100K トークン超 | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
額面だけを見れば、100K 以内の入力価格は Haiku 4.5 の 1 米ドルから 0.10 米ドルに、出力価格は 5 米ドルから 0.50 米ドルに下がり、名目上の単価は 90% 下がりました。ただし Anthropic は、Haiku 5.5 が新しいトークナイザーを採用しているため、同じタスクでもやや多くのトークンを消費する場合があるとも説明しています。そのため平均運用コストの下げ幅は単純な 90% ではなく、約 75% です。
実際のプロダクトでは、さらに次の 3 点を考える必要があります。
- Haiku 5.5 が 1 回でタスクを完了する確率はどれくらいか。
- 失敗したとき、何回の再試行が必要か。
- Sonnet や Opus を呼び出してレビューや修正を行う必要があるか。
より意味のある指標は次のとおりです。
成功したタスク 1 件あたりのコスト
= タスク完了にかかった総費用 ÷ 成功したタスクの件数
仮に Haiku 5.5 の 1 回あたりの呼び出しコストが Sonnet の 10 分の 1 だとしても、あるタスクで 2 回の再試行が必要になったり、リクエストの 20% が最終的に Sonnet に回されたりすれば、実際の節約幅は価格表上の差より小さくなります。
逆に、タスクを自動で検証でき、失敗しても低コストで再試行できるなら、Haiku 5.5 は非常に大きな経済的優位を持ちえます。
100K トークンを超えると、価格の境界がプロダクトのアーキテクチャを左右する
Haiku 5.5 の価格表では、100K トークンが重要な分岐点です。
短いリクエストや中程度の長さのリクエストなら、Haiku 5.5 の安さはすぐに実感できます。しかしコードリポジトリ、長い会話、企業のナレッジベース、大量のドキュメントを扱うプロダクトでは、100K トークンに近づいたり超えたりすることが頻繁に起こります。そうなると、すべての内容を 1 回のリクエストに詰め込むのが最適とは限りません。
より合理的なアーキテクチャには、通常次のような要素が含まれます。
- まず Haiku 5.5 でドキュメントを分類し、関連性で絞り込む。
- 元の内容を構造化された要約に圧縮する。
- 現在の質問に関係する断片だけを、より大きなモデルに渡す。
- 繰り返し使うコンテキストはキャッシュする。
- 複数ターンの会話は、毎回すべてを再送信するのではなく、検索可能な状態として保存する。
ここは、Haiku 5.5 がエージェントのアーキテクチャと最も密接に結びつく部分でもあります。Haiku 5.5 は安価な回答用モデルであるだけでなく、コンテキスト圧縮、検索結果の整理、サブタスク実行の基盤レイヤーにもなりえます。
effort 設定によって、静的なランキングだけでは足りなくなった
Haiku 5.5 は、Haiku シリーズで初めて effort を調整できるモデルです。同じモデルでも、タスクの重要度に応じて推論にかける量を変え、品質・レイテンシ・コストのバランスを選べます。
これは、ベンチマークの読み方を変えます。固定のスコアからわかるのは、ある設定でのモデルの振る舞いだけです。コストと品質の関係を示す曲線全体があって初めて、予算ごとにモデルがどう振る舞うかがわかります。
単純なタスクには、低めの effort が向いているでしょう。
- 分類
- 形式変換
- 固定フィールドの抽出
- 短いテキストの書き換え
中程度の複雑さのタスクでは、effort を上げてもよいでしょう。
- 長文の要約
- 段落をまたいだ情報の統合
- ブラウザでの複数ステップの操作
- 先に判断してからツールを呼び出す必要があるタスク
複雑なタスクでは、effort を上げても Sonnet の代わりになるとは限りません。Terminal-Bench の差がそれを物語っています。推論予算を増やせば成績は改善しますが、長期的な計画、エラーからの回復、複雑なツールチェーンにおける能力差が自動的に消えるわけではありません。
数字を実際のモデルルーティングに落とし込む
公式スコアと製品の位置づけを総合すると、まずは比較的手堅いルーティング表を作れます。
| タスクの種類 | 既定の選択 | 理由 |
|---|---|---|
| 分類、ルーティング、ラベル付け | Haiku 5.5 | 呼び出し量が多く、出力構造が明確で、検証しやすい |
| フィールド抽出、データ整理 | Haiku 5.5 | タスクの境界が明確で、高並列の処理に向いている |
| 要約とコンテキスト圧縮 | Haiku 5.5 | 価格と速度の優位が大きい |
| 単一ステップまたは短いフローのブラウザ操作 | Haiku 5.5 | OSWorld のスコアから、コンピューター操作能力の明確な向上がうかがえる |
| 一般的なコード解説と小さな修正 | Haiku 5.5 または Sonnet 5.5 | 自動テストの有無とミスの代償による |
| 複数ファイルにまたがるコード修正 | Sonnet 5.5 | Terminal-Bench でまだ明確な差がある |
| 長時間のエージェント型コーディング | Sonnet 5.5 または Opus 5.5 | 継続的な計画とエラー回復が必要 |
| 最終レビューと高リスクの判断 | Sonnet 5.5 または Opus 5.5 | より高い安定性と強い推論能力が必要 |
この表は「Haiku 5.5 の能力の限界」を恒久的に定義するものではありません。公式ベンチマーク、価格、製品の位置づけを並べて得られた、最初の利用指針にすぎません。
実際に導入する際は、自社のタスクセットで次の点を確認する必要があります。
- 出力が業務の基準を満たしているか
- 失敗を自動で検出できるか
- 失敗後の再試行がコストに見合うか
- レイテンシの低さが本当にプロダクト体験を改善するか
- 安さが、人手によるチェックのコスト増で相殺されないか
公式ベンチマークをどう読むか
新しいモデルのベンチマークを前にすると、陥りやすい誤解が 2 つあります。
1 つ目は、すべての項目を 1 つの総合順位に押し込めてしまうことです。知識労働、コンピューター操作、オープンエンドの推論、エージェント型コーディングはそれぞれ別の能力であり、1 列の合計点で代替することはできません。
2 つ目は、公式スコアをそのまま本番環境での結論とみなすことです。公式ベンチマークには明確なテスト設定がありますが、実際のプロダクトはプロンプト、ツール、コンテキスト、ネットワーク、データ、エラー回復の仕組みにも影響されます。
より信頼できる読み方は、次の 3 ステップです。
まず能力の飛躍を見る
Haiku 5.5 は Haiku 4.5 から着実に向上しているか。公式の表を見る限り答えはイエスで、特に OSWorld、知識労働、エージェント型コーディングの項目に表れています。
次にタスクの境界を見る
より大きなモデルに追いついたか。答えはタスク次第です。一部の知識労働とコンピューター操作ではすでに Sonnet に迫っていますが、複雑なエージェント型コーディングではまだ明確な差があります。
最後に単位コストを見る
使う価値があるかどうかは、品質、価格、レイテンシ、失敗からの回復が合わさった結果で決まります。ベンチマークのスコアだけでは、プロダクトがモデルを切り替えるべきかどうかには答えられません。
最終判断:Haiku 5.5 の「強さ」は、大量に使えることにある
Haiku 5.5 が Sonnet 5.5 を超えたかと問われれば、答えは簡単で、超えていません。公式データでも、知識労働、コンピューター操作、総合的な推論、エージェント型コーディングでは Sonnet 5.5 が依然として優位に立っています。
Haiku 5.5 が Haiku 4.5 より強いかと問われれば、答えはやはり明確です。強くなっており、しかもその向上幅は大きなものです。
本当に議論すべきなのは 3 つ目の問いです。本番システムの中の局所的な仕事を大量に任せられるほど、すでに強くなっているのか?
公式スコアと価格から見る限り、その答えもおそらくイエスです。
Haiku 5.5 の価値は、これまで中型モデルが必要でありながら、中型モデルの料金を払うほどではなかった一群のタスクを、より速く安い実行レイヤーに移せる点にあります。分類、抽出、要約、コンテキスト圧縮、短いフローのブラウザ操作、エージェントのサブタスクは、いずれも Haiku 5.5 の主戦場になりえます。
これは新たな「モデルランキング王者」のスコアではなく、モデルの役割分担についてのスコアです。
- Haiku 4.5 は、小型モデルが簡単な仕事を安くこなせることを示しました。
- Haiku 5.5 は、小型モデルがツールや複数ステップの操作を必要とする仕事の一部も担えることを示し始めています。
- Sonnet 5.5 は、引き続きより複雑な計画、コーディング、知識労働を担当します。
- Opus 5.5 は、長時間・高難度で、ミスの代償が大きいタスクを引き続き処理します。
モデル評価の焦点も、「誰のスコアが最も高いか」から「どのタスクで誰を呼び出すのが最も価値があるか」へと移りつつあります。


