
Claude Haiku 5.5 的官方跑分已經出爐。把它和 Haiku 4.5、GPT-6 Luna、Sonnet 5.5 放在一起看,真正值得討論的問題不是它有沒有拿下每一項,而是它把「小模型」的能力邊界推進到了哪裡。
Anthropic 官方發布的模型是 Claude Haiku 5.5。模型 ID 為 claude-haiku-5-5,發布日期是 2026 年 10 月 7 日。
Anthropic 對 Haiku 5.5 的定位很直接:它是目前速度最快、價格最低、能力最強的小模型,鎖定高流量、低延遲且對成本敏感的任務。官方列出的典型使用情境包括分類、資訊擷取、摘要、上下文壓縮、資料庫查詢、瀏覽器操作,以及擔任 Sonnet 5.5 或 Opus 5.5 的子 Agent。
這篇文章只使用 Anthropic 官方公布的 benchmark、價格和產品資訊,不把官方成績單包裝成獨立實驗。我們要做的,是把這些數字放回任務類型、價格和模型定位之中,看看 Haiku 5.5 究竟強在哪裡,又有哪些工作仍然不能交給它。
先看結論:Haiku 5.5 已經跨過「小模型只能做簡單工作」的分界線
把官方數據放在一起,Haiku 5.5 的輪廓相當清楚:
- 相較於 Haiku 4.5,它在 Anthropic 公布的每一項主要 benchmark 上都大幅提升;
- 在官方同時列出的項目中,它都超越了 GPT-6 Luna;
- 在知識工作、電腦操作和部分推理任務上,它已經接近 Sonnet 5.5;
- 在複雜的 Agent 程式開發上,它仍明顯落後 Sonnet 5.5;
- 它最有競爭力的地方,在於速度、價格和夠高的任務完成能力三者疊加。
因此,Haiku 5.5 比較適合理解為能力大幅增強的執行層,而不是全面取代 Sonnet 5.5 的模型。
官方 benchmark 橫向比較
Anthropic 在 Haiku 5.5 的發布頁上公布了以下數據。表中 GPT-6 Luna 與 Sonnet 5.5 的數值,也來自 Anthropic 的同一張對照表。
| 測試項目 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1:知識工作 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1:知識工作 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1:電腦操作 | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam:不使用工具 | 45.9% | 10.2% | — | 56.9% |
| Humanity's Last Exam:使用工具 | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0:Agent 程式開發 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1:Agent 程式開發 | 46.4% | — | 42.4% | 52.1% |
| Chartography:視覺推理 | 46.4% | 6.4% | 29.1% | 61.6% |
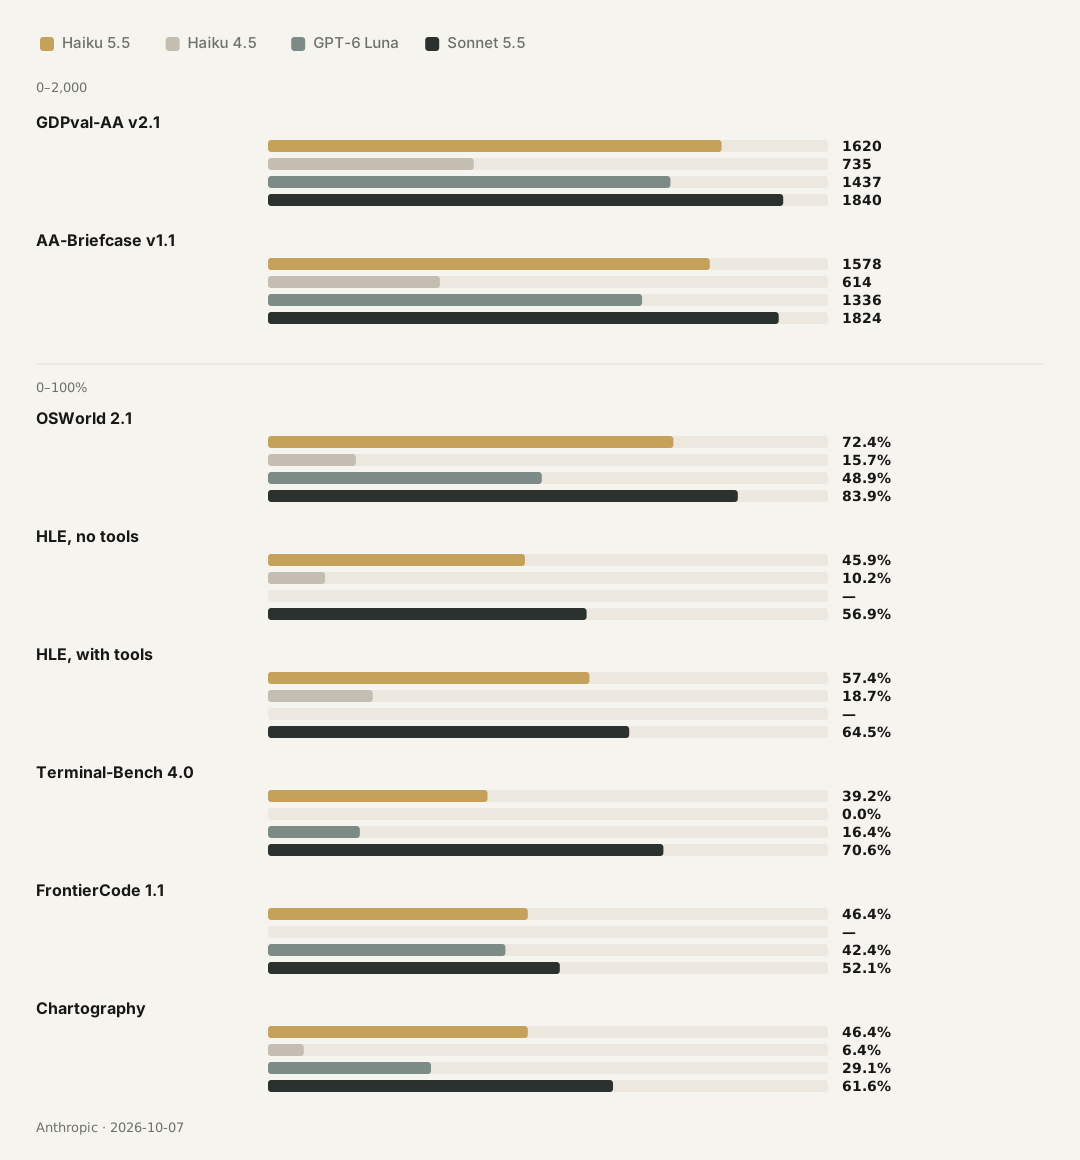
這些數字不能簡單壓縮成「Haiku 5.5 排名第二」。不同 benchmark 測的是完全不同的能力:知識工作看重交付品質,OSWorld 看模型能不能操作真實的電腦,Terminal-Bench 看模型能不能在命令列中完成多步驟的專業任務,Humanity's Last Exam 則偏向高難度的知識與推理。
同一個模型在不同任務上表現落差很大,這本身就是評測結果的一部分。
第一項變化:Haiku 5.5 把上一代遠遠甩在後面
如果只看 Haiku 4.5 和 Haiku 5.5,升級幅度非常明顯。
GDPval-AA v2.1 從 735 提高到 1620,約為上一代的 2.2 倍;AA-Briefcase 從 614 提高到 1578,約為 2.6 倍。OSWorld 從 15.7% 提高到 72.4%,Terminal-Bench 則從 0.0% 提高到 39.2%。
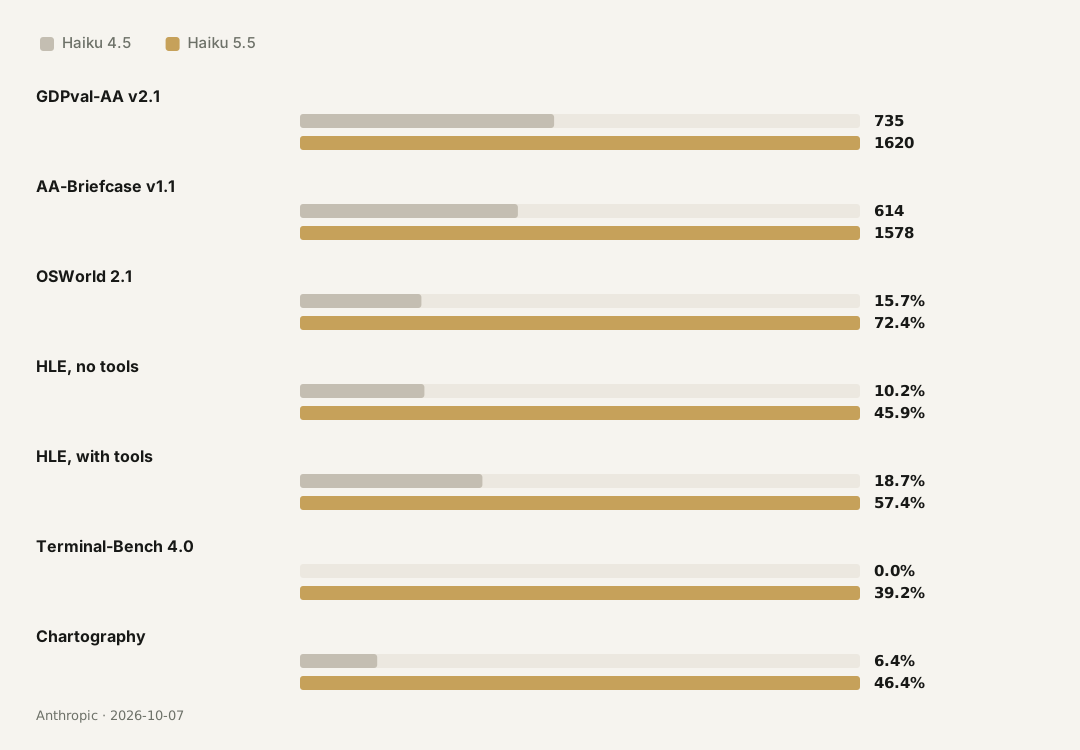
這不是「回答措辭更漂亮」等級的變化。OSWorld 和 Terminal-Bench 都牽涉一長串的操作,模型需要理解任務、呼叫工具、處理回饋,並在中途出錯後繼續執行。Haiku 5.5 在這類測試上的進步,說明它已經不只是適合做短文分類和摘要的模型。
尤其是 OSWorld。Haiku 4.5 的 15.7% 與 Haiku 5.5 的 72.4% 之間有明顯的斷層。即使把 benchmark 設定、離線子集和官方測試條件都考慮進去,這個結果仍然說明 Haiku 5.5 的電腦操作能力出現了非常大的世代躍進。
不過,單項進步不能直接推論出「所有正式環境的任務都進步了同樣幅度」。benchmark 衡量的是特定的任務集合,實際產品還會受到上下文長度、工具定義、錯誤復原、網路延遲和業務資料品質的影響。
第二項變化:它已經進入 GPT-6 Luna 的競爭區間
在 Anthropic 公布的項目中,Haiku 5.5 的表現都高於 GPT-6 Luna:
- GDPval-AA:1620 對 1437;
- AA-Briefcase:1578 對 1336;
- OSWorld:72.4% 對 48.9%;
- Terminal-Bench:39.2% 對 16.4%;
- Chartography:46.4% 對 29.1%。
這組數據足以支撐一個審慎的判斷:Haiku 5.5 已經進入主流高 CP 值模型的競爭區間。
但這裡必須保留兩個前提。
第一,這些數字來自 Anthropic 的發布頁。不同公司在 benchmark 的執行方式、模型設定、工具設定和統計方法上可能各不相同。這些數字適合用來了解產品方所展示的能力定位,不適合直接當成完全獨立、完全對等的第三方排名。
第二,「高於 GPT-6 Luna」不等於「所有任務都勝過 GPT-6 Luna」。官方表格只能佐證這些已公布項目的比較,不能把結果外推到沒有測試過的任務。
比較合理的說法應該是:
在 Anthropic 公布的對照項目中,Haiku 5.5 的成績高於 GPT-6 Luna;實際選用時,仍需要結合任務類型、價格、速度和呼叫方式來判斷。
第三項變化:它離 Sonnet 很近,但仍未抹平模型層級
Haiku 5.5 和 Sonnet 5.5 之間的差距同樣值得一看。
在 GDPval-AA v2.1 上,Haiku 5.5 得分 1620,Sonnet 5.5 得分 1840;在 AA-Briefcase 上,兩者分別是 1578 和 1824。OSWorld 上,Haiku 5.5 為 72.4%,Sonnet 5.5 為 83.9%。Humanity's Last Exam 不使用工具的成績分別為 45.9% 和 56.9%,使用工具後分別為 57.4% 和 64.5%。
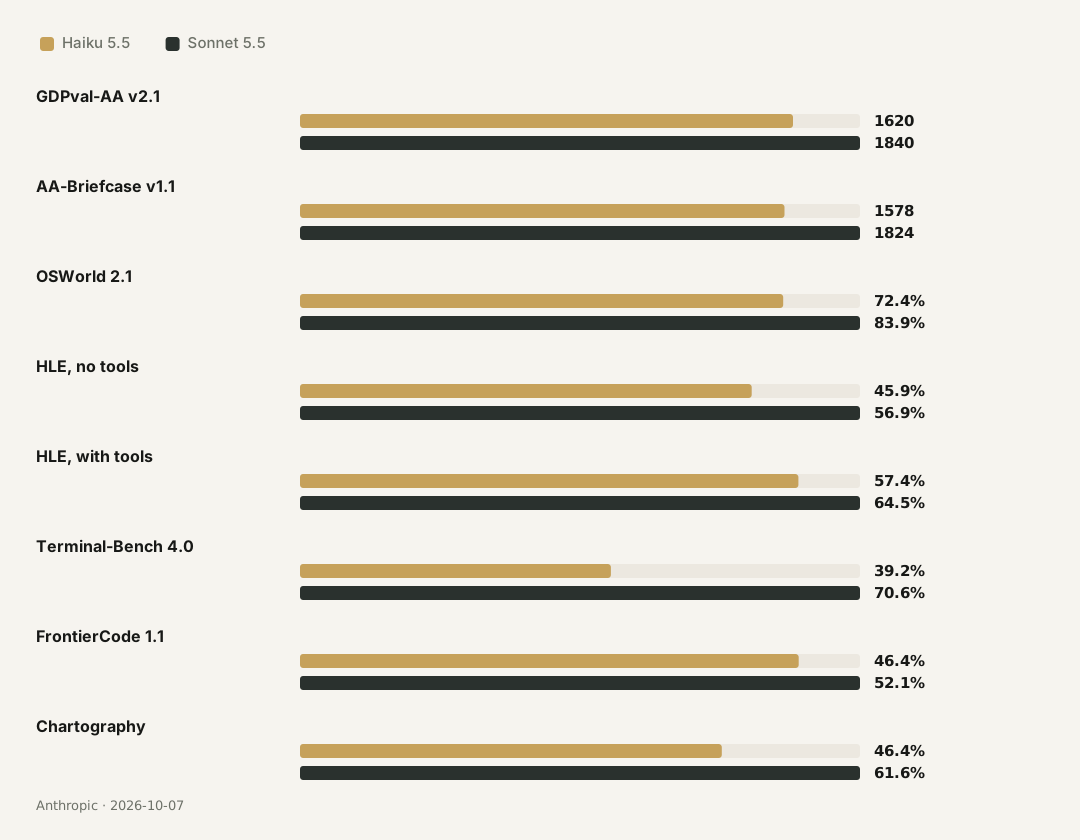
這些差距說明,Haiku 5.5 已經能處理相當一部分的知識工作和電腦操作,但複雜度再往上提高時,Sonnet 5.5 仍保有穩定的優勢。
Terminal-Bench 的差距最值得關注:Haiku 5.5 為 39.2%,Sonnet 5.5 為 70.6%。這個項目要求模型在命令列環境中完成複雜、多步驟的專業任務,更接近長程的 Agent 程式開發。Haiku 5.5 在這裡的表現已經遠高於 Haiku 4.5,但與 Sonnet 5.5 仍有很大的距離。
這為模型選擇畫出了一條清楚的界線:
- 局部、重複、可驗證的工作,Haiku 5.5 很有吸引力;
- 需要長期規劃、跨檔案修改和連續錯誤復原的任務,Sonnet 5.5 仍然更合適;
- 不能因為 Haiku 5.5 在某些 benchmark 上接近 Sonnet,就把兩者當成同一個模型的不同價位版本。
價格下降之後,真正該看的是「單位任務成本」
Haiku 5.5 的價格是這次發布的另一個重點。
對於不超過 100K Token 的請求,Haiku 5.5 的輸入價格是每百萬 Token 0.10 美元,輸出價格是 0.50 美元。超過 100K Token 之後,價格分別變為 0.50 美元和 2.50 美元。Anthropic 表示,Haiku 5.5 的平均執行成本比 Haiku 4.5 低約 75%。
| 請求規模 | 輸入價格 | 輸出價格 | 快取讀取 |
|---|---|---|---|
| 不超過 100K Token | $0.10 / MTok | $0.50 / MTok | $0.01 / MTok |
| 超過 100K Token | $0.50 / MTok | $2.50 / MTok | $0.05 / MTok |
表面上看,100K 以內的輸入價格從 Haiku 4.5 的 1 美元降到 0.10 美元,輸出價格從 5 美元降到 0.50 美元,名目單價下降了 90%。但 Anthropic 也說明,Haiku 5.5 採用了更新的 tokenizer,同樣的任務可能會消耗稍多的 Token,因此平均執行成本的降幅約為 75%,而不是單純的 90%。
對於實際產品,還要進一步考慮三件事:
- Haiku 5.5 一次就完成任務的機率有多高;
- 失敗後需要重試幾次;
- 是否需要呼叫 Sonnet 或 Opus 來審查和修正。
更有意義的指標是:
每個成功任務的成本
= 完成任務的總費用 ÷ 成功完成的任務數量
假設 Haiku 5.5 的單次呼叫成本只有 Sonnet 的十分之一,但它在某類任務上需要重試兩次,或者有 20% 的請求最後要升級到 Sonnet,那麼實際省下的幅度就會小於價目表上的差距。
反過來說,如果任務可以自動驗證,失敗後也能以低成本重試,Haiku 5.5 就可能擁有非常強的經濟優勢。
超過 100K Token 之後,價格分界會影響產品架構
在 Haiku 5.5 的價目表上,100K Token 是一個重要的分界點。
對於短請求和中等長度的請求,Haiku 5.5 的低價很容易體現出來。但面對程式碼儲存庫、長對話、企業知識庫和大量文件時,產品可能會頻繁接近或超過 100K Token。這時把所有內容一股腦塞進同一次請求,未必是最佳方案。
比較合理的架構通常包括:
- 先用 Haiku 5.5 做文件分類和相關性篩選;
- 把原始內容壓縮成結構化摘要;
- 只把和當前問題相關的片段交給更大的模型;
- 對重複的上下文使用快取;
- 把多輪對話儲存成可檢索的狀態,而不是每次完整重送。
這也是 Haiku 5.5 與 Agent 架構關係最密切的地方。它不只是一個便宜的回答模型,也可以成為上下文壓縮、檢索結果整理和子任務執行的基礎層。
effort 設定讓靜態排行榜不再夠用
Haiku 5.5 是 Haiku 系列第一個支援可調 effort 的模型。同一個模型,系統可以依任務的重要程度調整推理投入,在品質、延遲和成本之間做取捨。
這會改變我們解讀 benchmark 的方式。一個固定分數只能告訴我們模型在某個設定下的表現,完整的成本—品質曲線,才能告訴我們模型在不同預算下的行為。
簡單任務可能比較適合較低的 effort:
- 分類;
- 格式轉換;
- 固定欄位擷取;
- 短文改寫。
中等複雜度的任務可以提高 effort:
- 長文摘要;
- 跨段落的資訊整合;
- 瀏覽器中的多步驟操作;
- 需要先判斷再呼叫工具的任務。
複雜任務即使提高 effort,也不一定能取代 Sonnet。Terminal-Bench 的差距就是一個提醒:推理預算能改善表現,但不會自動消除模型在長程規劃、錯誤復原和複雜工具鏈上的能力差距。
把這些數字轉成實際的模型路由
綜合官方成績和產品定位,可以先整理出一張相對穩妥的路由表:
| 任務類型 | 預設選擇 | 原因 |
|---|---|---|
| 分類、路由、標籤 | Haiku 5.5 | 呼叫量大,輸出結構清楚,容易驗證 |
| 欄位擷取、資料整理 | Haiku 5.5 | 任務邊界明確,適合大量並行處理 |
| 摘要和上下文壓縮 | Haiku 5.5 | 價格和速度優勢明顯 |
| 單步驟或短流程的瀏覽器操作 | Haiku 5.5 | OSWorld 成績顯示其電腦操作能力已明顯提升 |
| 一般程式碼解說和小型修正 | Haiku 5.5 或 Sonnet 5.5 | 取決於有沒有自動化測試,以及出錯的代價 |
| 跨多個檔案的程式碼修改 | Sonnet 5.5 | Terminal-Bench 上仍有明顯差距 |
| 長程 Agent 程式開發 | Sonnet 5.5 或 Opus 5.5 | 需要持續規劃和錯誤復原 |
| 最終審核和高風險判斷 | Sonnet 5.5 或 Opus 5.5 | 需要更高的穩定性和更強的推理能力 |
這張表不是「Haiku 5.5 能力邊界」的永久定義。它只是把官方 benchmark、價格和產品定位放在一起之後,得出的第一版使用建議。
真正部署時,還需要用自己的任務集檢查:
- 輸出是否符合業務標準;
- 失敗能不能被自動發現;
- 失敗後重試是否划算;
- 更低的延遲能否改善產品體驗;
- 低價是否會被更高的人工檢查成本抵銷。
官方 benchmark 應該怎麼讀
面對新模型的 benchmark,最容易落入兩個誤區。
第一個誤區,是把所有項目壓縮成一個總排名。知識工作、電腦操作、開放式推理和 Agent 程式開發是不同的能力,不能用一欄總分取代。
第二個誤區,是把官方成績直接當成正式環境的結論。官方 benchmark 有明確的測試設定,但現實中的產品還會受到 prompt、工具、上下文、網路、資料和錯誤復原機制的影響。
比較可靠的讀法分成三步:
先看能力躍進
Haiku 5.5 相較 Haiku 4.5 是否有穩定的提升?從官方表格來看,答案是肯定的,尤其體現在 OSWorld、知識工作和 Agent 程式開發項目上。
再看任務邊界
它是否已經追上更大的模型?答案要看任務而定。它在部分知識工作和電腦操作上已經接近 Sonnet,但在複雜的 Agent 程式開發上仍有明顯差距。
最後看單位成本
它值不值得用,取決於品質、價格、延遲和失敗復原共同形成的結果。只看 benchmark 分數,無法回答產品是否應該切換模型。
最終判斷:Haiku 5.5 的「強」,在於可以被大量使用
如果只問 Haiku 5.5 是否超越 Sonnet 5.5,答案很簡單:沒有。官方數據已經顯示,Sonnet 5.5 在知識工作、電腦操作、綜合推理和 Agent 程式開發上仍佔優勢。
如果只問 Haiku 5.5 是否比 Haiku 4.5 更強,答案同樣明確:是,而且提升幅度很大。
真正值得討論的是第三個問題:它是否已經強到足以承擔大量正式系統中的局部工作?
從官方成績和價格來看,答案很可能也是肯定的。
Haiku 5.5 的價值在於,過去有一批需要中型模型、卻又不值得付中型模型價格的任務,現在可以放進一個更快、更便宜的執行層。分類、擷取、摘要、上下文壓縮、短流程的瀏覽器操作和 Agent 子任務,都可能成為它的主要舞台。
它不是一張新的「模型排行榜冠軍」成績單,而是一張關於模型分工的成績單:
- Haiku 4.5 證明了小模型可以便宜地完成簡單工作;
- Haiku 5.5 開始證明,小模型也能承擔一部分需要工具和多步驟操作的工作;
- Sonnet 5.5 仍然負責更複雜的規劃、程式開發和知識工作;
- Opus 5.5 則繼續處理長程、高難度、出錯代價高的任務。
模型評測的重點,也正從「誰的分數最高」轉向「誰在什麼任務上最值得被呼叫」。


