
Die offiziellen Benchmark-Werte von Claude Haiku 5.5 liegen vor. Stellt man sie neben Haiku 4.5, GPT-6 Luna und Sonnet 5.5, lautet die eigentlich spannende Frage nicht, ob das Modell jede Disziplin gewonnen hat. Sie lautet: Wie weit hat Haiku 5.5 die Grenze dessen verschoben, was ein kleines Modell leisten kann?
Das Modell, das Anthropic veröffentlicht hat, heißt Claude Haiku 5.5. Die Modell-ID lautet claude-haiku-5-5. Veröffentlicht wurde es am 7. Oktober 2026.
Anthropic positioniert es unmissverständlich: Haiku 5.5 ist das schnellste, günstigste und leistungsfähigste kleine Modell des Hauses, gedacht für Aufgaben mit hohem Volumen, niedriger Latenz und engem Kostenrahmen. Als typische Einsatzfelder nennt Anthropic Klassifizierung, Informationsextraktion, Zusammenfassungen, Kontextkomprimierung, Datenbankabfragen, Browser-Bedienung und den Einsatz als Subagent für Sonnet 5.5 oder Opus 5.5.
Dieser Artikel stützt sich ausschließlich auf die Benchmarks, Preise und Produktangaben, die Anthropic veröffentlicht hat. Er verpackt dieses Zeugnis nicht als unabhängiges Experiment. Es geht darum, die Zahlen in den Zusammenhang von Aufgabentyp, Preis und Modellrolle zurückzustellen und zu sehen, wo Haiku 5.5 wirklich stark ist – und welche Arbeit man ihm weiterhin nicht überlassen sollte.
Kurz gesagt: Haiku 5.5 hat die Grenze überschritten, an der ein kleines Modell nur einfache Arbeit erledigt
Legt man die offiziellen Zahlen nebeneinander, zeigt Haiku 5.5 ein klares Profil:
- gegenüber Haiku 4.5 legt es bei jedem wichtigen Benchmark, den Anthropic veröffentlicht hat, deutlich zu;
- bei den direkt gegenübergestellten Disziplinen liegt es vor GPT-6 Luna;
- bei Wissensarbeit, Computerbedienung und einem Teil der Reasoning-Aufgaben kommt es bereits nah an Sonnet 5.5 heran;
- beim komplexen agentischen Coding liegt es weiterhin klar hinter Sonnet 5.5;
- am wettbewerbsfähigsten ist es in der Kombination aus Tempo, Preis und einer inzwischen ausreichend hohen Erfolgsquote bei Aufgaben.
Haiku 5.5 lässt sich daher besser als Ausführungsschicht verstehen, deren Leistungsfähigkeit einen Sprung gemacht hat, denn als Modell, das Sonnet 5.5 auf ganzer Linie ersetzt.
Der offizielle Benchmark-Vergleich
Anthropic hat in der Ankündigung von Haiku 5.5 die folgenden Zahlen veröffentlicht. Die Werte für GPT-6 Luna und Sonnet 5.5 stammen aus derselben Vergleichstabelle.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: Wissensarbeit | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: Wissensarbeit | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: Computerbedienung | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| Humanity's Last Exam: ohne Tools | 45,9 % | 10,2 % | — | 56,9 % |
| Humanity's Last Exam: mit Tools | 57,4 % | 18,7 % | — | 64,5 % |
| Terminal-Bench 4.0: agentisches Coding | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1: agentisches Coding | 46,4 % | — | 42,4 % | 52,1 % |
| Chartography: visuelles Reasoning | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
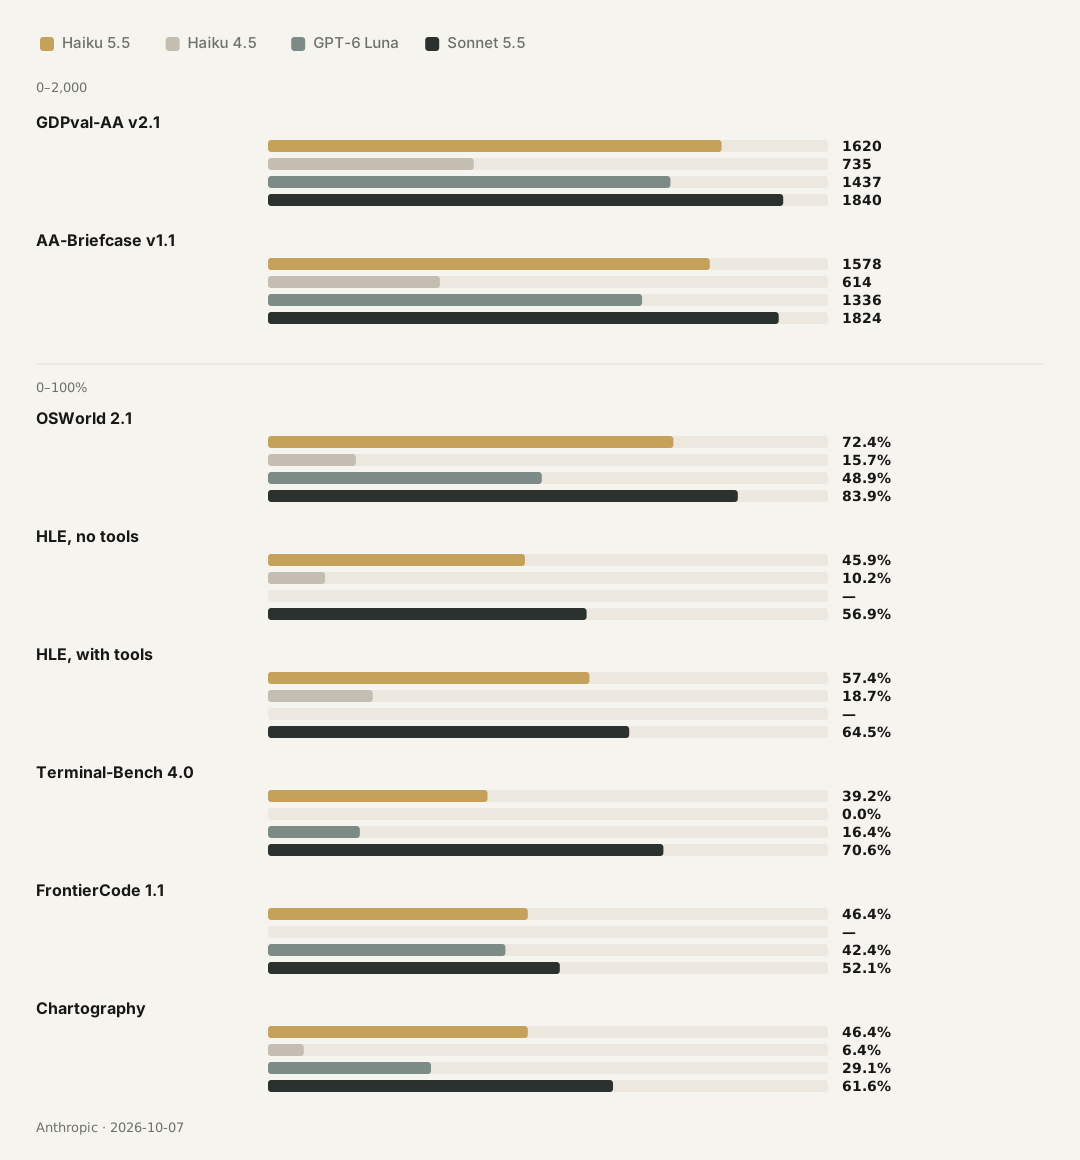
Diese Zahlen lassen sich nicht sauber zu „Haiku 5.5 belegt Platz zwei“ verdichten. Die Benchmarks messen unterschiedliche Fähigkeiten. Bei Wissensarbeit zählt die Qualität dessen, was abgeliefert wird. OSWorld prüft, ob das Modell einen echten Computer bedienen kann. Terminal-Bench prüft, ob es mehrstufige Facharbeit auf der Kommandozeile zu Ende bringt. Humanity's Last Exam zielt eher auf schweres Wissen und anspruchsvolles Reasoning.
Dass die Leistung je nach Aufgabe so stark streut, ist selbst Teil des Ergebnisses.
Veränderung eins: Haiku 5.5 hat die Vorgängergeneration hinter sich gelassen
Betrachtet man nur Haiku 4.5 und Haiku 5.5, ist das Ausmaß des Upgrades offensichtlich.
GDPval-AA v2.1 steigt von 735 auf 1620, etwa das 2,2-Fache der Vorgängergeneration. AA-Briefcase steigt von 614 auf 1578, etwa das 2,6-Fache. OSWorld klettert von 15,7 % auf 72,4 %, Terminal-Bench von 0,0 % auf 39,2 %.
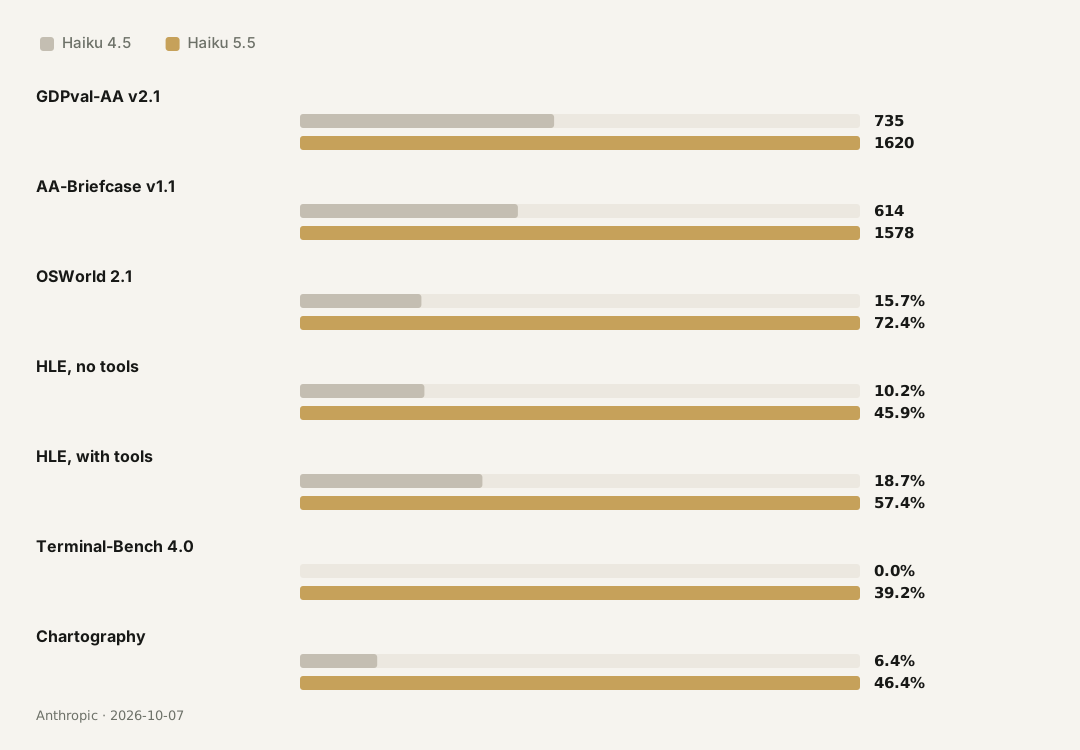
Das ist keine Veränderung nach dem Motto „die Formulierungen sind hübscher geworden“. OSWorld und Terminal-Bench verlangen lange Handlungsketten. Das Modell muss die Aufgabe verstehen, Tools aufrufen, Rückmeldungen verarbeiten und nach einem Fehler mittendrin weitermachen. Die Zugewinne in diesen Tests zeigen, dass Haiku 5.5 kein Modell mehr nur für kurze Klassifizierungen und Zusammenfassungen ist.
OSWorld ist das deutlichste Beispiel. Zwischen 15,7 % bei Haiku 4.5 und 72,4 % bei Haiku 5.5 liegt ein klarer Bruch. Selbst wenn man Benchmark-Aufbau, Offline-Teilmenge und die Testbedingungen von Anthropic einrechnet, zeigt das Ergebnis, dass sich die Computerbedienung um eine ganze Generation verändert hat.
Ein Zugewinn in einer Disziplin bedeutet allerdings nicht, dass sich jede Produktionsaufgabe im selben Maß verbessert hat. Ein Benchmark misst eine bestimmte Menge an Aufgaben. Ein echtes Produkt hängt zusätzlich von Kontextlänge, Tool-Definitionen, Fehlerbehandlung, Netzwerklatenz und der Qualität der Geschäftsdaten ab.
Veränderung zwei: Haiku 5.5 ist in den Bereich von GPT-6 Luna vorgestoßen
Bei den von Anthropic veröffentlichten Disziplinen liegt Haiku 5.5 vor GPT-6 Luna:
- GDPval-AA: 1620 gegenüber 1437;
- AA-Briefcase: 1578 gegenüber 1336;
- OSWorld: 72,4 % gegenüber 48,9 %;
- Terminal-Bench: 39,2 % gegenüber 16,4 %;
- Chartography: 46,4 % gegenüber 29,1 %.
Diese Werte reichen für eine vorsichtige Aussage: Haiku 5.5 ist in den Bereich vorgestoßen, in dem die gängigen Modelle mit gutem Preis-Leistungs-Verhältnis miteinander konkurrieren.
Zwei Einschränkungen gehören allerdings dazu.
Erstens stammen die Zahlen aus der Ankündigung von Anthropic. Unternehmen führen Benchmarks nicht auf dieselbe Weise durch, konfigurieren Modelle unterschiedlich, binden Tools anders ein und berechnen Statistiken nach eigenen Methoden. Die Tabelle zeigt gut, wo der Hersteller sein Produkt verortet. Ein vollständig unabhängiges, vollständig symmetrisches Ranking eines Dritten ist sie nicht.
Zweitens heißt „höher als GPT-6 Luna“ nicht „bei jeder Aufgabe besser als GPT-6 Luna“. Die offizielle Tabelle trägt einen Vergleich der veröffentlichten Disziplinen. Sie trägt keine Übertragung auf Aufgaben, die nicht getestet wurden.
Fair formuliert heißt das:
Bei den von Anthropic veröffentlichten Vergleichsdisziplinen erzielte Haiku 5.5 höhere Werte als GPT-6 Luna. Eine echte Modellwahl muss trotzdem Aufgabe, Preis, Tempo und Aufrufweise gegeneinander abwägen.
Veränderung drei: Nah an Sonnet – und die Modellstufen gibt es trotzdem noch
Der Abstand zwischen Haiku 5.5 und Sonnet 5.5 ist für sich genommen aufschlussreich.
Bei GDPval-AA v2.1 erreicht Haiku 5.5 1620 Punkte, Sonnet 5.5 1840. Bei AA-Briefcase lauten die Werte 1578 und 1824. Bei OSWorld kommt Haiku 5.5 auf 72,4 %, Sonnet 5.5 auf 83,9 %. Bei Humanity's Last Exam ohne Tools sind es 45,9 % und 56,9 %, mit Tools 57,4 % und 64,5 %.
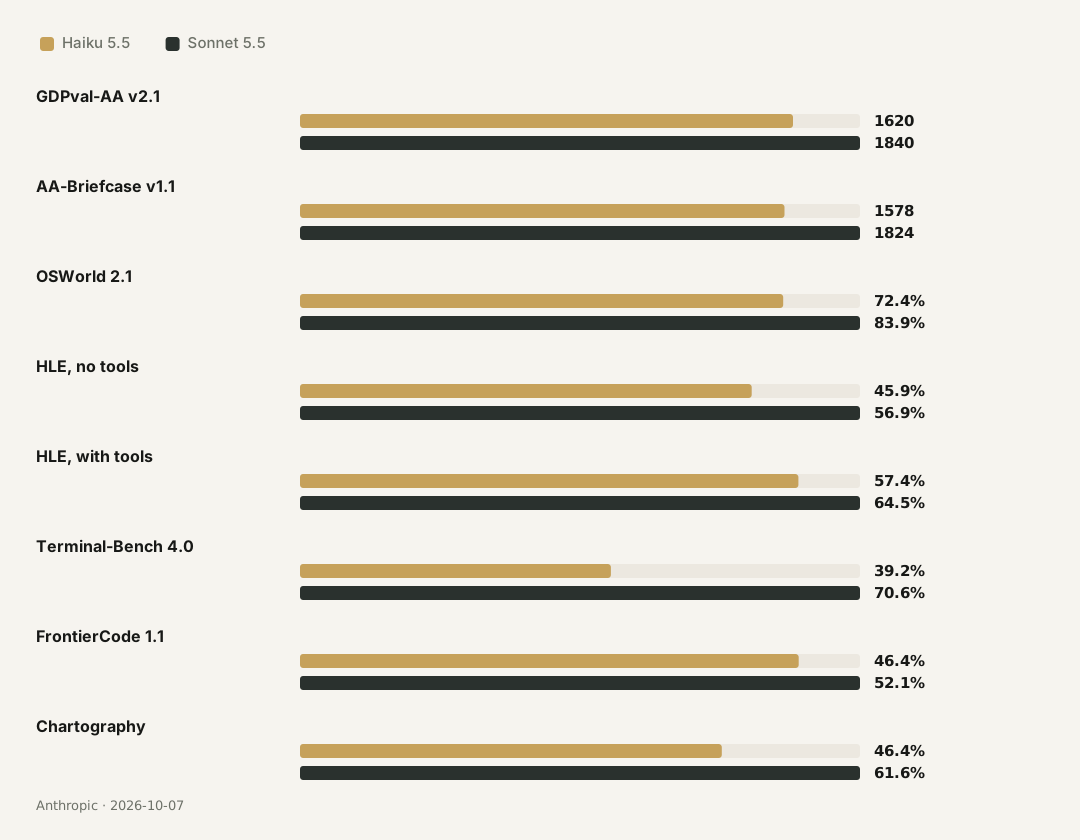
Diese Abstände zeigen: Haiku 5.5 kann bereits einen echten Teil der Wissensarbeit und Computerbedienung übernehmen. Je komplexer die Arbeit wird, desto beständiger hält Sonnet 5.5 seinen Vorsprung.
Terminal-Bench ist die Lücke, die man im Blick behalten sollte. Haiku 5.5 erreicht 39,2 %, Sonnet 5.5 70,6 %. Der Benchmark verlangt, komplexe, mehrstufige Facharbeit in einer Kommandozeilenumgebung abzuschließen, was lang laufendem agentischem Coding nahekommt. Haiku 5.5 liegt hier weit über Haiku 4.5 und noch weit hinter Sonnet 5.5.
Damit bekommt die Modellwahl eine klare Grenze:
- für lokal begrenzte, wiederkehrende, überprüfbare Arbeit ist Haiku 5.5 attraktiv;
- für Arbeit, die langfristige Planung, Änderungen über mehrere Dateien und wiederholte Fehlerbehebung erfordert, passt Sonnet 5.5 weiterhin besser;
- ein ähnlicher Wert in einigen Benchmarks ist kein Grund, beide als Preisvarianten desselben Modells zu behandeln.
Nach der Preissenkung zählen die Kosten pro Aufgabe
Der Preis ist der zweite Schwerpunkt dieser Veröffentlichung.
Bei Anfragen bis 100.000 Token berechnet Haiku 5.5 0,10 USD pro Million Eingabe-Token und 0,50 USD pro Million Ausgabe-Token. Oberhalb von 100.000 Token steigen diese Preise auf 0,50 USD und 2,50 USD. Laut Anthropic liegen die durchschnittlichen Betriebskosten von Haiku 5.5 etwa 75 % unter denen von Haiku 4.5.
| Anfragegröße | Eingabepreis | Ausgabepreis | Cache-Lesen |
|---|---|---|---|
| Bis 100.000 Token | 0,10 USD / MTok | 0,50 USD / MTok | 0,01 USD / MTok |
| Über 100.000 Token | 0,50 USD / MTok | 2,50 USD / MTok | 0,05 USD / MTok |
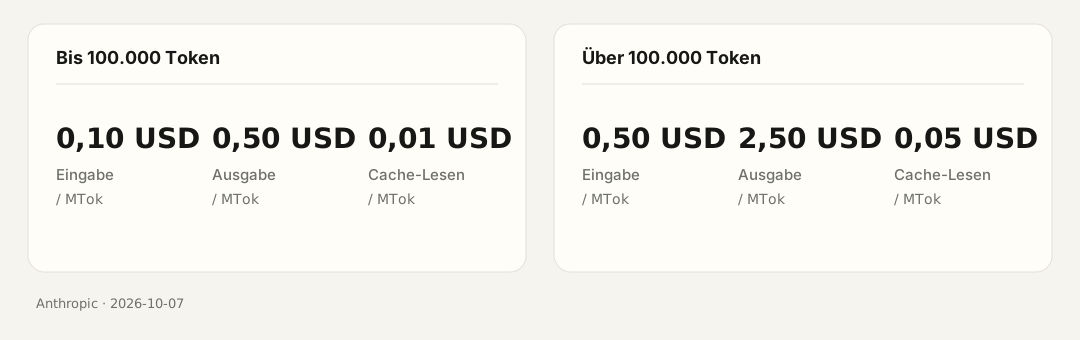
Auf den ersten Blick sinkt der Eingabepreis innerhalb von 100.000 Token von 1 USD bei Haiku 4.5 auf 0,10 USD und der Ausgabepreis von 5 USD auf 0,50 USD – eine Senkung des Listenpreises um 90 %. Anthropic weist aber auch darauf hin, dass Haiku 5.5 einen neueren Tokenizer verwendet, sodass dieselbe Aufgabe etwas mehr Token verbrauchen kann. Die durchschnittlichen Betriebskosten sinken daher um etwa 75 %, nicht pauschal um 90 %.
Ein echtes Produkt muss zusätzlich drei Fragen stellen:
- Wie oft erledigt Haiku 5.5 die Aufgabe beim ersten Aufruf?
- Wie viele Wiederholungen braucht ein Fehlschlag?
- Muss das Ergebnis noch von Sonnet oder Opus geprüft und korrigiert werden?
Aussagekräftiger ist diese Kennzahl:
Kosten pro erfolgreicher Aufgabe
= Gesamtausgaben für die Arbeit ÷ Anzahl der erfolgreich erledigten Aufgaben
Angenommen, ein Aufruf von Haiku 5.5 kostet ein Zehntel eines Sonnet-Aufrufs, die Aufgabe braucht aber zwei Wiederholungen, oder 20 % der Anfragen landen am Ende doch bei Sonnet. Dann fällt die Ersparnis kleiner aus als der Abstand auf der Preisliste.
Umgekehrt gilt: Lässt sich eine Aufgabe automatisch prüfen und ein Fehlschlag günstig wiederholen, kann Haiku 5.5 einen sehr großen wirtschaftlichen Vorteil haben.
Jenseits von 100.000 Token verändert die Preisgrenze die Produktarchitektur
Auf der Preisliste von Haiku 5.5 ist die Marke von 100.000 Token eine echte Trennlinie.
Bei kurzen und mittellangen Anfragen kommt der niedrige Preis leicht zum Tragen. Code-Repositorys, lange Unterhaltungen, Wissensdatenbanken von Unternehmen und große Dokumentensammlungen nähern sich jedoch oft den 100.000 Token oder überschreiten sie. All das in eine einzige Anfrage zu packen, ist nicht automatisch das beste Design.
Eine sinnvollere Architektur tut meist fünf Dinge:
- zuerst Haiku 5.5 für die Klassifizierung von Dokumenten und die Relevanzfilterung einsetzen;
- das Rohmaterial zu einer strukturierten Zusammenfassung verdichten;
- nur die Passagen, die für die aktuelle Frage relevant sind, an ein größeres Modell schicken;
- wiederkehrenden Kontext cachen;
- eine Unterhaltung über mehrere Runden als abrufbaren Zustand speichern, statt jedes Mal den gesamten Verlauf erneut zu senden.
Hier steht Haiku 5.5 einer Agent-Architektur am nächsten. Es ist ein günstiges Modell für Antworten und kann zugleich die Basisschicht für Kontextkomprimierung, das Sortieren von Suchergebnissen und die Ausführung von Teilaufgaben bilden.
Eine Effort-Einstellung macht statische Ranglisten weniger nützlich
Haiku 5.5 ist das erste Haiku-Modell mit einstellbarem Effort. Beim selben Modell kann ein System je nach Bedeutung der Aufgabe mehr oder weniger in Reasoning investieren und zwischen Qualität, Latenz und Kosten abwägen.
Das verändert, wie man einen Benchmark lesen sollte. Ein einzelner Wert sagt, wie sich das Modell in einer Konfiguration verhalten hat. Eine Kosten-Qualitäts-Kurve zeigt, wie es sich bei unterschiedlichen Budgets verhält.
Einfachere Aufgaben kommen mit einem niedrigeren Effort aus:
- Klassifizierung;
- Formatumwandlung;
- Extraktion fester Felder;
- Umschreiben kurzer Texte.
Aufgaben mittlerer Komplexität können einen höheren Effort bekommen:
- Zusammenfassen langer Dokumente;
- Zusammenführen von Informationen über mehrere Absätze;
- mehrstufige Arbeit im Browser;
- Aufgaben, bei denen erst eine Einschätzung und dann ein Tool-Aufruf nötig ist.
Ein höherer Effort bei einer schwierigen Aufgabe ersetzt Sonnet nicht automatisch. Die Lücke bei Terminal-Bench erinnert daran. Ein größeres Reasoning-Budget kann das Ergebnis verbessern. Es beseitigt aber keine Lücke bei langfristiger Planung, Fehlerbehebung und komplizierten Tool-Ketten.
Die Zahlen in eine praktische Routing-Tabelle übersetzen
Zusammengenommen erlauben die offiziellen Werte und die Produktpositionierung eine vorsichtige erste Routing-Tabelle:
| Aufgabe | Standardwahl | Begründung |
|---|---|---|
| Klassifizierung, Routing, Labels | Haiku 5.5 | Hohes Volumen, klare Ausgabeform, leicht überprüfbar |
| Feldextraktion und Datenbereinigung | Haiku 5.5 | Klar abgegrenzte Aufgabe, gut für hohe Parallelität geeignet |
| Zusammenfassungen und Kontextkomprimierung | Haiku 5.5 | Großer Vorteil bei Preis und Tempo |
| Browser-Abläufe mit einem oder wenigen Schritten | Haiku 5.5 | Der OSWorld-Wert zeigt einen klaren Fortschritt bei der Computerbedienung |
| Einfache Code-Erklärungen und kleine Korrekturen | Haiku 5.5 oder Sonnet 5.5 | Hängt von automatischen Tests und den Kosten eines Fehlers ab |
| Änderungen über viele Dateien | Sonnet 5.5 | Terminal-Bench zeigt weiterhin eine klare Lücke |
| Lang laufendes agentisches Coding | Sonnet 5.5 oder Opus 5.5 | Erfordert anhaltende Planung und Fehlerbehebung |
| Abschließende Prüfung und Entscheidungen mit hohem Risiko | Sonnet 5.5 oder Opus 5.5 | Erfordert mehr Stabilität und stärkeres Reasoning |
Diese Tabelle ist keine endgültige Festlegung, „wo Haiku 5.5 aufhört“. Sie ist ein erster Satz von Empfehlungen, der entsteht, wenn man offizielle Benchmarks, Preis und Produktrolle zusammenführt.
Ein echter Einsatz muss die Arbeit trotzdem an den eigenen Aufgaben prüfen:
- Erfüllt die Ausgabe den fachlichen Standard?
- Lässt sich ein Fehlschlag automatisch erkennen?
- Lohnt sich eine Wiederholung nach einem Fehlschlag finanziell?
- Verbessert die niedrigere Latenz das Produkt tatsächlich?
- Wird der niedrige Preis durch höhere Kosten für menschliche Prüfung aufgezehrt?
Wie man einen offiziellen Benchmark liest
Bei den Benchmarks eines neuen Modells passieren leicht zwei Fehler.
Der erste besteht darin, alle Disziplinen zu einer Gesamtplatzierung zusammenzufassen. Wissensarbeit, Computerbedienung, offenes Reasoning und agentisches Coding sind unterschiedliche Fähigkeiten. Eine Gesamtsumme kann sie nicht ersetzen.
Der zweite besteht darin, einen offiziellen Wert als Aussage über den Produktivbetrieb zu behandeln. Ein offizieller Benchmark hat eine festgelegte Testkonfiguration. Ein echtes Produkt wird zusätzlich vom Prompt, den Tools, dem Kontext, dem Netzwerk, den Daten und dem Mechanismus zur Fehlerbehebung beeinflusst.
Verlässlicher liest man in drei Schritten.
Zuerst den Leistungssprung betrachten
Hat sich Haiku 5.5 gegenüber Haiku 4.5 durchgängig verbessert? Laut offizieller Tabelle ja. Besonders deutlich zeigt sich das bei OSWorld, bei der Wissensarbeit und bei den Disziplinen zum agentischen Coding.
Dann die Aufgabengrenze prüfen
Hat es das größere Modell eingeholt? Das hängt von der Aufgabe ab. Bei einem Teil der Wissensarbeit und bei der Computerbedienung ist es bereits nah an Sonnet. Beim komplexen agentischen Coding ist die Lücke weiterhin deutlich.
Zum Schluss die Kosten pro Einheit
Ob sich der Einsatz lohnt, hängt von Qualität, Preis, Latenz und Fehlerbehebung zusammen ab. Ein Benchmark-Wert allein kann nicht beantworten, ob ein Produkt das Modell wechseln sollte.
Das abschließende Urteil: Haiku 5.5 ist stark, weil es sich in großem Umfang einsetzen lässt
Lautet die Frage nur, ob Haiku 5.5 Sonnet 5.5 schlägt, ist die Antwort einfach: nein. Die offiziellen Daten zeigen bereits, dass Sonnet 5.5 bei Wissensarbeit, Computerbedienung, allgemeinem Reasoning und agentischem Coding weiterhin vorn liegt.
Lautet die Frage nur, ob Haiku 5.5 stärker ist als Haiku 4.5, ist die Antwort ebenso klar: ja, und der Zugewinn ist groß.
Die eigentlich spannende Frage ist die dritte: Ist es bereits stark genug, um in Produktivsystemen einen großen Teil der lokal begrenzten Arbeit zu übernehmen?
Nach den offiziellen Werten und dem Preis lautet die Antwort wahrscheinlich ebenfalls: ja.
Der Wert von Haiku 5.5 liegt darin, dass eine Reihe von Aufgaben, die bisher ein mittelgroßes Modell brauchten, dessen Preis aber nicht wert waren, nun in einer schnelleren und günstigeren Ausführungsschicht laufen kann. Klassifizierung, Extraktion, Zusammenfassungen, Kontextkomprimierung, kurze Browser-Abläufe und Teilaufgaben für Agents können zu seinem Haupteinsatzfeld werden.
Das ist kein neues Zeugnis eines „Champions der Modell-Rangliste“. Es ist ein Zeugnis darüber, wie die Arbeit aufgeteilt wird:
- Haiku 4.5 hat gezeigt, dass ein kleines Modell einfache Arbeit günstig erledigen kann;
- Haiku 5.5 beginnt zu zeigen, dass ein kleines Modell auch einen Teil der Arbeit übernehmen kann, die Tools und mehrere Schritte erfordert;
- Sonnet 5.5 übernimmt weiterhin die komplexere Planung, das Programmieren und die Wissensarbeit;
- Opus 5.5 bleibt für die lang laufenden, sehr schwierigen Aufgaben zuständig, bei denen ein Fehler teuer ist.
Auch der Schwerpunkt der Modellbewertung verschiebt sich: von „Wer hat den höchsten Wert?“ zu „Welches Modell lohnt sich für welche Aufgabe am meisten?“.


