
Die spannende Frage bei Kimi K3.1 Pro lautet, ob es eine lange Aufgabe bis zum Ende durchhält: ein Projekt verstehen, Code ändern, Tools aufrufen und nach einem Fehlschlag weiter korrigieren. Ein ansprechender erster Bildschirm deckt davon nur einen kleinen Teil ab. Für Entwickler zählt eher: Funktionieren nach der zehnten Überarbeitung die ursprünglichen Features noch, und besteht das Ergebnis die Abnahme?
Dieser Artikel behandelt Kimi K3.1 Pro und die schnelle Variante Kimi K3.1 Pro Highspeed. Stand der Quellen: 23. Oktober 2026. Die Zahlen stammen aus offiziellem Material. Folkbench hat diese Modelle für diesen Artikel weder aufgerufen noch ihre Benchmarks wiederholt und vergibt keinen eigenen Wert.
Zuerst das Modell einordnen
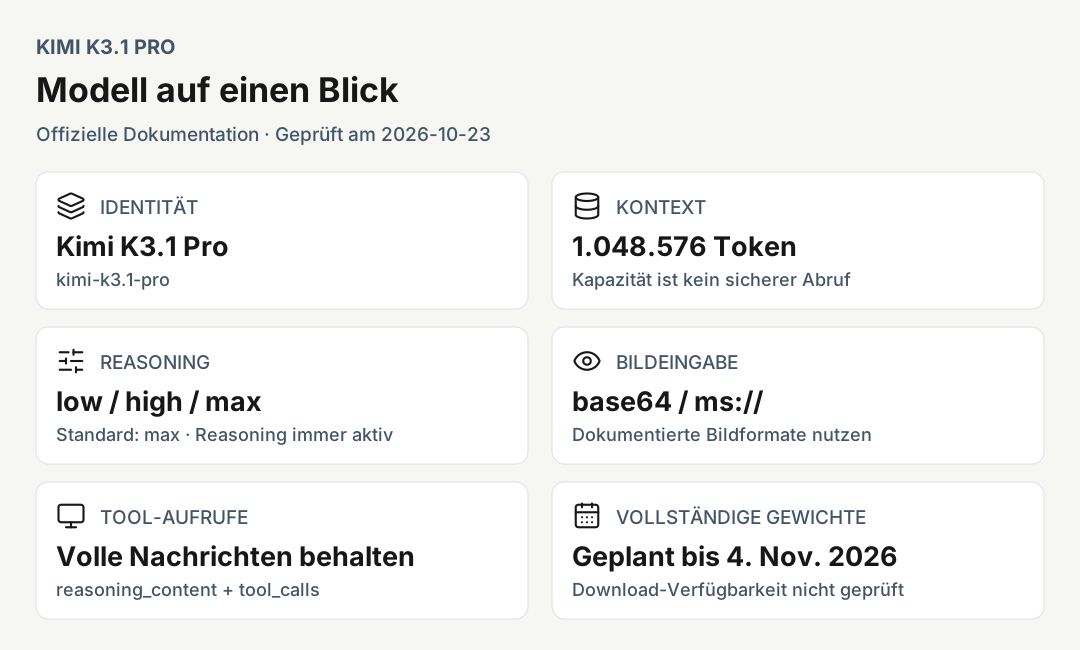
| Punkt | Geprüfte Dokumentation |
|---|---|
| Standard-API-ID | kimi-k3.1-pro |
| Highspeed-API-ID | kimi-k3.1-pro-highspeed |
| Offizielle Positionierung | Flaggschiff für Coding, 3D-Gestaltung und Finanzrecherche |
| Angabe zur Größe | 3T-Klasse; daraus lässt sich nicht ableiten, wie viele Parameter pro Anfrage aktiv sind |
| Kontextfenster | 1.048.576 Token |
| Reasoning-Stufe | low, high, max; Standard max |
| Bild und Tools | Bildeingabe, Tool-Aufrufe und Streaming |
| Gewichte | Der technische Blog plant die vollständigen Gewichte bis zum 4. November 2026; die Verfügbarkeit des Downloads wurde hier nicht geprüft |
Modellbezeichnung und Positionierung stammen aus der Modellliste, die genaue Kontextgröße aus der Abrechnungsdokumentation und die Schnittstellenfähigkeiten aus dem Schnellstart. Der technische Blog beschreibt das Modell als nachtrainierte Version von K3 und nennt den Plan für die Veröffentlichung der Gewichte. Eine Versionsnummer allein belegt also keine neue Grundarchitektur, und ein Veröffentlichungsplan belegt nicht, dass ein lokaler Einsatz bereits möglich ist.
Zwei Benchmarks, zwei verschiedene Fragen
Diese Zahlen sind der Vergleich, der im technischen Blog von Kimi veröffentlicht wurde. Auch die Spalten der Konkurrenzmodelle stammen von dieser Seite und nicht aus einem Folkbench-Versuch in einer einheitlichen Umgebung.
| Evaluation | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % |
| BenchCAD, mit Tools, Voxel IoU | 92,7 % | 96,2 % | 95,9 % |
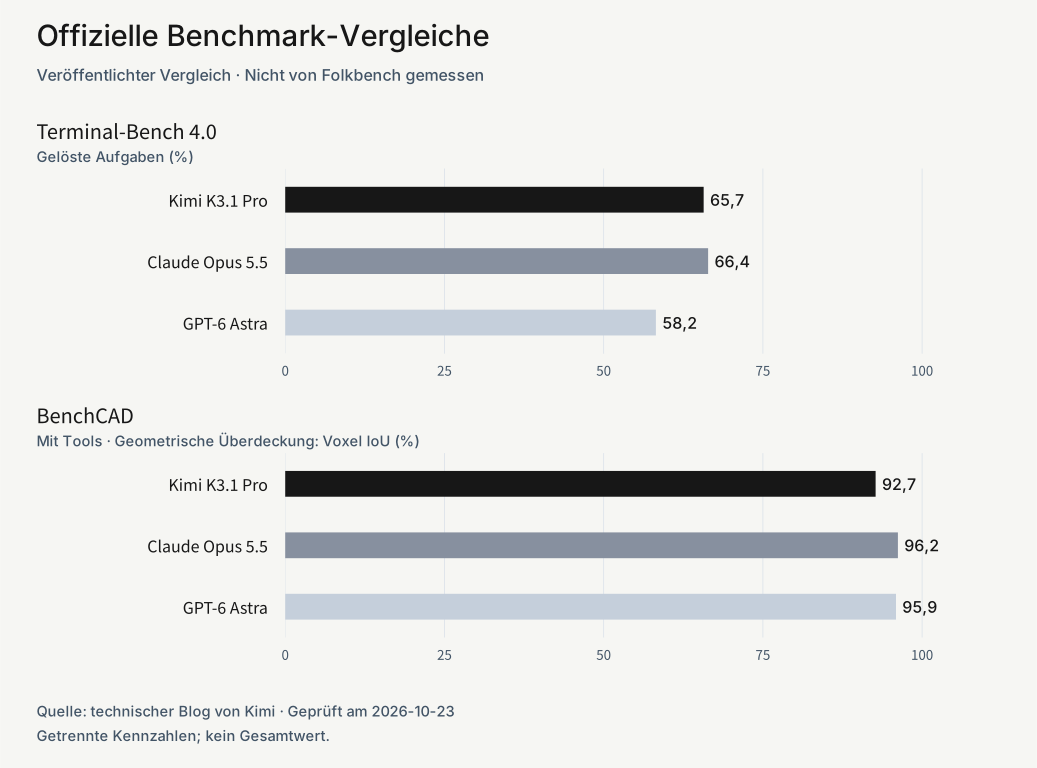
Die Fußnoten geben standardmäßig die Reasoning-Stufe max an. Kimis Terminal-Bench-Lauf verwendet Claude Code als Ausführungsumgebung; die Werte der Konkurrenz stammen aus Veröffentlichungen oder Ranglisten. BenchCAD testet offene Modelle an einer Teilmenge von 1.000 Fällen und nutzt für den Modus mit Tools ebenfalls Claude Code. Diese Bedingungen gehören zu den Werten dazu.
Coding: Ein knapper Wert ersetzt keine Abnahme im Projekt
65,7 % und 66,4 % liegen 0,7 Prozentpunkte auseinander. In dieser veröffentlichten Tabelle liegen die beiden also nah beieinander. Ohne gleiches Budget, gleiche Zahl an Wiederholungen und Angaben zur Unsicherheit reicht das nicht, um gleiche Fähigkeiten zu behaupten. Ebenso belegt ein höherer Wert als bei einem anderen Modell in einer einzelnen Evaluation nicht, dass es bei allen Coding-Aufgaben stärker ist.
In echten Projekten kommt es auf die Fehlerbehebung an. Eine Aufgabe kann verlangen, eine Schnittstelle zu ändern, die Aufrufer anzupassen und die Kompatibilität zu erhalten, ohne bestehendes Verhalten zu beschädigen. Wie viel Code beim ersten Versuch entsteht, sagt darüber wenig aus. Das Modell muss erkennen, worauf ein fehlschlagender Test tatsächlich hinweist, statt eine Assertion zu löschen, eine Bedingung aufzuweichen oder ein Feature wegzulassen, nur damit der Test durchläuft.
Wer das Modell in einen Code-Workflow einbinden will, kann vorher eine bereits gelöste Aufgabe mit klaren Abnahmekriterien erneut durchspielen: Repository-Stand und Anforderungen festlegen, jedes Kandidatenmodell unabhängig arbeiten lassen, dann Testergebnisse, Umfang der Änderungen und manuellen Nachbesserungsaufwand prüfen. Eine solche Aufzeichnung trägt eine Entscheidung besser als eine glänzende Demo. Das ist ein Vorschlag für eine Abnahme, kein Experiment, das für diesen Artikel durchgeführt wurde.
3D: Geometrische Überdeckung ist nur ein Teil des Ergebnisses
Die BenchCAD-Kennzahl ist hier Voxel IoU. Ein Wert von 92,7 % ist weder eine Erfolgsquote von 92,7 % bei Modellierungsaufgaben noch eine Bewertung künstlerischer Qualität. Geometrie, Materialien, Beleuchtung, Animation, Bearbeitbarkeit und Fertigungstoleranzen erfordern jeweils eigene Prüfungen.
Bei einer Three.js-Szene prüfen Sie, ob die Interaktionen funktionieren, wie flüssig sie auf dem Gerät läuft und ob die Ressourcen laden. Bei einem bearbeitbaren Bauteil prüfen Sie die Maße, das Verhalten nach Parameteränderungen und die exportierten Dateien. Eine überzeugende Darstellung aus einem Blickwinkel kann fehlende Flächen, sich durchdringende Geometrie oder eine unbrauchbare Topologie verbergen.
Unsere redaktionelle Einschätzung auf Basis dieser offiziellen Ergebnisse: K3.1 Pro gehört auf die Kandidatenliste für lange Coding-Aufgaben und programmatische Modellierung. Ob es eine bestehende Lösung ersetzt, sollten die Ergebnisse im jeweiligen Zielprojekt entscheiden.
Kontext mit einer Million Token beantwortet eine Kapazitätsfrage
Wie viele Dateien in 1.048.576 Token passen, hängt vom Inhalt und von der Tokenisierung ab. Es ist keine feste Zahl an Wörtern oder Codezeilen. Kapazität garantiert außerdem nicht, dass ein Modell die richtigen Belege findet, sich an alle früheren Vorgaben hält oder nach Dutzenden Tool-Aufrufen noch das ursprüngliche Ziel verfolgt.
Ein ganzes Repository mitzuschicken, kann bequem sein, bringt aber neben nützlichem Code auch generierte Dateien, veraltete Dokumentation und widersprüchliche Anweisungen mit. Besser ist eine Eingabe, die den aktuellen Stand, die relevanten Dateien, das Verhalten, das sich nicht ändern darf, und den Einstiegspunkt für die Abnahme klar benennt. Das Modell braucht brauchbaren Kontext, nicht einfach mehr Kontext.
Bei mehrstufigen Aufgaben gibt es zudem leicht übersehene laufende Kosten. Die offizielle Dokumentation zu Thinking-Modellen verlangt, das Reasoning in früheren Assistant-Nachrichten beizubehalten; es belegt weiterhin Kontext und wird mit abgerechnet. Eine kurze sichtbare Antwort kann also mit einer deutlich höheren Token-Rechnung einhergehen.
API-Einstellungen können das Erlebnis verändern
Laut Leitfaden zur Reasoning-Stufe arbeitet K3.1 Pro immer mit Reasoning, Standard ist max. low senkt die Stufe, schaltet das Denken aber nicht ab. Gleichen Sie diesen Parameter an, bevor Sie Geschwindigkeiten vergleichen, sonst spiegelt ein scheinbarer Tempounterschied womöglich nur unterschiedliche Budgets wider.
Bei der Migration sollten Sie drei Punkte gesondert prüfen:
- Verwenden Sie
reasoning_effortauf oberster Ebene, statt diethinking-Konfiguration von K2 zu übernehmen. - Behalten Sie in Tool-Schleifen die vollständigen Assistant-Nachrichten bei, einschließlich
reasoning_contentundtool_calls. Wer nur den finalen Text behält, verliert den Verlauf, den die Schnittstelle verlangt. - Halten Sie sich bei Bildern an den Schnellstart: Verwenden Sie base64 oder
ms://-Dateiverweise, statt davon auszugehen, dass beliebige öffentliche Bild-URLs angenommen werden.
Ein Relay wirft eigene Fragen auf: Bleiben die Anfragefelder erhalten, werden Antworten abgeschnitten, wird der Modellname umgemappt, fehlen Angaben zur Nutzung? Dass die Modell-API eine normale Antwort liefert, heißt noch nicht, dass die Tool-Schleife des darüberliegenden Agents korrekt funktioniert.
Kosten beginnen bei der ganzen Aufgabe
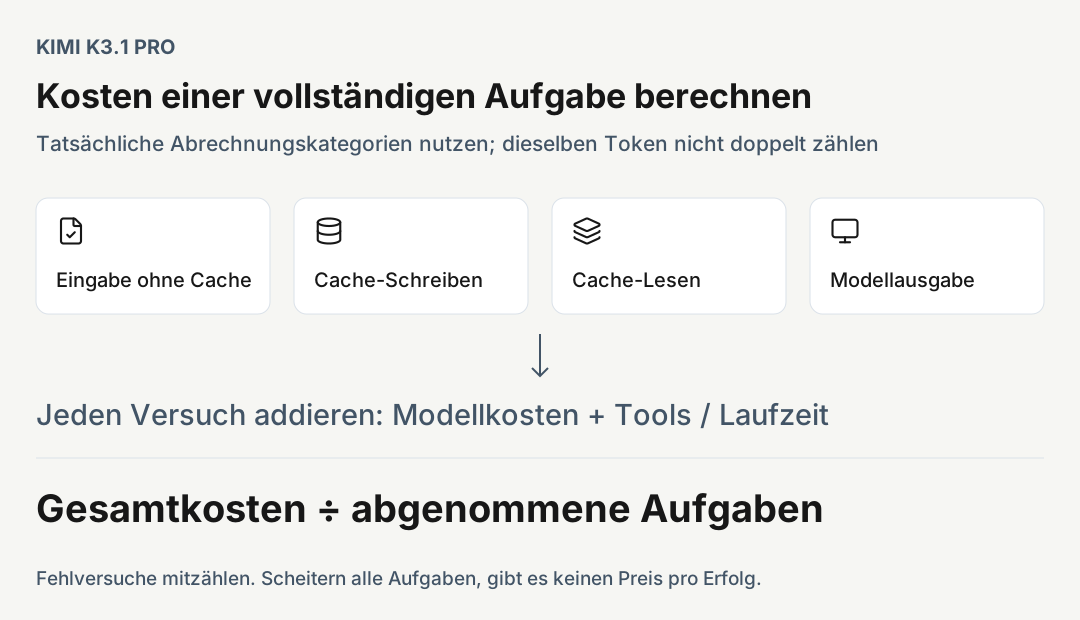
Die offizielle Preisseite und ihre Markdown-Fassung lieferten bei dieser Prüfung keine vollständige, nachprüfbare Preiszeile für K3.1 Pro. Wir veröffentlichen daher keine Dollarpreise und setzen auch keine Preise von K3 oder von Relays ein. Das beweist nicht, dass offizielle Preise unveröffentlicht sind; es beschreibt, was dieser Artikel prüfen konnte.
Dokumentiert ist die Abrechnungsstruktur: Die API-Nutzung wird getrennt von der Kimi-Mitgliedschaft und Kimi Code nach Verbrauch abgerechnet; Cache-Schreiben unterscheidet sich nach TTL, Cache-Treffer und Eingabe ohne Cache werden getrennt abgerechnet. Der Schnellstart beschreibt Preise ohne Staffelung nach Kontextlänge. Der Leitfaden zum Caching dokumentiert Wiederverwendung und Gültigkeitsdauer.
Bei einer Aufgabe mit langem Kontext sollten Sie daher getrennt betrachten, welche Eingaben den Cache verfehlen, welche Cache-Schreiben auslösen, welche als Cache-Lesen abgerechnet werden und wie viel Ausgabe am Ende entsteht. Tool-Dienste, Ausführungsumgebungen und fehlgeschlagene Wiederholungen können die Gesamtkosten erhöhen. Halten Sie sich an die tatsächlichen Kategorien der Rechnung, damit dieselben Token nicht doppelt gezählt werden.
Eine nützliche Kennzahl für Einkauf und Migration ist Gesamtkosten des Durchlaufs geteilt durch abgenommene Aufgaben. Fehlversuche bleiben im Zähler; scheitern alle Aufgaben, gibt es keinen Preis pro erfolgreicher Aufgabe, den man angeben könnte. Das ist eine vorgeschlagene Vergleichsmethode, kein von Folkbench gemessenes Ergebnis.
Die Modellliste beschreibt Highspeed als Variante mit gleicher Leistungsfähigkeit bei etwa 2- bis 3-facher Geschwindigkeit. Das ist eine Angabe des Anbieters, keine Messung eines ganzen Workflows. Wenn die Generierung die Hälfte der Gesamtzeit ausmacht und diese Hälfte auf ein Drittel schrumpft, sinkt die Gesamtzeit von 1 auf etwa 0,67: insgesamt rund die 1,5-fache Geschwindigkeit. Diese hypothetische Rechnung veranschaulicht einen Engpass und ist keine beobachtete Latenz von Kimi.
Womit Sie die Evaluation beginnen können
| Arbeit | Zu prüfende Fähigkeit | Ein aussagekräftiges Abnahmeergebnis |
|---|---|---|
| Änderungen über mehrere Code-Dateien | Vorgaben einhalten, Tools nutzen, Fehler beheben | Tests bestanden, alte Features erhalten, vertretbarer Nachbesserungsaufwand |
| Programmatisches 3D und Web-Interaktion | Räumliche Beziehungen, Skripte, Iteration | Bearbeitbare Dateien, funktionierende Interaktionen, ausreichende Performance |
| Recherche über mehrere Dokumente und Tabellen | Belege finden, dokumentübergreifend abgleichen | Nachvollziehbare Zitate, einheitliche Einheiten, nachrechenbare Berechnungen |
| Einfache Extraktion oder häufige Klassifizierung | Latenz und Kosten pro Aufgabe | Geringere Kosten bei gleicher Qualitätsschwelle |
Die ersten drei passen zu seiner offiziellen Positionierung, doch eine Positionierung ist keine Qualitätsgarantie. Gerade bei Recherche können flüssige Sprache und viele Zitate die Einzelprüfung nicht ersetzen: Stützt die Quelle die Aussage wirklich, stimmen Jahreszahlen und Einheiten überein, lassen sich die Tabellenformeln nachrechnen? Für einfache Klassifizierung ist ein Flaggschiffmodell mit Standardstufe max nicht unbedingt die wirtschaftlichste Wahl.
Die Einschätzung von Folkbench
Das offizielle Material liefert Kimi K3.1 Pro einen glaubwürdigen Grund für eine ernsthafte Evaluation: Seine Ergebnisse bei Coding und programmatischer Modellierung liegen nahe an starken Vergleichsmodellen. Der praktische Nutzen hängt davon ab, ob sich diese Fähigkeiten mit Ihren Eingaben, Tools und Ihrem Budget zuverlässig in abgenommene Ergebnisse umsetzen lassen.
Diesem Artikel fehlen eigene Aufrufprotokolle, wiederholte Versuche, Fehlerverteilungen und nachprüfbare Stückpreise. Deshalb gibt es hier weder einen Gesamtwert noch die Aussage „bestes Preis-Leistungs-Verhältnis“. Einige Benchmark-Abschnitte im Schnellstart enthalten noch Platzhalter und weichen in der Version vom technischen Blog ab. Die beiden Vergleiche oben stammen durchgehend aus dem Blog und kombinieren keine verschiedenen Versionen.
Für Code-Workflows lesen Sie weiter im [Folkbench-Leitfaden zur Evaluation von Softwareentwicklung](/de/blog/ai-api-relay-software-engineering-evaluation-guide). Weitere Modellartikel sind [Claude Opus 5.5](/de/blog/claude-opus-5-5-review-pricing) und [GPT-6.1 Sol](/de/blog/gpt-6-1-sol-review-pricing). Sol ist nicht das GPT-6 Astra aus der Tabelle; Modellbezeichnungen und Werte lassen sich nicht austauschen.


