
Skor resmi Claude Haiku 5.5 sudah keluar. Sandingkan dengan Haiku 4.5, GPT-6 Luna, dan Sonnet 5.5, maka pertanyaan yang layak dibahas bukanlah apakah ia memenangi setiap item, melainkan seberapa jauh Haiku 5.5 mendorong batas kemampuan sebuah model kecil.
Model yang dirilis Anthropic adalah Claude Haiku 5.5. ID modelnya claude-haiku-5-5, dan model ini dirilis pada 7 Oktober 2026.
Anthropic memosisikannya secara lugas. Haiku 5.5 adalah model kecil mereka yang tercepat, termurah, dan paling mumpuni, ditujukan untuk pekerjaan bervolume tinggi, berlatensi rendah, dan sensitif terhadap biaya. Penggunaan khas yang disebutkan meliputi klasifikasi, ekstraksi informasi, peringkasan, pemadatan konteks, kueri basis data, penggunaan browser, serta peran sebagai subagen untuk Sonnet 5.5 atau Opus 5.5.
Artikel ini hanya memakai benchmark, harga, dan pernyataan produk yang dipublikasikan Anthropic, dan tidak mengemas ulang rapor resmi itu sebagai eksperimen independen. Tugasnya adalah menempatkan kembali angka-angka tersebut ke dalam konteks jenis tugas, harga, dan peran model, lalu melihat di mana Haiku 5.5 benar-benar kuat, serta pekerjaan apa yang sebaiknya masih tidak diserahkan kepadanya.
Ringkasnya: Haiku 5.5 telah melewati garis “model kecil hanya untuk pekerjaan sederhana”
Satukan angka-angka resmi itu, dan profil Haiku 5.5 tampak jelas:
- Dibandingkan Haiku 4.5, skornya naik tajam di setiap benchmark utama yang dipublikasikan Anthropic;
- Pada item yang dilaporkan berdampingan, ia unggul atas GPT-6 Luna;
- Pada pekerjaan berbasis pengetahuan, pengoperasian komputer, dan sebagian tugas penalaran, ia sudah mendekati Sonnet 5.5;
- Pada coding berbasis agen yang kompleks, ia masih jelas tertinggal dari Sonnet 5.5;
- Daya saing terbesarnya ada pada kombinasi kecepatan, harga, dan tingkat penyelesaian tugas yang kini sudah cukup tinggi.
Haiku 5.5 lebih tepat dipahami sebagai lapisan eksekusi yang kemampuannya melonjak, bukan model yang menggantikan Sonnet 5.5 di semua lini.
Perbandingan benchmark resmi
Anthropic memublikasikan angka-angka berikut di halaman pengumuman Haiku 5.5. Sel GPT-6 Luna dan Sonnet 5.5 berasal dari tabel perbandingan yang sama.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: pekerjaan berbasis pengetahuan | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: pekerjaan berbasis pengetahuan | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: pengoperasian komputer | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam: tanpa alat | 45,9% | 10,2% | — | 56,9% |
| Humanity's Last Exam: dengan alat | 57,4% | 18,7% | — | 64,5% |
| Terminal-Bench 4.0: coding berbasis agen | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1: coding berbasis agen | 46,4% | — | 42,4% | 52,1% |
| Chartography: penalaran visual | 46,4% | 6,4% | 29,1% | 61,6% |
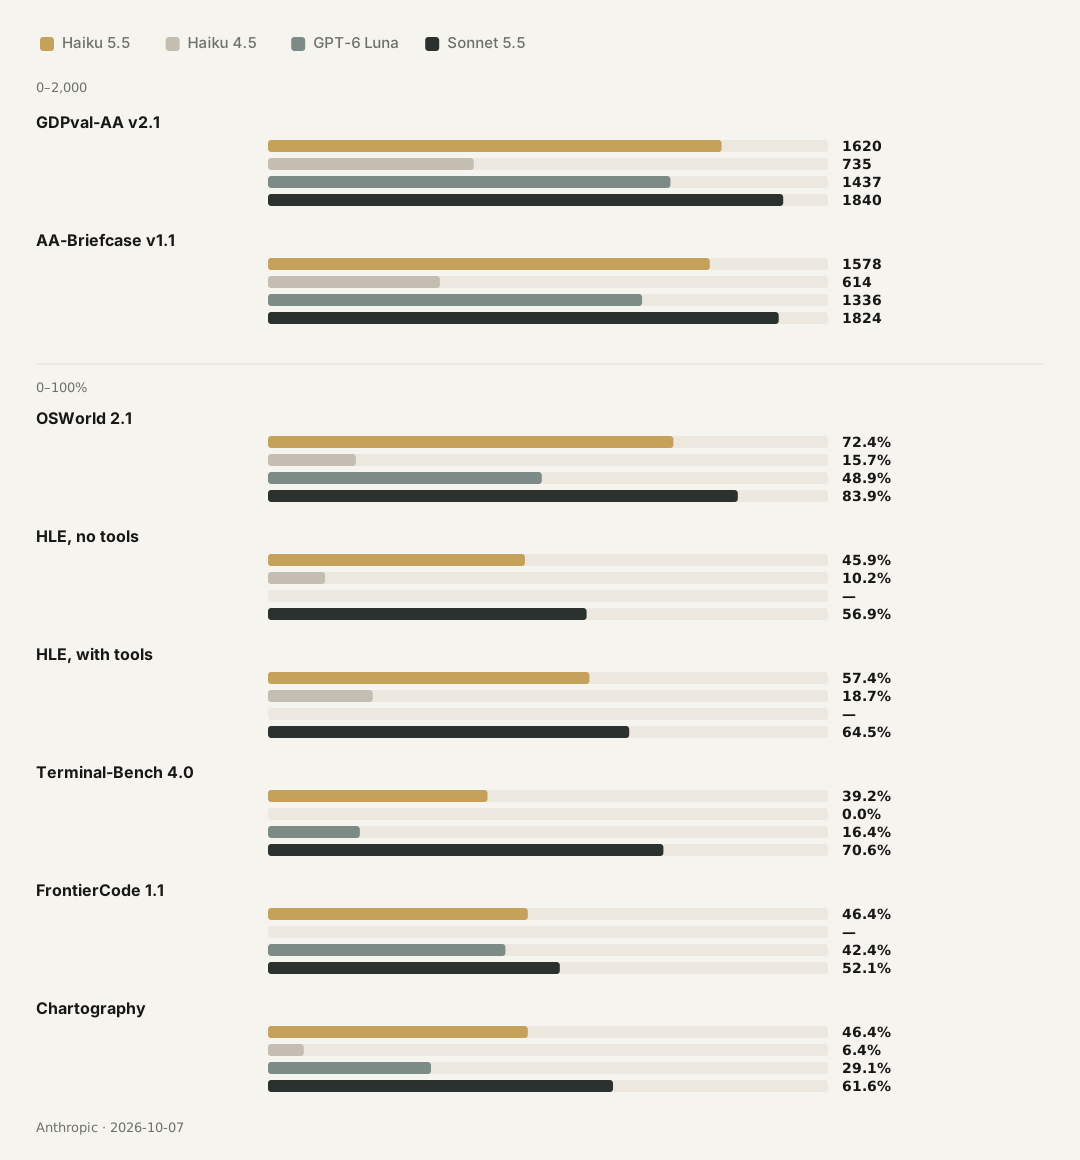
Angka-angka ini tidak bisa diringkas begitu saja menjadi “Haiku 5.5 berada di peringkat kedua”. Setiap benchmark mengukur kemampuan yang berbeda. Pekerjaan berbasis pengetahuan menilai kualitas hasil yang diserahkan. OSWorld menilai apakah model dapat mengoperasikan komputer sungguhan. Terminal-Bench menilai apakah model dapat menuntaskan pekerjaan profesional bertahap di command line. Humanity’s Last Exam lebih condong ke pengetahuan dan penalaran tingkat sulit.
Rentang hasil yang lebar antartugas itu sendiri merupakan bagian dari hasil evaluasi.
Perubahan pertama: Haiku 5.5 meninggalkan generasi sebelumnya jauh di belakang
Jika hanya membandingkan Haiku 4.5 dan Haiku 5.5, besarnya peningkatan langsung terlihat.
GDPval-AA v2.1 naik dari 735 menjadi 1620, sekitar 2,2 kali generasi sebelumnya. AA-Briefcase naik dari 614 menjadi 1578, sekitar 2,6 kali. OSWorld naik dari 15,7% menjadi 72,4%. Terminal-Bench naik dari 0,0% menjadi 39,2%.
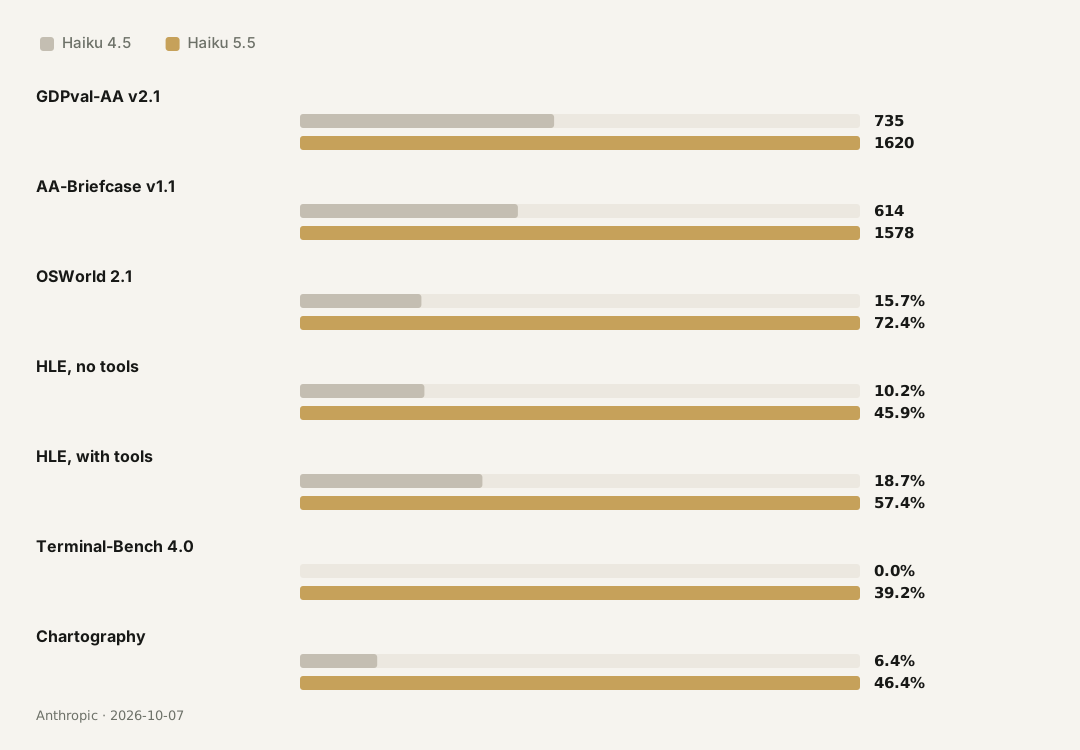
Ini bukan perubahan sekelas “kalimatnya jadi lebih indah”. OSWorld dan Terminal-Bench sama-sama melibatkan rangkaian tindakan yang panjang. Model harus memahami tugas, memanggil alat, menangani umpan balik, dan tetap melanjutkan setelah membuat kesalahan di tengah jalan. Peningkatan pada pengujian semacam ini menunjukkan bahwa Haiku 5.5 bukan lagi sekadar model untuk klasifikasi teks pendek dan ringkasan.
OSWorld adalah contoh paling mencolok. Ada lompatan yang jelas antara Haiku 4.5 di 15,7% dan Haiku 5.5 di 72,4%. Bahkan setelah memperhitungkan pengaturan benchmark, subset offline, dan kondisi pengujian Anthropic, hasil ini tetap menunjukkan bahwa kemampuan pengoperasian komputer melompat setara satu generasi penuh.
Meski begitu, peningkatan pada satu item tidak berarti setiap tugas produksi membaik dengan besaran yang sama. Benchmark mengukur sekumpulan tugas tertentu. Produk nyata juga bergantung pada panjang konteks, cara alat didefinisikan, pemulihan dari kesalahan, latensi jaringan, dan kualitas data bisnis.
Perubahan kedua: ia sudah masuk ke kelas GPT-6 Luna
Pada item-item yang dipublikasikan Anthropic, skor Haiku 5.5 lebih tinggi daripada GPT-6 Luna:
- GDPval-AA: 1620 berbanding 1437;
- AA-Briefcase: 1578 berbanding 1336;
- OSWorld: 72,4% berbanding 48,9%;
- Terminal-Bench: 39,2% berbanding 16,4%;
- Chartography: 46,4% berbanding 29,1%.
Kumpulan angka itu cukup untuk sebuah klaim yang hati-hati: Haiku 5.5 telah masuk ke arena persaingan model-model arus utama yang berefisiensi biaya tinggi.
Ada dua batasan yang harus selalu menyertai klaim tersebut.
Pertama, angka-angka ini berasal dari pengumuman Anthropic. Cara setiap perusahaan menjalankan benchmark, mengonfigurasi model, memasang alat, dan menghitung statistik tidak selalu sama. Tabel ini bagus untuk melihat di mana pembuat model menempatkan produknya, tetapi bukan peringkat pihak ketiga yang sepenuhnya independen dan sepenuhnya simetris.
Kedua, “lebih tinggi daripada GPT-6 Luna” tidak berarti “lebih baik daripada GPT-6 Luna di setiap tugas”. Tabel resmi mendukung perbandingan atas item yang dipublikasikan, tetapi tidak mendukung penerapan hasil itu pada tugas yang tidak diuji.
Cara yang adil untuk menyatakannya adalah:
Pada item perbandingan yang dipublikasikan Anthropic, Haiku 5.5 mencatat skor lebih tinggi daripada GPT-6 Luna. Pilihan nyata tetap harus mempertimbangkan jenis tugas, harga, kecepatan, dan cara model dipanggil.
Perubahan ketiga: ia dekat dengan Sonnet, tetapi tingkatan model masih ada
Selisih antara Haiku 5.5 dan Sonnet 5.5 juga membawa informasi tersendiri.
Pada GDPval-AA v2.1, Haiku 5.5 mencetak 1620 dan Sonnet 5.5 mencetak 1840. Pada AA-Briefcase, skor keduanya 1578 dan 1824. Pada OSWorld, Haiku 5.5 mencapai 72,4% dan Sonnet 5.5 mencapai 83,9%. Pada Humanity’s Last Exam tanpa alat, skornya 45,9% dan 56,9%. Dengan alat, skornya 57,4% dan 64,5%.
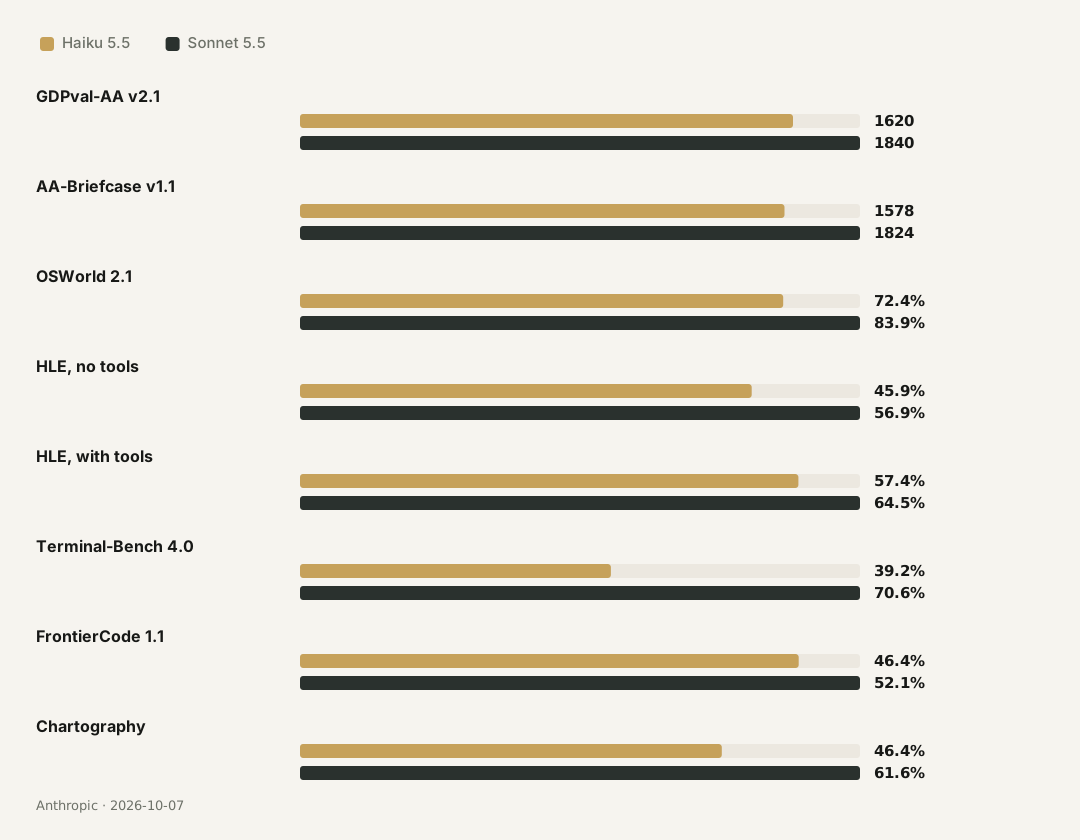
Selisih-selisih itu menunjukkan bahwa Haiku 5.5 sudah mampu menangani porsi yang berarti dari pekerjaan berbasis pengetahuan dan pengoperasian komputer. Namun, saat pekerjaan makin kompleks, Sonnet 5.5 tetap memegang keunggulan yang stabil.
Terminal-Bench adalah selisih yang patut diperhatikan. Haiku 5.5 mencapai 39,2%, sedangkan Sonnet 5.5 mencapai 70,6%. Benchmark ini meminta model menyelesaikan tugas profesional yang kompleks dan bertahap di lingkungan command line, yang dekat dengan coding berbasis agen jangka panjang. Di sini Haiku 5.5 jauh di atas Haiku 4.5, tetapi masih tertinggal jauh dari Sonnet 5.5.
Hal itu memberi batas yang jelas dalam memilih model:
- Untuk pekerjaan yang cakupannya terbatas, berulang, dan dapat diverifikasi, Haiku 5.5 sangat menarik;
- Untuk pekerjaan yang memerlukan perencanaan jangka panjang, perubahan lintas file, dan pemulihan berulang dari kesalahan, Sonnet 5.5 masih lebih cocok;
- Skor yang berdekatan di beberapa benchmark bukan alasan untuk menganggap keduanya sebagai varian harga dari model yang sama.
Setelah harga turun, angka yang patut dicermati adalah biaya per tugas
Harga adalah fokus lain dari rilis ini.
Untuk permintaan hingga 100 ribu token, Haiku 5.5 mengenakan $0,10 per 1 juta token input dan $0,50 per 1 juta token output. Di atas 100 ribu token, harga itu menjadi $0,50 dan $2,50. Anthropic menyebut biaya rata-rata menjalankan Haiku 5.5 sekitar 75% lebih rendah daripada Haiku 4.5.
| Ukuran permintaan | Harga input | Harga output | Pembacaan cache |
|---|---|---|---|
| Hingga 100 ribu token | $0,10 / 1 jt token | $0,50 / 1 jt token | $0,01 / 1 jt token |
| Lebih dari 100 ribu token | $0,50 / 1 jt token | $2,50 / 1 jt token | $0,05 / 1 jt token |
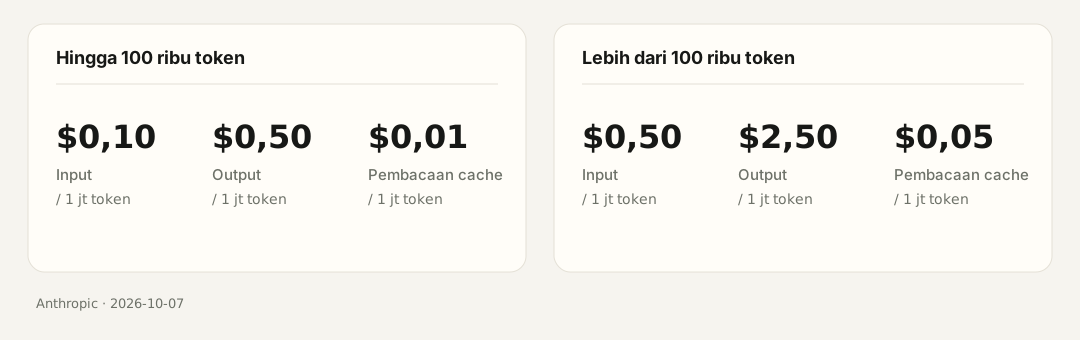
Sekilas, harga input hingga 100 ribu token turun dari $1 pada Haiku 4.5 menjadi $0,10, dan harga output turun dari $5 menjadi $0,50, pemangkasan 90% pada harga satuan yang tercantum. Namun, Anthropic juga menyebut bahwa Haiku 5.5 memakai tokenizer yang lebih baru, sehingga tugas yang sama bisa menghabiskan sedikit lebih banyak token. Karena itu, penurunan biaya rata-rata menjalankannya sekitar 75%, bukan rata 90%.
Produk nyata masih perlu menjawab tiga pertanyaan lanjutan:
- Seberapa sering Haiku 5.5 menuntaskan tugas pada panggilan pertama?
- Berapa kali percobaan ulang yang dibutuhkan saat gagal?
- Apakah hasilnya masih perlu ditinjau dan diperbaiki oleh Sonnet atau Opus?
Ukuran yang lebih berguna adalah:
Biaya per tugas yang berhasil
= total biaya untuk menyelesaikan pekerjaan ÷ jumlah tugas yang berhasil diselesaikan
Misalkan satu panggilan Haiku 5.5 hanya berbiaya sepersepuluh panggilan Sonnet, tetapi tugasnya butuh dua kali percobaan ulang, atau 20% permintaan pada akhirnya dinaikkan ke Sonnet. Penghematannya pun jadi lebih kecil daripada selisih di daftar harga.
Sebaliknya, jika suatu tugas dapat diverifikasi secara otomatis dan kegagalan bisa dicoba ulang dengan murah, Haiku 5.5 dapat memiliki keunggulan ekonomi yang sangat kuat.
Di atas 100 ribu token, batas harga mengubah arsitektur produk
Dalam daftar harga Haiku 5.5, 100 ribu token adalah garis pemisah yang nyata.
Untuk permintaan pendek dan menengah, harga rendahnya mudah terasa. Namun, repositori kode, percakapan panjang, basis pengetahuan perusahaan, dan kumpulan dokumen besar sering mendekati atau melewati 100 ribu token. Menjejalkan semuanya ke dalam satu permintaan belum tentu merupakan desain terbaik.
Arsitektur yang lebih masuk akal biasanya melakukan lima hal:
- Memakai Haiku 5.5 terlebih dahulu untuk mengklasifikasi dokumen dan menyaring relevansi;
- Memadatkan bahan mentah menjadi ringkasan terstruktur;
- Hanya mengirim bagian yang relevan dengan pertanyaan saat ini ke model yang lebih besar;
- Menyimpan konteks yang berulang di cache;
- Menyimpan percakapan multi-giliran sebagai status yang dapat diambil kembali, alih-alih mengirim ulang seluruh utas setiap kali.
Di sinilah Haiku 5.5 paling dekat dengan arsitektur agen. Ia bukan hanya model murah untuk menjawab, tetapi juga bisa menjadi lapisan dasar untuk pemadatan konteks, pengurutan hasil pencarian, dan pelaksanaan subtugas.
Pengaturan effort membuat peringkat statis kurang berguna
Haiku 5.5 adalah model Haiku pertama dengan pengaturan effort yang dapat disesuaikan. Dengan model yang sama, sistem dapat mengalokasikan lebih banyak atau lebih sedikit penalaran sesuai pentingnya tugas, lalu memilih titik keseimbangan antara kualitas, latensi, dan biaya.
Hal ini mengubah cara membaca benchmark. Satu skor hanya menunjukkan perilaku model dalam satu konfigurasi. Kurva biaya–kualitas menunjukkan perilakunya di berbagai tingkat anggaran.
Tugas yang lebih sederhana bisa memakai effort yang lebih rendah:
- Klasifikasi;
- Konversi format;
- Ekstraksi kolom tetap;
- Penulisan ulang teks pendek.
Tugas menengah bisa memakai effort yang lebih tinggi:
- Meringkas dokumen panjang;
- Menghimpun informasi lintas paragraf;
- Pekerjaan bertahap di browser;
- Tugas yang harus menilai dulu, baru memanggil alat.
Menaikkan effort pada tugas sulit tidak otomatis menggantikan Sonnet. Selisih Terminal-Bench menjadi pengingatnya. Anggaran penalaran yang lebih besar dapat memperbaiki hasil, tetapi tidak menghapus kesenjangan dalam perencanaan jangka panjang, pemulihan dari kesalahan, dan rantai alat yang rumit.
Ubah angka menjadi tabel perutean yang praktis
Secara keseluruhan, skor resmi dan posisi produk mendukung tabel perutean awal yang hati-hati berikut:
| Tugas | Pilihan default | Alasan |
|---|---|---|
| Klasifikasi, perutean, label | Haiku 5.5 | Volume tinggi, bentuk output jelas, dan mudah diverifikasi |
| Ekstraksi kolom dan pembersihan data | Haiku 5.5 | Batas tugas eksplisit, cocok untuk konkurensi tinggi |
| Ringkasan dan pemadatan konteks | Haiku 5.5 | Keunggulan harga dan kecepatannya besar |
| Alur browser satu langkah atau pendek | Haiku 5.5 | Skor OSWorld menunjukkan peningkatan jelas dalam pengoperasian komputer |
| Penjelasan kode biasa dan perbaikan kecil | Haiku 5.5 atau Sonnet 5.5 | Bergantung pada tes otomatis dan besarnya biaya bila terjadi kesalahan |
| Perubahan di banyak file | Sonnet 5.5 | Terminal-Bench masih menunjukkan kesenjangan yang jelas |
| Coding berbasis agen jangka panjang | Sonnet 5.5 atau Opus 5.5 | Butuh perencanaan berkelanjutan dan pemulihan dari kesalahan |
| Peninjauan akhir dan keputusan berisiko tinggi | Sonnet 5.5 atau Opus 5.5 | Butuh stabilitas lebih tinggi dan penalaran lebih kuat |
Tabel ini bukan definisi permanen tentang “batas kemampuan Haiku 5.5”. Ini hanyalah serangkaian saran awal yang diperoleh dengan menyatukan benchmark resmi, harga, dan peran produk.
Penerapan nyata tetap harus menguji pekerjaan itu pada tugas-tugasnya sendiri:
- Apakah output memenuhi standar bisnis?
- Apakah kegagalan dapat terdeteksi secara otomatis?
- Apakah percobaan ulang setelah gagal sepadan dengan biayanya?
- Apakah latensi yang lebih rendah benar-benar memperbaiki produk?
- Apakah harga yang murah tergerus oleh biaya peninjauan manual yang lebih tinggi?
Cara membaca benchmark resmi
Ada dua kesalahan yang mudah terjadi saat membaca benchmark model baru.
Pertama, melebur semua item menjadi satu peringkat keseluruhan. Pekerjaan berbasis pengetahuan, pengoperasian komputer, penalaran terbuka, dan coding berbasis agen adalah kemampuan yang berbeda. Satu skor total tidak bisa mewakili semuanya.
Kedua, menganggap skor resmi sebagai kesimpulan untuk lingkungan produksi. Benchmark resmi memiliki konfigurasi pengujian yang dinyatakan. Produk nyata juga dipengaruhi oleh prompt, alat, konteks, jaringan, data, dan mekanisme pemulihan dari kesalahan.
Cara membaca yang lebih andal terdiri atas tiga langkah.
Mulailah dari lompatan kemampuan
Apakah Haiku 5.5 meningkat secara konsisten dibandingkan Haiku 4.5? Menurut tabel resmi, ya. Perubahan itu terutama terlihat pada OSWorld, pekerjaan berbasis pengetahuan, dan item coding berbasis agen.
Lalu lihat batas tugasnya
Apakah ia sudah menyamai model yang lebih besar? Itu tergantung tugasnya. Pada sebagian pekerjaan berbasis pengetahuan dan pengoperasian komputer, ia sudah mendekati Sonnet. Pada coding berbasis agen yang kompleks, kesenjangannya masih jelas.
Akhiri dengan biaya per unit
Layak dipakai atau tidaknya bergantung pada kombinasi kualitas, harga, latensi, dan pemulihan dari kegagalan. Skor benchmark saja tidak dapat menjawab apakah sebuah produk perlu berganti model.
Penilaian akhir: Haiku 5.5 kuat karena bisa dipakai dalam volume besar
Jika pertanyaannya hanya apakah Haiku 5.5 mengalahkan Sonnet 5.5, jawabannya sederhana: tidak. Data resmi sudah menunjukkan bahwa Sonnet 5.5 masih unggul dalam pekerjaan berbasis pengetahuan, pengoperasian komputer, penalaran umum, dan coding berbasis agen.
Jika pertanyaannya hanya apakah Haiku 5.5 lebih kuat daripada Haiku 4.5, jawabannya sama jelasnya: ya, dan peningkatannya besar.
Pertanyaan yang layak dibahas adalah yang ketiga. Apakah ia sudah cukup kuat untuk mengambil alih banyak bagian pekerjaan di dalam sistem produksi?
Berdasarkan skor resmi dan harganya, jawabannya kemungkinan besar ya.
Nilai Haiku 5.5 terletak pada kemampuannya memindahkan sekumpulan tugas, yang dulu membutuhkan model kelas menengah tetapi tidak sepadan dengan harga model kelas menengah, ke lapisan eksekusi yang lebih cepat dan lebih murah. Klasifikasi, ekstraksi, ringkasan, pemadatan konteks, alur browser pendek, dan subtugas agen semuanya bisa menjadi panggung utamanya.
Ini bukan rapor baru tentang “juara peringkat model”. Ini adalah rapor tentang pembagian kerja:
- Haiku 4.5 membuktikan bahwa model kecil dapat mengerjakan pekerjaan sederhana dengan murah;
- Haiku 5.5 mulai membuktikan bahwa model kecil juga dapat menangani sebagian pekerjaan yang memerlukan alat dan lebih dari satu langkah;
- Sonnet 5.5 masih menangani perencanaan, coding, dan pekerjaan berbasis pengetahuan yang lebih kompleks;
- Opus 5.5 tetap menangani tugas jangka panjang dan berkesulitan tinggi yang mahal jika terjadi kesalahan.
Fokus evaluasi model pun sedang bergeser, dari “siapa yang skornya tertinggi” menjadi “siapa yang paling layak dipanggil untuk tugas apa”.


