
Pertanyaan yang menarik tentang Kimi K3.1 Pro adalah apakah model ini mampu menuntaskan tugas panjang: memahami proyek, menyunting kode, memakai tool, lalu memperbaiki diri ketika hasilnya gagal. Tampilan pertama yang memukau hanya sebagian kecil dari pekerjaan itu. Bagi pengembang, pertanyaan yang lebih berharga adalah: setelah revisi kesepuluh, apakah fitur aslinya masih berfungsi, dan apakah hasil kerjanya lolos uji penerimaan?
Model yang dibahas di sini adalah Kimi K3.1 Pro dan varian cepatnya, Kimi K3.1 Pro Highspeed. Sumber dicek per 23 Oktober 2026. Angka-angkanya berasal dari materi resmi. Untuk artikel ini, Folkbench tidak memanggil model tersebut, tidak menjalankan ulang benchmark-nya, dan tidak memberikan skor independen.
Kenali modelnya lebih dulu
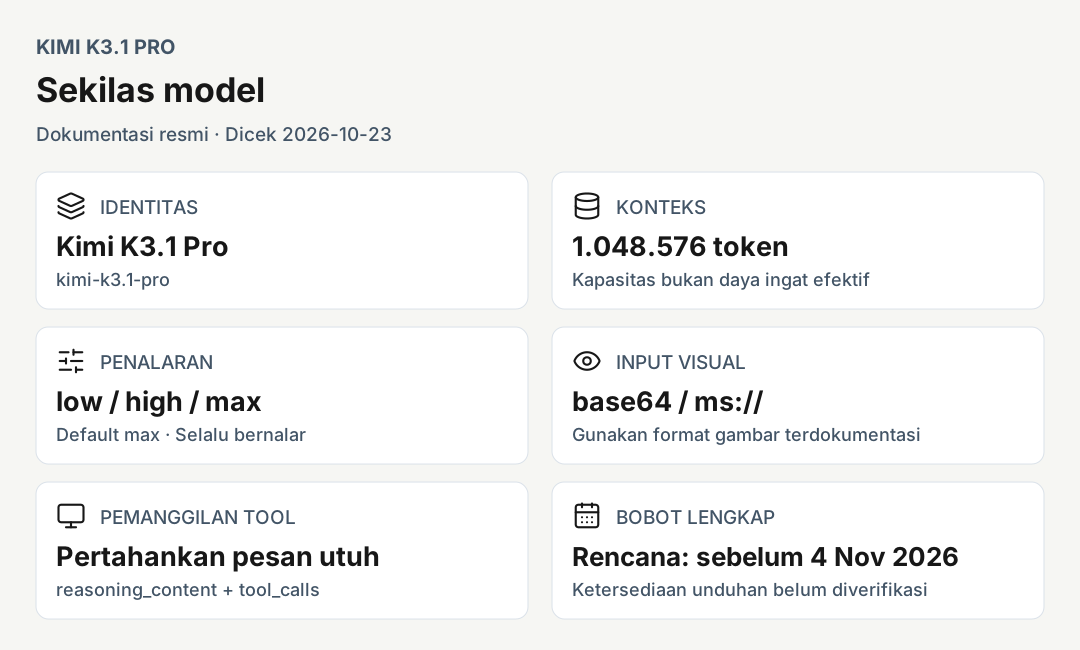
| Item | Hasil pengecekan dokumentasi |
|---|---|
| ID API standar | kimi-k3.1-pro |
| ID API Highspeed | kimi-k3.1-pro-highspeed |
| Posisi resmi | Model unggulan untuk coding, kreasi 3D, dan riset keuangan |
| Keterangan skala | Kelas 3T; ini tidak menunjukkan berapa parameter yang aktif per permintaan |
| Jendela konteks | 1.048.576 token |
| Tingkat penalaran | low, high, max; default max |
| Visual dan tool | Input visual, pemanggilan tool, dan streaming |
| Bobot | Blog teknis menargetkan bobot lengkap dirilis paling lambat 4 November 2026; ketersediaan unduhan belum diverifikasi di sini |
Identitas dan posisi model berasal dari daftar model, ukuran konteks yang persis dari dokumentasi penagihan, dan kemampuan antarmuka dari panduan mulai cepat. Blog teknis menggambarkannya sebagai hasil post-training dari K3 dan mencantumkan rencana rilis bobotnya. Nomor versi saja tidak membuktikan adanya arsitektur dasar yang baru, dan rencana rilis tidak membuktikan bahwa model ini sudah bisa dijalankan secara lokal.
Dua benchmark, dua pertanyaan berbeda
Angka-angka berikut adalah perbandingan yang dipublikasikan di blog teknis Kimi. Kolom pesaing juga berasal dari halaman itu, bukan dari eksperimen Folkbench dengan lingkungan yang seragam.
| Evaluasi | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% |
| BenchCAD, dengan tool, Voxel IoU | 92,7% | 96,2% | 95,9% |
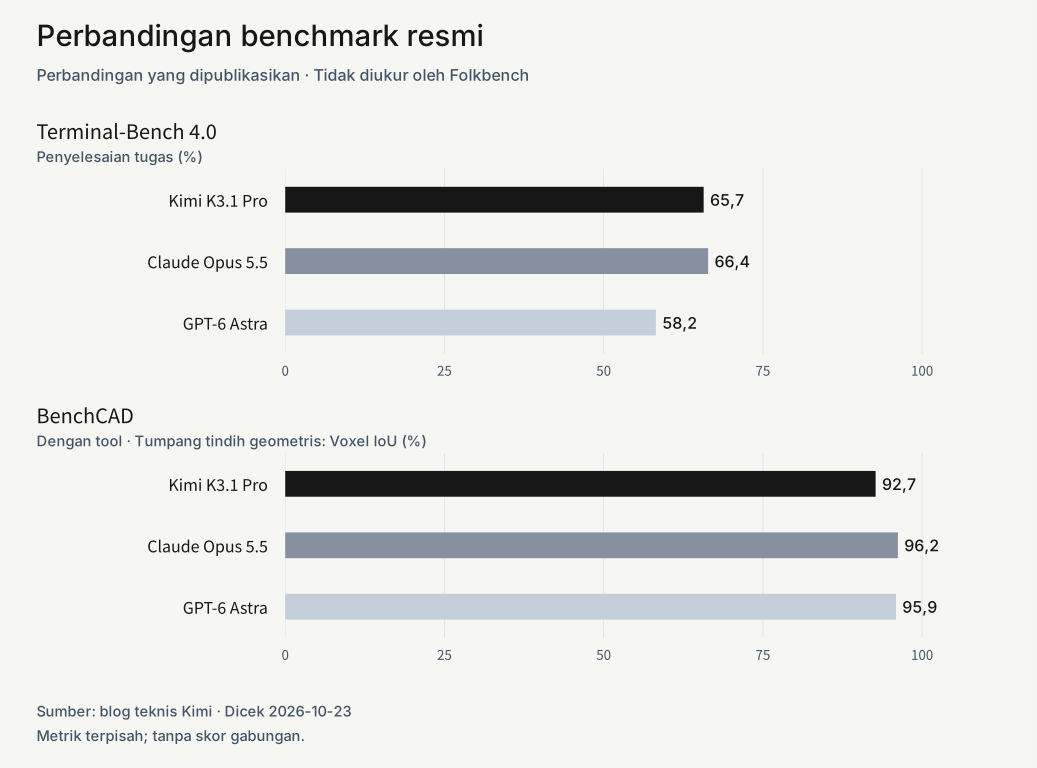
Catatan kaki resmi menyebut tingkat penalaran max sebagai default. Run Terminal-Bench Kimi memakai kerangka eksekusi Claude Code, sedangkan hasil pesaing dikumpulkan dari materi rilis atau papan peringkat. BenchCAD menguji model terbuka pada subset 1.000 sampel, dan mode dengan tool juga memakai Claude Code. Kondisi-kondisi ini perlu selalu disertakan bersama skornya.
Coding: skor yang berdekatan tetap butuh uji penerimaan di tingkat proyek
65,7% dan 66,4% berselisih 0,7 poin persentase. Keduanya berdekatan dalam tabel yang dipublikasikan ini. Tanpa anggaran run yang setara, jumlah pengulangan, dan estimasi ketidakpastian, itu tidak cukup untuk menyatakan kemampuannya setara. Demikian pula, skor yang lebih tinggi daripada model lain pada satu evaluasi tidak membuktikan keunggulan di semua tugas coding.
Dalam proyek nyata, yang lebih penting adalah pemulihan dari kesalahan. Sebuah permintaan bisa menuntut perubahan antarmuka, pembaruan di semua pemanggil, dan kompatibilitas yang tetap terjaga, tanpa merusak perilaku yang sudah ada. Jumlah kode yang dihasilkan pada percobaan pertama hampir tidak menjawab kewajiban itu. Model harus memahami apa arti pengecekan yang gagal, bukan menghapus assertion, melonggarkan kondisi, atau membuang fitur demi membuatnya lolos.
Sebelum bermigrasi, putar ulang tugas lama yang sudah terselesaikan dan memiliki kriteria penerimaan yang jelas. Tetapkan revisi repositori dan kebutuhannya, biarkan setiap kandidat mengerjakannya secara mandiri, lalu periksa hasil pengujian, cakupan perubahan, dan jumlah perbaikan manual. Catatan seperti itu lebih mendukung keputusan daripada demo yang tampak meyakinkan. Ini adalah usulan cara menguji penerimaan, bukan eksperimen yang sudah dijalankan untuk artikel ini.
3D: kemiripan geometri baru sebagian dari hasil kerja yang siap diserahkan
Metrik BenchCAD di sini adalah Voxel IoU. Nilai 92,7% bukan tingkat keberhasilan tugas 92,7%, dan juga bukan penilaian kualitas artistik. Geometri, material, pencahayaan, animasi, kemudahan penyuntingan, dan toleransi manufaktur membutuhkan pengecekan yang berbeda.
Untuk adegan Three.js, periksa apakah interaksinya berfungsi, bagaimana performanya di perangkat, dan apakah semua aset termuat. Untuk komponen yang bisa disunting, periksa dimensi, bentuk setelah parameter diubah, dan file hasil ekspor. Render yang meyakinkan dari satu sudut bisa menyembunyikan permukaan yang hilang, geometri yang saling tembus, atau topologi yang tidak bisa dipakai.
Penilaian editorial kami berdasarkan hasil resmi ini: K3.1 Pro layak masuk daftar kandidat untuk tugas coding panjang dan pemodelan terprogram. Apakah model ini bisa menggantikan solusi yang sudah ada sebaiknya ditentukan oleh hasil kerja nyata di proyek sasaran.
Konteks sejuta token menjawab soal kapasitas
Jumlah file yang muat dalam 1.048.576 token bergantung pada isi dan tokenisasi. Ini bukan jumlah kata atau baris kode yang tetap. Kapasitas juga tidak menjamin bahwa model menemukan bukti yang tepat, mengingat setiap batasan sebelumnya, atau tetap mengejar tujuan awal setelah puluhan panggilan tool.
Mengirim seluruh repositori bisa praktis, tetapi juga ikut membawa file hasil generate, dokumentasi usang, dan instruksi yang saling bertentangan bersama kode yang berguna. Sebutkan revisi yang berlaku, file yang relevan, perilaku yang tidak boleh berubah, dan titik masuk uji penerimaan. Yang dibutuhkan model adalah konteks yang berguna, bukan sekadar konteks yang lebih banyak.
Ada juga biaya berulang yang mudah terlewat. Dokumentasi model thinking resmi mewajibkan konten penalaran dalam pesan assistant sebelumnya tetap disertakan; bagian ini terus memakan konteks dan ikut ditagih. Jawaban yang tampak pendek bisa saja disertai tagihan token yang jauh lebih besar untuk keseluruhan run.
Pengaturan API bisa mengubah pengalaman
Panduan tingkat penalaran menyebut K3.1 Pro selalu bernalar dengan default max. Memilih low berarti menurunkan tingkatnya, bukan mematikan proses berpikir. Samakan pengaturan ini sebelum membandingkan latensi; jika tidak, hasil yang tampak “lebih lambat” bisa jadi hanya mencerminkan anggaran yang berbeda.
Saat bermigrasi, ada tiga hal yang perlu dicek tersendiri:
- Gunakan
reasoning_effortdi tingkat teratas, jangan menyalin konfigurasithinkingdari K2. - Pertahankan pesan assistant secara utuh dalam loop tool, termasuk
reasoning_contentdantool_calls. Jika hanya teks akhir yang disimpan, riwayat yang diwajibkan antarmuka akan hilang. - Untuk input visual, ikuti panduan mulai cepat: gunakan base64 atau referensi file
ms://, jangan berasumsi bahwa URL gambar publik apa pun bisa langsung diterima.
Relay menambah pertanyaannya sendiri: apakah kolom permintaan dipertahankan, apakah respons terpotong, apakah nama model dipetakan ulang, dan apakah detail penggunaan lengkap? Respons teks yang berhasil tidak membuktikan bahwa loop tool pada agen di atasnya sudah bekerja dengan benar.
Biaya dimulai dari keseluruhan tugas
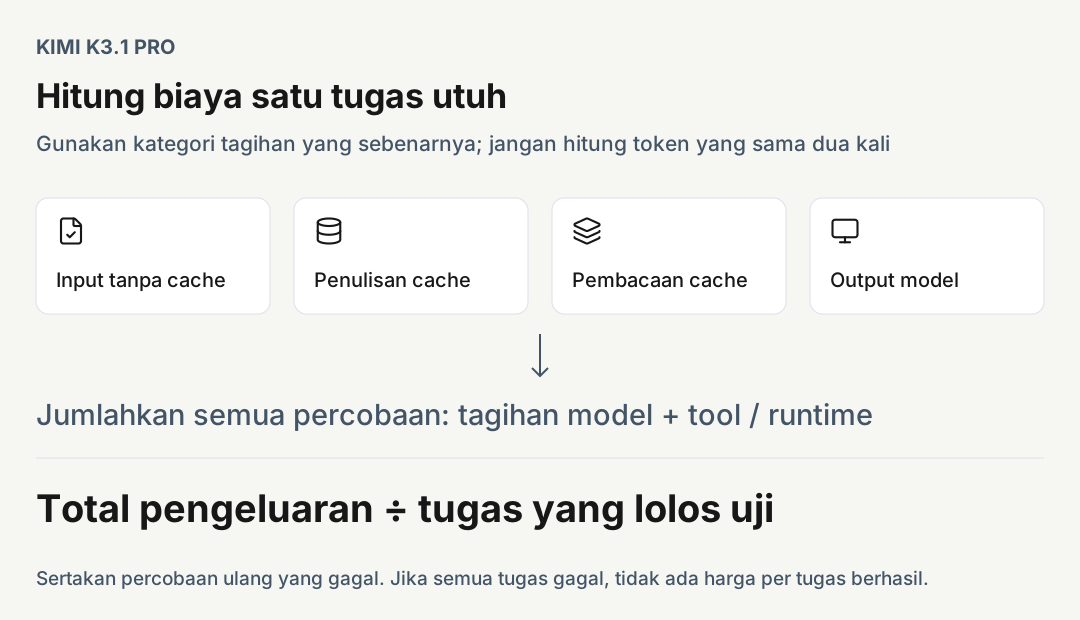
Halaman harga resmi beserta versi Markdown-nya tidak menampilkan baris harga K3.1 Pro yang lengkap dan dapat diverifikasi saat pengecekan ini. Karena itu, kami tidak mencantumkan tarif dalam dolar dan tidak meminjam harga K3 atau harga relay. Ini tidak membuktikan bahwa harga resmi belum dipublikasikan; ini hanya menggambarkan apa yang bisa diverifikasi oleh artikel ini.
Yang terdokumentasi adalah struktur penagihannya: API ditagih sesuai pemakaian, terpisah dari keanggotaan Kimi dan Kimi Code; penulisan cache dibedakan menurut TTL, sedangkan cache hit dan input tanpa cache memiliki kategori penagihan sendiri. Panduan mulai cepat menyebut harganya tidak berjenjang menurut panjang konteks. Panduan cache menjelaskan aturan pemakaian ulang dan masa berlakunya.
Saat menilai tugas berkonteks panjang, pisahkan input yang tidak mengenai cache, penulisan cache, pembacaan cache, dan output yang dihasilkan. Layanan tool, lingkungan eksekusi, dan percobaan ulang yang gagal juga bisa menambah pengeluaran. Ikuti kategori yang sebenarnya di tagihan agar token yang sama tidak dihitung dua kali.
Ukuran yang berguna untuk pengadaan dan diskusi migrasi adalah total pengeluaran untuk satu kelompok tugas dibagi jumlah tugas yang lolos uji penerimaan. Percobaan yang gagal tetap dihitung dalam pembilang; jika semua tugas gagal, tidak ada harga per tugas berhasil yang bisa dilaporkan. Ini adalah usulan cara membandingkan, bukan hasil yang sudah diukur Folkbench.
Daftar model menggambarkan Highspeed sebagai varian dengan kemampuan yang sama dan kecepatan sekitar 2–3×. Itu klaim penyedia, bukan pengukuran alur kerja dari ujung ke ujung. Jika pembuatan output memakan separuh total waktu, memangkas separuh itu menjadi sepertiganya hanya menurunkan total waktu dari 1 menjadi sekitar 0,67: secara keseluruhan sekitar 1,5× lebih cepat. Perhitungan hipotetis ini menggambarkan hambatan, bukan latensi Kimi yang teramati.
Dari mana mulai mengevaluasinya
| Jenis pekerjaan | Kemampuan yang perlu diamati | Hasil uji penerimaan yang bermakna |
|---|---|---|
| Perubahan lintas file kode | Menjaga batasan, memakai tool, pulih dari kegagalan | Pengujian lolos, fitur lama tetap ada, perbaikan manual masih wajar |
| 3D terprogram dan interaksi web | Hubungan spasial, pembuatan skrip, iterasi | File bisa disunting, interaksi berfungsi, performa memadai |
| Riset multidokumen dan analisis spreadsheet | Menemukan bukti, pengecekan silang | Kutipan bisa ditelusuri, satuan konsisten, perhitungan bisa diulang |
| Ekstraksi sederhana atau klasifikasi berfrekuensi tinggi | Latensi dan biaya per tugas | Pengeluaran lebih baik pada ambang kualitas yang sama |
Tiga jenis pertama sesuai dengan posisi resminya, tetapi posisi bukan jaminan kualitas. Terutama dalam riset, bahasa yang lancar dan banyaknya kutipan tidak bisa menggantikan pengecekan satu per satu: apakah sumbernya benar-benar mendukung setiap klaim, apakah tahun dan satuannya konsisten, dan apakah rumus spreadsheet bisa dihitung ulang. Untuk klasifikasi sederhana, model unggulan yang berjalan dengan default max belum tentu pilihan yang paling hemat.
Penilaian Folkbench
Materi resmi memberi K3.1 Pro alasan yang kredibel untuk masuk ke evaluasi yang serius: hasil coding dan pemodelan terprogramnya berada di dekat pembanding yang kuat. Nilai praktisnya bergantung pada apakah kemampuan itu bisa diubah secara konsisten menjadi hasil kerja yang lolos uji penerimaan dengan input, tool, dan anggaran Anda.
Artikel ini belum memiliki catatan panggilan sendiri, uji berulang, distribusi kegagalan, dan harga satuan yang terverifikasi, sehingga tidak memberikan skor gabungan maupun klaim “efisiensi biaya terbaik”. Sebagian bagian benchmark di panduan mulai cepat masih berisi placeholder dan versinya berbeda dari blog teknis. Kedua perbandingan di atas hanya memakai blog teknis secara konsisten, tanpa menggabungkan versi yang berbeda.
Untuk alur kerja kode, lanjutkan ke [panduan evaluasi rekayasa perangkat lunak Folkbench](/id/blog/ai-api-relay-software-engineering-evaluation-guide). Liputan model terkait mencakup [Claude Opus 5.5](/id/blog/claude-opus-5-5-review-pricing) dan [GPT-6.1 Sol](/id/blog/gpt-6-1-sol-review-pricing). Sol bukan GPT-6 Astra yang ada di tabel; identitas dan skor keduanya tidak bisa dipertukarkan.


