1 回の失敗は、モデルが間違えたことを証明できます。しかしそれだけでは、以前より間違えやすくなったことまでは証明できません。
「このモデル、また賢さが落ちた?」片足がペダルから浮いたペリカンに、フレームがねじれて絡まった自転車。そこへ先週はかなりうまく描けていたスクリーンショットを並べれば、それだけでこの疑問は生まれます。
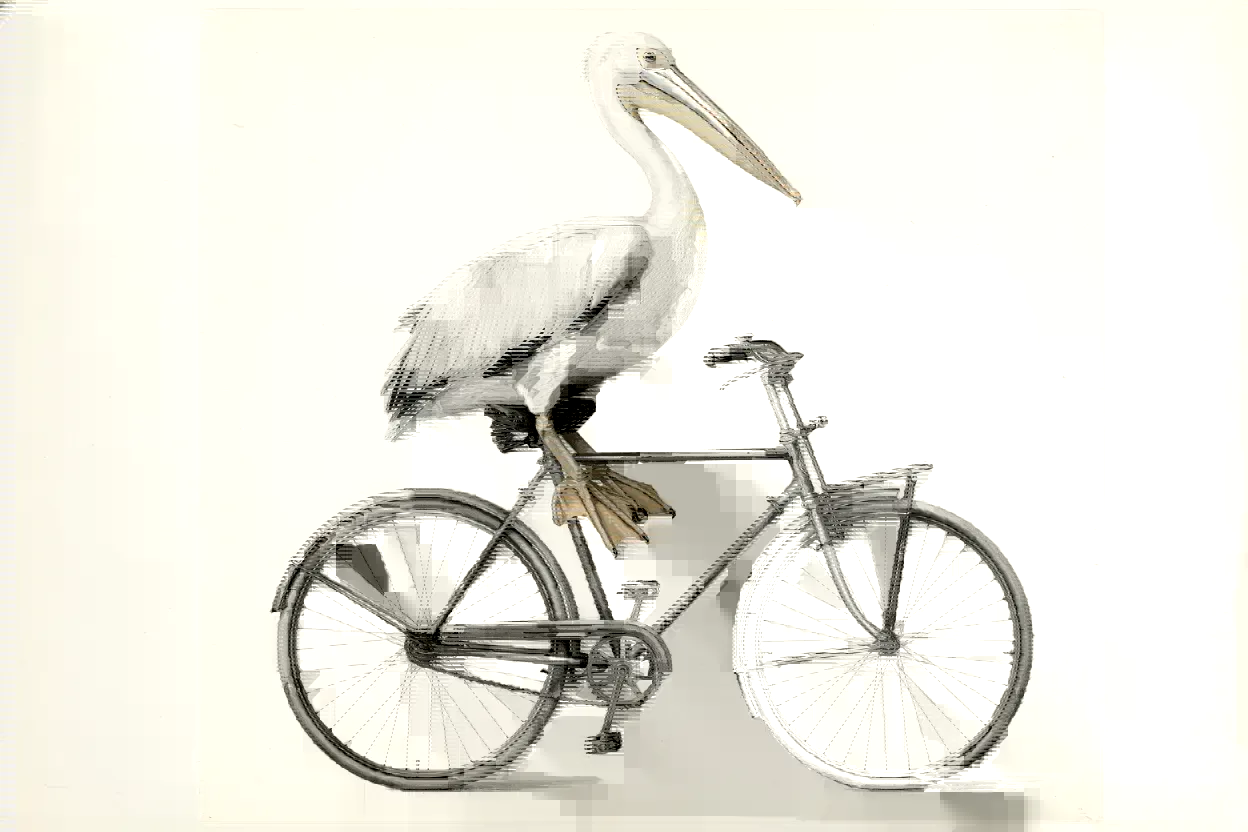
この疑いは、「モデルにはランダム性があるから」の一言で片付けるべきではありません。お金を払っていて、以前はこなせていたタスクが今はうまくいかないのなら、問いただすのは当然です。とはいえ逆に、スクリーンショット 2 枚だけでは、モデルがすり替えられた、思考の予算が削られた、あるいは特定のチャネルが「水増し」された、とまでは言えません。
少し前、私はペリカンテストを何十回も繰り返し走らせました。このテストが面白いのは、多くの間違いがそのまま絵として描き出される点です。コードが動いても、自転車の構造が正しいとは限りません。鳥と自転車がそろって描かれていても、足が本当にペダルを踏んでいるとは限りません。一見なめらかでも論理の穴が潜んでいるかもしれない文章の回答に比べれば、こうした空間的な関係は目で見て気づきやすいのです。ただ、走らせる回数が増えるほど、別のことにも気づきました。私たちはしばしば、1 つの作品で、サービス全体を評価しているのです。
この記事は、どのモデルを擁護するためのものでもなく、いくつかの表面的な特徴から「偽モデル」を見抜く方法を教えるものでもありません。私が関心を持っているのは、もっと絞った問いです。モデルが悪くなったと疑ったとき、その感覚をどうすれば第三者が検証し直せる証拠に変えられるのか、ということです。
注:以下に登場するサービス A・B と、それに付随するテストの数値はすべて説明用の例です。実在のサービスを指すものではなく、Folkbench の実測結果やランキングでもありません。
1. まず切り分ける:「賢さが落ちた」とは、具体的に何のことか?
「賢さが落ちた」は便利な言葉ですが、いくつもの異なる問題を 1 つにまとめてしまいます。最も直接的な層は、今回の回答が確かに間違っていたということです。ペリカンの脚が 1 本多い、足がペダルを踏めていない、車輪とフレームが離れてしまっている。どれも具体的で、確認できる失敗です。サンプルが 1 つあれば「この種の間違いが起きた」ことは証明できますし、「この種の間違いは絶対にしない」という約束を覆すこともできます。2 つ目の層は、同じ、あるいは十分に近い条件のもとで、このサービスが以前より失敗しやすくなったということです。
これはもう、間違いが存在するかどうかの問題ではありません。どれくらいの頻度で現れるかの問題です。以前はたいていできていたのに、今はたいていうまくいかない。私たちがふだん「体験が悪くなった」と言うとき、いちばん測る価値があるのはこの部分です。3 つ目の層は、変化の原因が、モデルそのもの、あるいはサーバー側の設定の何らかの変更にあるということです。これはすでに原因についての主張です。同じ悪い結果でも、説明はいくつも考えられます。リクエストのパラメータが違う、コンテキストが違う、出力が途中で切れた、あるいは基盤モデルや推論設定が本当に変わった。結果だけを見ても、ふつうはこれらの説明を 1 つに絞り込めません。
ですから、「今回は間違っていた」「このサービスは信頼性が落ちた」「このサービスはこっそりモデルをすり替えた」では、必要な証拠の強さが違います。この違いを認めることは、ユーザーが苦情を言うハードルを上げることではありません。むしろ逆です。問題をはっきり位置づけてこそ、サービス提供側があらゆる障害を「ランダム性」で説明することも、評価する側があらゆる差を「モデルのすり替え」で説明することも防げるのです。
2. 見ているのは 1 つの作品か、それとも出力の分布か?
ランダムサンプリングを使う生成設定では、同じ入力から違う出力が生まれ得ます。再現性を高めるための何らかの手段を使ったとしても、「できるだけ一致させる」を「毎回まったく同じ」と読み替えてはいけません。たとえば OpenAI の過去の技術解説には、同じ seed、同じパラメータ、同じバックエンドのフィンガープリントでも、出力が完全に同一になる保証はないと明記されていました。これは再現性に限界があることを示すもので、今日のすべてのモデルが同じパラメータに対応しているという意味ではありません。1
ペリカンテストで本当に知りたいのは、多くの場合「たまに良い絵を 1 枚描けるか」ではなく、「指定した条件のもとで、もう一度タスクを渡したら、合格の結果が得られる見込みはどれくらいか」です。単一のスクリーンショットの問題は、簡単な例で見えてきます。あるサービスの真の 1 回あたりの合格率が 80% で、各回の生成は互いに独立し、テスト中に状態が変わらないとします。このとき、20 回続けてテストして少なくとも 1 回失敗する確率は次のとおりです。 1 − 0.8²⁰ ≈ 98.85% つまり、たいていはきちんとこなせるサービスでも、20 回のテストのどこかで、スクリーンショットに撮れる失敗を残すことはほぼ避けられません。
逆に、別のサービスの真の 1 回あたりの合格率が 40% しかないとします。同じく独立で安定しているという前提で 20 回走らせると、少なくとも 1 回合格の結果が得られる確率は次のとおりです。 1 − 0.6²⁰ ≈ 99.996% こちらも、人に見せられる作品を 1 枚はほぼ確実に出してきます。この 2 つの計算は、現実の呼び出しがすべて独立だと言っているわけでも、現実の合格率がちょうどこの数字だと言っているわけでもありません。示しているのは、選び方の問題です。いちばん良い 1 回だけを見せれば信頼性は過大評価されやすく、いちばん悪い 1 回だけを見せれば劣化の程度は誇張されやすいのです。
ですから、同じサービスが「フル性能の動かぬ証拠」の投稿と「賢さが落ちた動かぬ証拠」の投稿の両方に登場することは十分にあり得ます。スクリーンショットはどちらも本物でも、そこからの推論が成り立つとは限りません。もう 1 つ、見落とされやすい違いがあります。1 回の生成で成功することと、10 回生成して成功した 1 回を選ぶことは、同じ能力の指標ではありません。後者には、追加の呼び出し、待ち時間、選別のコストが含まれています。2 つのワークフローを比べるなら、両者に同じ試行予算を与えるべきです。A の 1 回目と B の厳選集を比べてはいけません。
3. 20 回走らせれば、差は自動的に統計的な意味を持つのか?
いいえ。20 回は妥当な試験予算にはなり得ますが、統計的なお墨付きではありません。同じ具体例で見てみましょう。チャネル A は 20 回中 16 回合格、チャネル B は 20 回中 8 回合格でした。どちらも同じ固定の問題と同じ採点基準を使い、サンプルはすべて残しています。
| チャネル | 合格回数 / 総回数 | サンプル合格率 | 合格率の 95% Wilson 信頼区間 |
|---|---|---|---|
| A | 16 / 20 | 80% | 58.4%~91.9% |
| B | 8 / 20 | 40% | 21.9%~61.3% |
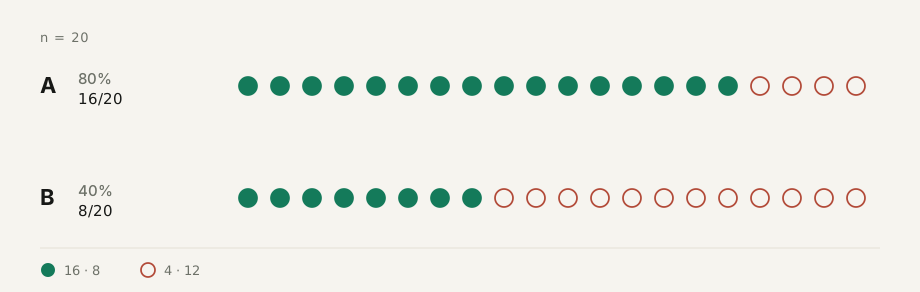
区間は、二項比率の両側 95% Wilson 区間で計算しています。合格率の推定の不確かさを表すもので、絵の出来を表すスコアの範囲ではありません。2 まず確実に言えるのは、サンプル上の差が 40 パーセントポイントだということです。一方で、どちらも 20 回しかないので、推定はまだ粗いことも見ておく必要があります。80% と 40% を、正確に測り終えた、今後も変わらない真の能力として扱ってはいけません。
さらに、各回の呼び出しが独立で、各チャネルの合格確率が観測期間内で安定しており、これが事前に決めた 1 回限りの比較だと仮定します。上の「合格/不合格」の回数に両側 Fisher の正確検定を行うと、p ≈ 0.0225 が得られます。事前に採用した 5% の有意水準に照らせば、この例は「この条件のもとで両者の合格率には差がある」ことを支持します。3 しかしこの数字は、「B が水増しされている確率が 97.75%」という意味でも、「A が永遠に優れている確率が 97.75%」という意味でもありません。p 値が表すのは、差がないという仮説とその検定の条件のもとで、これほど極端な、あるいはもっと極端なデータが得られる確率です。背後にある何らかの原因の確率ではありません。3
また、上の表の 2 つの区間が重なっているかどうかを見て、差の検定の代わりにしてはいけません。各区間はそれぞれ 1 つの合格率を推定するもので、検定の対象は両者の差だからです。1 つの検定方法を覚えることより大事なのは、3 つの境界を押さえておくことです。差の大きさとサンプル数は一緒に見る。 16 対 8 と 16 対 15 から、同じ強さの結論を導くべきではありません。必要なサンプル数は、どれだけ小さな差を見分けたいか、そして誤判定のリスクをどこまで許容するかによって決まります。あらゆるタスクに通用する「最低何回走らせればよい」という数はありません。
有意差が検出されなかったことは、両者が同じだという証明にはなりません。 データが少なすぎたり不安定すぎたりして、まだ結論を出せないだけかもしれません。差が無視できるほど小さいことを示したいなら、「どこまで小さければ無視できるか」を事前に定義する必要があります。有意でない結果を、同等性の証明として扱ってはいけません。統計的な差があることは、それだけでサービスを乗り換える理由にはなりません。 ユーザーにとっては、失敗の代償、呼び出しの料金、レイテンシ、やり直しのコストも考える必要があります。確かな差であっても、選択に影響しないほど小さいことはあります。ここでの統計の役割は、専門的に見える p 値を生み出すことではなく、証拠が支えられる以上のことを主張しないよう、私たちを止めることです。
4. ベースラインは「プロンプトが同じ」の一言ではなく、実験の契約である
比較テストの多くは、サンプル数が問題になる前につまずいています。サンプルが最初から比較可能になっていないのです。同じ「自転車に乗るペリカンを描いて」という入力でも、一方は新しいセッションで API を呼び出し、もう一方はすでに何十往復も会話してツールまで有効になったチャットウィンドウで生成している。一方は長い出力を許されているのに、もう一方は途中で長さの上限に達してしまう。こうした結果は、100 回繰り返しても、そのままモデルの能力差に帰することはできません。
OLMES という評価標準の研究は、プロンプトの形式、コンテキスト内の例、タスクの言い回しといった評価上の選択が、測定される性能を変えることを指摘しています。再現可能な比較には、こうした設定を明確に記録しておく必要があります。この研究が扱う具体的なタスクはペリカンの SVG と同じではありませんが、実験の設定に関する注意は同じように参考になります。4 私の提案は、ベースラインを「今回はいったい何を測っているのか」についての契約として捉えることです。
比較対象は、サービス、グループまたはルーティング、そして入手できるモデルのバージョンまで具体的に特定します。時間とともに変わり得るモデルのエイリアスしかなければ、エイリアスを記録します。基盤となるスナップショットがわからなければ、「不明」と書きます。API が返すモデル名の文字列を、基盤の正体が独立に検証された証拠として扱ってはいけません。入力はできるだけ完全に保存します。最後のプロンプトだけでなく、自分で制御・観察できるシステムプロンプト、会話履歴、添付ファイル、ツールの設定も含めます。目に見える条件がそろっていても、見えない条件までそろっていることが証明されたわけではありません。
生成設定については、思考の強度、出力の上限、そして API が実際に対応しているサンプリングパラメータを記録します。対応していない項目には「非対応」、反映されたか確認できない項目には「不明」と書き、黙ってそろっているものとして扱わないでください。異なるモデルで同じ「high」という名前の設定が、同じ計算予算を意味すると決めつけるべきでもありません。
評価環境には、レンダリングの方法と採点基準が含まれます。同じ SVG は、同じビューポートとレンダリング環境で確認します。アニメーションの問題なら、取り決めた観察時間に沿って確認し、一方では動き全体を見て、もう一方では 1 フレームだけを選ぶ、といったことをしてはいけません。問題がアニメーションを求めていないなら、出力が静止画だからといって減点すべきでもありません。最後に、リトライのルールはテストの前に書いておく必要があります。最初の失敗のあとにリトライしてよいか、何回までか、フィードバックを与えるかは、いずれもテスト条件の一部であり、その場の思いつきで決めるものではありません。
こうした条件を固定するのは、現実から切り離された「実験室のモデル」を作るためではありません。2 つのチャット製品の既定の体験を比べることも、十分にできます。ただしその場合の結論は、「2 つの製品は、既定の設定で提供するものに差がある」であって、「基盤モデルの重みの優劣を切り分けた」ではありません。制御できない条件は、不明のままにしておいてかまいません。しかし不明なものを、制御済みと書いてはいけません。
5. テストの段取りは、単に回数を増やすことより大事なことが多い
チャネルと時間帯を結びつけない
午前中に A をまとめて走らせ、深夜に B をまとめて走らせると、「チャネルの差」と「時間の差」が混ざってしまいます。たとえ差が観察されても、それがどこまでその時間帯に依存しているのか判断しにくくなります。軽めの横並び比較なら、私は事前に決めた時間枠の中で A と B に交互にリクエストを送り、順序もランダムにします。同時実行数もできるだけそろえ、一方は 1 件ずつ生成し、もう一方はまとまったバーストを受ける、という状況は避けます。
さらに、時間枠をいくつかの小さなバッチに分け、各バッチに A と B の両方を含めることもできます。そうすれば全体の結果に加えて、差が特定のバッチだけに集中していないかも確認できます。ランダムな順序は時間による交絡を減らすのに役立ちますが、共有されたバックエンドや短時間の障害などがもたらし得る相関を、自動的に取り除いてくれるわけではありません。
縦断的な問い、つまり「先週より悪くなったか」は事情が違います。時間そのものが研究対象の変数なので、両者を同じ時刻に固定することはできません。この場合は、核となる問題、設定、採点基準をできるだけ同じに保ち、観察期間ごとに参照サービスも一緒に走らせ直すべきです。今日の結果を、先週いちばん良かった 1 枚といつまでも比べ続けてはいけません。縦断的な結果を見るときは、絶対的な合格率と相対的な差の両方を残しておきます。テスト対象のサービスと参照サービスがそろって下がった場合、相対的な差は変わらないかもしれませんが、それはユーザー体験が悪化していないことを意味しません。参照も、永遠に正しく、永遠に安定した真の値ではありません。
結果を見ながら、いつやめるかを決めない
「まず 5 回走らせて、A が勝ったら投稿する。勝たなければ、有意差が出るまで続ける」。この方法はサンプルを増やしているように見えますが、実際には統計のルールそのものを変えています。通常の固定サンプルの検定でデータを何度も覗き見し、結果に応じてやめどきを決めると、本来の誤検出の制御が壊れてしまいます。継続的に観察する必要のあるテストには、専用の逐次的な手法を使うべきです。5 一般の人が逐次統計学から始める必要はありません。最も実行しやすいのは、今回何回走らせるか、どの主要指標を使うか、どの主要な比較を行うかを事前に書いておき、すべての結果を残すことです。
API や採点の流れに問題がないか、先に何回か試して確認するのはもちろんかまいません。ただしそれは試運転です。手順の修正が終わってから、改めて本番のテストを始めてください。問題を調整していた段階の結果と、本番の結果を混ぜてはいけません。同じことは、別の 2 つの習慣にも当てはまります。何十もの問題を一気に試して、最も有利な 1 問だけを公表すること。あるいは合計点で優位に立てないとわかると、特定の小項目に切り替えて勝利を宣言すること。どちらも、事前に取り決めた同じ比較ではありません。
同じ問題を 100 回走らせたことを、100 問解いたことと見なさない
生成を繰り返せば「この問題でどれだけ信頼できるか」はわかりますが、結論の適用範囲が自動的に広がるわけではありません。ペリカンをどれだけ安定して描けても、コードのデバッグ、長文の分析、複雑な指示への追従が同じように信頼できることを直接示すわけではありません。あるタスクの種類について推論するとき、問題ごとの違いと、同じ問題を何度も生成したときのばらつきは、2 種類の異なる不確かさです。関連する評価研究では、繰り返しのサンプリング、問題単位での比較、そしてクラスター化した相関のあるサンプルの扱いをはっきり区別しています。6
ですから私は、まず 1 つのプローブで再現性を観察し、そのうえで実際の用途に関係する固定のタスクを少数加えます。両者に同じ問題セットに答えさせ、まず問題ごとの成績と問題ごとの差を計算してから集計します。合計点だけを出して終わりにはしません。複数の問題の結果に正式な統計分析を行うなら、同じ問題・同じバッチという対応関係を保っておく必要があります。「10 問を各 10 回」を「互いに独立した 100 問」として扱い、先ほどの単一問題の例の計算をそのまま当てはめることはできません。
もう 1 つ、小さな落とし穴があります。固定の seed は再現の問題を調べるのには向いていますが、同じ seed でほとんど変わらない出力を 20 回コピーしても、ランダムな出力分布を 20 回独立に観察したことにはなりません。安定性を測るときは、サンプリングの方針を事前に取り決めておきます。seed に対応している API なら事前に生成した複数の seed を使い、対応していないならその制約を記録します。問題セットを長期的にどう更新するかは、別途掘り下げるべき問題です。少なくとも今回の比較の中では、問題を差し替えながら、新旧のスコアをつないで「モデルの進歩曲線」を描くことはしないでください。
6. タイムアウト、途中切断、描き間違いを一緒くたにしない
よくある統計の歪みに、「正常に返ってきた作品」だけを採点し、タイムアウトやエラーになったリクエストを削除してしまうというものがあります。そうして得たスコアが答えているのは、「完全な出力を受け取れたあとで、それが合格する見込みはどれくらいか」です。ユーザーがより気にする「リクエストを 1 回送ったら、合格の結果を受け取れるか」ではありません。事前に 20 回のリクエストを予定し、そのうち 4 回がタイムアウトしたとします。残りの 16 回は完全な作品を返し、うち 8 回が合格でした。この場合、完全な作品の中での合格率は 50% ですが、20 回のリクエスト全体で数えた、初回のリクエストで合格の結果が得られた割合は 40% にすぎません。前者だけを公表すると、何も届かなかった 4 回の体験が抜け落ちてしまいます。
そこで私は、3 種類の結果を同時に残すようにしています。技術的な理由で結果を届けられなかったもの、完全に返ってきたがタスクとしては不合格のもの、完全に返ってきてタスクとしても合格のものです。タイムアウト、API のエラー、ストリームの途中切断、長さの上限への到達といった問題は、それぞれ原因を分けて記録します。ただし、分けて記録することは、サービスの障害を免責することではありません。サービスを選ぶ人にとっては、タイムアウトも描き間違いも同じように時間を奪います。ただ、原因を突き止める段階では、それらをすべて「モデルの知能が落ちた」と表現すべきではない、ということです。ローカルのネットワークやテストスクリプトの障害も別枠にし、除外するかどうかは事前に定めたルールに従うべきです。どちらが負けたかを見てから、その場でサンプルを削除してはいけません。
ここで私は、初回のリクエストで合格の結果が得られた割合を主要指標とし、完全な出力の中での内容の合格率、技術的な失敗率、所要時間、コストを補助的な説明として並べるほうを選びます。完全な出力の中での内容の合格率も、偏りのない「純粋な能力スコア」ではありません。複雑なリクエストほどタイムアウトしやすいなら、残った作品はもともと簡単なものだった可能性があります。この合格率は問題の切り分けには役立ちますが、リクエスト全体で数えた結果の代わりにはなりません。
「1 回修正すれば成功するか」は別のテストとして立て、両者に同じ修正の機会を与えればよいでしょう。一方には根気よく 5 回も修正に付き合い、もう一方は 1 回間違えただけで不合格にする、ということはしないでください。
7. 一般の人でも実行できる最小限の比較実験
ペリカン 1 羽をテストするために、まず評価プラットフォームを作る必要はありません。以下は出発点となる案です。ある固定のプローブではっきりした差を調べるのに向いたもので、小さな劣化を確実に検出するためのサンプル数の設計ではありません。
| 項目 | 今回の取り決め |
|---|---|
| 問い | この固定の問題で、サービス A と B の「初回のリクエストで合格の結果が得られた割合」に差はあるか? |
| 入力と設定 | 見えるリクエストをすべて保存する。制御できるパラメータはそろえる。確認できない違いは記録する。 |
| サンプル | 各サービスに本番のリクエストを 20 回ずつ事前に予定する。試運転は本番のサンプルに混ぜない。 |
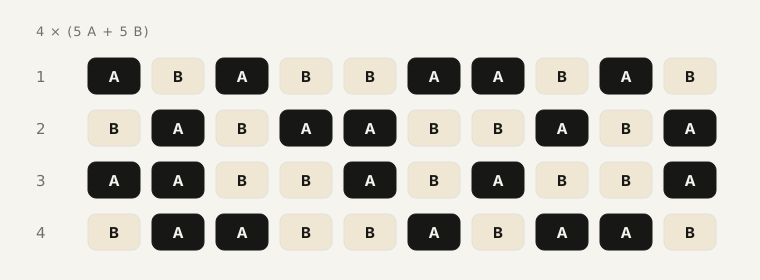
| 時間と順序 | 事前に決めた時間枠を 4 バッチに分け、各バッチで A・B を 5 回ずつ実行する。バッチ内ではランダムに交互に並べ、同時実行のルールをそろえる。 |
| リトライ | 本番の初回回答テストではリトライを追加しない。修正能力を評価したい場合は別の実験にする。 |
| 採点 | 走らせる前に合格基準を決める。レンダリング後、チャネル名を隠して順序をシャッフルしてから採点する。 |
| 出力 | すべての生の結果、各回のステータス、採点の根拠、バッチごとと全体の統計を保存する。 |
ペリカンの問題の合格基準は、まずは素朴なもので十分です。取り決めた環境でファイルが正常にレンダリングされるか。主体と自転車が見分けられる程度にそろっているか。重要な構造に明らかな誤りはないか。足とペダルなど、問題が求める接触関係が成り立っているか。見た目の美しさは別に記録してかまいませんが、洗練された配色で構造上の誤りを帳消しにしてはいけません。
境界線上のサンプルで判断に迷う場合は、まず「判断保留」として印を付け、事前に決めた再確認のルールに従って処理します。チャネル名を見てから、通すかどうかを決めてはいけません。小規模なテストなら、まず人手によるブラインド採点で十分です。規模が大きくなってから、自動採点や判定者のキャリブレーションを検討すればよく、それは次の段階の問題です。最初のラウンドですべてを解決する必要はありません。記録するときは、「ラウンドごとに 1 つ」の設定と、「呼び出しごとに 1 行」のログを分けておくと、ずっと楽になります。ラウンドごとの設定には、元のリクエストのテンプレート、パラメータ、問題のバージョン、採点ルールのバージョン、時間枠、タイムアウトとリトライの取り決めを保存します。呼び出しごとには、少なくとも次の項目を記録します。
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_path時刻はタイムゾーン付きの形式で記録します。生のレスポンス、抽出した SVG、レンダリングした画像は artifact_path でひも付けます。API が返すトークン使用量やバックエンドのフィンガープリントなども併せて保存してよく、提供されていなければ空欄または不明とします。request_hash はリクエストが一致しているかを確かめるためのもので、元のリクエストそのものの代わりにはなりません。ログを保存・共有するときは API キーを取り除き、個人的なコンテキストやその他の機微な内容はマスキングしてください。公開検証に必要なのは実験の条件であって、アカウントの認証情報まで差し出すことではありません。
集計するときは、まず全体の差とバッチごとの結果を見ます。前述の二項区間と Fisher の正確検定が当てはまるのは、独立性や安定性といった前提がおおむね成り立つ場合だけです。結果が明らかにバッチの影響を受けている場合や、のちに複数の問題を繰り返すテストに広げる場合は、対応のある設計に合った分析を行うべきで、単一問題の公式を機械的に使い回してはいけません。最初の差が追いかける価値のあるものなら、新たに事前に決めた時間枠で再テストし、実際の用途に関係するタスクも加えます。最初のラウンドのデータは、異常の手がかりにすぎません。独立した新しいラウンドでの検証があってはじめて、それが続いているのかを判断する助けになります。
8. 差が見つかったあと、結論はどう書くべきか?
先ほどの説明用の数字を例にすると、抑制的でありながら役に立つ結論は、次のように書けます。
今回の固定の問題、同一の見える設定、事前に決めた時間枠のもとで、A と B をそれぞれ 20 回テストしたところ、初回のリクエストで合格の結果が得られたのは 16 回と 8 回で、サンプル合格率の差は 40 パーセントポイントでした。独立なサンプリングなどの前提のもとで、両側 Fisher の正確検定の p 値は約 0.0225 であり、今回の条件のもとで差があることを支持します。この結果は、ほかの時間枠や関連するタスクでの検証がまだ必要であり、これだけでは基盤モデルやサーバー側の設定の変化の具体的な原因を特定することはできません。
「フル性能の動かぬ証拠」ほどの刺激はありませんが、他の人が検証し直すのに必要な主要条件は示しています。時間帯をまたぎ、関連するタスクをまたいだその後のテストでも同じ方向の結果が得られ続けるなら、より十分な根拠をもってこう言えます。このサービスはこれらの用途において参照より信頼性が低い、あるいは過去のベースラインと比べて本当に後退している、と。それでも、「結果の質が落ちた」から「こっそり小さなモデルにすり替えた」へと飛ぶのは、まだ一歩余計です。具体的な仕組みを確かめるには、検証可能なルーティングや設定の記録など、異なる説明を見分けられる独立した証拠が必要です。出力の文体だけでモデル名を当てることはできません。
とはいえ、ユーザーは原因が判明するまでサービスを乗り換えてはいけない、という意味でもありません。サービスを選ぶのに必要なのは、それが自分の要件を満たしているかどうかです。特定の原因を指摘するのに必要なのは、その原因についての証拠です。 この 2 つは切り離して考えられます。
9. 本当に節約すべきなのは、「問題をはっきり証明する」ためのコスト
手作業のテストでいちばん骨が折れるのは、たいてい実行ボタンを押すことではなく、そのあとの繰り返し作業です。ファイルはどこに保存したか、パラメータは変わっていないか、この画像は何回目の生成か、リトライしたものか、スクリーンショットと生のレスポンスをまだ対応づけられるか。こうした記録がなければ、そのときはどれほど確信していた「本当に賢さが落ちた」も、1 週間後には検証しようのないスクリーンショットが数枚残るだけかもしれません。
異なるサービスの成績をまず把握したいだけなら、誰もがゼロから整理し直す必要はありません。まず Folkbench で公開ランキングとレポートへの入り口を確認し、関心のあるモデル、サービスのグループ、指標について、すでに結果があるかを確かめるとよいでしょう。その公開ページは、同じモデルのもとで異なるサービスを比較することを強調しており、ランキングにも、ある行のグループのデータがその中継サービスの全グループの成績を表すわけではない、という注記があります。7
ただし、既存のランキングの意義は、情報を集めて整理するコストを減らすことにあり、条件の確認を放棄させることではありません。Folkbench を含め、どのランキングについても問い続ける価値があります。いつ測ったのか、何を測ったのか、サンプルはどれだけあるのか、失敗は残されているのか、結論はどの範囲に当てはまるのか。公開されていない情報は、依然として不明です。最初の問いに戻りましょう。「モデルの賢さが落ちた」のうち、どれだけが本当で、どれだけが 1 回のサンプリングによる錯覚なのでしょうか。
共通の定義、完全なサンプル、比較可能な条件がそろう前に全体の割合を 1 つ示しても、新たな迷信を生むだけです。私たちにもっとできるのは、具体的な疑いの一つひとつを、段階を追って検証可能な判断に変えていくことです。失敗を見たら、まず生の結果を残す。劣化を疑ったら、比較を始める。差が見つかったら、そこで原因を追う。これらのステップを、1 枚のスクリーンショットの中で一度に済ませてしまわないでください。1 枚のスクリーンショットは、良い問いを投げかけることができます。それに答えるには、きちんとした実験が必要です。
注釈と参考資料
- OpenAI、How to make your completions outputs consistent with the new seed parameter、過去の Cookbook のサンプルで、ページはアーカイブ済みと表示されています。この解説は固定 seed を、決定性の保証ではなく、決定性に近づけるためのベストエフォートとして説明しています。本記事はその再現性の限界だけを引用しており、そこに出てくる旧モデル名やパラメータの対応範囲を現在の製品説明として扱うものではありません。原文↩
- NIST/SEMATECH、e-Handbook of Statistical Methods、7.2.4.1 節 Confidence intervals の Wilson 比率区間。本記事では 16/20 と 8/20 に両側 95% Wilson 区間を用いています。結果は筆者が公式に基づいて計算し、パーセントで小数第 1 位に四捨五入したものです。ここでの信頼水準は、区間を構成する方法の長期的な被覆率の性質を表します。Wilson 法は近似法です。原文↩
- SciPy 公式ドキュメント、
scipy.stats.fisher_exact。本記事では分割表[[16, 4], [8, 12]]にalternative="two-sided"を指定して計算し、p = 0.0224774273717544を得ました。これは例示データでの計算結果であり、論文やプラットフォームのレポートにある実測結果ではありません。この例は独立した二項結果の比較を対象としています。対応のあるデータ、複数問題にわたるクラスター、時間的な相関、多重比較がある場合は、その設計に合った方法で扱う必要があります。原文↩ - Yuling Gu ほか、OLMES: A Standard for Language Model Evaluations、Findings of NAACL 2025。プロンプトの形式、コンテキスト内の例の選び方、タスクの言い回しといった評価の細部と、再現可能な比較に必要なことを論じています。原文↩
- Ramesh Johari、Leo Pekelis、David J. Walsh、Always Valid Inference: Bringing Sequential Analysis to A/B Testing、arXiv:1512.04922、2019 年改訂版。結果を継続的に見ながらそれによってサンプル数を決めることの問題と、それに対応する逐次推論の手法を論じています。原文↩
- Evan Miller、Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations、2024 年。問題単位の不確かさ、繰り返しサンプリング、対応のある比較、クラスター化したサンプルについては第 2・3・4 節を、サンプル数の計画については第 5 節を参照してください。原文↩
- Folkbench の公開トップページとランキングページ、閲覧日:2026 年 10 月 5 日。本記事は公開ページに基づいて、その入り口、比較の範囲、グループに関する注記を説明しているだけです。個別のランキングの数値を独自に保証するものではなく、本記事で提案した実験手順のすべてを Folkbench がすでに実装しているという意味でもありません。トップページ、ランキング↩