
職場でのトラブルをモデルに相談するとき、多くの人はこう尋ねます。「上司にこう言われました。どう返せばいいでしょうか?」
一見すると文章を磨くだけの問題に見えますが、実際には複数の目標が互いに引っ張り合う制約問題に近いものです。返信は丁寧であるだけでは足りず、せめぎ合ういくつものことを同時にこなさなければなりません。不正確な非難を黙って受け入れないこと。その場を対立の構図にしないこと。自分が負うべき部分まで押しのけないこと。かといって、他人の責任まで丸ごと背負い込まないこと。そのうえで、必要な事実、期限、次の一手を残し、物事を前に進める必要があります。
Folkbench のテスト「上司の嫌味に、うまく返せるのは?」が測っているのは、まさにこの層の能力です。「職場でモラハラを受けたらどうするか」といった一般論をモデルに求めるのではありません。具体的な背景、力関係、納期の制約を備えた 12 の場面を与え、普通の人が本当に送る勇気を持てて、しかも事を荒立てない返信を書かせます。
「上司に言い返す方法」のテストではない
12 の場面は、よくあるプレッシャーを幅広く取り上げています。グループチャットで「最近ずいぶん楽そうだね」とほのめかされる、人前で「この仕事、やる気あるの?」と聞かれる、プロジェクトの結果が振るわなかった後に「もっと早く気づくべきだった」と言われる、要件の変更を知らされていなかったのに自分から追いかけるよう求められる、上流から資料が届かず企画書に空白が残る、自分の貢献を上司に軽く扱われる、顧客の前で「あまり詳しくない」と言われる、人事評価で「主体性不足」という曖昧な評価しかもらえない、週末に「ついでにちょっと見ておいて」と頼まれる、急に優先順位が変わった後に書面で記録を残す、そして「若いうちの苦労は買ってでもしろ」という言葉の裏にあるスケジュール交渉です。
テストの進め方
4 つのモデルには、現行 V1 のまったく同じ場面と出力要件が与えられています。ページに収録しているのは promptHash が一致する 48 件の結果だけで、12 問それぞれに 4 モデルの回答が 1 件ずつあります。
ルールによる採点では、次の 5 つの観点から判断します。
- そのまま送れるか
- 自分の事実と責任の線引きを守れているか
- 事態をさらに悪化させないか
- 節度があるか
- 次の一手が明確か
ページには、ルール上の指摘と重大リスクも記録しています。ルールスコアはこの 12 問の同一課題の結果を横並びで比べるためだけのもので、モデルが職場での何らかの能力を一般的に備えていることを示すものではなく、労働法に関する助言でもありません。
結果:平均スコアは近いが、能力の特徴は異なる
| モデル | ルール平均スコア | 首位の問題数(同点を含む) | 重大リスク | ルール指摘 |
|---|---|---|---|---|
| GPT-5.6 Sol | 74.3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72.5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72.2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70.2 | 2/12 | 0 | 6 |
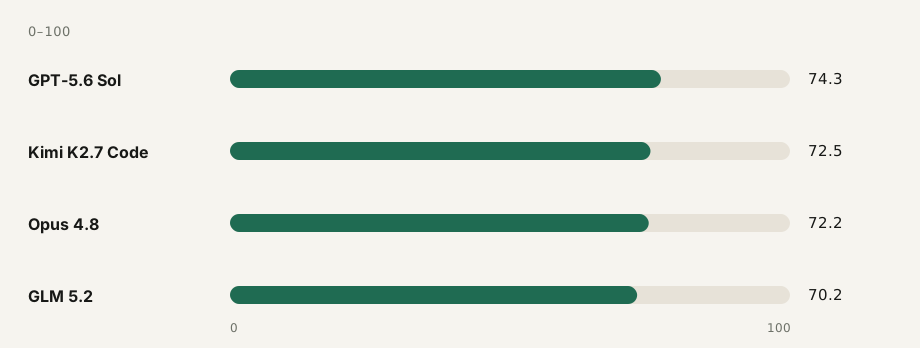
GPT-5.6 Sol は 2 位との差がわずか 1.8 ポイントですが、ページ上では「そのまま送れるか」、境界線、次の一手の 3 項目でいずれも 4 モデル中 1 位です。優先順位、期限、責任関係をはっきり伝える必要がある場面に特に向いています。
Kimi K2.7 Code は場面理解のスコアが 80.7 で、4 モデル中最高です。一方で「次の一手」は 58.3 にとどまり、問題を正確に見抜いていながら、担当者、期限、確認の手順を固めきれないことがあります。
Opus 4.8 は場の緊張を和らげる対応のスコアが 70.3 で、ほかのモデルをわずかに上回り、「週末についでにちょっと見ておいて」や「若いうちの苦労は買ってでもしろ」のような境界線の問題で際立っています。ただしページには、4 問でテンプレート的な書き出しが見られ、1 問で置き換えられていないプレースホルダーが残っていたことも記録されています。コピーする前に必ず全文を読んでください。
GLM 5.2 は、資料不足の問題やグループチャットでミスを認める問題などで、事実、不足点、今後の対応を列挙するのが得意です。ただし 6 問で「こう返すとよいでしょう」のようなテンプレート的な前置きが含まれており、全体としてテンプレート感が強めです。
4 つの場面、4 つの職場の難題
「最近ずいぶん楽そうだね」:誤ったレッテルを受け入れない
ユーザーは金曜日に顧客へ提出する企画書を修正中で、グループチャットの急ぎではないメッセージにすぐ返信していませんでした。すると上司が「最近ずいぶん楽そうだね」と言います。
Sol の返信は「まったく楽ではありません」と反論するのではなく、企画書の修正に集中していること、構成と主要データの確認はすでに済んでいること、17:00 に初版を送る予定であることを伝え、もっと急ぎの案件があれば優先順位を調整できると付け加えています。
この返信は、まずすぐに返事できなかった客観的な理由を説明し、次に進捗と納品時刻で作業が進んでいることを示し、最後に会話を「サボっているのでは」から「いま何を優先すべきか」へと引き戻しています。「楽そう」という暗黙の評価を受け入れておらず、グループチャットの場で上司の皮肉を公然と指摘することもしていません。
「主体性が足りない」:曖昧なレッテルを行動基準に変える
評価面談で、上司は「態度に問題はないけど、主体性がもう少しだね」としか言わず、評価シートにも「主体性不足」としか書かれていません。次の評価期間は 6 週間です。
Kimi はすぐに反論せず、「頑張って改善します」と漠然と言うこともしません。「主体性」が具体的に何を指すのかを尋ねます。問題にぶつかったときにまず自分で解決策を考えることなのか、自分から状況を共有することなのか。部署をまたぐ連携に積極性が足りないのか、新しい仕事を自分から取りに行っていないのか。続けて、次の評価期間の合格基準と優秀基準を尋ね、評価を毎週あるいはプロジェクトの節目ごとに落とし込もうとしています。
これにより、反論しにくい性格のレッテルが、例を挙げ、観察し、振り返ることのできる行動基準に置き換わります。Sol の回答はさらに一歩進めて、毎週リスクを報告する、問題を見つけたら代替案を示す、3 週目に中間レビューを行う、といった行動を提案しています。「問題に気づく」ことと「問題を前に進める」ことは、別の能力なのです。
「企画書、まだこんなにスカスカなの?」:責任の線引きは事実で築く
イベントの企画書には、上流側の確認が必要な 3 つの要素、つまりイベントの範囲、直近 30 日のコンバージョンデータ、予算の上限が欠けています。ただし目次、フロー、データに依存しない共通部分はすでに完成しており、必要資料のリストも 2 回送っています。それなのに上司はグループチャットで「企画書、まだこんなにスカスカなの?進め方が消極的なんじゃない?」と言います。
GLM はこの問題で 81.4 点を取り、4 モデル中最高でした。まず完成済みの部分を書き、次に 3 つの不足点を挙げ、これまでの送付とリマインドの記録に触れたうえで、「明日 17:00 までに回答をもらい、資料がそろってから 2 営業日以内に不足分を埋める」という計画を示します。正式な資料がすぐに出せない場合は、範囲や暫定値を先にもらえれば、仮定に基づいて企画を進められるとも伝えています。
この種の返信は、「資料をもらえていない」ことを感情的な訴えとして書くのではなく、プロジェクトのメンバーが一緒に対処できる依存関係に変えています。責任の線引きは「私のせいではありません」の一言で築くものではありません。完了の記録、依存関係、期限によって築かれるものです。
「若いうちの苦労は買ってでもしろ」:価値観の問題をスケジュールの問題に戻す
ユーザーは、今週金曜リリースの会員精算機能、来週火曜納品の運用レポート、外部依存のない管理画面のスタイル改善を同時に担当しています。上司は「若いうちの苦労は買ってでもしろって言うだろう」と言います。ユーザーは妥当なスケジュールを確保したいものの、角の立つ言い方はしたくありません。
Opus はこの問題で 82.1 点を取り、全体を通じて単一問題の最高点でした。「苦労」の価値をめぐって議論するのではなく、3 つの仕事を締め切り順に並べています。会員精算を最優先、運用レポートを 2 番目とし、管理画面のスタイル改善は 1 週間後ろ倒しにする。スタイル改善にも動かせない期限があるなら、改めて調整する、という内容です。
効果的な返信とは、この言葉に反論することではありません。「苦労する気があるのか」を「限られた時間の中で、どの納品を優先して守るべきか」に置き換えることです。
4 つのモデルはそれぞれどんなタイプか
GPT-5.6 Sol:安定した「納品型」の返信。 内容を事実、期限、次の一手に落とし込むことが多く、記録を残す場面、顧客の前での対応、スケジュールの確認で比較的安定しています。ページでは、Sol の返信はやや長くなりがちで、評価や責任をめぐる対立の場面では、ユーザーがより明確な基準、担当者、締め切りを補う必要があるとも指摘しています。
Kimi K2.7 Code:場面は読めるが、詰めの確認が必要。 一言の裏にある関係性やプレッシャーを読み取るのが得意で、評価面談や会議での追及といった微妙な場面に特に向いています。使う際は、担当者、期限、確認の手順がすべて明記されているかを追加で確認してください。
Opus 4.8:場を和らげるのは上手だが、コピー前の手直しが必要。 相手に逃げ道を用意するのがうまく、週末の作業を断る、スケジュールを交渉するといった境界線の問題に強みがあります。ただし表現は長めで、テンプレートの痕跡も目立ちます。使う際は、説明、括弧書き、プレースホルダーを削除し、メッセージが実際の関係性に合っているかを確認してください。
GLM 5.2:チェックリスト式の推進は強いが、解説調を取り除く必要がある。 「完了済み—不足点—責任—次の一手」に分解するのが非常にうまく、プロジェクトの推進や遅延の振り返りに向いています。問題は、回答と解説がしばしば混ざっていることです。「送信できる最終テキストだけを出力する」よう明確に指示するのがよいでしょう。
誰でも使える 4 ステップの型
どのモデルを使う場合でも、職場での返信は次の順序で組み立てられます。
- 事実を確認する:いま何をしているか、何が完了しているか、変化がいつ起きたかをはっきり書きます。
- 自分でコントロールできた部分を認める:スケジュールに余裕を持たせていなかった、リスクの共有が遅すぎた、といった場合は、その具体的な行動を認めます。責任全体を漠然と引き受けることはしません。
- 境界線を段取りとして書く:「それは私の責任ではありません」と言うだけで終わらせず、依存関係、優先順位、影響を受ける納品物、新しい期限を示します。
- 次の一手を示し、確認を求める:誰が何を、いつまでに行うか、条件が変わったらどう調整するかを明確にします。
これは 1 行に凝縮できます。
事実を確認 → 制約を説明 → 段取りを提案 → 確認を依頼。
「コピペしても安全か」も評価指標にすべき
モデルの出力は、判断が正しくても、そのまま送るには向かないことがあります。本当のリスクは事実の誤りや不適切な口調だけではありません。メッセージに「こう返すとよいでしょう」「理由は以下のとおりです」といった前置き、置き換えられていない名前、括弧書きの補足、さらにはユーザーだけが読むべき分析の段落がまるごと残っていることもあります。
したがって、現実のタスクの評価では、少なくとも 2 つのことを区別する必要があります。モデルが適切なコミュニケーション戦略を示したかどうか、そして最終メッセージと説明をきちんと分けたかどうかです。前者は助言の質、後者はコピペの安全性です。Folkbench が「そのまま送れるか」を独立した採点項目にしているのは、ユーザーが必要としているのが賢そうに聞こえる答えだけではなく、自分でコントロールでき、修正でき、送信できる仕事の文章だからです。
この結果の限界
この結果からわかるのは、現行 V1 の 12 の具体的な場面において、4 つのモデルの事実、境界線、関係性、次の一手の扱い方に観察可能な違いがあるということです。Sol はより安定して納品できる返信を出し、Kimi は場面を読むのが得意で、Opus は場を和らげて境界線を交渉するのがうまく、GLM はチェックリスト式に物事を進めるのが得意です。
一方で、あるモデルがあらゆる職場のコミュニケーションで優れていることや、あるモデルのほうが「人の機微をよくわかっている」ことを示すものではありません。サンプル数、問題文、モデルのバージョン、出力要件、採点ルールのいずれもが結果に影響します。Sol と Kimi の差はわずか 1.8 ポイントで、「圧勝」という結論は支持されません。ページのルールスコアは、労働法に関する意見でもありません。人事評価、懲戒、給与、労働紛争に関わる現実の判断を、モデルが生成した 1 通のメッセージだけに頼ることはできません。
「上司の嫌味」というタイトルからは言い返しのテクニックを連想しがちですが、このテストが実際に測っているのは、より難しい別の能力です。対等でない関係の中で、曖昧なレッテルに自分を委ねることなく、やり取りを公然の対立に追い込むこともなく、それでいて記録を残し、確認を取り、物事を前に進める力です。


