
第 1 回では「スクリーンショット 1 枚を鵜呑みにしない」ことを取り上げました。今回はさらに問いを進めます。なぜスコアでさえ鵜呑みにできないのでしょうか?
自転車に乗ったペリカンが 3 羽いるとします。1 羽目はとても丁寧に描かれています。羽毛には重なりがあり、車輪にはハイライトが入り、背景には夕日まで描かれています。ところがよく見ると、両足ともペダルの上に浮いています。2 羽目は数本の線で描いた簡単なスケッチのようです。影もなければ、きれいな配色もありません。それでもフレームは無理なくつながり、体はサドルに乗り、足は確かにペダルを踏んでいます。3 羽目は静止画で見る限り問題がありません。ところが再生ボタンを押すと、足が勝手な軌道を漂い始めます。ペダルはペダルで回り、ペリカンはペリカンで空を蹴っています。最高点を付けるべきなのは、どれでしょうか?
「1 羽目がいちばんきれい」と答えるなら、採点しているのは美的センスです。「2 羽目がいちばん確実」と答えるなら、採点しているのはタスクを達成できたかどうかです。そしてスクリーンショットしか見なければ、3 羽目の誤りは見つからないままかもしれません。
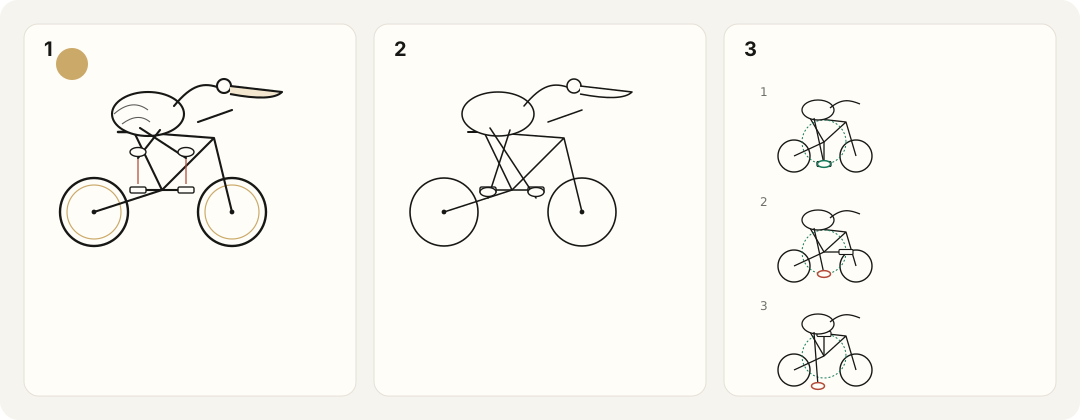
前回の記事では、モデルが本当に劣化したかを判断するには、選び出した 1 回の出力ではなく、比較可能な条件で繰り返しテストする必要があると論じました。ただ、その主張には、まだ決着していない前提が隠れています。何が合格なのかを、私たちはすでに知っているという前提です。この前提が成り立たなければ、繰り返しても結論が自動的に信頼できるものになるわけではありません。偏った物差しで、ますます安定して測るだけになるかもしれません。この記事はそこから始めます。「このペリカンはまあまあに見える」という感想を、根拠があり、再確認でき、段階的に自動化できる評価方法に変えるには、どうすればよいのでしょうか。
注:この記事のサンプル、数値、採点方式、設定はすべて方法を説明するための例です。実在のモデルのランキングを示すものではなく、Folkbench がこれらの手順を実装済みであることも意味しません。引用している研究は関連する方法とリスクを説明するためのもので、この記事の提案が実験で検証済みであることを示すものではありません。
1. 採点方法の前に、まず課題を書き出す
ペリカンテストが魅力的なのは、誤りが表面にそのまま描き出されるからです。余分な脚、つながらないフレーム、ペダルに届かない足は、流暢な文章ではなかなかごまかせません。それでも、実際に何を測っているのかは、もっと具体的に言う必要があります。モデルに「SVG で自転車に乗るペリカンを描いて」と頼んだとき、直接観察できるのは、文章の要求をコードに変換できるか、そしてそのコードが要求を満たす絵を生成するかです。この結果だけでは、モデルが内部でどのような空間表現を使ったかはわかりません。「この問題はよくできた」を「完全な空間理解能力がある」と同一視することもできません。
モデルがレンダリングして絵を見て、何度も修正してよいのであれば、測っているのは 1 回のコード生成ではなく、フィードバック付きのワークフローです。どちらも測る価値はありますが、同じ「初回回答」のランキングに混ぜるべきではありません。より実際的なポイントはこうです。課題に書かれていない要件を、採点の段階で突然持ち出してはいけません。元の課題が「自転車に乗るペリカンを描く」だけなら、後から標準的なロードバイクであること、2 つの車輪がまったく同じ大きさであること、両方の翼がハンドルを握っていること、すべての部品がはっきり見えていることを求めるべきではありません。妥当な遠近法、遮蔽、カートゥーン調のデフォルメは、自由な描画の一部です。私はテストを 2 種類に分けることを提案します。
1 つは自由課題のまま残し、モデルが「乗る」ことをどう理解し、どう表現するかを観察するものです。採点では明確で必要不可欠な要件だけを見て、境界上のサンプルには議論の余地があることを受け入れます。もう 1 つは制約付き課題です。実行前に、視点、見えているべき関係、出力形式、使ってよい技術を決めておきます。たとえば、視点は主に真横から、両足を見せるための軽いずらしは可、各足とそのペダルの接点は必ず見えること、納品物は自己完結した SVG 1 つ、外部の画像やスクリプトは使わない、といった具合です。
制約付き課題は元の課題を変えてしまいますが、それは欠点ではありません。課題のバージョンを明記しておけば、より具体的な問いを立てられます。モデルは視点の指定を守れなかったのか、接触を明確に描けなかったのか、それとも自転車の構造自体を間違えたのか。重要なのは、どちらのバージョンがより「本物」かではありません。自由課題は自由課題として、制約付き課題は制約付き課題として採点することです。曖昧な課題に、後から考え出した厳しい基準を組み合わせてはいけません。
2. 合計点を急がず、まず「乗る」を分解する
「全体的によくできている。8 点」。これがいちばん手軽な採点方法で、いちばん再確認しにくい採点方法でもあります。その 8 点は、主体が正しいからなのか、構造が妥当だからなのか、配色が好ましいからなのか。次に同じ誤りが出たとき、ジャッジは今度は 9 点を付けたりしないでしょうか? 私はまず 4 つの観点から始めます。ただし、感覚で埋める 4 つの数字としては扱いません。
| 観点 | 主に確認すること | 混ぜてはいけないもの |
|---|---|---|
| Pelican:主体 | ペリカンだと識別できるか。胴体や手足に明らかな異常がないか。課題が明示的に求めた見え方を満たしているか | 課題が求めていない写実性、羽毛の細かさ、個人的な画風の好み |
| Bicycle:自転車 | 車輪、フレーム、クランク、ペダルなどが、課題の求める妥当な構造になっているか | 課題が求めていないブランド、車種、装飾、特定の SVG の書き方 |
| Riding:乗車関係 | 体が無理なく支えられているか。足がペダルに対応しているか。課題が求めた操作の関係が成り立っているか | 「鳥が自転車の横にいる」「両方のオブジェクトが存在する」というだけのこと |
| Animation:時間的な関係 | 求められた動きが起きているか。動きの中で接触と接続が保たれているか。不自然な飛びやめり込みがないか | 静的な課題ではそもそも求められていないアニメーション。課題と関係のないエフェクト |
オブジェクトが存在することと、関係が成り立つことは別です。「足がある」と「ペダルがある」は 2 つのオブジェクト判定です。「足がペダルに乗っている」は関係の判定です。さらに一歩進んで、「ペダルが回っている間も足がペダルに乗っている」は、時間をまたいだ関係の判定です。だからこそ、「ペリカン、自転車、車輪 2 つがそろっているか」を確認するだけでは、まったく足りません。切り分けるべきなのは、体とサドル、足とペダル、ペダルとクランク、フレームと車軸のつながりです。
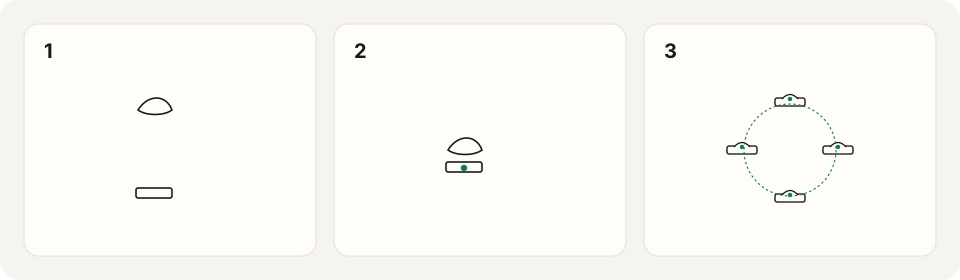
参考になる関連研究があります。TIFA はテキスト中の要件を複数の質問に変換し、視覚的質問応答で生成画像がそれを満たすかを確認します。既製のペリカン採点器ではありませんが、有用な方向性を示しています。全体の印象だけで点を付けるのではなく、画像を要件と 1 項目ずつ突き合わせるという方向です。1 実装面では、各チェックに pass、fail、uncertain、not_applicable の 4 つの状態を持たせることを勧めます。それぞれ合格、不合格、根拠不足、対象外を意味します。
重要なのは、最後の 2 つの区別です。静的な課題でアニメーションを求めていなければ、Animation は「対象外」です。アニメーションを求めているのに、めり込みを判断する材料が足りない場合は「根拠不足」です。前者で減点すべきではなく、後者を自動的に合格として数えてはいけません。次に、項目を必須条件と追加の品質項目に分けます。必須条件は合格かどうかを決め、追加項目は細部や見た目を記述します。必須条件で明確に不合格になったものは、見事な羽毛や背景、グラデーションで埋め合わせることはできません。
最初のレポートには、主体のチェックがいくつ通ったか、自転車の構造ではどの項目で失敗したか、乗車関係に未解決の問題があるか、アニメーションが対象かどうかだけを書けば十分です。小数点以下 2 桁まで正確な合計点は必要ありません。総合スコアが本当に必要なら、対象項目、重み、欠損値の扱いを事前に公開し、必須条件の不合格は別に示します。重みの違いで生じる順位も、それ自体がロバスト性を確認する価値のある対象です。合計点は圧縮された要約であって、元のエビデンスを置き換える理由にはなりません。
3. SVG DOM は役に立つが、答え付きの構造図ではない
SVG を見たときのエンジニアの直感は単純です。ソースコードがあるのだから、そのままパースすればよいのでは? そうしてルールはすぐに書けてしまいます。circle 要素が 2 つ見つかれば、車輪が 2 つある。foot という名前の要素が見つかれば、足がある。足とペダルのバウンディングボックスが交差していれば、足はペダルに乗っている。問題は、どのステップも「コード上の表現方法」を「絵の中の意味的な事実」と取り違えていることです。
車輪は円要素でもパスでも描けます。2 つの車輪は別々に書くことも、use で再利用することもできます。1 つの視覚的なオブジェクトが、複数のグループやパスで構成されることもあります。SVG 仕様はこうしたさまざまな表現を認めており、現実の 1 つのオブジェクトが 1 つの DOM ノードに対応することを求めてはいません。2 ですから、circle 要素を 2 つ数えられなくても車輪が欠けている証明にはならず、2 つ数えられても妥当な位置にある証明にはなりません。foot という名前の要素は、生成側が付けた名前にすぎず、独立した検証ではありません。
静的ルールは、確定できる制約の確認に向いている
たとえば、出力が取り決めた形式でパースできるか、課題で禁止された外部参照を含んでいないか、許可されていないスクリプトがないか、指定された環境で空でない内容をレンダリングできるか、といったものです。こうしたチェックには明確な根拠があり、ログも残しやすいものです。ただし、これらが答えるのは「納品と技術上の制約を満たしているか」であって、「この鳥が正しく自転車に乗っているか」ではありません。レンダリングに成功したからといって、形式チェックの代わりにもなりません。SVG 仕様は文書の形態と処理モードを区別しています。Web ページにインラインで埋め込んだ断片と単独の SVG ファイルを、その選択を明記しないまま同じパース要件で受け入れるべきではありません。3
幾何学的なチェックでは、まず何を測るのかを決める
足とペダルに対応する、目に見える幾何領域を確実に特定できれば、距離、重なり、軌跡を計算できます。たとえば、足裏とペダルの接触面との距離を、同じ絵の中で取り決めた基準の車輪径で割れば、相対距離が得られます。「ペダルからどれだけ離れているか」をこの形で論じるほうが、固定のピクセルしきい値をそのまま当てはめるよりも解釈しやすくなります。それでも、接触面をどう定義し、どこまでの誤差を許容するかは、ラベル付きのサンプルで較正する必要があります。「5 ピクセルずれていれば必ず誤り」と根拠なく宣言することはできません。
測定では、座標変換、ストローク、クリッピング、実際に見えているかどうかも考慮しなければなりません。SVG 要素は、入れ子になった座標系の中にあることがあります。仕様には、実際にはレンダリングされない要素でもバウンディングボックスを持つケースもあります。バウンディングボックスを得たからといって、絵の中で見えているオブジェクトの境界を得たことにはなりません。4 2 つのバウンディングボックスが交差していても、足裏がペダルに触れているとは限りません。平面上の 2 つの領域が重なっていても、それは奥行き方向の遮蔽にすぎず、妥当な支えではないかもしれません。汎用的な SVG に対しては、幾何学的なルールは検証を経た補助的なエビデンスとして使うほうがよく、較正されていないまま拒否権を持つジャッジにすべきではありません。
自動化のために、部品 ID、キーポイント、グループ構造を統一するよう求めることは可能です。ただしそれは、別の「構造化出力」トラックにすべきです。そうした宣言が実際の絵と対応しているかを確認するのであって、モデルが「接触は正しい」と書けば評価プログラムがそれを信じる、という形にしてはいけません。DOM は確認できる情報を増やしてくれますが、意味の認識をただで解決してくれるわけではありません。
4. 視覚ジャッジに任せる前に、ジャッジに試験を受けさせる
静的ルールで足りないなら、絵を見られるモデルに採点させればよい。これは進む価値のある道です。ただし、「モデルが絵を説明できる」ことを「モデルが微妙な空間的誤りを安定して判定できる」ことと同一視すべきではありません。MT-Bench と Chatbot Arena に関する 2023 年の研究は、LLM ジャッジの位置バイアス、冗長性バイアス、自己選好を論じると同時に、特定のテキスト評価では強力なモデルが人間の選好とかなりよく一致したことも報告しています。妥当な結論は「モデルのジャッジはどれも信用できない」ではなく、「その信頼性はタスクに依存し、検証が必要だ」というものです。また、これらのテキスト評価の結果を、そのまま視覚的な採点の正確さとして使うこともできません。5
視覚能力そのものも確認が必要です。2024 年の BlindTest の研究では、テスト対象の視覚言語モデルが、円が重なっているか、線が交差しているかといった単純な幾何学の問題でもまだ間違えることがわかりました。今日のモデルがすべて当時の水準にとどまっているという意味ではありません。それでも、細かな接触関係について、モデルが有名だというだけで正しく見えていると決めつけるべきではない、と気づかせてくれるには十分です。6 私なら、すぐにランキングをジャッジに任せるのではなく、まず人手による参照サンプルを作ります。
そのサンプルには、明らかな成功例と明らかな失敗例に加えて、境界上のケースも必要です。簡単なスケッチ、細い線、妥当な遮蔽、複雑なパス、静止していれば問題ないのに動くと誤りになる作品などです。少なくとも 2 人のアノテーターが独立にブラインドで採点し、そのうえで意見が分かれた箇所を見直すようにします。人間も当然の正解ではありません。2 人が同じルールを読んで毎回逆の結論に至るなら、最初に直すべきは課題か採点の指示かもしれません。どうしても明確にならないサンプルは、議論の余地があるものとして残してかまいません。「標準解答」をでっち上げる必要はありません。
ジャッジには好みの感想ではなく、具体的な質問に答えさせる
ジャッジには、元の課題、凍結した採点ルール、統一した方法でレンダリングした画像を渡します。アニメーションの項目では、タイムスタンプ付きのフレームか動画も渡します。提供元の名前、ランキング上の順位、生成モデル自身による「この画像は要件を完全に満たしています」といった説明は、一緒に渡さないでください。ジャッジには項目ごとに尋ねます。「各足はそれぞれのペダルに触れていますか?」「見えているフレームは、前後の車軸と妥当につながっていますか?」「これらの時点で、足とペダルのつながりは保たれていますか?」
各判定には、短く、位置を特定できるエビデンスを 1 つ添えます。たとえば「2.0 秒の時点で、手前側の足とペダルの間にはっきりした隙間がある」のようにです。エビデンスが足りないときは uncertain を返します。見えにくいことを流暢な文章でごまかしてはいけません。画像内の文字、SVG のコメント、メタデータは、あくまでテスト対象のコンテンツであり、採点ルールを変える指示にはなりません。ファイル名やチャネルのラベルを隠すことは、作品に手を加えてよいという意味ではありません。切り抜きや注釈付きの補助画像が必要なら、元の画像と処理の記録を両方残します。
較正を 1 つの「全体一致率」に頼ってはいけない
参照セットに、合格の画像が 90 枚、重大な誤りのある画像が 10 枚あるとします。常に「合格」と答えるジャッジでも全体の正解率は 90% になりますが、重大な誤りはすべて見逃します。ですから私は、重大な誤りをいくつ見逃したか、正しい作品をいくつ誤って落としたか、画風によって性能にばらつきがないか、同じ作品を繰り返し採点したときに結果が安定しているかを、それぞれ別に確認します。境界上のサンプルでは、ジャッジが根拠不足を認めようとするかどうかも見ます。
「1 つの要素だけを変えた」サンプルを少し用意すると役に立ちます。元の絵はそのままにして片足だけをペダルから離す、あるいは背景だけを変えて構造には手を付けない、といったものです。前者の変更は関連するスコアに影響すべきで、後者は構造の判定を理由なく変えるべきではありません。こうした人工サンプルは診断には向いていますが、実際のモデル出力を完全に置き換えることはできません。採点用プロンプトの修正に使うサンプルと、ジャッジの最終確認に使うホールドアウトのサンプルは、分けておく必要があります。同じ答えに合わせて満足のいく結果になるまで調整し、そのスコアを汎化の証明として扱ってはいけません。
複数のジャッジによる投票は、意見の相違を浮かび上がらせることができます。しかし、3 つのモデルを使ったからといって、3 つの判定が互いに独立しているわけではありません。同じ間違いを共有しているかもしれません。ジャッジ自身が「95% 確信している」と言っても、較正しないまま実際の正解率 95% として扱うことはできません。ジャッジが証明すべきなのは、自分のスコアを説明できることだけでなく、誤りを見抜けることです。
5. アニメーションは数枚の静止画ではなく、時間の中で関係が崩れないかを確かめるもの
静的な採点が問うのは「今、ペダルに乗っているか」です。アニメーションの採点が問うのは「動き出したあとも、その関係が成り立ち続けるか」です。最初のフレームでたまたま足がペダルに触れていても、その後ペダルの軌道に沿って動くとは限りません。逆に、足もペダルも固定して動かさなければ、課題が求めたペダルをこぐ動作を完成させたことにはなりません。つまりアニメーションには、少なくとも 2 つの異なる問いがあります。動くべきものが本当に動いているか、そして動きの中で保たれるべきつながりが保たれ続けているかです。
まず、アニメーションの場面を取り決めます。その場でこぐのか、前に進むのか、カメラが追いかけるのかは、それぞれ別の課題です。課題が精密な機械シミュレーションを求めていないなら、ギア比のような追加の制約をこっそり加えるべきではありません。クランクが回ること、足がペダルに触れ続けることを明示的に求めているなら、それらは受け入れ基準に含めるべきです。
評価環境は、実際のアニメーションの状態も保たなければなりません。具体的なエンジニアリング上の落とし穴を 1 つ挙げます。Playwright のスクリーンショットのオプション animations="disabled" は、対応している関連アニメーションを停止します。有限のアニメーションは終了状態まで進められ、無限のアニメーションはキャンセルされて初期状態に戻ります。「任意の瞬間を正確に切り取る」という意味ではありません。7 ですから、アニメーションをオフにして見栄えのよい 1 枚を撮っただけで、アニメーションを合格にすることはできません。まず動きがわかっているテスト用ファイルで、タイミングの制御とスクリーンショットの方法を確認し、そのうえでモデルの出力に使います。対応しているアニメーションの仕組みも明記しておくべきです。
課題が 4 秒のループを求めているとします。出発点になる案の 1 つは、2 回分の完全なループを観察し、事前に決めたレートでサンプリングし、さらにループの境目と誤りが疑われる区間を追加で確認する、というものです。観測期間、サンプリングレート、追加確認のルールは、どちらに問題が出たかを見てから厳しくするのではなく、本番の評価の前にすべて固定しておくべきです。それでも、有限のフレームでは、フレームの間に起きた一瞬の異常を見逃すことがあります。レポートには「いかなる時点でもめり込みがないことを数学的に証明した」ではなく、「取り決めた観測期間とサンプリング条件のもとでは、明らかな誤りは見つからなかった」と書くべきです。
平面の絵における通常の遮蔽にも注意が必要です。脚がフレームの後ろを通るとき、輪郭が重なっていても、それが自動的にめり込みを意味するわけではありません。確認すべきなのは、前後関係やつながりが不自然に変化していないかです。部分的な拡大は観察の助けになりますが、全体の空間的な文脈を捨ててはいけません。自動ジャッジが今のところ静止画しか確実に扱えないなら、静的な結果を公開し、アニメーションは人手のレビューに回しましょう。測っていない能力を合計点に押し込むより、この物差しはまだそこまで届かないと認めるほうがよいのです。
6. 採点システムも間違えるし、「モデルが急に劣化した」という錯覚を生むこともある
静的チェック、視覚ジャッジ、人手のレビューをそろえても、問題は終わりません。システムそのものが変わることがあるからです。昨日のジャッジは、わずかな隙間に寛容でした。今日の新しいバージョンは、厳しく減点します。生成された作品はまったく変わっていないのに、ランキング上の合格率は下がります。保存しているのが「モデル名、日付、合計点」だけなら、ジャッジの変化はモデルの劣化と誤解されやすくなります。生成モデルとリクエストのパラメーターに加えて、課題のバージョン、採点基準のバージョン、ジャッジのモデルと設定、レンダラーのバージョン、自動チェッカーのバージョンを記録してください。どれか 1 つが変わっただけでも、スコアの意味は変わりえます。
ジャッジやルールを入れ替える前に、私なら新旧のバージョンに保存済みの同じ作品を採点させ、差がどこに集中しているかを確認します。必要なら過去の作品を採点し直してもかまいませんが、それは「同じ成果物を新たに採点したもの」と明記すべきであり、モデルが改めて回答したかのように見せかけてはいけません。
もう 1 つの種類の問題は、評価が完了しなかった場合です。サービスのタイムアウト、壊れた SVG、スクリーンショットプログラムのクラッシュ、ジャッジへのリクエストの失敗を、すべて「モデルが描き間違えた」にまとめるべきではありません。作品そのものがルールに違反しているなら、事前に決めたルールに従って不合格にできます。評価基盤が故障したのなら、その評価は未判定として記録し、決まった手順で補完します。1 つの作品について、明確に不合格になった必須条件が 1 つでもあれば、全体を不合格としてかまいません。逆に、明確な不合格はないものの、まだはっきりしない必須条件があるなら、そのまま通すことはできません。
予定していた 100 件のリクエストのうち、合格が確定したものが 72 件、不合格が確定したものが 18 件、まだ判定していないものが 10 件あるとします。レポートでは、未判定のサンプルを削除して「合格率 80%」と発表するのではなく、まずこの 3 つの件数を示せばよいのです。判定済みのラベルをひとまず正しいとみなすなら、このバッチの最終的な合格割合は 72%~82% の間になりえます。下限は未判定をすべて不合格として、上限はすべて合格として数えた値です。この範囲は未判定のラベルから生じるもので、統計的な信頼区間ではありません。ジャッジの誤判定や、ほかのサンプルへの一般化に伴う不確実性も含んでいません。
人手のレビューも、ジャッジが付けた不合格や議論のある項目だけを見ればよいわけではありません。自動で合格した作品からも、事前に決めた方法で無作為に抽出して確認すべきです。そうしないと、最も危険な見逃しが「合格」の領域にずっと隠れたままになりかねません。どんな自動評価も、「自分の誤りを見つけたことがない」と言うことで、誤りがないことを証明することはできません。自らの誤りを能動的に見つけられる監査手順が必要です。
7. 課題は古くなる。しかし毎日変えれば科学的になるわけでもない
ある問題が話題になると、その問題に特化した例、チュートリアル、修正のアドバイス、最適化が後に続きます。モデルがペリカンをうまく描けたのを見ただけで、ズルをしたと言うことはできません。公開された問題が知られること、問題のタイプを学習すること、テストのサンプルが学習データに入ることは、それぞれ別のレベルの問題です。特定のモデルが特定のテスト素材を見たことがあるかどうかには、エビデンスが必要です。「この問題は有名すぎる」は、そのエビデンスにはなりません。
それでも、テスト素材が学習データに入ることは、評価が向き合わなければならないリスクです。LiveBench の取り組みには、より新しい情報源を使うこと、問題を継続的に更新すること、検証可能な答えに基づいて自動採点することが含まれます。これは関連するリスクを減らす実践の 1 つであって、「毎月問題を変えれば汚染はまったくない」ことを保証するものではありません。8 ペリカンのような自由生成の問題については、私は用途の異なる 3 種類の課題を持っておきたいと考えます。長期的な変化を観察するための、安定したコア問題。転移を観察するための、定期的に入れ替える拡張問題。手順を凍結した後の確認に使う、まだ公開していないホールドアウト問題。ホールドアウト問題は、ルールの調整を延々と続けるためのものではありません。
コア問題の価値は比較可能性にあり、学習データの汚染に免疫があることではありません。拡張問題の価値はカバー範囲を広げることにあり、より奇抜なプロンプトにすることではありません。
変えるべきは主役の名前だけでなく、制約そのもの
ペリカンをアヒルに替えるのも 1 つの変化です。しかし、それで関係の構造が自動的に変わるわけではありません。より診断に役立つバリエーションは、意図的に 1 つの条件を変えるものです。向きを反転させたとき、つながりは正しいままか。遮蔽を増やしたとき、重要な部品は欠けずに残るか。課題が「自転車の横に立って押す」になったとき、モデルはそれでも乗車の姿勢を当てはめてしまうか。同じ接触関係がアニメーションに入ったとき、崩れないか。
課題を別の関係に変えることもできます。手がカップの取っ手を持つ、物がトレーに支えられる、複数の部品が指定された順序でつながる、といったものです。肝心なのは、珍しい要件をすべて 1 枚の絵に詰め込むことではなく、各バリエーションが何をテストしているかを把握していることです。1 つのテンプレートに 100 種類の動物を機械的に当てはめれば、もちろん 100 問は作れます。だからといって、それを能力についての 100 個の独立したエビデンスと呼ぶことはできません。集計の際には課題のカテゴリーとテンプレートのファミリーを保持し、バリエーションが多いというだけで 1 つのテンプレートが合計の大半を占めないようにすべきです。
自動生成した新しい問題にも、受け入れ確認が必要です。問題が曖昧だったり、矛盾していたり、最終的な画像からは確認しようがなかったりすることがあります。問題、答え、ジャッジのルールをすべて同じモデルが提案し、その同じモデルが正しいと確認しているなら、独立したチェックはなおさら必要です。
問題セットを更新するとき、難易度の変化をモデルの進歩として描かない
今月 80 点、来月 90 点だったとしても、モデルが強くなったとは限りません。新しい問題が単に易しいだけかもしれません。古い問題セットを新しいものに入れ替えるときは、共通の問題を残し、参照用のシステム群に近い条件で両方の問題セットを解かせるのがよいでしょう。変化は課題のカテゴリーごとに分けて報告します。共通の問題も参照システムも、いつまでも正しい正解ではありません。変化を見分ける助けにはなりますが、難易度の厳密な等化を自動的に済ませてくれるわけではありません。エビデンスが不十分なときの誠実なやり方は、異なる試験の素点を 1 本の曲線につなぎ合わせることではなく、バージョンごとに結果を示すことです。
問題は引退した後に公開してもかまいません。ほかの人が再確認し、学び、改善できるようにするためです。公開されると、その役割は「まだ見られていないチェック」から「再現可能な回帰テスト」へと変わるかもしれません。問題は 1 回しか使えないわけではありませんが、いつまでも同じ測定器として使い続けられるわけでもありません。動的な問題セットの要点は、新しさを永遠に追いかけることではなく、各段階でその問題がどんな結論を支えられるかを管理することです。
8. 本当に自動化する価値があるのは、後から監査できる手順
ここまで来ると、計画をどんどん大きくしたくなります。複数のジャッジ、軌跡分析、動的な問題セット、自動の裁定、どれも欠かせない、と。しかし、最小限使えるバージョンを全自動の工場から始める必要はありません。少数の問題を選び、受け入れ条件を書き、実際の出力を集め、人手による参照を作り、そのうえでどの項目をルールに任せられるか、どの項目を視覚ジャッジに任せられるかを確認します。まだ確実に自動化できていない部分は、人手での対応を残します。
データが少ないうちの目標は、ルールの穴を見つけることであって、「採点精度があるレベルに達した」と発表することではありません。自動化した能力を正式に確認するには、別途ホールドアウトのサンプルが必要で、不確実性も報告しなければなりません。妥当な手順の一例は次のとおりです。
課題と受け入れルールを凍結 → 計画どおりに生成 → 完全な生の出力を保存
→ 管理された環境でパースとレンダリング → 静的チェック / 視覚による項目別採点
→ ルールに沿って議論のある項目をレビューし、自動合格の項目を抜き取り確認
→ 初回納品の結果、項目別の成績、未判定の状態を集計
各ステップは、その前のステップまでたどれるようにします。生のレスポンス、抽出した SVG、実際のレンダリング結果、アニメーションの観察記録、ジャッジの生の返答、レビューの結論は、1 つの実行 ID で結び付けます。ファイルを抽出したり正規化したりするときは、処理前と処理後のバージョンを保存します。SVG の一部を修復しなければレンダリングできなかったのなら、それは修復手順の結果として記録します。最初の回答を黙って上書きしてはいけません。採点ルールを更新したときは、古い記録を消すのではなく、新しい評価記録を追加します。
省略できないエンジニアリング上の前提が 1 つあります。モデルの出力は、信頼できないコンテンツとして扱うことです。SVG の処理モードには、スクリプト、イベント、外部リソースが関わることがあります。「拡張子が画像だ」ということは、普段ログインして使っているブラウザで実行しても安全だという意味ではありません。3
レンダリング環境では、アカウントの認証情報、ネットワーク、ホストのファイルを分離し、リソースの使用量を制限し、信頼できないコンテンツに適したサンドボックス構成を使うべきです。Playwright を使う場合も、ブラウザを「Docker に入れた」から問題が解決したことにはなりません。そのドキュメントは、デフォルトのコンテナイメージの用途の限界や、root での実行と Chromium のサンドボックスの関係について、明確に注意を促しています。9 具体的なセキュリティ対策は、実際に動かす環境で確認する必要があります。課題が何を許可し、実行環境が何を許可するかは、事前にそろえておくべきです。モデルにスクリプトを使わせておきながら、採点時に断りなくすべてのスクリプトを無効にしてはいけません。
本当に省くべきなのは、「丁寧な確認」そのものではありません。確認のたびにファイルを探し直し、パラメーターを照合し、タイムスタンプを書き足すという、繰り返しの手間です。
9. 読む価値のあるランキングは、さらに問いかけられるようになっている
スコアを見たとき、私はさらに次のことを調べられるようにしたいと思います。それはどのモデルサービスの、どの問題セットの、どの期間のスコアなのか。サンプルはいくつあり、不合格や未判定のケースは残されているのか。誰が採点し、どのように較正され、判定の根拠を見つけられるのか。こうした情報は、非常に精密に見える合計点よりも、その評価が自らの限界に真剣に向き合っているかどうかをよく物語ります。
自分で手順を構築するつもりのない人は、Folkbench の公開ランキング、レポート、評価に関する説明から始めて、関心のあるモデルとサービスに当てはまる公開済みの結果がすでにあるかを確認できます。その公開ホームページでは、比較の範囲を「同じモデルの異なるサービス」と説明しています。それでも、カバー範囲、機能の状態、結論の根拠は、その時点で公開されている情報に従ってください。10
これは Folkbench にも、ほかのランキングにも当てはまります。欠けている情報は不明のままにしておきます。プラットフォームの紹介は、実際のレポートの代わりにはなりません。この記事で提案した評価方法は、どこかのプラットフォームがすでに備えている機能と同じではありません。よい評価は、読者に「私のこのスコアを信じてほしい」と求めるものではありません。読者がスコアをたどって、作品、条件、ルール、意見の相違に行き着けるようにするものです。3 羽のペリカンの話に戻りましょう。
1 羽目がいちばん見栄えがよいかどうかを議論する必要はありませんし、ある 1 フレームが見事だからといって、3 羽目のアニメーション全体を合格にする必要もありません。何を測るかを取り決め、エビデンスをはっきり記録しておけば、「謎」と呼ばれがちなものの多くは、1 項目ずつ議論できる問いに変わります。第 1 回では、スクリーンショットはよい問いを立てることはできるが、それに答えるにはまともな実験が必要だと書きました。今回付け加えたいのは、まともな実験には、検証済みの物差しも必要だということです。
付録 A. 出発点にできる制約付き課題と受け入れ基準表
以下の静的な課題は、この記事のために設計した例です。業界標準でも、どこかのプラットフォームの正式な問題でもありません。使う前に試行し、アノテーションで較正してください。正式な比較を始めた後は、結果を見て課題を変えないでください。
プロンプトの例
単独で開ける、自己完結した静的 SVG ファイル 1 つの内容だけを出力してください。
viewBox は "0 0 800 600" とし、Markdown のコードフェンスや説明は付けないでください。

普通の 2 輪自転車に乗る、カートゥーン調のペリカンを描いてください。
視点は主に真横からとします。乗車の関係がはっきりわかるよう、部品を少しずらすことは認めます。

絵は次のすべてを満たす必要があります。
1. ペリカンと自転車が画面内に完全に収まり、余分な脚がないこと。
2. 前輪と後輪、フレーム、サドル、ハンドル、クランク、2 つのペダルが識別できること。
   フレームが前後両方の車軸と妥当につながり、ペダルがクランクと妥当な関係にあること。
3. 体がサドルに座っていること。2 本の足がそれぞれ自分のペダルに触れ、
   2 か所の接触がどちらもはっきり見えること。少なくとも片方の翼がハンドルに触れていること。
4. SVG のベクターグラフィックスとインラインスタイルだけを使うこと。埋め込みビットマップ、外部リソース、
   スクリプト、foreignObject、アニメーションは使わないこと。

写実性、複雑な背景、羽毛の質感、装飾的なエフェクトは求めません。
受け入れ基準表の例
| ID | 確認項目 | 種類 |
|---|---|---|
| F1 | 取り決めた単独ファイルの形式、ビューポート、リソース制限を満たす | 必須条件 |
| P1 | 主体がペリカンだと識別でき、絵が欠けておらず、明らかな余分な脚がない | 必須条件 |
| B1 | 2 つの車輪、フレーム、サドル、ハンドル、クランク、2 つのペダルが識別できる | 必須条件 |
| B2 | フレームが前後両方の車軸と妥当につながり、ペダルがクランクと妥当な関係にある | 必須条件 |
| R1 | 体とサドルが、座って支えられている関係をはっきり示している | 必須条件 |
| R2 | 各足がそれぞれのペダルに触れ、接触が見え方の要件を満たしている | 必須条件 |
| R3 | 少なくとも片方の翼がハンドルに触れている | 必須条件 |
| A | 静的な課題のため、アニメーションはテストしていない | 対象外 |
| Q1 | 色、線、細部 | 任意の表示項目。必須条件の不合格を打ち消さない |
「識別できる」「妥当な」「はっきり」には、対になる正例と負例、そして境界についての注記がまだ必要です。この表はルールの骨組みにすぎず、数行の文章だけで主観的な判断がなくなるわけではありません。結果が合格になるのは、すべての必須条件を満たしたときだけです。必須条件に明確な不合格があれば、不合格です。明確な不合格はないものの未判定の必須条件がある場合は、レビューに回します。R3 を確認するのは、このプロンプト例が明示的に求めているからです。断りなく、すべてのペリカン問題に当てはめるべきではありません。
付録 B. ジャッジ出力記録の例
以下の JSON は、1 項目分の架空の記録です。フィールド同士の関係を示すためのもので、実在の画像には対応していません。完全なレポートでも、何らかのライブラリでそのまま実行できる設定でもありません。
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "手前側の足と、それに対応するペダルの間に、はっきり見える隙間がある。"
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id からは、ジャッジの具体的なモデル、プロンプト、パラメーター、バージョン記録を特定できるようにします。render_profile_id からは、ブラウザ、ビューポート、その他の関連設定を特定できるようにします。アニメーションのエビデンスには、実際の時刻を記録します。「途中のどこかに 1 フレームある」とだけ書くべきではありません。review_required は評価システムが既定のルールに従って設定するもので、ジャッジが単独で決めるものではありません。このフィールドが false でも、そのサンプルが無作為の監査に入ることはあります。自動採点の失敗、視覚的な材料の不足、課題の不合格は、それぞれ別に記録すべきです。1 つの曖昧な「失敗」状態にまとめてはいけません。
注と出典
- Yushi Hu ほか、TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering、ICCV 2023。この論文は、テキストの要件を質問応答によるチェックに変換し、画像とテキストの整合性を評価します。この記事は分解の考え方を借りていますが、元論文の実験スコアをペリカンの SVG やアニメーションの課題に当てはめるものではありません。論文↩
- W3C、Scalable Vector Graphics (SVG) 2、文書構造とパスの章。グループ化、
useによる再利用、パスによる表現を参照してください。「DOM ノードは現実世界の意味的なオブジェクトに当然には対応しない」という判断は、これをもとにこの記事が評価設計として下したものです。文書構造、パス↩ - W3C、SVG 2 — Conformance Criteria、処理モードと文書の適合性に関する節。仕様は、スクリプトの実行、外部リソース、宣言的アニメーションといった機能を区別し、文書の形態も区別しています。ブラウザの対応状況と実行時の制限は、実際の環境で確認する必要があります。仕様↩
- W3C、SVG 2 — Coordinate Systems, Transformations and Units、座標変換とバウンディングボックスに関する箇所。接触距離、しきい値、意味の認識についてのこの記事の提案は評価設計の例であり、SVG 仕様が定める「正しい乗車」のアルゴリズムではありません。仕様↩
- Lianmin Zheng ほか、Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena、NeurIPS 2023 Datasets and Benchmarks Track、arXiv v4。この記事では、特定のテキスト評価におけるジャッジの能力とバイアスについての記述にのみ用いています。すべての視覚ジャッジに同じ程度のバイアスや同じ正確さがあると推定するものではありません。論文↩
- Pooyan Rahmanzadehgervi ほか、Vision language models are blind、2024。この記事は 2024 年の元の研究を参照しており、後の改訂でのモデル、タイトル、結果が混ざらないよう、arXiv v1 を指定して引用しています。この研究を 2026 年のモデルの現在のランキングとして使うことはできません。論文のバージョン↩
- Playwright のドキュメント、
page.screenshotのanimationsオプション、2026 年 10 月 5 日参照。ドキュメントは、このオプションが CSS アニメーション、CSS トランジション、Web Animations をどう扱うかを説明しています。確認しないまま、あらゆる SVG アニメーションの仕組みに共通するタイミング制御として拡大解釈すべきではありません。ドキュメント↩ - Colin White ほか、LiveBench: A Challenging, Contamination-Limited LLM Benchmark、ICLR 2025、arXiv v2。以前のタイトルでは「Contamination-Free」が使われていました。この記事は、継続的な更新、検証可能な採点、汚染リスクの低減に関する 2025 年改訂版の表現に従っており、汚染がまったくないことを約束するものではありません。論文↩
- Playwright の Docker ドキュメント、2026 年 10 月 5 日参照。ドキュメントは、デフォルトのイメージを信頼できない Web サイトへのアクセスに使うことは推奨しないと注意を促し、デフォルトで root として実行すると Chromium のサンドボックスが無効になることを説明しています。この記事は、完全で安全なデプロイ方法を示すものではありません。分離、ネットワーク、権限のポリシーは、実際に動かす環境に合わせて実装し、テストする必要があります。ドキュメント↩
- Folkbench 公開ホームページ、2026 年 10 月 5 日参照。ホームページにはランキング、レポート、関連する説明への入口があり、比較の範囲を「同じモデルの異なるサービス」と説明しています。また、その計測の入口には、ベータ版の準備フローであること、そして実際のプローブはまだ有効になっておらず、現在の入口は準備フローを示すためのものであることが表示されています。この記事は公開情報を示すだけです。表示用の入口を完了した実測とはみなさず、特定のランキングを独自に保証するものでもなく、Folkbench がここで提案した 4 つの観点による採点、ジャッジの較正、動的な問題セットを実装済みだと主張するものでもありません。ホーム↩


