
첫 번째 글에서는 스크린샷 한 장을 쉽게 믿지 말라고 했습니다. 이번 글에서는 점수조차 쉽게 믿어서는 안 되는 이유를 묻습니다.
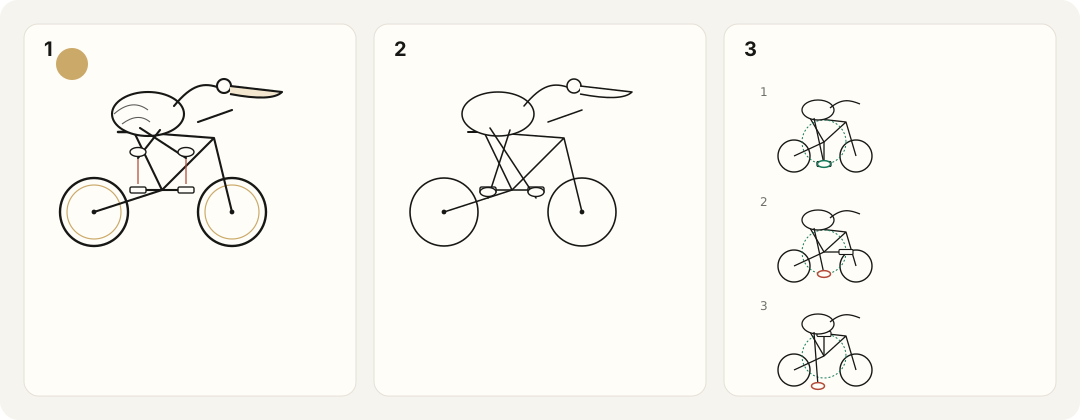
자전거를 타는 펠리컨 세 마리가 있다고 해 봅시다. 첫 번째는 아주 공들여 그렸습니다. 깃털에는 층이 있고, 바퀴에는 하이라이트가 들어가 있으며, 배경에는 노을까지 깔려 있습니다. 그런데 자세히 보면 두 발이 모두 페달 위에 떠 있습니다. 두 번째는 몇 번의 선으로 쓱쓱 그린 스케치 같습니다. 그림자도 없고 보기 좋은 색 배합도 없습니다. 그래도 프레임은 무리 없이 이어지고, 몸은 안장에 앉아 있으며, 발은 실제로 페달을 밟고 있습니다. 세 번째는 정지 화면으로 보면 흠잡을 데가 없습니다. 하지만 재생 버튼을 누르면 발이 제멋대로 궤적을 그리며 떠다니기 시작합니다. 페달은 페달대로 돌고, 펠리컨은 펠리컨대로 발을 구릅니다. 어느 펠리컨이 가장 높은 점수를 받아야 합니까?
답이 “첫 번째가 가장 예쁘다”라면 우리는 미감을 채점하고 있는 것입니다. 답이 “두 번째가 가장 믿을 만하다”라면 과제를 완수했는지를 채점하고 있는 것입니다. 스크린샷만 본다면 세 번째의 오류는 아예 발견되지 않을 수도 있습니다.
앞선 글에서는 모델이 정말 나빠졌는지 판단하려면 골라낸 출력 하나가 아니라 비교 가능한 조건에서 반복한 테스트가 필요하다고 주장했습니다. 그런데 그 주장 안에는 아직 해결되지 않은 전제가 숨어 있습니다. 무엇이 합격인지 우리가 이미 알고 있다는 전제입니다. 이 전제가 성립하지 않는다면 테스트를 반복해도 결론이 저절로 믿을 만해지지는 않습니다. 편향된 자가 점점 더 안정적으로 잴 뿐일 수도 있습니다. 이 글은 바로 거기서 출발해, “이 펠리컨은 그럭저럭 괜찮아 보인다”는 인상을 근거가 있고, 다시 확인할 수 있으며, 단계적으로 자동화할 수 있는 평가 방법으로 바꾸는 길을 찾아봅니다.
참고: 이 글에 나오는 샘플, 숫자, 채점 방식과 설정은 모두 방법론을 설명하기 위한 예시입니다. 실제 모델 순위와는 관계가 없으며, Folkbench가 이러한 절차를 이미 구현했다는 뜻도 아닙니다. 인용한 연구는 관련 방법과 위험을 설명하기 위한 것이며, 이 글의 제안이 실험으로 검증되었다는 뜻은 아닙니다.
1. 채점을 논하기 전에 과제부터 명확히 쓰기
펠리컨 테스트가 매력적인 이유는 오류가 겉으로 그대로 드러나기 때문입니다. 다리가 하나 더 있거나, 프레임이 이어지지 않거나, 발이 페달에 닿지 않으면 그럴듯한 말로 덮기 어렵습니다. 그래도 이 테스트가 정확히 무엇을 측정하는지는 더 구체적으로 말해야 합니다. 모델에게 “SVG로 자전거 타는 펠리컨을 그려라”라고 요청했을 때 직접 관찰되는 것은, 글로 된 요구를 코드로 옮길 수 있는지, 그리고 그 코드가 요구에 맞는 그림을 만들어 내는지입니다. 이 결과만으로는 모델이 내부적으로 어떤 공간 표상을 사용했는지 알 수 없습니다. “이 문항을 잘 풀었다”를 “완전한 공간 이해 능력을 갖췄다”와 같은 것으로 볼 수도 없습니다.
모델이 렌더링하고, 그림을 보고, 여러 번 고칠 수 있다면 측정 대상은 단 한 번의 코드 생성이 아니라 피드백이 있는 워크플로가 됩니다. 둘 다 측정할 가치가 있습니다. 다만 같은 첫 답변 순위표에 섞어서는 안 됩니다. 더 실질적인 요점은 이것입니다. 과제에 적혀 있지 않던 요구가 채점할 때 갑자기 등장해서는 안 됩니다. 원래 과제가 “자전거 타는 펠리컨을 그려라” 한 문장뿐이라면, 나중에 와서 표준 로드바이크여야 한다거나, 두 바퀴 크기가 정확히 같아야 한다거나, 두 날개가 모두 핸들바를 잡아야 한다거나, 모든 부품이 또렷하게 드러나야 한다고 요구해서는 안 됩니다. 합리적인 원근, 가림, 만화적 표현은 원래 열린 그림 과제의 일부입니다. 저라면 테스트를 두 종류로 나누겠습니다.
하나는 열린 과제를 그대로 두고, 모델이 “자전거를 탄다”는 것을 어떻게 이해하고 표현하는지 관찰하는 방식입니다. 채점은 명확하고 꼭 필요한 요구만 잡아내며, 경계에 있는 샘플은 논란이 있을 수 있음을 인정합니다. 다른 하나는 제약 과제입니다. 시점, 보여야 하는 관계, 출력 형식, 허용되는 기법을 실행 전에 미리 정해 둡니다. 예를 들어 측면 시점을 기본으로 하되 두 발을 모두 보여 주기 위해 약간 어긋나게 그리는 것은 허용하고, 각 발과 해당 페달이 닿는 부분은 반드시 보이게 하며, 결과물은 자체 완결형 SVG 파일 하나로 제출하고, 외부 이미지나 스크립트는 쓰지 않도록 정할 수 있습니다.
제약 과제는 원래 과제를 바꿉니다. 그렇다고 결함은 아닙니다. 과제 버전을 명시해 두면 더 구체적인 질문을 던질 수 있습니다. 모델이 시점 요구를 놓쳤는지, 접촉 관계를 분명히 그리지 못했는지, 아니면 자전거 구조부터 잘못 그렸는지 말입니다. 핵심은 어느 쪽이 더 “정통”이냐가 아닙니다. 열린 과제는 열린 과제로, 제약 과제는 제약 과제로 채점해야 합니다. 모호한 과제에 나중에 만들어 낸 엄격한 기준을 짝지어서는 안 됩니다.
2. 총점을 서두르지 말고, “탄다”는 것부터 분해하기
“전체적으로 괜찮네, 8점.” 가장 편한 채점 방식이자 가장 다시 확인하기 어려운 방식입니다. 그 8점은 주체가 정확해서입니까, 구조가 합리적이어서입니까, 아니면 색이 마음에 들어서입니까? 다음에 같은 오류가 나왔을 때 심판이 9점을 주지는 않겠습니까? 저는 네 가지 차원에서 시작하겠지만, 이를 감으로 채워 넣는 숫자 네 개로 다루지는 않겠습니다.
| 차원 | 주로 확인하는 것 | 섞어서는 안 되는 것 |
|---|---|---|
| Pelican: 주체 | 펠리컨으로 알아볼 수 있는지, 몸이나 팔다리에 뚜렷한 이상이 없는지, 과제가 명시한 가시성 요구를 충족하는지 | 과제가 요구하지 않은 사실감, 깃털 디테일, 개인적인 화풍 취향 |
| Bicycle: 자전거 | 바퀴, 프레임, 크랭크, 페달 등이 과제가 요구한 합리적인 구조를 이루는지 | 과제가 요구하지 않은 브랜드, 차종, 장식, 특정 SVG 작성 방식 |
| Riding: 탑승 관계 | 몸이 합리적으로 지탱되는지, 발이 페달과 대응하는지, 과제가 요구한 조작 관계가 성립하는지 | 단지 “새가 자전거 옆에 있다”거나 “두 대상이 모두 존재한다”는 것 |
| Animation: 시간에 따른 관계 | 요구된 동작이 일어나는지, 동작 중에 접촉과 연결이 유지되는지, 부자연스러운 튐이나 관통이 없는지 | 정적 과제에서는 요구하지도 않은 애니메이션, 과제와 무관한 효과 |
대상이 존재한다고 해서 관계가 성립하는 것은 아닙니다. “발이 있다”와 “페달이 있다”는 대상 판단 두 개입니다. “발이 페달 위에 있다”는 관계 판단입니다. 한 걸음 더 나아가 “페달이 도는 동안에도 발이 페달 위에 있다”는 시간을 가로지르는 관계 판단입니다. 그래서 “펠리컨, 자전거, 바퀴 두 개가 모두 있는가”만 확인해서는 턱없이 부족합니다. 정말로 따로 떼어 봐야 할 것은 몸과 안장, 발과 페달, 페달과 크랭크, 프레임과 바퀴 축 사이의 연결입니다.
참고할 만한 관련 연구도 있습니다. TIFA는 텍스트에 담긴 요구를 여러 질문으로 바꾼 뒤, 시각 질의응답으로 생성된 이미지가 그 요구를 충족하는지 확인합니다. 바로 가져다 쓸 수 있는 펠리컨 채점기는 아니지만, 유용한 방향을 보여 줍니다. 전체 인상 점수만 매기기보다 이미지가 요구와 일치하는지 항목별로 확인하라는 것입니다. 1 구현에서는 모든 검사 항목에 pass, fail, uncertain, not_applicable의 네 가지 상태를 두겠습니다. 각각 통과, 실패, 증거 부족, 해당 없음을 뜻합니다.
중요한 것은 마지막 두 상태의 구분입니다. 정적 과제가 애니메이션을 요구하지 않았다면 Animation은 “해당 없음”입니다. 애니메이션을 요구했는데 자료가 부족해 관통 여부를 판단할 수 없다면 그것은 “증거 부족”입니다. 앞의 경우는 감점해서는 안 되고, 뒤의 경우는 자동으로 통과 처리해서는 안 됩니다. 그다음에는 항목을 필수 조건과 부가 품질 항목으로 나눕니다. 필수 조건은 합격 여부를 정하고, 부가 항목은 디테일과 외관을 기술합니다. 필수 조건에서 명확한 실패가 나왔다면 멋진 깃털, 배경, 그라데이션으로 그 실패를 메울 수 없습니다.
초기 보고서에는 주체 검사가 몇 개 통과했는지, 자전거 구조의 어느 항목에서 실패했는지, 탑승 관계에 미결 문제가 있는지, 애니메이션이 해당되는지만 적어도 충분합니다. 소수점 둘째 자리까지 정밀한 총점이 꼭 필요하지는 않습니다. 종합 점수가 정말 필요하다면 적용 항목, 가중치, 결측값 처리 방식을 미리 공개하고, 필수 조건의 실패는 따로 보여 주어야 합니다. 가중치에 따라 달라지는 순위 자체도 강건한지 확인해 볼 가치가 있습니다. 총점은 압축된 요약일 뿐, 원래의 증거를 대신할 이유가 되지 않습니다.
3. SVG DOM은 도움이 되지만, 정답이 딸려 오는 구조도는 아닙니다
SVG를 보면 떠오르는 엔지니어링 직관은 단순합니다. 소스 코드가 있으니 바로 파싱하면 되지 않느냐는 것입니다. 그러면 규칙은 금방 만들어집니다. circle 요소를 두 개 찾으면 바퀴가 두 개, foot이라는 이름의 요소를 찾으면 발이 있는 것, 발과 페달의 바운딩 박스가 교차하면 발이 페달 위에 있는 것으로 봅니다. 문제는 이 단계 하나하나가 “코드에서 무언가를 표현하는 방식”을 “그림 속 의미상의 사실”로 착각한다는 점입니다.
바퀴 하나는 원 요소로 그릴 수도 있고 경로(path)로 그릴 수도 있습니다. 바퀴 두 개를 따로 작성할 수도 있고 use로 재사용할 수도 있습니다. 시각적 대상 하나가 여러 그룹과 경로로 이루어질 수도 있습니다. SVG 명세는 이처럼 다양한 표현을 허용하며, 현실의 대상 하나가 DOM 노드 하나에 대응할 것을 요구하지 않습니다. 2 따라서 circle 요소가 두 개 세어지지 않는다고 바퀴가 빠졌다는 증거가 되지는 않고, 두 개가 세어진다고 해서 그것들이 합리적인 위치에 있다는 증거가 되지도 않습니다. foot이라는 이름의 요소 역시 생성 모델이 붙인 이름일 뿐, 독립적인 검증이 아닙니다.
정적 규칙은 확정할 수 있는 제약을 검사하는 데 가장 적합합니다
예를 들어 출력이 약속한 형식으로 파싱되는지, 과제가 금지한 외부 참조가 들어 있는지, 허용되지 않은 스크립트가 있는지, 지정된 환경에서 비어 있지 않은 내용으로 렌더링되는지 같은 것들입니다. 이런 검사는 근거가 분명하고 로그를 남기기도 쉽습니다. 하지만 이들이 답하는 것은 “제출 요건과 기술적 제약을 충족하는가”이지 “이 새가 자전거를 제대로 탔는가”가 아닙니다. 렌더링에 성공했다고 해서 형식 검사를 대신할 수도 없습니다. SVG 명세는 문서 형태와 처리 모드를 구분합니다. 웹 페이지에 인라인으로 삽입된 조각과 독립된 SVG 파일을, 그렇게 한다고 밝히지 않은 채 같은 파싱 요구로 검수해서는 안 됩니다. 3
기하 검사는 먼저 무엇을 재는지부터 정해야 합니다
발과 페달에 해당하는 보이는 기하 영역을 신뢰할 수 있게 식별했다면 거리, 겹침, 궤적을 계산할 수 있습니다. 예를 들어 발바닥과 페달 접촉면 사이의 거리를 같은 그림 안에서 약속한 기준 바퀴 지름으로 나누면 상대 거리가 나옵니다. “페달에서 얼마나 떨어졌는가”를 이런 형태로 논하는 편이 고정된 픽셀 임곗값을 그대로 들이대는 것보다 해석하기 쉽습니다. 다만 접촉면을 어떻게 정의하고 오차를 얼마나 허용할지는 여전히 라벨링된 샘플로 보정해야 합니다. “5픽셀 차이가 나면 무조건 틀린 것”이라고 근거 없이 선언할 수는 없습니다.
측정에서는 좌표 변환, 선(stroke), 클리핑, 실제 가시성도 고려해야 합니다. SVG 요소는 중첩된 좌표계 안에 있을 수 있습니다. 명세에는 실제로 렌더링되지 않은 요소도 바운딩 박스를 갖는 경우가 있습니다. 바운딩 박스를 얻었다고 해서 그림 속에 보이는 대상의 경계를 얻은 것은 아닙니다. 4 두 바운딩 박스가 교차한다고 해서 발바닥이 페달에 닿은 것도 아닙니다. 평면 영역 두 개가 겹치는 것도 앞뒤로 가린 것일 뿐, 합리적으로 지탱하고 있다는 뜻이 아닐 수 있습니다. 일반적인 SVG에서는 기하 규칙을 검증을 거친 뒤 보조 증거로 쓰는 편이 낫습니다. 보정되지 않은 채 거부권을 쥔 심판으로 써서는 안 됩니다.
자동화를 위해 부품 ID, 키포인트, 그룹 구조를 통일된 방식으로 출력하도록 요구할 수도 있습니다. 다만 그것은 별도의 “구조화 출력 트랙”이어야 합니다. 그런 선언이 실제 그림과 대응하는지를 검사해야 하며, 모델이 “접촉 정상”이라고 써 넣었다고 평가 프로그램이 그대로 믿게 해서는 안 됩니다. DOM은 검사할 수 있는 정보를 더 많이 주지만, 의미 인식을 공짜로 해결해 주지는 않습니다.
4. 시각 심판에게 일을 맡기기 전에, 심판부터 시험하기
정적 규칙으로 부족하다면 그림을 볼 수 있는 모델에게 채점을 맡기면 됩니다. 가 볼 만한 길입니다. 다만 “모델이 그림을 묘사할 수 있다”를 “모델이 미세한 공간 오류를 안정적으로 판정할 수 있다”와 같은 것으로 취급해서는 안 됩니다. MT-Bench와 Chatbot Arena에 관한 2023년 연구는 LLM 심판의 위치 편향, 장황함 편향, 자기 선호 같은 문제를 다루는 한편, 특정 텍스트 평가에서는 강한 모델이 사람의 선호와 꽤 잘 일치했다는 결과도 보고합니다. 따라서 합리적인 결론은 “모델 심판은 전부 믿을 수 없다”가 아니라 “신뢰도는 과제에 따라 달라지므로 검증해야 한다”입니다. 이 텍스트 평가 결과를 시각 채점의 정확도로 그대로 가져다 쓸 수도 없습니다. 5
시각 능력 자체도 검증이 필요합니다. 2024년 BlindTest 연구는 당시 시험한 시각 언어 모델들이 원이 겹치는지, 선이 교차하는지 같은 단순한 기하 과제에서도 여전히 실수한다는 사실을 발견했습니다. 오늘날의 모든 모델이 그해 수준에 머물러 있다는 뜻은 아닙니다. 그래도 미세한 접촉 관계를 모델의 지명도만 믿고 정확히 볼 것이라고 가정해서는 안 된다는 점을 일깨워 주기에는 충분합니다. 6 저라면 순위표를 곧바로 심판에게 넘기기보다 사람이 판정한 참조 샘플 세트부터 구축하겠습니다.
이 세트에는 명백한 성공작과 명백한 실패작뿐 아니라 경계 사례도 있어야 합니다. 간단한 스케치, 가는 선, 합리적인 가림, 복잡한 경로, 그리고 멈춰 있을 때는 괜찮지만 움직이면 틀어지는 작품 같은 것들입니다. 가능하면 라벨러를 최소 두 명 두어 각자 독립적으로 블라인드 채점하게 한 뒤, 의견이 갈린 부분을 검토하세요. 사람도 타고난 정답 기준은 아닙니다. 두 사람이 같은 규칙을 읽고도 계속 반대 결론을 낸다면, 먼저 고쳐야 할 것은 과제나 채점 설명일 수 있습니다. 명확히 할 수 없는 샘플은 논란이 있는 상태로 남겨 둘 수 있습니다. 억지로 “표준 답안”을 만들어 낼 필요는 없습니다.
심판은 취향에 대한 감상이 아니라 구체적인 질문에 답해야 합니다
심판에게는 원래 과제, 동결된 채점 규칙, 동일한 방식으로 렌더링한 이미지를 줍니다. 애니메이션 문항이라면 시간 표시가 있는 프레임이나 영상도 함께 줍니다. 서비스 제공업체 이름, 순위표 위치, 생성 모델이 직접 쓴 “이 그림은 요구를 완전히 충족함” 같은 설명은 주지 마세요. 심판에게는 항목별로 묻습니다. “두 발이 각각 자기 페달에 닿아 있는가?” “보이는 프레임이 앞뒤 바퀴 축과 합리적으로 연결되는가?” “이 시점들에서 발과 페달의 연결이 유지되는가?”
판단마다 짧고 위치를 특정할 수 있는 증거를 하나씩 붙입니다. 예를 들면 “2.0초 시점, 관찰자에 가까운 발과 페달 사이에 뚜렷한 틈이 있음” 같은 식입니다. 증거가 부족하면 uncertain을 반환하게 합니다. 잘 보이지 않는 부분을 매끄러운 설명으로 덮어서는 안 됩니다. 이미지 속 텍스트, SVG 주석, 메타데이터는 평가 대상인 콘텐츠일 뿐이며, 채점 규칙을 바꾸는 지시가 될 수 없습니다. 파일 이름이나 채널 라벨을 가렸다고 해서 작품을 마음대로 수정해도 되는 것은 아닙니다. 잘라 내거나 보조 표시를 덧붙인 그림이 필요하다면 원본과 처리 기록을 함께 보관해야 합니다.
보정은 하나의 “전체 일치율”에만 기댈 수 없습니다
참조 세트에 합격 이미지 90장과 심각한 오류가 있는 이미지 10장이 있다고 해 봅시다. 언제나 “통과”라고 답하는 심판도 전체 정확도 90%를 얻지만, 심각한 오류는 하나도 잡아내지 못합니다. 그래서 저는 핵심 오류를 얼마나 놓쳤는지, 올바른 작품을 얼마나 잘못 떨어뜨렸는지, 화풍이 달라도 성능이 일관적인지, 같은 작품을 반복 채점했을 때 결과가 안정적인지를 따로 확인하겠습니다. 경계 샘플에서는 심판이 증거 부족을 인정할 줄 아는지도 봐야 합니다.
“한 가지 요인만 바꾼” 샘플을 몇 개 만들어 두면 유용합니다. 원본은 그대로 두고 발 하나만 페달에서 떼어 놓거나, 구조는 건드리지 않고 배경만 바꾸는 식입니다. 앞의 변경은 관련 점수에 영향을 주어야 하고, 뒤의 변경은 아무 이유 없이 구조 판단을 바꾸어서는 안 됩니다. 이렇게 인위적으로 만든 샘플은 진단에는 적합하지만 실제 모델 출력을 완전히 대신할 수는 없습니다. 채점 프롬프트를 고치는 데 쓴 샘플과 최종적으로 심판을 검증하는 홀드아웃 샘플도 분리해야 합니다. 같은 답안에 맞춰 만족스러울 때까지 조정한 뒤, 그 성적을 일반화 능력의 증거로 내세워서는 안 됩니다.
여러 심판의 투표는 의견 차이를 드러내는 방법이 될 수 있습니다. 하지만 모델 세 개를 썼다고 해서 세 판단이 서로 독립적인 것은 아닙니다. 같은 실수를 공유할 수도 있습니다. 심판이 스스로 “95% 확신한다”고 말해도, 보정을 거치지 않았다면 실제 정확도 95%로 받아들일 수 없습니다. 심판이 증명해야 하는 것은 자기 점수를 설명하는 능력만이 아니라, 오류를 알아보는 능력입니다.
5. 애니메이션은 스크린샷 몇 장을 더 찍는 일이 아니라, 시간 속에서 관계가 끊기는지 확인하는 일입니다
정적 채점은 “지금 페달 위에 있는가?”를 묻습니다. 애니메이션 채점은 “움직이기 시작한 뒤에도 그 관계가 계속 성립하는가?”를 묻습니다. 첫 프레임에서 발이 우연히 페달에 닿아 있다고 해서 그 뒤에도 페달의 궤적을 따라 움직인다는 보장은 없습니다. 반대로 발과 페달을 함께 고정해 아무것도 움직이지 않게 만든 것도 과제가 요구한 페달링 동작을 완성한 것이 아닙니다. 따라서 애니메이션에는 적어도 두 가지 서로 다른 질문이 있습니다. 움직여야 할 것이 실제로 움직이는가, 그리고 움직이는 동안 유지되어야 할 연결이 계속 유지되는가입니다.
먼저 애니메이션 장면부터 합의해야 합니다. 제자리에서 페달을 밟는 것, 앞으로 나아가는 것, 카메라가 따라가는 것은 서로 다른 과제입니다. 과제가 정밀한 기계 시뮬레이션을 요구하지 않았다면 기어비 같은 추가 제약을 슬그머니 덧붙여서는 안 됩니다. 반면 크랭크가 돌고 발이 페달에 계속 닿아 있어야 한다고 명시했다면, 그 요구는 검수 항목에 들어가야 합니다.
평가 환경도 실제 애니메이션 상태를 보존해야 합니다. 구체적인 엔지니어링 함정을 하나 들어 보겠습니다. Playwright의 스크린샷 옵션 animations="disabled"는 지원하는 관련 애니메이션을 멈춥니다. 유한 애니메이션은 끝까지 진행시키고, 무한 애니메이션은 취소해 초기 상태로 되돌립니다. “임의의 순간을 정확히 캡처한다”는 뜻이 아닙니다. 7 그러니 누군가 애니메이션을 끄고 보기 좋은 그림 한 장을 캡처했다고 해서 애니메이션을 통과로 처리할 수는 없습니다. 먼저 동작이 알려진 테스트 파일로 시간 제어와 스크린샷 방법을 검증하고, 그다음에 모델 출력에 적용해야 합니다. 지원하는 애니메이션 방식도 문서로 남겨야 합니다.
과제가 4초 루프를 요구한다고 해 봅시다. 출발점이 될 만한 방안은 완전한 루프 두 번을 관찰하면서 미리 정한 빈도로 샘플링하고, 루프가 이어지는 지점과 오류가 의심되는 구간을 추가로 확인하는 것입니다. 관찰 구간, 샘플링 빈도, 추가 확인 규칙은 모두 정식 평가 전에 고정해야 하며, 어느 쪽에 문제가 보이는지 확인한 뒤에 기준을 조여서는 안 됩니다. 그렇게 해도 유한한 프레임 샘플링은 프레임 사이에 잠깐 나타나는 이상을 놓칠 수 있습니다. 보고서에는 “수학적으로 전 구간에 관통이 없음을 증명했다”가 아니라 “약속한 구간과 샘플링 조건에서 뚜렷한 오류를 발견하지 못했다”고 적어야 합니다.
평면 그림에서 생기는 정상적인 가림도 주의해야 합니다. 다리가 프레임 뒤로 지나갈 때 윤곽이 겹친다고 해서 자동으로 관통인 것은 아닙니다. 확인해야 할 것은 앞뒤 순서나 연결 관계가 부자연스럽게 바뀌는지입니다. 부분 확대는 관찰에 도움이 되지만, 전체적인 공간 맥락을 버려서는 안 됩니다. 자동 심판이 현재 정지 이미지만 신뢰할 수 있게 다룰 수 있다면, 정적 성적을 먼저 공개하고 애니메이션은 사람의 검토로 남겨 두세요. 측정하지 못한 능력을 총점에 밀어 넣느니, 이 자가 아직 거기까지 닿지 못한다고 인정하는 편이 낫습니다.
6. 채점 시스템도 틀릴 수 있고, “모델이 갑자기 나빠졌다”는 착시를 만들 수도 있습니다
정적 검사, 시각 심판, 사람의 검토를 갖추어도 문제는 끝나지 않습니다. 시스템 자체가 바뀔 수 있기 때문입니다. 어제의 심판은 살짝 떠 있는 정도에는 관대했는데, 오늘 새 버전으로 바뀌자 엄격하게 감점하기 시작합니다. 생성된 작품은 하나도 바뀌지 않았는데 순위표의 합격률은 떨어집니다. “모델 이름, 날짜, 총점”만 저장한다면 심판의 변화를 모델의 성능 저하로 잘못 읽기 쉽습니다. 생성 모델과 요청 파라미터 외에도 과제 버전, 채점 기준 버전, 심판의 모델과 설정, 렌더러 버전, 자동 검사 프로그램의 버전을 기록하세요. 이 가운데 어느 하나만 바뀌어도 점수가 뜻하는 바가 달라질 수 있습니다.
심판이나 규칙을 교체하기 전에, 저라면 이전 버전과 새 버전으로 저장된 같은 작품들을 함께 채점해 보고 차이가 어디에 몰리는지 살펴보겠습니다. 필요하면 과거 작품을 다시 채점할 수 있지만, 그것은 “같은 산출물에 대한 새 버전의 재채점”으로 표시해야 하며, 모델이 방금 다시 답한 것처럼 꾸며서는 안 됩니다.
또 다른 유형의 문제는 평가가 끝나지 않은 경우입니다. 서비스 타임아웃, 손상된 SVG, 스크린샷 프로그램의 충돌, 심판 요청 실패를 모두 “모델이 잘못 그렸다”로 뭉뚱그려서는 안 됩니다. 작품 자체가 규칙을 어겼다면 미리 정한 규칙에 따라 실패로 판정할 수 있습니다. 평가 인프라에 장애가 났다면 평가를 미결로 기록하고, 정해진 절차에 따라 보완 평가를 해야 합니다. 작품 하나에 대해서는 필수 조건 하나가 명확히 실패한 것만으로 전체를 불합격으로 판정할 수 있습니다. 반대로 명확한 실패는 없지만 아직 판단하기 어려운 필수 조건이 남아 있다면 그대로 통과시켜서는 안 됩니다.
예정된 요청 100건 가운데 72건이 합격으로 확인되고, 18건이 불합격으로 확인되었으며, 10건은 아직 판정되지 않았다고 해 봅시다. 보고서는 미결 샘플을 지우고 “합격률 80%”를 발표하기보다 이 세 수치를 먼저 분명히 적을 수 있습니다. 이미 판정된 라벨을 일단 옳다고 본다면, 이 배치의 최종 합격 비율은 72%에서 82% 사이일 수 있습니다. 하한은 미결 항목을 모두 실패로, 상한은 모두 통과로 계산한 값입니다. 이 범위는 미결 라벨에서 나온 것이며 통계적 신뢰 구간이 아닙니다. 심판의 오판이나 다른 샘플로 일반화할 때의 불확실성도 포함하지 않습니다.
사람의 검토도 심판이 표시한 실패와 논란만 봐서는 안 됩니다. 자동으로 통과한 작품 가운데서도 미리 정한 방식으로 일부를 무작위 추출해 확인해야 합니다. 그렇지 않으면 가장 위험한 누락이 “통과” 영역에 계속 숨어 있을 수 있습니다. 어떤 자동 평가도 “스스로 오류를 발견한 적이 없다”는 사실만으로 오류가 없음을 증명할 수는 없습니다. 자신의 실수를 적극적으로 찾아내는 감사 절차가 필요합니다.
7. 과제는 낡기 마련이지만, 매일 바꾼다고 더 과학적인 것은 아닙니다
어떤 문항이 화제가 되면 예시, 튜토리얼, 수정 요령, 그리고 그 문항만을 겨냥한 최적화가 뒤따릅니다. 그렇다고 모델이 펠리컨을 잘 그린 것만 보고 부정행위를 했다고 단정할 수는 없습니다. 공개 문항의 노출, 문제 유형의 학습, 테스트 샘플의 학습 데이터 유입은 서로 다른 층위의 문제입니다. 특정 모델이 특정 테스트 자료를 접했는지는 증거가 있어야 판단할 수 있습니다. “이 문항은 너무 유명하다”는 것은 그런 증거가 아닙니다.
그래도 테스트 자료가 학습 데이터에 들어가는 것은 평가가 마주해야 할 위험입니다. LiveBench는 더 새로운 정보원을 사용하고, 문항을 지속적으로 갱신하며, 검증 가능한 정답을 기준으로 자동 채점하는 방식을 씁니다. 이는 관련 위험을 줄이는 하나의 실천 방식이지, “매달 문항을 바꾸기만 하면 오염이 전혀 없다”는 보장이 아닙니다. 8 펠리컨 같은 개방형 생성 문항이라면 저는 용도가 다른 세 종류의 문항을 두는 쪽을 택하겠습니다. 장기적인 변화를 관찰하는 안정적인 핵심 문항, 전이를 관찰하는 정기 교체 확장 문항, 그리고 아직 공개하지 않은 홀드아웃 문항입니다. 홀드아웃 문항은 절차를 동결한 뒤 검증하는 데 쓰며, 규칙을 끝없이 조정하는 데는 쓰지 않습니다.
핵심 문항의 가치는 비교 가능성에 있지, 학습 오염에 대한 면역에 있지 않습니다. 확장 문항의 가치는 더 넓은 범위에 있지, 더 기이한 문제에 있지 않습니다.
바꿀 가치가 있는 것은 주인공의 이름만이 아니라 제약입니다
펠리컨을 오리로 바꾸는 것도 하나의 변화이지만, 그것만으로 관계 구조가 바뀌지는 않습니다. 진단 가치가 더 높은 변형은 조건 하나를 의도적으로 바꿉니다. 방향을 반대로 돌려도 연결 관계가 여전히 올바른지, 가림이 늘어나도 핵심 부품이 온전한지, “자전거 옆에 서서 끌고 가라”고 요구해도 모델이 여전히 타는 자세를 갖다 쓰는지, 같은 접촉 관계가 애니메이션에 들어가면 무너지는지 같은 것들입니다.
관계 과제 자체를 바꿀 수도 있습니다. 손으로 컵 손잡이를 쥐기, 쟁반 위에 물체를 받치기, 여러 부품을 지정된 순서로 연결하기 같은 것입니다. 핵심은 희귀한 요구를 그림 한 장에 몽땅 쌓는 것이 아니라, 각 변형이 무엇을 검사하는지 아는 것입니다. 템플릿 하나에 동물 100종을 기계적으로 바꿔 넣으면 물론 문항 100개가 생깁니다. 그렇다고 능력에 대한 독립적인 증거 100개를 얻었다고 할 수는 없습니다. 집계할 때는 과제 범주와 템플릿 계열을 함께 남겨, 변형이 유난히 많다는 이유만으로 한 템플릿이 총점의 대부분을 차지하지 않도록 해야 합니다.
자동으로 생성한 새 문항도 검수가 필요합니다. 문항이 모호하거나, 모순되거나, 최종 이미지로는 아예 검증할 수 없는 것일 수 있습니다. 문항, 정답, 심판 규칙을 모두 같은 모델이 제안하고 그 모델이 직접 옳다고 확인한다면, 독립적인 검사가 더욱 필요합니다.
문항 은행을 바꿀 때 난이도 변화를 모델의 발전으로 그리지 않기
이번 달 80점, 다음 달 90점이라고 해서 반드시 모델이 강해졌다는 뜻은 아닙니다. 새 문항이 그저 더 쉬웠을 수도 있습니다. 그래서 이전 문항 은행을 새것으로 바꿀 때는 공통 문항을 남겨 두고, 참조 시스템 한 세트가 비슷한 조건에서 두 문항 은행을 모두 풀게 하는 편이 좋습니다. 과제 범주별 변화는 따로 보고합니다. 공통 문항과 참조 시스템도 영원히 옳은 정답 기준은 아닙니다. 변화를 식별하는 데 도움이 될 뿐, 엄밀한 난이도 동등화를 저절로 해 주지는 않습니다. 증거가 부족할 때 가장 정직한 방법은 서로 다른 시험지의 원점수를 억지로 한 곡선으로 잇지 않고, 버전별로 성적을 나누어 보여 주는 것입니다.
사용을 마친 문항은 공개해서 다른 사람들이 다시 확인하고, 배우고, 개선하게 할 수 있습니다. 다만 공개된 뒤에는 그 역할이 “아직 본 적 없는 검증”에서 “반복 가능한 회귀 테스트”로 바뀔 수 있습니다. 문항은 한 번만 쓸 수 있는 것도 아니고, 영원히 같은 측정 도구로 쓸 수 있는 것도 아닙니다. 동적 문항 은행의 핵심은 끝없이 새로움을 좇는 것이 아니라, 각 단계에서 문항이 어떤 결론을 뒷받침할 수 있는지 관리하는 것입니다.
8. 정말 자동화할 가치가 있는 것은 나중에 되짚어 감사할 수 있는 절차입니다
여기까지 오면 방안을 점점 크게 키우기 쉽습니다. 여러 심판, 궤적 분석, 동적 문항 은행, 자동 중재까지 무엇 하나 빠뜨릴 수 없을 것 같습니다. 하지만 최소한으로 쓸 수 있는 버전이 완전 자동화된 공장에서 시작할 필요는 없습니다. 작은 문항 세트를 고르고, 검수 조건을 적고, 실제 출력을 모으고, 사람이 판정한 참조 기준을 만든 뒤, 어떤 항목을 규칙에 맡기고 어떤 항목을 시각 심판에 맡길 수 있는지 검증하세요. 아직 신뢰할 수 있게 자동화하지 못한 부분은 사람이 처리하도록 남겨 둡니다.
데이터가 적을 때의 목표는 규칙의 허점을 찾는 것이지, “채점 정확도가 어느 수준에 도달했다”고 서둘러 발표하는 것이 아닙니다. 자동화 능력을 정식으로 검증하려면 별도의 홀드아웃 샘플을 두고 불확실성도 함께 보고해야 합니다. 합리적인 절차의 한 예는 다음과 같습니다.
과제와 검수 규칙 동결 → 계획에 따라 생성 → 전체 원본 출력 저장
→ 통제된 환경에서 파싱과 렌더링 → 정적 검사 / 시각 항목별 채점
→ 규칙에 따라 논란 검토, 자동 통과 항목 표본 점검
→ 첫 제출 결과, 항목별 성과, 미결 상태 집계
각 단계는 바로 앞 단계로 거슬러 올라갈 수 있어야 합니다. 원본 응답, 추출한 SVG, 실제 렌더링 이미지, 애니메이션 관찰 기록, 심판의 원본 반환값, 검토 결론은 하나의 실행 식별자로 묶습니다. 파일을 추출하거나 정규화할 때는 처리 전후 버전을 모두 저장합니다. SVG 일부를 고쳐야 렌더링에 성공했다면, 그것은 수정 절차의 결과로 기록해야 하며 첫 답변을 몰래 덮어써서는 안 됩니다. 채점 규칙을 업그레이드할 때도 이전 기록을 지우지 말고 새 평가 기록을 추가해야 합니다.
건너뛸 수 없는 엔지니어링 전제가 하나 있습니다. 모델 출력을 신뢰할 수 없는 콘텐츠로 다뤄야 한다는 것입니다. SVG 처리 모드에는 스크립트, 이벤트, 외부 리소스가 관여할 수 있습니다. “확장자가 이미지”라고 해서 평소 로그인해 쓰는 브라우저에서 실행해도 안전하다는 뜻은 아닙니다. 3
렌더링 환경은 계정 자격 증명, 네트워크, 호스트 파일을 격리하고, 리소스 사용을 제한하며, 신뢰할 수 없는 콘텐츠에 맞는 샌드박스 설정을 사용해야 합니다. Playwright를 쓴다고 해서 브라우저를 “Docker에 넣었으니” 문제가 해결된 것도 아닙니다. 공식 문서는 기본 컨테이너 이미지의 용도 제한, 그리고 root 실행과 Chromium 샌드박스의 관계를 분명히 경고합니다. 9 구체적인 보안 조치는 실제 실행 환경에서 검증해야 합니다. 과제가 허용하는 기능과 실행 환경이 허용하는 기능도 미리 맞춰 두어야 합니다. 모델에게 스크립트를 쓰게 해 놓고, 채점할 때 아무 설명 없이 스크립트를 전부 막아서는 안 됩니다.
정말 아껴야 할 것은 “꼼꼼한 검증” 그 자체가 아닙니다. 검증할 때마다 파일을 다시 찾고, 파라미터를 대조하고, 타임스탬프를 채워 넣는 반복 작업입니다.
9. 읽을 가치가 있는 순위표는 계속 캐물을 수 있게 해 줍니다
점수 하나를 볼 때 저는 그 뒤를 계속 찾아볼 수 있기를 바랍니다. 그 점수가 어떤 모델 서비스, 어떤 문항 은행, 어떤 기간에 해당하는지, 샘플은 몇 개였고 실패와 미결 사례를 남겨 두었는지, 누가 채점했고 어떻게 보정했으며 판정 근거를 찾을 수 있는지 말입니다. 이런 정보는 매우 정밀해 보이는 총점보다, 평가가 자신의 한계를 진지하게 다뤘는지를 더 잘 보여 줍니다.
직접 절차를 구축할 생각이 없다면 Folkbench의 공개 순위, 보고서, 평가 설명에서 시작해, 관심 있는 모델과 서비스에 해당하는 게시된 결과가 이미 있는지 확인할 수 있습니다. 공개 홈페이지는 비교 범위를 같은 모델 아래의 서로 다른 서비스로 설명합니다. 다만 구체적인 적용 범위, 기능 상태, 결론의 근거는 그때그때 공개된 정보를 기준으로 삼아야 합니다. 10
Folkbench든 다른 순위표든 마찬가지입니다. 빠진 정보는 알 수 없는 것으로 남겨 둡니다. 플랫폼의 소개가 실제 보고서를 대신하지는 않습니다. 이 글이 제안한 평가 방안도 어떤 플랫폼이 이미 갖춘 능력과 같은 것이 아닙니다. 좋은 평가는 독자에게 “내 점수를 믿어라”라고 요구하지 않습니다. 독자가 점수를 따라 작품, 조건, 규칙, 의견 차이까지 찾아갈 수 있게 합니다. 다시 그 세 마리 펠리컨으로 돌아가 봅시다.
첫 번째가 가장 보기 좋은지를 두고 다툴 필요도 없고, 세 번째의 어느 한 프레임이 예쁘다고 해서 애니메이션 전체를 통과시켜 줄 필요도 없습니다. 무엇을 잴지 먼저 합의하고 증거를 분명히 기록하기만 하면, 흔히 감이나 운의 영역으로 여겨지던 많은 것이 항목별로 논의할 수 있는 문제가 됩니다. 첫 번째 글은 스크린샷 한 장이 좋은 질문을 던질 수는 있지만, 그 질문에 답하려면 제대로 된 실험이 필요하다고 말했습니다. 이번 글이 덧붙이고 싶은 말은 이것입니다. 제대로 된 실험에는 검증을 거친 자도 필요합니다.
부록 A. 출발점으로 쓸 수 있는 제약 과제와 검수표
아래 정적 문항은 이 글을 위해 설계한 예시입니다. 업계 표준이 아니며, 어떤 플랫폼의 공식 문항도 아닙니다. 사용하기 전에 시범 운영과 라벨링 보정을 거쳐야 합니다. 정식 비교가 시작된 뒤에는 결과를 보고 문항을 바꾸지 마세요.
예시 프롬프트
독립적으로 열 수 있는 자체 완결형 정적 SVG 파일 하나의 내용만 출력하세요.
viewBox는 "0 0 800 600"으로 하세요. Markdown 코드 펜스나 설명은 붙이지 마세요.

평범한 두 바퀴 자전거를 타는 만화풍 펠리컨을 그리세요.
측면 시점을 기본으로 하세요. 탑승 관계가 분명히 보이도록 부품을 약간 어긋나게 그리는 것은 허용합니다.

그림은 다음을 모두 충족해야 합니다.
1. 펠리컨과 자전거가 화면 안에 완전히 들어가 있고, 여분의 다리가 없어야 합니다.
2. 앞뒤 바퀴, 프레임, 안장, 핸들바, 크랭크, 페달 두 개를 알아볼 수 있어야 합니다.
   프레임은 앞뒤 바퀴 축과 합리적으로 연결되고, 페달과 크랭크의 관계도 합리적이어야 합니다.
3. 몸은 안장에 앉아 있어야 합니다. 두 발은 각각 자기 페달에 닿아 있어야 하고,
   두 접촉 부분이 모두 분명히 보여야 합니다. 적어도 한쪽 날개는 핸들바에 닿아 있어야 합니다.
4. SVG 벡터 그래픽과 인라인 스타일만 사용하세요. 삽입 비트맵, 외부 리소스,
   스크립트, foreignObject, 애니메이션은 사용하지 마세요.

사실적인 묘사, 복잡한 배경, 깃털 질감, 장식 효과는 필요하지 않습니다.
예시 검수표
| 번호 | 검사 항목 | 성격 |
|---|---|---|
| F1 | 약속한 독립 파일 형식, 뷰포트, 리소스 제한을 충족 | 필수 조건 |
| P1 | 주체를 펠리컨으로 알아볼 수 있고, 그림이 온전하며, 명확한 여분의 다리가 없음 | 필수 조건 |
| B1 | 바퀴 두 개, 프레임, 안장, 핸들바, 크랭크, 페달 두 개를 알아볼 수 있음 | 필수 조건 |
| B2 | 프레임과 앞뒤 바퀴 축, 페달과 크랭크의 연결 관계가 합리적 | 필수 조건 |
| R1 | 몸과 안장이 분명한 착석 지지 관계를 이룸 | 필수 조건 |
| R2 | 두 발이 각각 자기 페달에 닿아 있고, 접촉 부분이 가시성 요구를 충족 | 필수 조건 |
| R3 | 적어도 한쪽 날개가 핸들바에 닿아 있음 | 필수 조건 |
| A | 정적 문항이므로 애니메이션 능력은 테스트하지 않음 | 해당 없음 |
| Q1 | 색, 선, 디테일 표현 | 선택 표시 항목, 필수 조건 실패를 상쇄하지 않음 |
“알아볼 수 있음”, “합리적”, “분명한” 같은 표현에는 여전히 짝을 이루는 긍정·부정 예시와 경계에 대한 설명이 필요합니다. 이 표는 규칙의 뼈대일 뿐이며, 문장 몇 줄만으로 주관적 판단이 사라지지는 않습니다. 필수 조건을 모두 통과해야 합격입니다. 필수 조건 하나라도 명확히 실패하면 불합격입니다. 명확한 실패는 없지만 미결인 필수 조건이 있으면 검토로 넘깁니다. R3를 검사하는 이유는 이 예시 프롬프트가 그것을 명시적으로 요구했기 때문이며, 아무 설명 없이 모든 펠리컨 문항에 적용해서는 안 됩니다.
부록 B. 심판 출력 기록 하나의 예시
아래 JSON은 항목 하나에 대한 가상의 기록으로, 필드 사이의 관계를 보여 주기 위한 것입니다. 실제 이미지와는 관계가 없습니다. 완전한 보고서도 아니고, 어떤 라이브러리에서 바로 실행할 수 있는 설정도 아닙니다.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "관찰자에 가까운 발과 해당 페달 사이에 뚜렷하게 보이는 틈이 있습니다."
  },
  "review_required": false,
  "review_reason": null
}judge_profile_id로는 심판의 구체적인 모델, 프롬프트, 파라미터, 버전 기록을 찾을 수 있어야 합니다. render_profile_id로는 브라우저, 뷰포트 및 기타 관련 설정을 찾을 수 있어야 합니다. 애니메이션 증거에는 실제 시점을 기록해야 하며, “중간쯤 어느 프레임”이라고만 적어서는 안 됩니다. review_required는 평가 시스템이 정해진 규칙에 따라 설정하며, 심판이 혼자 결정하지 않습니다. 이 필드가 false라도 샘플은 무작위 감사 대상이 될 수 있습니다. 자동 채점 실패, 시각 자료 부족, 과제 불합격은 따로 기록해야 하며, 하나의 모호한 “실패” 상태로 함께 묶어서는 안 됩니다.
주석과 참고 자료
- Yushi Hu 외, TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. 이 논문은 텍스트 요구를 질의응답 검사로 바꾸어 이미지와 텍스트의 일치도를 평가합니다. 이 글은 그 분해 아이디어를 빌렸을 뿐, 원 논문의 실험 성적을 펠리컨 SVG나 애니메이션 과제로 옮겨 오지 않습니다. 논문↩
- W3C, Scalable Vector Graphics (SVG) 2, 문서 구조(Document Structure)와 경로(Paths) 장. 그룹화,
use를 통한 재사용, 경로 표현을 참고하세요. “DOM 노드가 현실의 의미 대상과 자연스럽게 대응하지는 않는다”는 것은 이를 바탕으로 이 글이 내린 평가 설계상의 판단입니다. 문서 구조; 경로↩ - W3C, SVG 2 — Conformance Criteria, 처리 모드와 문서 적합성에 관한 절. 명세는 스크립트 실행, 외부 리소스, 선언적 애니메이션 같은 기능을 구분하고, 서로 다른 문서 형태도 구분합니다. 구체적인 브라우저 지원과 실행 제한은 실제 환경에서 따로 검증해야 합니다. 명세↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, 좌표 변환과 바운딩 박스(Bounding boxes) 관련 단락. 접촉 거리, 임곗값, 의미 인식에 관한 이 글의 제안은 평가 설계의 예시이며, SVG 명세가 정의한 “올바른 탑승” 판정 알고리즘이 아닙니다. 명세↩
- Lianmin Zheng 외, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. 이 글은 특정 텍스트 평가에서 심판의 능력과 편향에 관한 내용만 근거로 삼으며, 모든 시각 심판이 같은 정도의 편향이나 같은 정확도를 가진다고 추정하지 않습니다. 논문↩
- Pooyan Rahmanzadehgervi 외, Vision language models are blind, 2024. 이 글은 2024년의 원래 연구를 가리키며, 이후 개정판의 모델, 제목, 결과가 섞이지 않도록 arXiv v1을 특정해 인용합니다. 이 연구를 2026년 모델의 현재 순위로 쓸 수는 없습니다. 논문 버전↩
- Playwright 공식 문서,
page.screenshot의animations옵션, 확인일: 2026년 10월 5일. 문서는 이 옵션이 CSS animations, CSS transitions, Web Animations를 어떻게 처리하는지 설명합니다. 검증 없이 모든 SVG 애니메이션 방식에 통하는 단일한 시간 제어 수단으로 확대해서는 안 됩니다. 문서↩ - Colin White 외, LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. 초기 버전의 제목에는 “Contamination-Free”가 쓰였습니다. 이 글은 지속적인 갱신, 검증 가능한 채점, 오염 위험 감소에 관한 2025년 개정판의 표현을 따르며, 오염이 전혀 없다고 약속하지 않습니다. 논문↩
- Playwright 공식 Docker 문서, 확인일: 2026년 10월 5일. 문서는 기본 이미지를 신뢰할 수 없는 웹사이트 방문에 쓰는 것을 권장하지 않으며, 기본 설정인 root 실행이 Chromium 샌드박스를 비활성화한다고 설명합니다. 이 글은 완전한 보안 배포 방안을 제공하지 않습니다. 실제 격리, 네트워크, 권한 정책은 실행 환경에 맞게 구현하고 테스트해야 합니다. 문서↩
- Folkbench 공개 홈페이지, 확인일: 2026년 10월 5일. 홈페이지는 순위, 보고서, 관련 설명으로 가는 입구를 제공하며, 같은 모델 아래의 서로 다른 서비스를 비교한다고 소개합니다. 또한 측정 입구에는 “베타 준비 절차”라는 표시와 함께 “실제 측정은 아직 활성화되지 않았으며, 현재 입구는 준비 절차를 보여 주기 위한 것”이라는 안내가 붙어 있습니다. 이 글은 공개 정보의 입구를 가리킬 뿐입니다. 표시용 입구를 완료된 실측으로 간주하지 않고, 특정 순위를 독자적으로 보증하지 않으며, Folkbench가 이 글에서 제안한 4개 차원 채점, 심판 보정, 동적 문항 은행을 구현했다고 주장하지도 않습니다. 홈페이지↩


