
Saíram as pontuações oficiais do Claude Haiku 5.5. Coloque-o ao lado do Haiku 4.5, do GPT-6 Luna e do Sonnet 5.5, e a pergunta que vale a discussão não é se ele venceu em todos os itens. É até onde o Haiku 5.5 empurrou o limite do que um modelo pequeno consegue fazer.
O modelo lançado pela Anthropic é o Claude Haiku 5.5. O ID do modelo é claude-haiku-5-5. O lançamento foi em 7 de outubro de 2026.
O posicionamento da Anthropic é direto. O Haiku 5.5 é o seu modelo pequeno mais rápido, mais barato e mais capaz, voltado para trabalhos de alto volume, baixa latência e sensíveis a custo. Os usos típicos citados são classificação, extração de informações, resumos, compactação de contexto, consultas a bancos de dados, uso de navegador e atuação como subagente do Sonnet 5.5 ou do Opus 5.5.
Este artigo usa apenas os benchmarks, os preços e as informações de produto que a Anthropic publicou. Ele não reembala esse boletim como se fosse um experimento independente. O trabalho aqui é recolocar os números no contexto do tipo de tarefa, do preço e do papel do modelo, e ver onde o Haiku 5.5 é realmente forte — e que trabalho ainda não deve ser entregue a ele.
Resumo: o Haiku 5.5 cruzou a linha do “modelo pequeno só faz trabalho simples”
Juntando os números oficiais, o perfil do Haiku 5.5 fica claro:
- em relação ao Haiku 4.5, ele sobe de forma expressiva em todos os principais benchmarks que a Anthropic publicou;
- nos itens reportados lado a lado, ele fica à frente do GPT-6 Luna;
- em trabalho de conhecimento, uso de computador e parte das tarefas de raciocínio, ele já se aproxima do Sonnet 5.5;
- em programação agêntica complexa, ainda fica claramente atrás do Sonnet 5.5;
- seu ponto mais competitivo é a combinação de velocidade, preço e uma taxa de conclusão de tarefas que agora é alta o suficiente.
Por isso, faz mais sentido ler o Haiku 5.5 como uma camada de execução cuja capacidade deu um salto, e não como um modelo que substitui o Sonnet 5.5 em tudo.
A comparação oficial de benchmarks
A Anthropic publicou os números abaixo no anúncio do Haiku 5.5. As células do GPT-6 Luna e do Sonnet 5.5 vêm da mesma tabela comparativa.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: trabalho de conhecimento | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: trabalho de conhecimento | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: uso de computador | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam: sem ferramentas | 45,9% | 10,2% | — | 56,9% |
| Humanity's Last Exam: com ferramentas | 57,4% | 18,7% | — | 64,5% |
| Terminal-Bench 4.0: programação agêntica | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1: programação agêntica | 46,4% | — | 42,4% | 52,1% |
| Chartography: raciocínio visual | 46,4% | 6,4% | 29,1% | 61,6% |
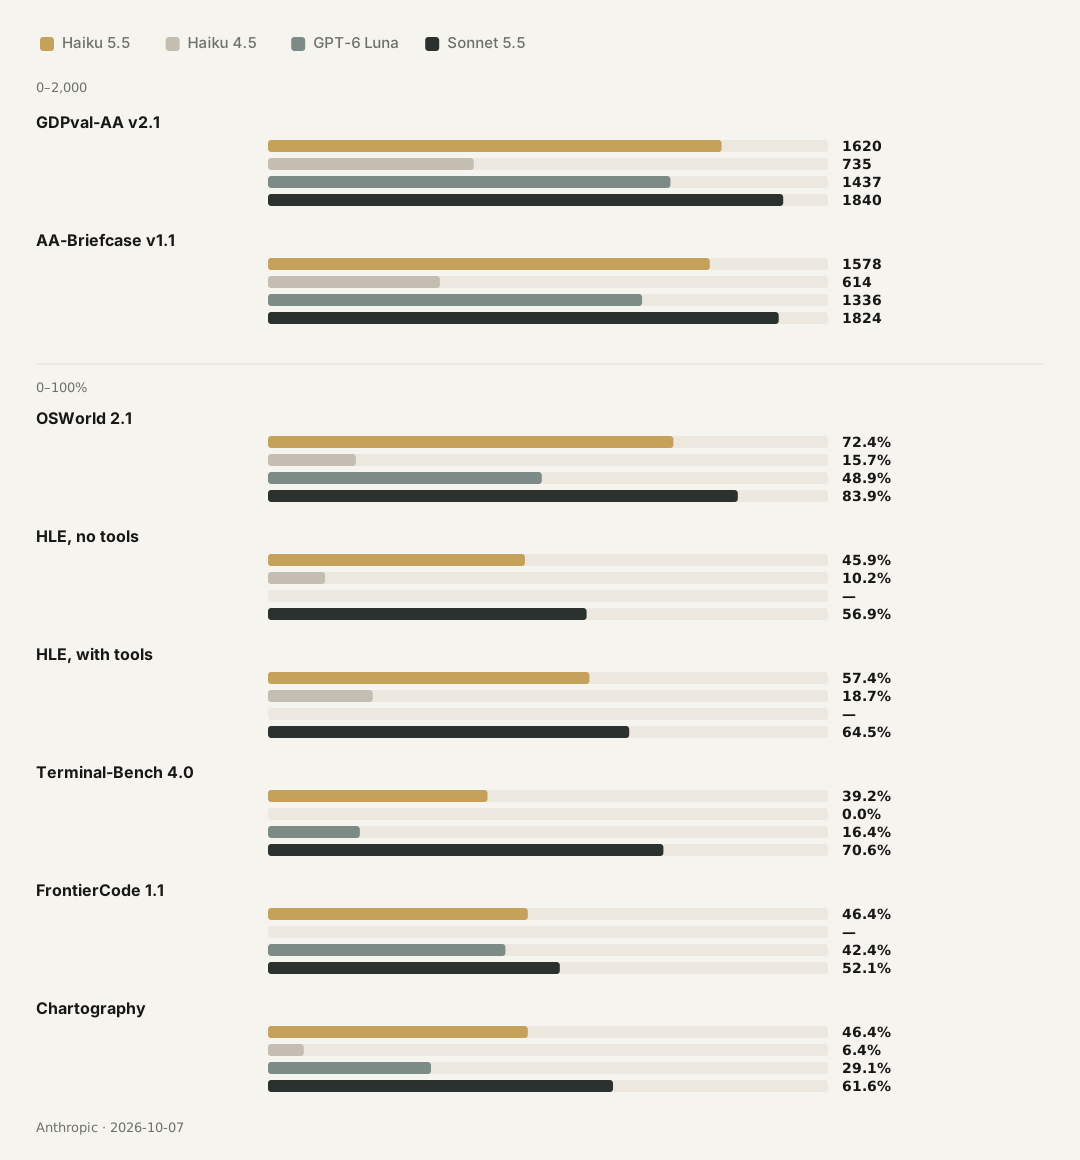
Esses números não se resumem a um simples “o Haiku 5.5 ficou em segundo”. Os benchmarks medem habilidades diferentes. O trabalho de conhecimento olha para a qualidade do que é entregue. O OSWorld verifica se o modelo consegue operar um computador de verdade. O Terminal-Bench avalia se ele consegue concluir trabalho profissional de várias etapas na linha de comando. O Humanity’s Last Exam pende para conhecimento difícil e raciocínio.
Uma variação grande entre tarefas também faz parte do resultado.
Mudança um: o Haiku 5.5 deixou a geração anterior para trás
Basta olhar só para o Haiku 4.5 e o Haiku 5.5 para ver o tamanho do salto.
O GDPval-AA v2.1 vai de 735 para 1620, cerca de 2,2 vezes a geração anterior. O AA-Briefcase vai de 614 para 1578, cerca de 2,6 vezes. O OSWorld vai de 15,7% para 72,4%. O Terminal-Bench vai de 0,0% para 39,2%.
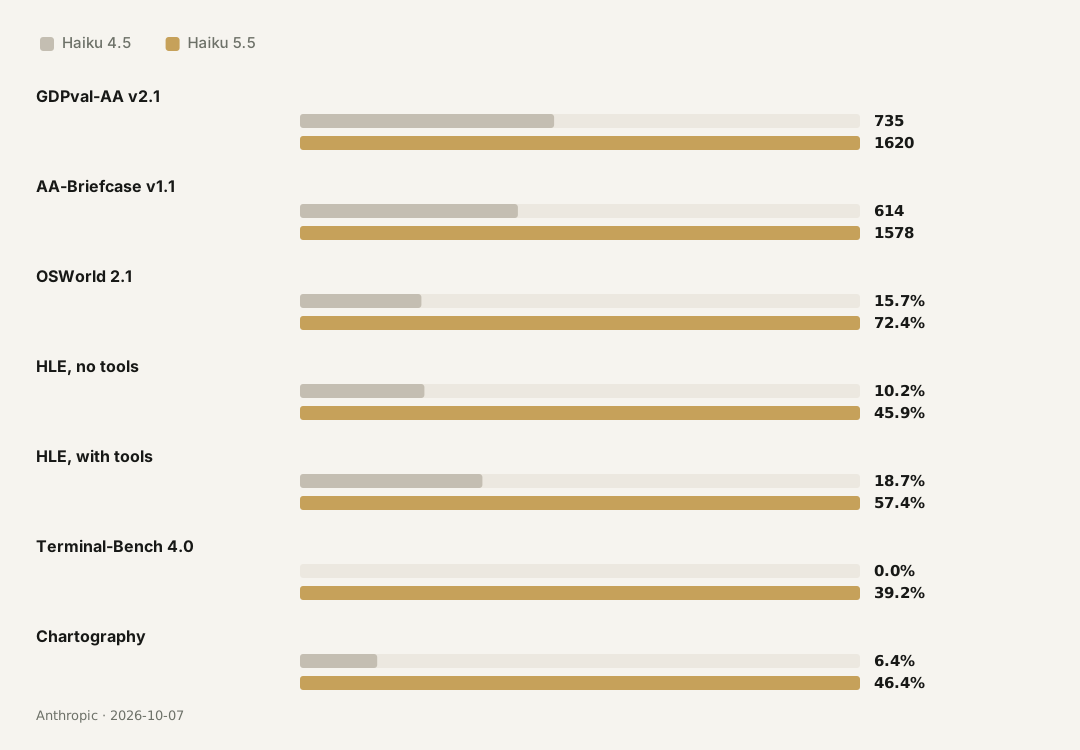
Não é uma mudança do tipo “as respostas ficaram mais bem escritas”. O OSWorld e o Terminal-Bench envolvem longas cadeias de ações. O modelo precisa entender a tarefa, chamar ferramentas, lidar com o retorno e seguir em frente depois de errar no meio do caminho. O ganho nesses testes mostra que o Haiku 5.5 já não é só um modelo para classificações e resumos curtos.
O OSWorld é o exemplo mais nítido. Há uma ruptura clara entre os 15,7% do Haiku 4.5 e os 72,4% do Haiku 5.5. Mesmo levando em conta a configuração do benchmark, o subconjunto offline e as condições de teste da Anthropic, o resultado ainda indica que o uso de computador avançou uma geração inteira.
Um ganho em um item não significa que todas as tarefas de produção melhoraram na mesma proporção. Um benchmark mede um conjunto específico de tarefas. Um produto real também depende do tamanho do contexto, de como as ferramentas são definidas, da recuperação de erros, da latência de rede e da qualidade dos dados do negócio.
Mudança dois: ele entrou na faixa do GPT-6 Luna
Nos itens que a Anthropic publicou, o Haiku 5.5 marca mais que o GPT-6 Luna:
- GDPval-AA: 1620 contra 1437;
- AA-Briefcase: 1578 contra 1336;
- OSWorld: 72,4% contra 48,9%;
- Terminal-Bench: 39,2% contra 16,4%;
- Chartography: 46,4% contra 29,1%.
Esse conjunto basta para uma afirmação cautelosa: o Haiku 5.5 entrou na faixa em que disputam os principais modelos de alto custo-benefício.
Mas duas ressalvas precisam acompanhá-la.
Primeiro, os números vêm do anúncio da Anthropic. Empresas diferentes não rodam um benchmark, configuram um modelo, conectam ferramentas ou calculam uma estatística da mesma forma. A tabela é um bom jeito de ver onde o fabricante posiciona o produto. Não é um ranking de terceiros totalmente independente e totalmente simétrico.
Segundo, “acima do GPT-6 Luna” não quer dizer “melhor que o GPT-6 Luna em todas as tarefas”. A tabela oficial sustenta uma comparação dos itens publicados. Ela não autoriza estender o resultado a tarefas que não foram testadas.
Uma forma justa de dizer isso é:
Nos itens de comparação que a Anthropic publicou, o Haiku 5.5 registrou pontuações mais altas que o GPT-6 Luna. Uma escolha real ainda precisa pesar a tarefa, o preço, a velocidade e a forma como o modelo é chamado.
Mudança três: ele está perto do Sonnet, mas os níveis de modelo continuam lá
A distância entre o Haiku 5.5 e o Sonnet 5.5 também diz muita coisa.
No GDPval-AA v2.1, o Haiku 5.5 marca 1620 e o Sonnet 5.5, 1840. No AA-Briefcase, as duas pontuações são 1578 e 1824. No OSWorld, o Haiku 5.5 tem 72,4% e o Sonnet 5.5, 83,9%. No Humanity’s Last Exam sem ferramentas, os números são 45,9% e 56,9%. Com ferramentas, 57,4% e 64,5%.
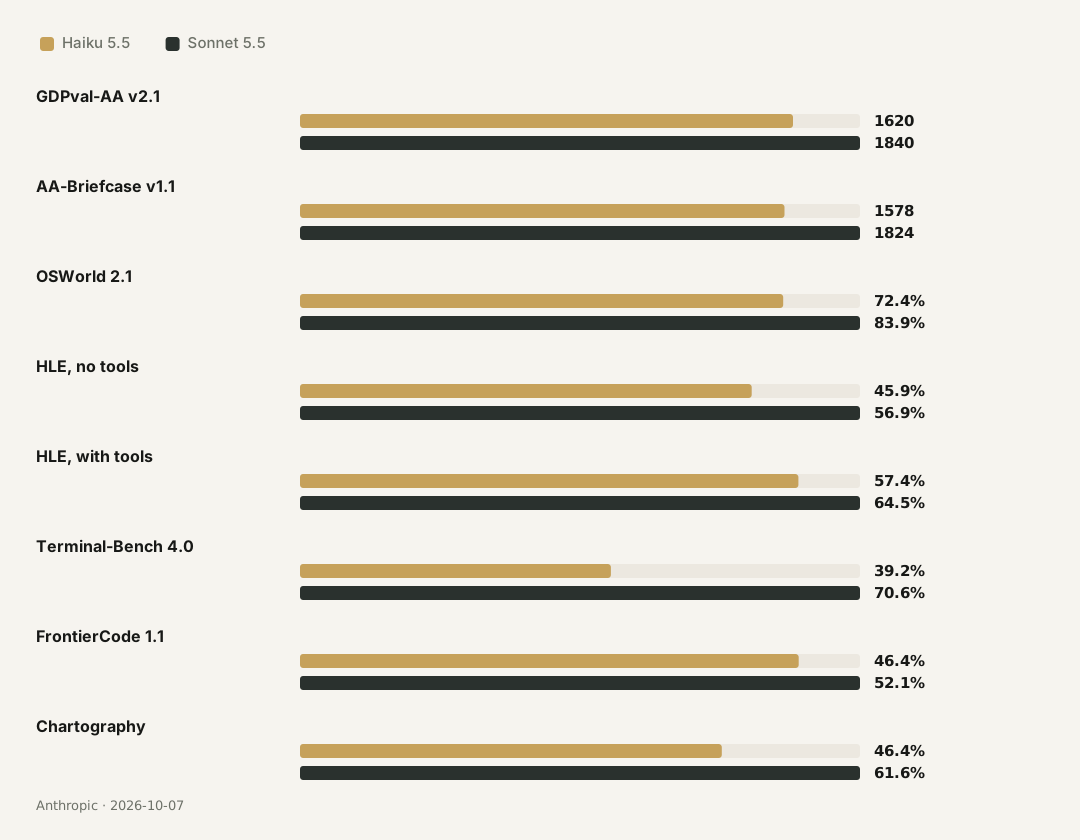
Essas diferenças mostram que o Haiku 5.5 já dá conta de uma parcela real do trabalho de conhecimento e do uso de computador. À medida que o trabalho fica mais complexo, o Sonnet 5.5 ainda mantém uma vantagem consistente.
A diferença que merece atenção é a do Terminal-Bench. O Haiku 5.5 tem 39,2%; o Sonnet 5.5, 70,6%. O benchmark pede que o modelo conclua tarefas profissionais complexas e de várias etapas em um ambiente de linha de comando, algo próximo da programação agêntica de longa duração. Aqui o Haiku 5.5 está muito acima do Haiku 4.5, mas ainda bem longe do Sonnet 5.5.
Isso dá à escolha de modelo um limite claro:
- para trabalho localizado, repetitivo e verificável, o Haiku 5.5 é atraente;
- para trabalho que exige planejamento de longo prazo, edições em vários arquivos e recuperação repetida de erros, o Sonnet 5.5 ainda é mais adequado;
- uma pontuação próxima em alguns benchmarks não é motivo para tratar os dois como versões de preço diferentes do mesmo modelo.
Depois do corte de preço, o número a observar é o custo por tarefa
O preço é o outro foco deste lançamento.
Para uma requisição de até 100 mil tokens, o Haiku 5.5 cobra US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de tokens de saída. Acima de 100 mil tokens, esses preços passam para US$ 0,50 e US$ 2,50. A Anthropic afirma que o custo médio de execução do Haiku 5.5 é cerca de 75% menor que o do Haiku 4.5.
| Tamanho da requisição | Preço de entrada | Preço de saída | Leitura de cache |
|---|---|---|---|
| Até 100K tokens | US$ 0,10 / MTok | US$ 0,50 / MTok | US$ 0,01 / MTok |
| Acima de 100K tokens | US$ 0,50 / MTok | US$ 2,50 / MTok | US$ 0,05 / MTok |
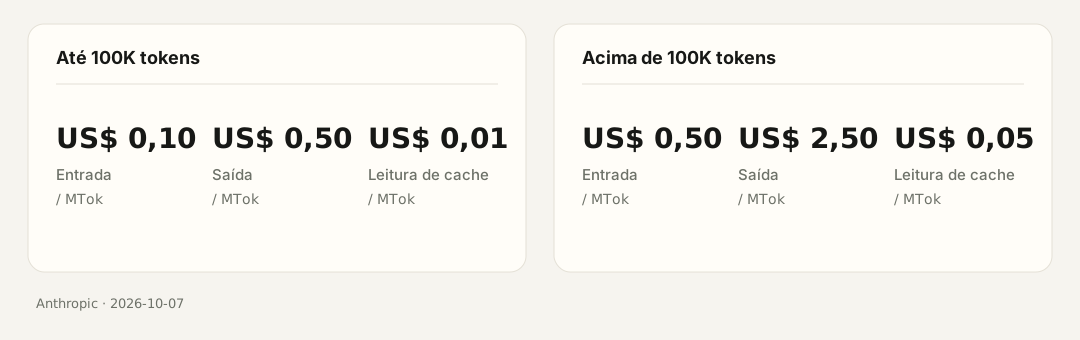
À primeira vista, a entrada dentro de 100 mil tokens cai de US$ 1 no Haiku 4.5 para US$ 0,10, e a saída cai de US$ 5 para US$ 0,50 — um corte de 90% no preço unitário de tabela. A Anthropic também diz que o Haiku 5.5 usa um tokenizador mais novo, então a mesma tarefa pode consumir um pouco mais de tokens. A queda no custo médio de execução é de cerca de 75%, e não de 90% cravados.
Um produto real ainda precisa responder a mais três perguntas:
- Com que frequência o Haiku 5.5 conclui a tarefa na primeira chamada?
- Quantas novas tentativas uma falha exige?
- O resultado ainda precisa passar pelo Sonnet ou pelo Opus para revisão e correção?
A medida mais útil é:
Custo por tarefa bem-sucedida
= gasto total para concluir o trabalho ÷ número de tarefas concluídas com sucesso
Suponha que uma chamada ao Haiku 5.5 custe um décimo de uma chamada ao Sonnet, mas que a tarefa precise de duas novas tentativas, ou que 20% das requisições acabem escaladas para o Sonnet. Nesse caso, a economia é menor do que a diferença na tabela de preços.
O inverso também vale: se uma tarefa pode ser verificada automaticamente e uma falha pode ser repetida a baixo custo, o Haiku 5.5 pode ter uma vantagem econômica muito forte.
Acima de 100 mil tokens, a fronteira de preço muda a arquitetura do produto
Na tabela de preços do Haiku 5.5, 100 mil tokens é uma linha divisória de verdade.
Em requisições curtas e médias, o preço baixo aparece com facilidade. Repositórios de código, conversas longas, bases de conhecimento corporativas e grandes conjuntos de documentos costumam chegar perto ou passar de 100 mil tokens. Colocar tudo isso em uma única requisição não é automaticamente o melhor desenho.
Uma arquitetura mais sensata costuma fazer cinco coisas:
- usar primeiro o Haiku 5.5 para classificar documentos e filtrar por relevância;
- comprimir o material bruto em um resumo estruturado;
- enviar a um modelo maior apenas os trechos que importam para a pergunta atual;
- colocar em cache o contexto repetido;
- guardar uma conversa de vários turnos como um estado que pode ser recuperado, em vez de reenviar a conversa inteira toda vez.
É também aqui que o Haiku 5.5 fica mais perto de uma arquitetura de agentes. Ele não é só um modelo barato para respostas: também pode ser a camada de base para compactação de contexto, organização de resultados de busca e execução de subtarefas.
Com o ajuste de esforço, um ranking estático já não basta
O Haiku 5.5 é o primeiro modelo Haiku com nível de esforço (effort) ajustável. Com o mesmo modelo, um sistema pode gastar mais ou menos em raciocínio conforme a importância da tarefa e escolher entre qualidade, latência e custo.
Isso muda a forma de ler um benchmark. Uma pontuação única diz como o modelo se comportou em uma configuração. Uma curva de custo–qualidade diz como ele se comporta com orçamentos diferentes.
Tarefas mais simples podem ficar em um esforço menor:
- classificação;
- conversão de formato;
- extração de campos fixos;
- reescrita de um texto curto.
Tarefas intermediárias podem receber um esforço maior:
- resumo de um documento longo;
- consolidação de informações de vários parágrafos;
- trabalho de várias etapas em um navegador;
- tarefas que precisam primeiro julgar e depois chamar uma ferramenta.
Aumentar o esforço em uma tarefa difícil não substitui automaticamente o Sonnet. A diferença no Terminal-Bench é o lembrete. Um orçamento maior de raciocínio pode melhorar o resultado, mas não apaga uma diferença em planejamento de longo prazo, recuperação de erros e cadeias complicadas de ferramentas.
Transforme os números em uma tabela prática de roteamento
Juntando as pontuações oficiais e o posicionamento do produto, dá para montar uma primeira tabela de roteamento, ainda cautelosa:
| Tarefa | Escolha padrão | Por quê |
|---|---|---|
| Classificação, roteamento, rótulos | Haiku 5.5 | Alto volume, formato de saída claro e fácil de verificar |
| Extração de campos e limpeza de dados | Haiku 5.5 | O escopo da tarefa é explícito e o trabalho se presta a alta concorrência |
| Resumos e compactação de contexto | Haiku 5.5 | A vantagem de preço e velocidade é grande |
| Fluxos de navegador curtos ou de uma etapa | Haiku 5.5 | A pontuação no OSWorld mostra um ganho claro no uso de computador |
| Explicação de código comum e pequenas correções | Haiku 5.5 ou Sonnet 5.5 | Depende de testes automáticos e do custo de um erro |
| Edições em muitos arquivos | Sonnet 5.5 | O Terminal-Bench ainda mostra uma diferença clara |
| Programação agêntica de longa duração | Sonnet 5.5 ou Opus 5.5 | Exige planejamento contínuo e recuperação de erros |
| Revisão final e decisões de alto risco | Sonnet 5.5 ou Opus 5.5 | Exige mais estabilidade e raciocínio mais forte |
Esta tabela não é uma definição permanente de “onde o Haiku 5.5 para”. É um primeiro conjunto de sugestões que surge ao reunir os benchmarks oficiais, o preço e o papel do produto.
Uma implantação real ainda precisa verificar o trabalho com suas próprias tarefas:
- A saída atende ao padrão do negócio?
- Uma falha pode ser detectada automaticamente?
- Depois de uma falha, vale a pena pagar por uma nova tentativa?
- A latência menor realmente melhora o produto?
- O preço baixo acaba consumido por um custo maior de revisão humana?
Como ler um benchmark oficial
Com os benchmarks de um modelo novo, é fácil cometer dois erros.
O primeiro é condensar todos os itens em uma única posição geral. Trabalho de conhecimento, uso de computador, raciocínio aberto e programação agêntica são habilidades diferentes. Um total único não consegue representá-las.
O segundo é tratar uma pontuação oficial como uma conclusão sobre produção. Um benchmark oficial tem uma configuração de teste declarada. Um produto real também é afetado pelo prompt, pelas ferramentas, pelo contexto, pela rede, pelos dados e pelo mecanismo de recuperação de erros.
Uma leitura mais confiável tem três passos.
Comece pelo salto de capacidade
O Haiku 5.5 melhorou de forma consistente em relação ao Haiku 4.5? Pela tabela oficial, sim. A mudança aparece sobretudo no OSWorld, no trabalho de conhecimento e nos itens de programação agêntica.
Depois, olhe para o limite das tarefas
Ele alcançou o modelo maior? Depende da tarefa. Em parte do trabalho de conhecimento e no uso de computador, já está perto do Sonnet. Em programação agêntica complexa, a diferença ainda é clara.
Termine pelo custo unitário
Se vale a pena usá-lo depende de qualidade, preço, latência e recuperação de falhas em conjunto. Uma pontuação de benchmark sozinha não diz se um produto deve trocar de modelo.
O veredito final: o Haiku 5.5 é forte porque pode ser usado em volume
Se a única pergunta é se o Haiku 5.5 supera o Sonnet 5.5, a resposta é simples: não. Os dados oficiais já mostram o Sonnet 5.5 ainda à frente em trabalho de conhecimento, uso de computador, raciocínio geral e programação agêntica.
Se a única pergunta é se o Haiku 5.5 é mais forte que o Haiku 4.5, a resposta é igualmente clara: é, e o ganho é grande.
A pergunta que vale a discussão é a terceira. Ele já é forte o bastante para assumir uma grande quantidade de trabalho localizado dentro de sistemas em produção?
Pelas pontuações oficiais e pelo preço, a resposta provável é sim.
O valor do Haiku 5.5 está em que um lote de tarefas que antes precisava de um modelo de porte médio, mas não justificava o preço de um modelo de porte médio, agora pode ficar em uma camada de execução mais rápida e mais barata. Classificação, extração, resumos, compactação de contexto, fluxos curtos de navegador e subtarefas de agentes podem virar seu palco principal.
Este não é um novo boletim de “campeão do ranking de modelos”. É um boletim sobre a divisão do trabalho:
- o Haiku 4.5 mostrou que um modelo pequeno consegue fazer trabalho simples a baixo custo;
- o Haiku 5.5 começa a mostrar que um modelo pequeno também pode assumir parte do trabalho que exige ferramentas e mais de uma etapa;
- o Sonnet 5.5 continua cuidando do planejamento, da programação e do trabalho de conhecimento mais complexos;
- o Opus 5.5 continua cuidando das tarefas longas e de alta dificuldade em que um erro sai caro.
O foco da avaliação de modelos também está mudando: de “quem tem a maior pontuação” para “quem mais vale a pena chamar para cada tarefa”.


