O Folkbench lançou a detecção de degradação de modelos no Monitor de Integridade. Rankings tradicionais medem o limite máximo de um modelo em ambiente oficial, enquanto diretórios comuns de relays se restringem a preços anunciados, disponibilidade HTTP e latência. Nenhum dos dois responde à pergunta operacional decisiva: quando um modelo é servido por um relay de API de terceiros, sua profundidade de raciocínio, adesão a restrições e identidade permanecem consistentes com a API oficial direta?
Para preencher essa lacuna, o Folkbench integra um conjunto automatizado de sondas em duas dimensões—atualidade e impressão digital do modelo (model fingerprint)—calibrado continuamente por chaves API oficiais diretas independentes nas mesmas janelas de medição. Ao ancorar o comportamento dos relays em uma linha de base oficial ao vivo, desvios ocultos passam a gerar sinais públicos verificáveis.
Principais pilares da novidade:
- Sondas em duas dimensões: Une sondas dinâmicas de atualidade a sondas de impressão digital que acompanham hábitos de raciocínio, alocação de tokens e telemetria da API, barrando cache estático e imitação superficial.
- Calibração oficial independente: Executa exatamente as mesmas sondas com chaves API oficiais diretas isoladas na mesma janela, separando atualizações do provedor oficial de desvios específicos do relay.
- Granularidade por modelo e grupo de serviço: Registra concordância de sondas, tokens de entrada, tokens de raciocínio, impressões digitais e checagens de cache disponíveis por modelo e grupo específico.
- Fluxo completo da medição à troca: Integra o Monitor de Integridade aos quatro rankings públicos do Folkbench, ao comparador lado a lado e ao cliente desktop open-source Folkbench Switch.
Por que rankings convencionais e monitores de uptime não enxergam a degradação
Em uma arquitetura intermediada, o relay fica entre quem chama a API e o laboratório criador do modelo. Sob pressão de custo ou picos de tráfego, essa camada pode introduzir três formas de degradação invisíveis para métricas de rede comuns:
- Substituição silenciosa de modelo: O cliente solicita um modelo de ponta, mas em horários de pico ou prompts longos a chamada vai para um modelo menor mais barato ou uma versão antiga.
- Corte no orçamento de raciocínio: O nome do modelo permanece, porém o esforço de raciocínio é reduzido ou as etapas internas são interrompidas cedo demais.
- Corte de contexto ou alteração de limites: Turnos anteriores são descartados ou o limite de saída é comprimido para poupar tokens, gerando esquecimentos em tarefas longas.
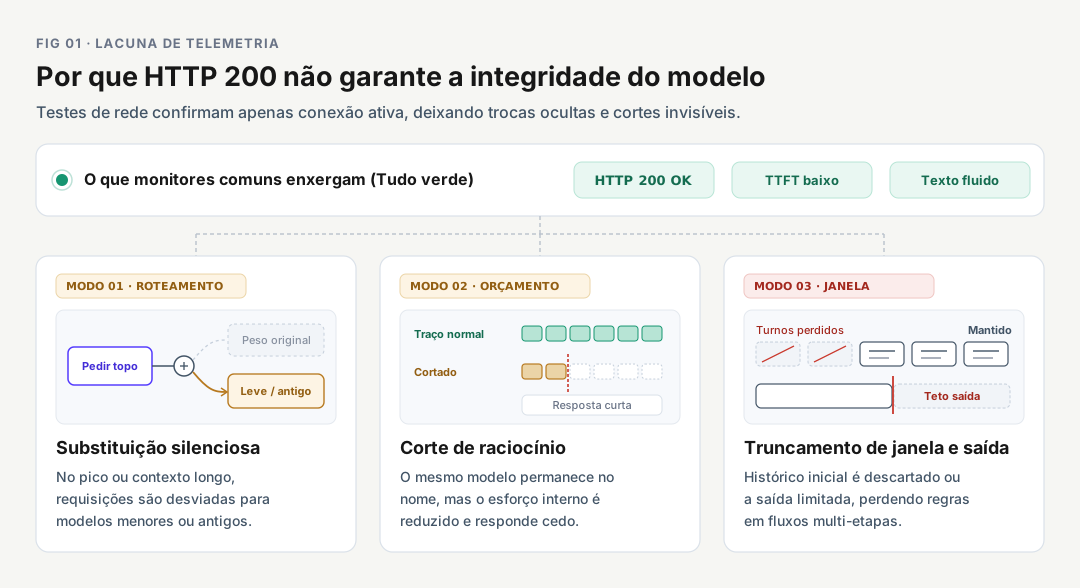
Figura 1: Conectividade verde na superfície (`HTTP 200`, resposta rápida e texto curto fluido) não garante entrega íntegra. Substituição de pesos, corte no orçamento de raciocínio e limitação de contexto ocorrem fora do alcance de monitores de uptime.
Em todos esses cenários, a conectividade aparente continua intacta: o endpoint retorna HTTP 200, conversas curtas parecem fluídas e respostas apressadas até reduzem a latência média. Ao mesmo tempo, a aleatoriedade natural de amostragem explica falhas isoladas—como analisado em [O modelo ficou mesmo mais burro?](/pt/blog/did-the-model-get-dumber/), um print isolado não distingue ruído estatístico de degradação sistêmica.
Por que verificações manuais simples falham diante de roteamento moderno
Diante da suspeita de perda de desempenho, dois testes manuais comuns acabam neutralizados pelo roteamento moderno de gateways:
- Perguntar qual é o modelo: Um modelo não enxerga a infraestrutura de proxy à sua frente. Basta uma instrução de sistema ou resposta memorizada para declarar qualquer nome comercial.
- Repetir enigmas clássicos: Problemas populares já estão presentes nos dados de treino até de modelos compactos. Além disso, prompts fixos repetidos permitem resposta via cache estático ou liberação seletiva de prompts conhecidos para rotas íntegras.
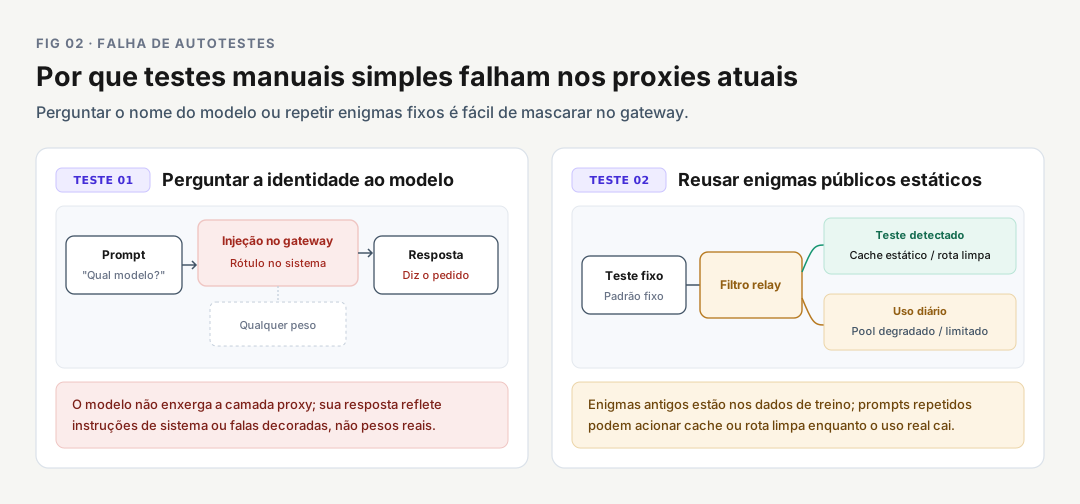
Figura 2: Como dois autotestes comuns são contornados. À esquerda, o prompt de sistema injetado pelo gateway força qualquer identidade sobre pesos menores. À direita, filtros reconhecem testes estáticos repetidos e respondem via cache estático ou rota limpa enquanto degradam o tráfego real.
Arquitetura de sondas duplas: compreensão atual e impressão digital do modelo
Para identificar desvios ocultos com precisão, o Folkbench combina duas dimensões complementares de sondagem executadas simultaneamente em cada janela:
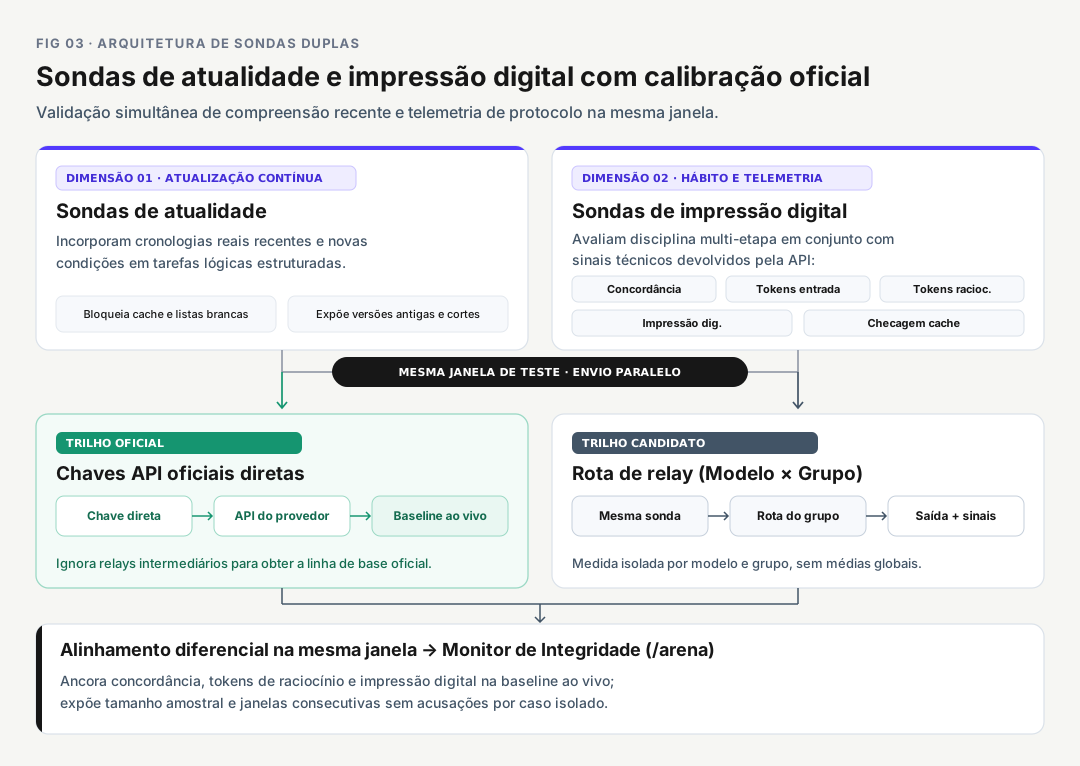
Figura 3: Arquitetura paralela na mesma janela. Sondas de atualidade bloqueiam respostas em cache, enquanto sondas de impressão digital medem concordância, tokens de entrada, tokens de raciocínio, impressão digital e checagens de cache em contraste com chaves oficiais diretas isoladas.
1. Sondas de atualidade: bloqueio a cache estático e versões defasadas
As sondas de atualidade incorporam eventos recentes, linhas do tempo atuais e restrições dinâmicas que acompanham o calendário real. Como o contexto muda continuamente, intermediários não conseguem precomputar respostas estáticas; ao mesmo tempo, quando a tarefa exige ordenar fatos recentes e cruzar novas condições, snapshots antigos falham no limite temporal de conhecimento e modelos muito comprimidos perdem precisão em restrições múltiplas.
2. Sondas de impressão digital: hábitos de execução e telemetria de tokens
Se um relay substitui o modelo por um alternativo competente ou corta metade do raciocínio do modelo correto, olhar apenas certo/errado em perguntas simples não basta. As sondas de impressão digital monitoram padrões comportamentais sob regras rígidas de formato e raciocínio multipasso junto com telemetria da API: concordância de sondas, tokens de entrada, tokens de raciocínio, impressão digital e checagens de cache quando disponíveis. Quando o esforço de raciocínio é reduzido nos bastidores, o texto pode parecer polido enquanto tokens de raciocínio e concordância caem em conjunto.
Calibração por chaves API oficiais diretas independentes
Sem referência simultânea, uma queda de pontuação em um relay gera dúvida: houve degradação do intermediário ou alteração no próprio provedor oficial? Para eliminar essa ambiguidade, o Folkbench executa exatamente as mesmas sondas com chaves API oficiais diretas independentes nas mesmas janelas, sem passar por nenhum relay.
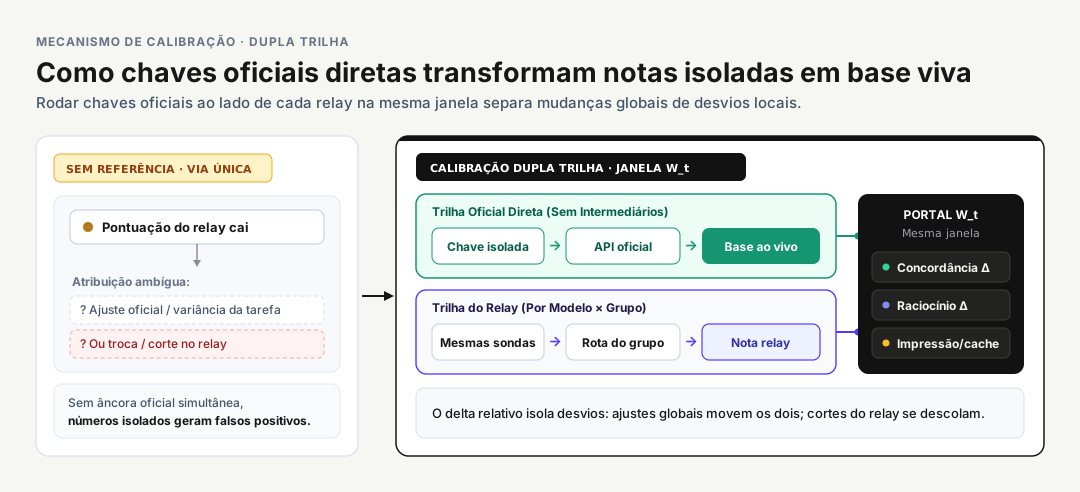
Mecanismo de calibração: Sem referência oficial simultânea (esquerda), uma queda não separa mudanças do provedor de cortes no relay. A calibração em dupla trilha (direita) executa chaves oficiais isoladas ao lado de cada rota `modelo × grupo` na mesma janela `W_t`.
| Situação observada | Monitoramento sem calibração | Calibração com chaves oficiais diretas independentes |
|---|---|---|
| Oscilação ou ajuste do modelo oficial | Risco de atribuir ao relay mudança do provedor | A linha oficial acompanha o movimento e isola o ruído global |
| Base oficial estável e queda no relay | Falta referência simultânea para validar magnitude | Concordância e tokens de raciocínio divergem claramente da base oficial |
| Grupos diferentes divergem no mesmo relay | Um grupo rápido mascara cortes em grupos baratos | Cada rota modelo × grupo é comparada separadamente contra a base |
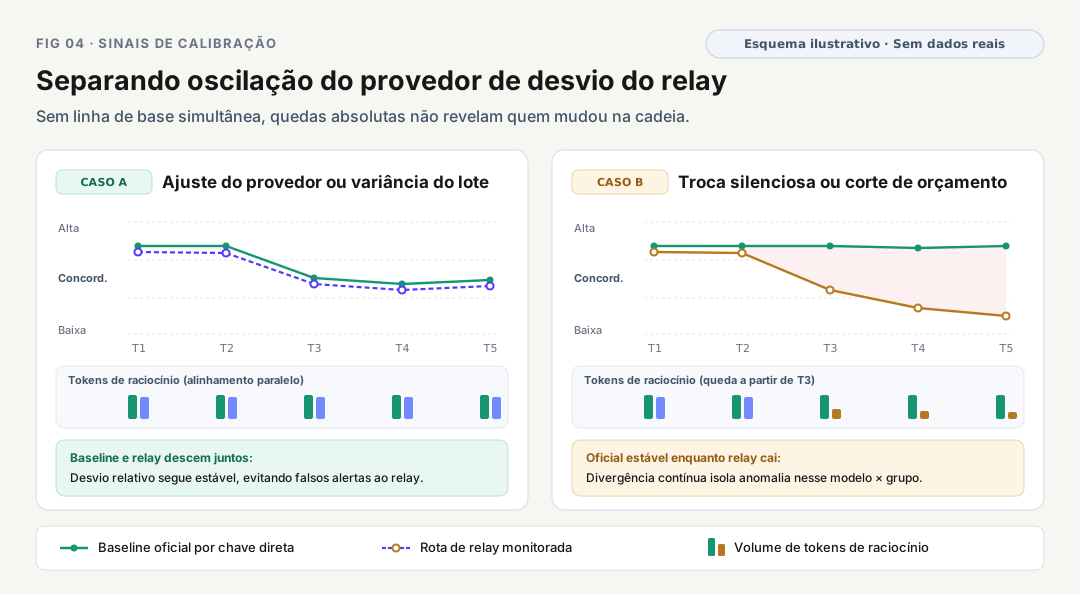
Figura 4 (esquema ilustrativo, não são dados reais medidos): Como a base oficial direta separa variação do provedor oficial (Caso A, deslocamento paralelo a partir de `T3`) de degradação própria de uma rota `modelo × grupo` (Caso B, linha oficial estável enquanto concordância e tokens de raciocínio recuam).
Seguindo os limites indicados no [Monitor de Integridade](/pt/arena), uma única resposta ou porcentagem isolada não comprova troca de modelo. Amostra, janelas consecutivas e distribuição de tokens devem ser lidos juntos como sinal objetivo de alerta antecipado.
O que diferencia o Folkbench dos portais convencionais
A maioria dos portais de IA mede apenas tetos teóricos em datasets fixos ou se limita a preço e ping HTTP. O Folkbench fecha essa distância com uma cadeia completa em quatro camadas:
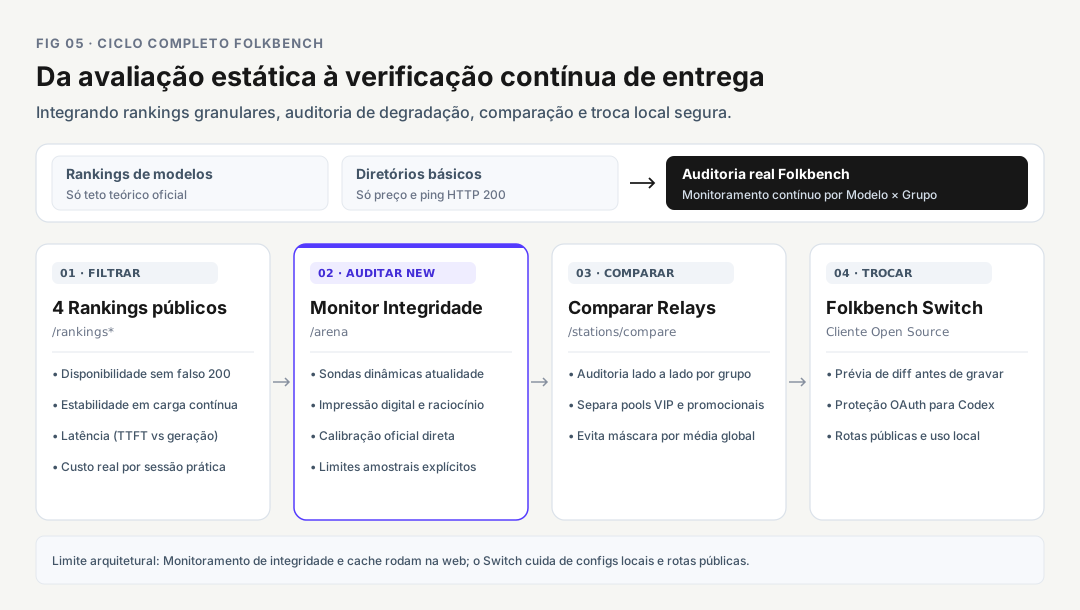
Figura 5: Do ranking estático à verificação contínua de entrega. O ciclo une seleção por grupo (`/rankings), auditoria calibrada (/arena), comparação exata (/stations/compare) e troca local segura (Folkbench Switch`); o monitoramento de integridade e cache opera continuamente na plataforma web.*
- Medição por modelo e grupo exato: Separa grupos promocionais de grupos "chave oficial / estável" em vez de resumir um provedor inteiro em uma nota genérica.
- Quatro rankings públicos dedicados: [Disponibilidade](/pt/rankings) (descarta falsos
200e cortes de stream), [Estabilidade](/pt/rankings/stability) (tarefas longas e horários de pico), [Latência](/pt/rankings/latency) (TTFT separado da taxa de geração) e [Custo por sessão](/pt/rankings/cost) (gasto real de trabalho). - [Monitor de Integridade](/pt/arena) e [Comparar relays](/pt/stations/compare) abertos: Telemetria calibrada e comparação lado a lado sem exigir várias chaves próprias.
- Cliente open-source [Folkbench Switch](https://github.com/Folkbench/folkbench/releases): App em Tauri + Rust (macOS
.dmge Windows.exe) para Claude Code, Codex, Gemini CLI, Aider, OpenCode e Kimi CLI com pré-visualização de diff, proteção de credenciais OAuth do Codex e estimativa local de consumo. (Monitoramento de integridade e cache permanecem recursos contínuos da plataforma web.)
Como usar esses sinais na escolha de rotas
- Selecione grupos candidatos em [Disponibilidade](/pt/rankings), [Estabilidade](/pt/rankings/stability), [Latência](/pt/rankings/latency) e [Custo por sessão](/pt/rankings/cost).
- Verifique no [Monitor de Integridade](/pt/arena) o alinhamento de sondas, tokens de raciocínio e impressão digital com a linha oficial ao longo de janelas consecutivas.
- Confirme exatamente o grupo desejado em [Comparar relays](/pt/stations/compare) antes de recarregar saldo.
- Mantenha rota principal e reserva no Folkbench Switch para alternar com segurança em segundos após revisar o diff.
Avaliar infraestrutura de IA hoje significa conferir não apenas o modelo no papel, mas se cada rota entrega o desempenho prometido. Com sondas de atualidade, impressão digital e calibração oficial independente, o Folkbench estabelece uma régua pública verificável para escolher rotas de API.