Uma falha pode provar que um modelo errou. Sozinha, ela não prova que o modelo erra mais do que antes.
“Esse modelo ficou mais burro de novo?” Um pelicano com um pé pendurado fora do pedal, uma bicicleta com o quadro retorcido feito um nó, ao lado de um print que na semana passada parecia bem bom: é o que basta para a pergunta aparecer.
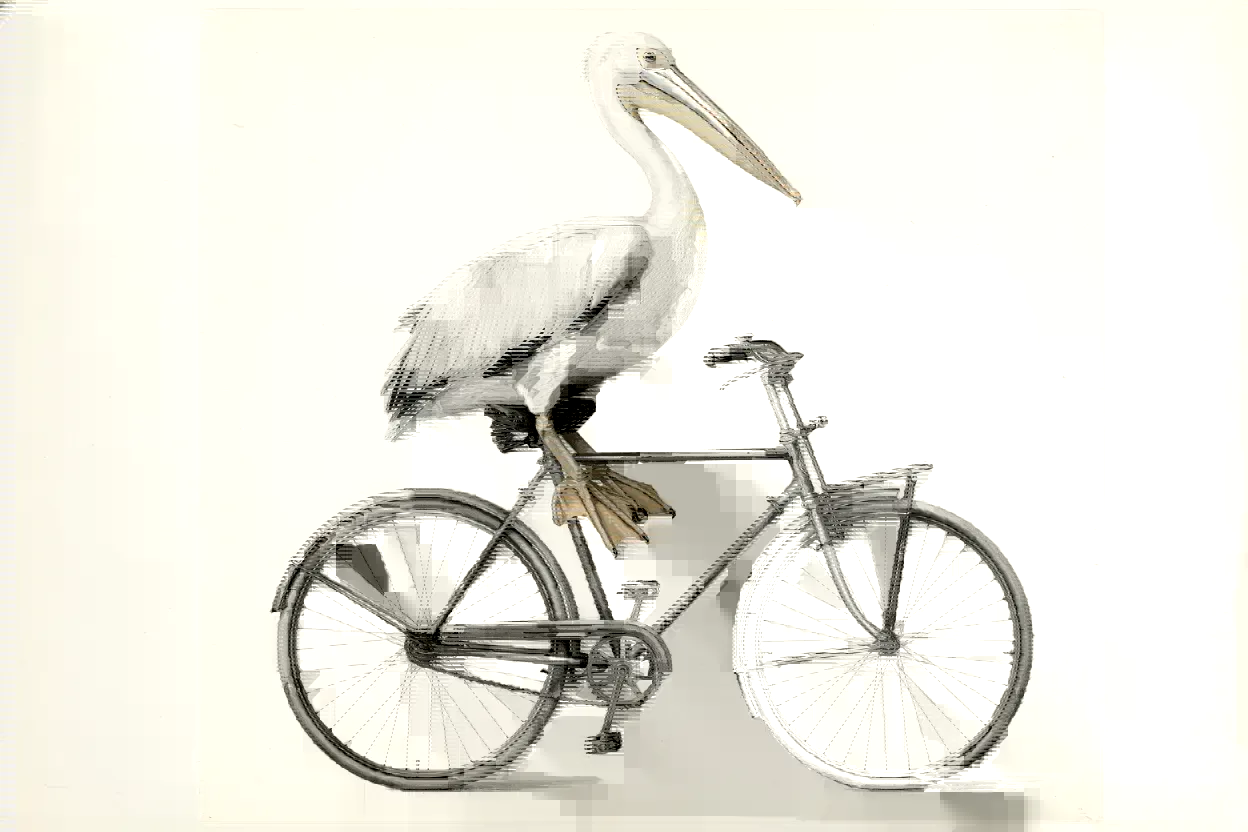
Essa desconfiança não deve ser despachada com um “modelos são aleatórios”. Alguém pagou por uma tarefa que o serviço costumava cumprir, e agora ele não cumpre. Isso merece ser questionado. Dois prints, porém, não bastam para mostrar que o modelo foi trocado, que o orçamento de raciocínio foi cortado ou que determinado serviço foi “batizado”.
Há um tempo, rodei o teste do pelicano dezenas de vezes. O que torna essa tarefa útil é que muitos dos erros ficam desenhados à vista. Código que roda não significa que a bicicleta esteja estruturalmente correta. Pássaro e bicicleta presentes não significam que o pé esteja de fato no pedal. Essas relações espaciais são mais fáceis de pegar a olho do que uma resposta fluente que ainda pode esconder um furo lógico. Quanto mais rodadas eu guardava, mais claro ficava outro ponto: muitas vezes julgamos um serviço inteiro por um único trabalho.
Este artigo não está aqui para defender nenhum modelo, nem ensina a desmascarar um “modelo falso” a partir de alguns traços superficiais. A pergunta que me interessa é mais estreita: quando suspeitamos que um modelo piorou, como transformar essa sensação em evidências que outra pessoa possa conferir?
Observação: os serviços A e B a seguir, e todos os números de teste ligados a eles, são exemplos didáticos. Eles não se referem a nenhum serviço real e não são medições nem rankings do Folkbench.
1. Primeiro, separe a pergunta: o que você quer dizer com “mais burro”?
“Ficou mais burro” é uma expressão prática, e ela embrulha várias perguntas diferentes numa só. A camada mais direta é: esta resposta específica está errada. O pelicano ganhou uma perna a mais, o pé errou o pedal ou as rodas se soltaram do quadro. Cada uma dessas é uma falha concreta que dá para verificar. Uma amostra basta para provar que “esse tipo de erro aconteceu” e para derrubar a promessa de que “ele nunca cometeria esse tipo de erro”. A segunda camada é: nas mesmas condições, ou em condições próximas o bastante, este serviço falha com mais frequência.
Aí já não se trata de saber se o erro existe, e sim de com que frequência ele aparece. A parte de “a experiência piorou” que mais vale medir é a passagem de “normalmente dava certo” para “normalmente não dá”. A terceira camada é: a mudança foi causada por uma alteração no próprio modelo ou na configuração do lado do servidor. Isso já é uma afirmação sobre causa. O mesmo resultado ruim pode vir de explicações diferentes: parâmetros de requisição diferentes, contexto diferente, uma saída truncada ou uma mudança real no modelo subjacente e nas configurações de inferência. Só de olhar o resultado, em geral não dá para apontar uma única dessas explicações.
Por isso, “esta saiu errada”, “este serviço é menos confiável” e “este serviço trocou o modelo às escondidas” não pedem evidências da mesma força. Perceber essa diferença não torna mais difícil o usuário reclamar. Faz o contrário. Nomear a pergunta com clareza impede que quem oferece o serviço explique toda falha como “aleatoriedade”, e impede que quem avalia explique toda diferença como “trocaram o modelo”.
2. Você está olhando para um trabalho ou para uma distribuição de saídas?
Numa configuração de geração com amostragem aleatória, a mesma entrada pode produzir saídas diferentes. Mesmo usando algum controle pensado para melhorar a reprodutibilidade, “o mais consistente possível” não deve ser lido como “idêntico toda vez”. Uma nota técnica mais antiga da OpenAI dizia isso explicitamente: com a mesma seed, os mesmos parâmetros e a mesma impressão digital do backend, ainda não há garantia de que a saída seja idêntica. Isso é um limite da reprodutibilidade. Não significa que todo modelo hoje aceite os mesmos parâmetros.1
No teste do pelicano, o que normalmente queremos saber não é “ele consegue, de vez em quando, desenhar uma imagem boa?”. É “nas condições que eu especifiquei, se eu passar a tarefa mais uma vez, qual a chance de um resultado aprovado?”. Um exemplo simplificado mostra o problema de um único print. Suponha que a taxa real de aprovação de um serviço, por tentativa, seja de 80%, que cada geração seja independente e que o estado dele não mude durante o teste. A probabilidade de pelo menos uma falha em 20 tentativas seguidas é: 1 − 0.8²⁰ ≈ 98.85% Um serviço que costuma fazer bem o trabalho quase certamente vai deixar, em algum ponto dessas 20 tentativas, uma falha digna de print.
Agora inverta. Suponha que a taxa real de aprovação de outro serviço, por tentativa, seja de apenas 40%. Sob as mesmas premissas de independência e estabilidade, a probabilidade de pelo menos um resultado aprovado em 20 tentativas é: 1 − 0.6²⁰ ≈ 99.996% Ele também quase certamente vai produzir um trabalho para exibir. Esses dois cálculos não dizem que toda chamada real é independente, nem que as taxas reais de aprovação são exatamente esses números. Eles apontam para uma escolha: mostrar só a melhor tentativa facilita superestimar a confiabilidade, e mostrar só a pior facilita exagerar uma queda.
Por isso, o mesmo serviço pode aparecer num post que usa uma imagem como prova de que ele está com força total e em outro que usa uma imagem como prova de que ele ficou mais burro. Os dois prints podem ser reais. A inferência, não necessariamente. Há outra distinção fácil de pular. Acertar na primeira geração e gerar dez vezes para depois escolher o acerto não são a mesma capacidade. A segunda inclui chamadas extras, espera e o custo da seleção. Se for comparar dois fluxos de trabalho, dê aos dois o mesmo orçamento de tentativas. Não compare a primeira tentativa de A com a favorita de B escolhida a dedo.
3. Rodar 20 vezes basta para uma diferença ter significado estatístico?
Não. Vinte rodadas podem ser um orçamento experimental razoável. Não são um alvará estatístico. Pegue o mesmo exemplo concreto. O canal A roda 20 vezes e é aprovado em 16. O canal B roda 20 vezes e é aprovado em 8. Os dois usam a mesma tarefa fixa e a mesma regra de avaliação, e todas as amostras são mantidas.
| Canal | Aprovados / total | Taxa na amostra | Intervalo de Wilson de 95% para a taxa |
|---|---|---|---|
| A | 16 / 20 | 80% | 58,4%–91,9% |
| B | 8 / 20 | 40% | 21,9%–61,3% |
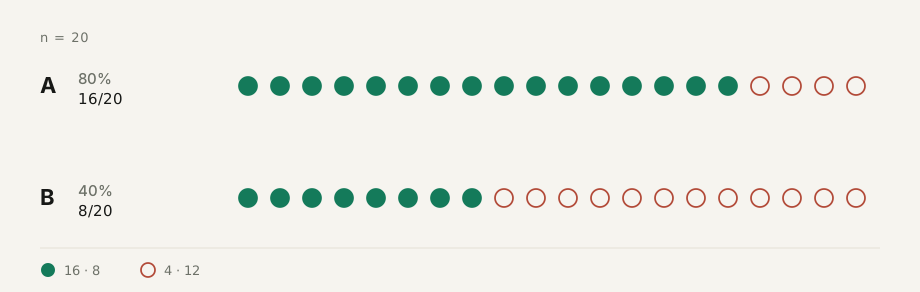
Os intervalos são intervalos de Wilson bilaterais de 95% para uma proporção binomial. Eles expressam a incerteza na estimativa da taxa de aprovação. Não são uma faixa de nota para a qualidade da imagem.2 A diferença na amostra é de 40 pontos percentuais. Com só 20 tentativas de cada lado, a estimativa ainda é grosseira. 80% e 40% não devem ser tratados como uma capacidade real medida com exatidão e que nunca vai mudar.
Se assumirmos ainda que as chamadas são independentes, que a probabilidade de aprovação de cada canal é estável dentro da janela e que essa comparação foi escolhida com antecedência, um teste exato de Fisher bilateral sobre as contagens de aprovados e reprovados dá p ≈ 0.0225. Com um nível de significância de 5% definido de antemão, este exemplo sustenta que “as taxas de aprovação diferem nessas condições”.3 Esse número não é “97,75% de chance de B ter sido batizado”, nem “97,75% de chance de A ser melhor para sempre”. Um valor-p é a probabilidade de obter dados tão extremos quanto esses, ou mais, sob a hipótese de que não há diferença e nas condições do teste. Não é a probabilidade de uma causa oculta.3
Não troque um teste da diferença por uma olhada para ver se os dois intervalos se sobrepõem. Cada intervalo estima uma taxa. O teste trata da diferença entre elas. Três limites importam mais do que decorar um teste. Olhe o tamanho da diferença e o tamanho da amostra juntos. 16 contra 8 não deve sustentar uma conclusão da mesma força que 16 contra 15. Quantas amostras você precisa depende de quão pequena é a diferença que você quer detectar e de quanto risco de errar o veredito você aceita. Não existe um “rode pelo menos tantas vezes” que sirva para toda tarefa.
Não encontrar uma diferença significativa não prova que os dois são iguais. Os dados podem simplesmente ser poucos demais, ou instáveis demais, para sustentar uma conclusão por enquanto. Para mostrar que uma diferença é pequena o bastante para ser ignorada, defina antes o que é “pequena o bastante”. Um resultado não significativo não é prova de equivalência. Uma diferença estatística não é, por si só, motivo para trocar de serviço. O usuário ainda precisa pesar o custo de uma falha, o preço de uma chamada, a latência e o custo de refazer o trabalho. Uma diferença pode ser real e ainda assim pequena demais para mudar a escolha. O papel da estatística aqui não é produzir um valor-p com cara de profissional. É impedir que a gente afirme mais do que as evidências aguentam.
4. Uma linha de base é um contrato experimental, não a frase “o prompt era o mesmo”
Muitas comparações falham antes de o tamanho da amostra virar problema: as amostras não eram comparáveis desde o início. Os dois lados recebem o pedido “desenhe um pelicano andando de bicicleta”. Uma chamada é uma requisição de API numa sessão nova. A outra é uma janela de chat com dezenas de turnos, com ferramentas ativadas. Um lado pode escrever uma saída longa. O outro bate num limite de tamanho no meio do caminho. Repetir isso cem vezes ainda não permite atribuir o resultado a uma diferença de capacidade do modelo.
A pesquisa sobre o padrão de avaliação OLMES aponta que escolhas de avaliação como o formato do prompt, os exemplos no contexto e a redação da tarefa mudam o desempenho medido. Uma comparação reproduzível precisa registrar essas configurações. As tarefas desse trabalho não são o SVG do pelicano, mas o alerta sobre a configuração experimental merece ser levado a sério.4 Eu trataria a linha de base como um contrato sobre “o que esta rodada está medindo de fato”.
O que está sendo comparado deve ser específico: o serviço, o grupo ou a rota, e a versão do modelo que você consegue de fato obter. Se tudo o que você tem é um alias de modelo que pode mudar com o tempo, registre o alias. Se não souber qual é o snapshot subjacente, escreva “desconhecido”. Não trate a string de modelo devolvida pela interface como verificação independente da identidade subjacente. Salve a entrada da forma mais completa possível. Isso vai além do prompt final: inclui o system prompt, o histórico, os anexos e as configurações de ferramentas que você consegue controlar e observar. Condições visíveis iguais não provam que as condições invisíveis também eram iguais.
Nas configurações de geração, registre o nível de raciocínio, o limite de saída e os parâmetros de amostragem que a interface realmente aceita. Escreva “não suportado” para um campo que a interface não oferece, e “desconhecido” para um campo que você não consegue confirmar que teve efeito. Não trate esses campos, sem avisar, como iguais. Não presuma que uma configuração chamada “high” signifique o mesmo orçamento de computação em dois modelos diferentes.
O ambiente de avaliação inclui a forma de renderizar e a forma de avaliar. Confira o mesmo SVG na mesma viewport e no mesmo renderizador. Numa tarefa de animação, use a janela de observação combinada. Não assista ao movimento inteiro de um lado para escolher um único quadro do outro. Se a tarefa não pediu animação, não tire pontos porque a saída é uma imagem estática. Por fim, escreva a regra de novas tentativas antes de o teste começar. Se uma primeira falha pode ser repetida, quantas vezes e se é permitido dar feedback são partes das condições do teste. Não são algo para improvisar depois que os resultados chegam.
Fixar essas coisas não é uma tentativa de construir um “modelo de laboratório” descolado do mundo real. Você pode perfeitamente comparar a experiência padrão de dois produtos de chat. A conclusão, então, deve ser “esses dois produtos entregam coisas diferentes nas configurações padrão”, e não “isolei quais pesos do modelo subjacente são melhores”. Uma condição que você não controla pode continuar desconhecida. Uma condição desconhecida não pode ser registrada como controlada.
5. Como você organiza o teste costuma importar mais do que simplesmente rodar mais vezes
Não amarre o canal ao horário
Rodar todo o A de manhã e depois todo o B tarde da noite mistura “uma diferença entre canais” com “uma diferença ao longo do tempo”. Mesmo que você veja uma diferença, é difícil dizer quanto dela depende daquela janela. Numa comparação lado a lado mais leve, eu intercalaria A e B dentro de uma janela escolhida de antemão, em ordem aleatória. Mantenha a concorrência o mais parecida possível. Não deixe um lado gerar uma resposta de cada vez enquanto o outro absorve uma rajada.
Dá para ir um passo além e dividir a janela em pequenos lotes, com A e B em todos eles. Além do resultado geral, você consegue ver se a diferença está concentrada num único lote. A ordem aleatória ajuda a reduzir a confusão com o efeito do tempo. Ela não elimina automaticamente a correlação que vem de um backend compartilhado, de uma queda breve ou de algo parecido.
Uma pergunta longitudinal, “está pior do que na semana passada?”, é diferente. O tempo é justamente a variável que você está estudando, então não dá para fixar os dois lados no mesmo momento. Mantenha a mesma tarefa central, a mesma configuração e a mesma regra de avaliação na medida do possível, e rode de novo um serviço de referência dentro de cada janela de observação. Não fique comparando para sempre os resultados de hoje com a melhor imagem da semana passada. Ao ler um resultado longitudinal, guarde tanto a taxa absoluta de aprovação quanto a diferença relativa. Se o serviço testado e a referência caem juntos, a diferença entre eles pode continuar igual. Isso não significa que a experiência do usuário não piorou. Uma referência não é uma verdade sempre correta e sempre estável.
Não decida quando parar enquanto olha os resultados
“Rode cinco vezes. Se A ganhar, poste. Se A não ganhar, continue até a diferença ficar significativa.” Isso parece acrescentar amostras. Na verdade, muda a regra estatística. Espiar um teste de amostra fixa repetidas vezes e parar por causa do que se viu quebra o controle de falsos positivos para o qual aquele teste foi feito. Um teste que precisa acompanhar os dados continuamente deve usar um método pensado para análise sequencial.5 A maioria das pessoas não precisa começar pela estatística sequencial. A prática mais fácil é anotar, antes da rodada, quantas execuções você vai fazer, qual métrica principal vai usar e quais comparações principais vai fazer. Depois, guarde todos os resultados.
Fazer algumas chamadas antes, para confirmar que a interface e o processo de avaliação funcionam, não tem problema. Essas são rodadas-piloto. Quando terminar de mexer no procedimento, comece o teste formal à parte. Não misture os resultados do ajuste da tarefa com os resultados formais. O mesmo vale para outros dois hábitos. Testar dezenas de tarefas e publicar só a que parece melhor, ou ver que a nota total ficou para trás e então declarar vitória num critério parcial, não é a comparação combinada de antemão.
Não trate cem repetições de uma tarefa como cem tarefas
A geração repetida diz o quanto o serviço é confiável nesta tarefa. Ela não amplia a conclusão automaticamente. Um pelicano que sai bem de forma consistente não significa, por si só, que depuração de código, análise de textos longos e cumprimento de instruções complexas sejam igualmente confiáveis. Ao fazer inferências sobre uma classe de tarefas, a variação entre tarefas e a variação entre repetições de uma mesma tarefa são dois tipos diferentes de incerteza. A pesquisa sobre avaliação distingue amostragem repetida, comparações no nível da tarefa e o tratamento de amostras agrupadas e dependentes.6
Por isso, eu usaria primeiro uma sonda para observar a repetibilidade e depois acrescentaria um pequeno conjunto de tarefas fixas ligadas ao uso real. Os dois lados respondem ao mesmo conjunto. Calcule o resultado em cada tarefa, e a diferença em cada tarefa, antes de agregar. Não apresente só uma nota total. Se fizer uma análise formal com várias tarefas, mantenha o pareamento por tarefa e por lote. Não dá para tratar “10 tarefas, 10 vezes cada” como “100 tarefas independentes” e reaproveitar o cálculo de tarefa única feito antes.
Há uma armadilha menor. Uma seed fixa é útil quando você está investigando um problema de reprodução. Copiar vinte vezes uma saída quase inalterada da mesma seed não equivale a vinte observações independentes da distribuição aleatória de saídas. Quando estiver medindo estabilidade, combine antes a estratégia de amostragem. Uma interface que aceita seeds pode usar várias seeds geradas de antemão. Numa interface que não aceita, registre essa limitação. Como um conjunto de tarefas deve ser atualizado a longo prazo é outra questão. Pelo menos dentro desta comparação, não troque as tarefas para depois ligar as notas antigas e novas numa curva de “o modelo está melhorando”.
6. Timeout, truncamento e desenho errado não vão para o mesmo saco
Uma distorção estatística comum é avaliar só os trabalhos que voltaram com sucesso e apagar timeouts e erros. A nota obtida responde a “depois de ter uma saída completa em mãos, com que frequência ela é aprovada?”. Ela não responde à pergunta que mais importa para o usuário: “se eu enviar uma requisição, recebo um resultado aprovado?”. Suponha que 20 requisições tenham sido programadas com antecedência e que 4 delas tenham dado timeout. As outras 16 devolveram um trabalho completo, e 8 delas foram aprovadas. A taxa de aprovação entre as saídas completas é de 50%. A taxa de primeira entrega aprovada, contada sobre as 20 requisições, é de 40%. Publicar só o primeiro número deixa de fora as quatro vezes em que o usuário não recebeu nada.
Eu manteria três tipos de resultado ao mesmo tempo: falha técnica de entrega, retorno completo que não cumpre a tarefa e retorno completo que cumpre a tarefa. Timeouts, erros de interface, streams interrompidos e limite de tamanho atingido devem manter, cada um, seu próprio motivo. Registrá-los separadamente não isenta o serviço da falha. Para quem está escolhendo um serviço, um timeout e um desenho errado custam tempo do mesmo jeito. Quando você está rastreando uma causa, porém, eles não devem ser descritos todos como “a inteligência do modelo caiu”. Uma falha na rede local ou no script de teste deve ser listada à parte. Excluí-la ou não exige uma regra escrita de antemão. Não dá para apagar uma amostra depois de ver qual lado perdeu.
Eu preferiria tornar a parcela de primeiras requisições que retornam um resultado aprovado a métrica principal, e manter ao lado, como explicação, a taxa de aprovação do conteúdo entre as saídas completas, a taxa de falha técnica, a latência e o custo. A taxa de aprovação do conteúdo nas saídas completas também não é uma nota não enviesada de “capacidade pura”. Se requisições complexas têm mais chance de dar timeout, os trabalhos que sobram podem ter sido mais fáceis desde o início. Essa taxa ajuda a localizar um problema. Ela não substitui o resultado contado sobre todas as requisições.
“Ele consegue acertar depois de um conserto?” pode ser um teste separado, com a mesma chance de conserto para os dois lados. Não conduza um lado com paciência por cinco rodadas de correção para condenar o outro no primeiro erro.
7. Uma comparação mínima que qualquer pessoa consegue fazer
Você não precisa construir uma plataforma de avaliação antes de testar um pelicano. Aqui vai um plano inicial. Ele serve para checar uma diferença evidente numa sonda fixa. Não é um planejamento de tamanho de amostra que garanta detectar uma queda pequena.
| Item | Acordo para esta rodada |
|---|---|
| Pergunta | Nesta tarefa fixa, os serviços A e B diferem na parcela de primeiras entregas aprovadas? |
| Entrada e configurações | Salve a requisição visível completa. Iguale os parâmetros que você controla. Registre as diferenças que não dá para confirmar. |
| Amostra | Programe com antecedência 20 requisições formais de cada lado. Deixe as rodadas-piloto fora da amostra formal. |
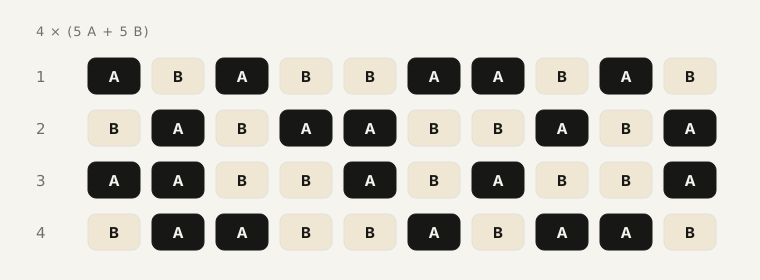
| Tempo e ordem | Divida uma janela predefinida em 4 lotes, com 5 chamadas de A e 5 de B em cada. Intercale-as aleatoriamente dentro do lote, com a mesma regra de concorrência. |
| Novas tentativas | O teste formal de primeira resposta não inclui novas tentativas. Abra um experimento separado se quiser medir o conserto. |
| Avaliação | Fixe a regra de aprovação antes da primeira rodada. Depois de renderizar, oculte o nome do canal, embaralhe a ordem e só então avalie. |
| Saída | Salve todos os resultados brutos, o status de cada chamada, o motivo de cada nota e as estatísticas por lote e gerais. |
Uma regra de aprovação simples é um bom ponto de partida para a tarefa do pelicano. O arquivo renderiza no ambiente combinado? A figura principal e a bicicleta estão completas o bastante para serem reconhecidas? Alguma estrutura-chave está obviamente errada? Os contatos que a tarefa exige, como pé e pedal, de fato acontecem? Dá para anotar a beleza à parte. Cores caprichadas não compensam um erro estrutural.
Se alguém ficar em dúvida sobre uma amostra limítrofe, marque-a como disputada e siga a regra de reavaliação definida antes. Não decida se ela passa depois de ver o nome do canal. Um teste pequeno pode ser avaliado à mão, às cegas. Quando a escala cresce, a avaliação automatizada e a calibração de juízes são a próxima questão. Nem tudo precisa ser resolvido na primeira rodada. Registrar fica muito mais fácil se você separar a configuração que pertence à rodada do log com uma linha por chamada. A configuração da rodada guarda o template original da requisição, os parâmetros, a versão da tarefa, a versão da regra de avaliação, a janela de tempo e o acordo sobre timeout e novas tentativas. Cada chamada deve registrar pelo menos estes campos:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathRegistre os horários com fuso horário. Relacione a resposta bruta, o SVG extraído e a imagem renderizada por meio de artifact_path. Contagens de tokens, impressões digitais do backend e qualquer outra coisa que a interface exponha podem ser guardadas junto. Se não forem fornecidas, registre como vazio ou desconhecido. request_hash serve para checar que a requisição não mudou. Ele não substitui a requisição original. Ao salvar ou compartilhar o log, remova as chaves de API e oculte o contexto privado ou outros conteúdos sensíveis. O que uma verificação pública precisa é das condições do experimento, não das credenciais da conta entregues junto.
Ao resumir, olhe primeiro a diferença geral e o resultado de cada lote. O intervalo binomial e o teste exato de Fisher de antes valem quando suas premissas, incluindo independência e estabilidade, se sustentam aproximadamente. Se o resultado for claramente afetado pelo lote, ou se depois você expandir para testes repetidos em várias tarefas, use uma análise adequada ao desenho do experimento. Não reaproveite mecanicamente a fórmula de tarefa única. Se uma primeira diferença merecer investigação, teste de novo numa nova janela predefinida e acrescente tarefas ligadas ao uso que você realmente tem. A primeira rodada é uma pista de anomalia. Uma nova rodada, separada, é o que ajuda a julgar se ela continua lá.
8. Depois de encontrar uma diferença, como escrever a conclusão?
Com os mesmos números didáticos, uma conclusão contida e ainda útil pode ficar assim:
Na tarefa fixa desta rodada, com configurações visíveis iguais e uma janela de tempo predefinida, A e B foram testados 20 vezes cada. As primeiras entregas aprovadas foram 16 e 8. As taxas de aprovação na amostra diferem em 40 pontos percentuais. Sob premissas que incluem amostragem independente, um teste exato de Fisher bilateral dá um valor-p de cerca de 0,0225, o que sustenta uma diferença nas condições desta rodada. O resultado ainda precisa ser conferido em outras janelas e em tarefas relacionadas. Sozinho, ele não identifica a causa específica de uma mudança no modelo subjacente ou na configuração do servidor.
É menos empolgante do que uma “prova de que está com força total”. Em compensação, entrega à próxima pessoa as condições de que ela precisa para conferir. Se testes posteriores, em outros períodos e em tarefas relacionadas, continuarem apontando na mesma direção, teremos um motivo mais forte para dizer que este serviço é menos confiável do que a referência para esses usos, ou que ele de fato ficou para trás em relação à sua própria linha de base histórica. Pular de “a entrega piorou” para “trocaram às escondidas por um modelo menor” ainda é um passo a mais. Confirmar um mecanismo específico exige evidências independentes capazes de distinguir as explicações, como um registro de rota ou de configuração que dê para verificar. O estilo da saída não basta para adivinhar o modelo.
Isso também não significa que o usuário precise esperar até a causa ser conhecida para poder trocar. Escolher um serviço depende de ele atender às suas necessidades. Acusar uma causa específica depende de evidências sobre essa causa. As duas coisas podem ficar separadas.
9. O que vale mesmo poupar é o custo de provar a questão com clareza
A parte cansativa de um teste manual normalmente não é apertar o botão de rodar. É o trabalho repetitivo depois. Onde está o arquivo? Os parâmetros mudaram? Esta imagem é de qual geração? Foi uma nova tentativa? O print ainda bate com a resposta bruta? Sem esses registros, a convicção de que “ficou mesmo mais burro” pode, uma semana depois, não passar de alguns prints que ninguém consegue conferir.
Se você só quer uma primeira ideia de como serviços diferentes se comportam, ninguém precisa organizar isso do zero. Você pode começar pelo Folkbench, olhar os rankings públicos e a entrada para os relatórios, e ver se o modelo, o grupo de serviço e a métrica que importam para você já têm resultado. As páginas públicas enfatizam a comparação de serviços sob o mesmo modelo, e os rankings também avisam que os números do grupo de uma linha não representam todos os grupos daquela revenda.7
Um ranking publicado deveria reduzir o custo de coletar e organizar. Não deveria ser motivo para parar de checar as condições. Isso vale para qualquer ranking, inclusive o do Folkbench: quando foi medido, o que foi medido, qual o tamanho da amostra, as falhas foram mantidas e qual é o alcance da conclusão? Informação que não é pública continua sendo desconhecida. De volta à pergunta inicial: quanto de “o modelo ficou mais burro” é real, e quanto é a ilusão de um único sorteio?
Antes de existir uma definição comum, uma amostra completa e condições comparáveis, publicar um percentual geral só cria mais um mito. O que podemos fazer melhor é pegar cada suspeita concreta e transformá-la, passo a passo, num julgamento que pode ser verificado. Ao ver uma falha, guarde o resultado bruto. Ao suspeitar de uma piora, comece uma comparação. Ao encontrar uma diferença, aí sim rastreie a causa. Não tente cumprir todas essas etapas dentro de um único print. Um print pode levantar uma boa pergunta. Respondê-la ainda exige um experimento decente.
Notas e fontes
- OpenAI, How to make your completions outputs consistent with the new seed parameter, exemplo arquivado do Cookbook. A nota descreve a seed fixa como um melhor esforço rumo ao determinismo, não como garantia. Este artigo cita apenas esse limite da reprodutibilidade. Ele não trata os nomes de modelos antigos nem o suporte a parâmetros daquela página como descrição atual do produto. Fonte↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, seção 7.2.4.1, Confidence intervals, intervalo de Wilson para uma proporção. Este artigo usa intervalos de Wilson bilaterais de 95% para 16/20 e 8/20, calculados pela fórmula e arredondados para uma casa decimal em porcentagem. O nível de confiança descreve a cobertura de longo prazo do método do intervalo. O método de Wilson é uma aproximação. Fonte↩
- Documentação do SciPy,
scipy.stats.fisher_exact. Este artigo usa a tabela de contingência[[16, 4], [8, 12]]comalternative="two-sided"e obtémp = 0.0224774273717544. Esse é um cálculo sobre os dados do exemplo, não um resultado medido de um artigo científico ou de um relatório de plataforma. O exemplo compara resultados binomiais independentes. Dados pareados, agrupamento entre tarefas, dependência temporal ou comparações múltiplas exigem uma análise adequada ao desenho. Fonte↩ - Yuling Gu et al., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. O artigo discute detalhes de avaliação como o formato do prompt, a escolha dos exemplos no contexto e a redação da tarefa, e o que uma comparação reproduzível exige. Fonte↩
- Ramesh Johari, Leo Pekelis e David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, revisão de 2019. O artigo discute o problema de acompanhar os resultados continuamente e deixar que isso decida o tamanho da amostra, e os métodos de inferência sequencial que tratam desse problema. Fonte↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Sobre incerteza no nível da tarefa, amostragem repetida, comparações pareadas e amostras agrupadas, veja as seções 2, 3 e 4. Sobre o planejamento do tamanho da amostra, veja a seção 5. Fonte↩
- Página inicial e páginas de rankings públicas do Folkbench, consultadas em 5 de outubro de 2026. Este artigo usa essas páginas públicas apenas para descrever o ponto de entrada, o escopo da comparação e o aviso sobre grupos. Ele não endossa de forma independente nenhum número específico de ranking e não afirma que o Folkbench já implemente todos os procedimentos experimentais propostos aqui. Início; Rankings↩