
O ponto que merece atenção no Kimi K3.1 Pro é se ele consegue levar uma tarefa longa até o fim: entender o projeto, alterar o código, chamar ferramentas e seguir corrigindo a partir do retorno das falhas. Uma primeira tela bonita é só um pedaço pequeno disso. Para quem desenvolve, a pergunta que mais importa é outra: depois da décima rodada de alterações, as funcionalidades originais continuam lá, e a entrega passa nos critérios de aceitação?
Os modelos tratados aqui são o Kimi K3.1 Pro e a variante de alta velocidade Kimi K3.1 Pro Highspeed. As fontes foram conferidas em 23 de outubro de 2026, e os números vêm de material oficial público. Nesta rodada, o Folkbench não chamou o modelo, não reexecutou os benchmarks e não lhe atribuiu nenhuma nota independente.
Primeiro, identificar o modelo
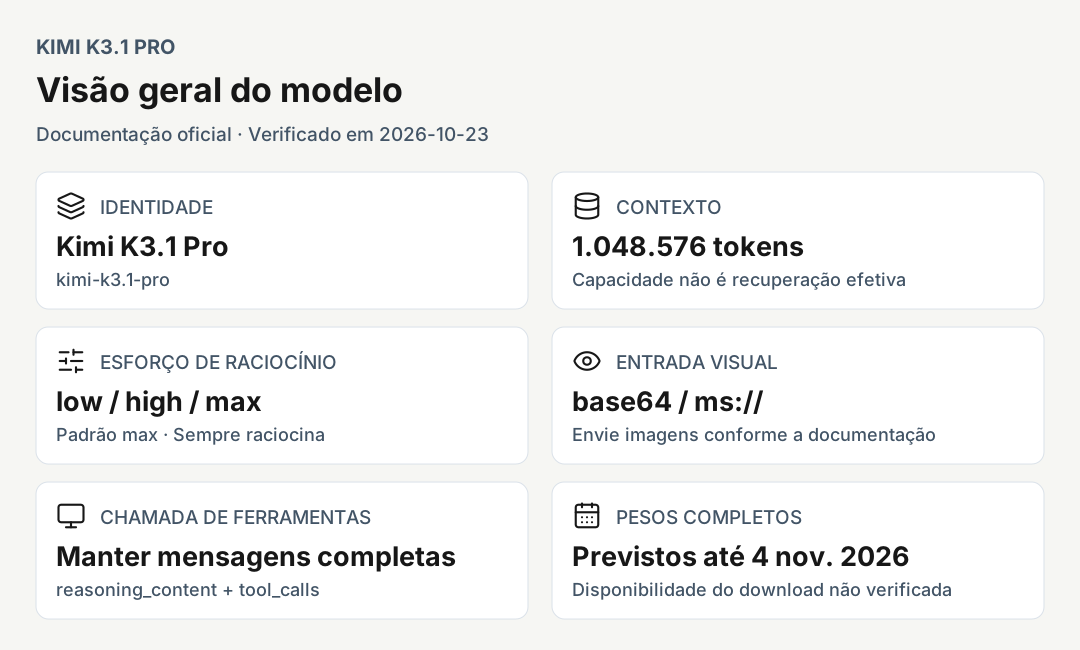
| Item | Resultado da verificação |
|---|---|
| ID padrão na API | kimi-k3.1-pro |
| ID de alta velocidade na API | kimi-k3.1-pro-highspeed |
| Posicionamento oficial | Modelo carro-chefe para programação, criação 3D e pesquisa financeira |
| Escala declarada | Classe de 3T; isso não permite deduzir quantos parâmetros são ativados por requisição |
| Janela de contexto | 1.048.576 tokens |
| Esforço de raciocínio | low, high, max; padrão max |
| Visão e ferramentas | Entrada visual, chamada de ferramentas, saída em streaming |
| Status dos pesos | O blog técnico prevê publicar os pesos completos até 4 de novembro de 2026; este artigo não verificou a disponibilidade do download |
A identidade e o posicionamento vêm da lista oficial de modelos; o tamanho exato do contexto, da documentação de cobrança; os recursos da interface, do guia de início rápido. O blog técnico oficial descreve o modelo como uma versão do K3 com pós-treinamento e traz o plano de publicação dos pesos. Por isso, não convém deduzir só pelo número da versão que a arquitetura de base mudou, nem apresentar o plano de pesos abertos como se a implantação local já fosse possível.
Dois benchmarks, duas perguntas diferentes
A tabela e o gráfico abaixo usam o mesmo conjunto de valores comparativos publicado no blog técnico do Kimi. Os dados dos concorrentes também vêm dessa página; não são resultados medidos de novo pelo Folkbench em um ambiente comum.
| Avaliação | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% |
| BenchCAD, com ferramentas, Voxel IoU | 92,7% | 96,2% | 95,9% |
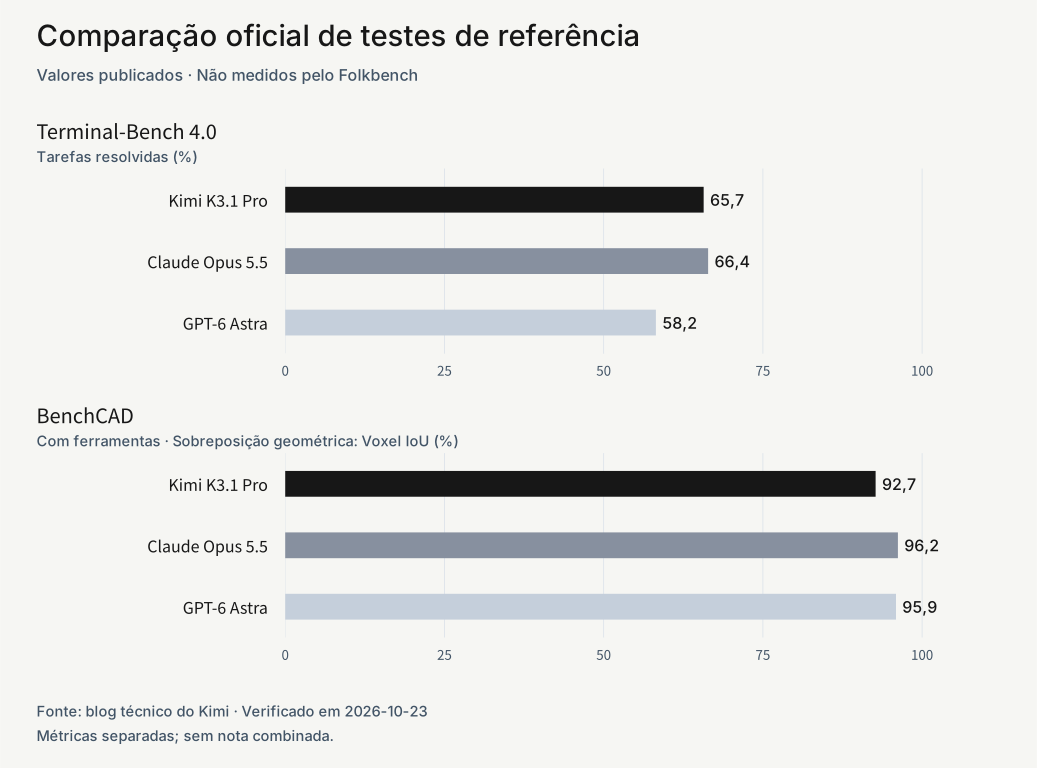
Por padrão, as notas de rodapé oficiais usam o esforço de raciocínio max. O Terminal-Bench do Kimi usa o framework de execução do Claude Code, e as colunas dos concorrentes reúnem dados de materiais de lançamento ou de rankings. No BenchCAD, os modelos abertos foram testados em um subconjunto de 1.000 amostras, e o modo com ferramentas também usa o Claude Code. Essas condições precisam ficar junto com os números.
Tarefas longas de programação: notas próximas não substituem a aceitação do projeto
65,7% e 66,4% diferem em 0,7 ponto percentual. Isso mostra que o desempenho nesta tabela oficial é próximo, mas, sem o mesmo orçamento de execução, o mesmo número de repetições e uma faixa de incerteza, não dá para escrever que as capacidades são iguais. Da mesma forma, superar outro modelo em uma única avaliação não basta para concluir que ele é melhor em todas as tarefas de programação.
Em projetos reais, o que mais vale observar é a recuperação de erros. Uma tarefa pode exigir alterar uma interface, atualizar quem a chama e preservar a compatibilidade, sem quebrar funcionalidades existentes. A quantidade de código que o modelo gera na primeira tentativa não responde a nada disso. Ele precisa entender o que o teste que falhou está apontando, em vez de forçar a aprovação apagando asserções, afrouxando condições ou pulando funcionalidades.
Se a ideia é colocá-lo em um fluxo de trabalho de código, escolha uma tarefa já resolvida, com critérios de aceitação claros, e reproduza-a: fixe a versão do repositório e os requisitos, deixe cada modelo candidato trabalhar de forma independente e depois confira os testes, o escopo das alterações e quanto reparo manual foi necessário. Esse registro decide uma migração melhor do que a impressão de que o modelo “escreve muito bem”. O que se descreve aqui é um método de aceitação sugerido, não um experimento realizado para este artigo.
3D: geometria próxima não significa entrega pronta
A linha do BenchCAD mede Voxel IoU. Os 92,7% não podem ser reescritos como “92,7% das tarefas de modelagem bem-sucedidas”, muito menos tratados como nota de qualidade artística. Reconstrução geométrica, materiais, iluminação, animação, editabilidade e tolerâncias de fabricação são questões de aceitação diferentes.
Se o uso for uma cena Three.js em uma página web, a aceitação deve incluir se as interações funcionam, se a cena roda com fluidez no dispositivo e se os recursos carregam. Se for uma peça editável, confira as relações de medidas, a forma depois de alterar os parâmetros e o arquivo exportado. Um ângulo de renderização bonito pode esconder falhas na parte de trás, interseções na estrutura ou uma topologia inutilizável.
A partir desses dois dados oficiais, a avaliação editorial do Folkbench é que ele merece entrar na lista de candidatos para tarefas longas de código e modelagem programática. Se ele pode substituir a solução atual, quem decide são os resultados entregues no projeto em questão.
Contexto de 1 milhão de tokens: a capacidade só diz se cabe ou não
Quantos arquivos reais cabem em 1.048.576 tokens depende do conteúdo e da tokenização; não é um número fixo de palavras nem de linhas de código. Mais importante: a capacidade não garante automaticamente que o modelo encontre as evidências certas, lembre as restrições anteriores ou mantenha o objetivo original depois de dezenas de chamadas de ferramentas.
Em projetos grandes, colocar o repositório inteiro na requisição pode ser prático, mas também leva junto arquivos gerados, documentação desatualizada e instruções contraditórias. Uma boa entrada deixa claros a versão atual, os arquivos-alvo, os comportamentos que não podem mudar e o ponto de entrada da aceitação. O modelo precisa de contexto útil, não apenas de mais contexto.
Tarefas de várias rodadas têm ainda um custo fácil de ignorar. A documentação oficial dos modelos de raciocínio exige preservar o conteúdo de raciocínio das mensagens anteriores do assistente; essa parte continua ocupando contexto e entrando na cobrança. Uma resposta curta não significa que a execução inteira consumiu poucos tokens.
Integração via API: poucos parâmetros mudam a experiência
O guia de esforço de raciocínio explica que o K3.1 Pro sempre raciocina e que o esforço padrão é max. low reduz o esforço; não desliga o raciocínio. Antes de comparar velocidade, alinhe esse parâmetro; caso contrário, um resultado “mais lento” pode refletir apenas um orçamento diferente.
Na migração, vale conferir três pontos à parte:
- Use o
reasoning_effortno nível superior da requisição; não copie a configuraçãothinkingdo K2. - Em chamadas de ferramentas de várias rodadas, preserve as mensagens completas do assistente, incluindo
reasoning_contentetool_calls. Guardar só o texto final perde o histórico que a API exige. - Para entrada visual, siga o guia de início rápido e use base64 ou referências de arquivo
ms://; não presuma que qualquer URL pública de imagem será aceita diretamente.
Uma revenda exige verificações extras: se os campos da requisição são preservados, se as respostas são truncadas, se o nome do modelo é remapeado e se os campos de uso vêm completos. A API do modelo responder normalmente não significa que o loop de ferramentas do agente acima dela esteja funcionando corretamente.
Custo: primeiro calcule uma tarefa, depois fale de custo-benefício
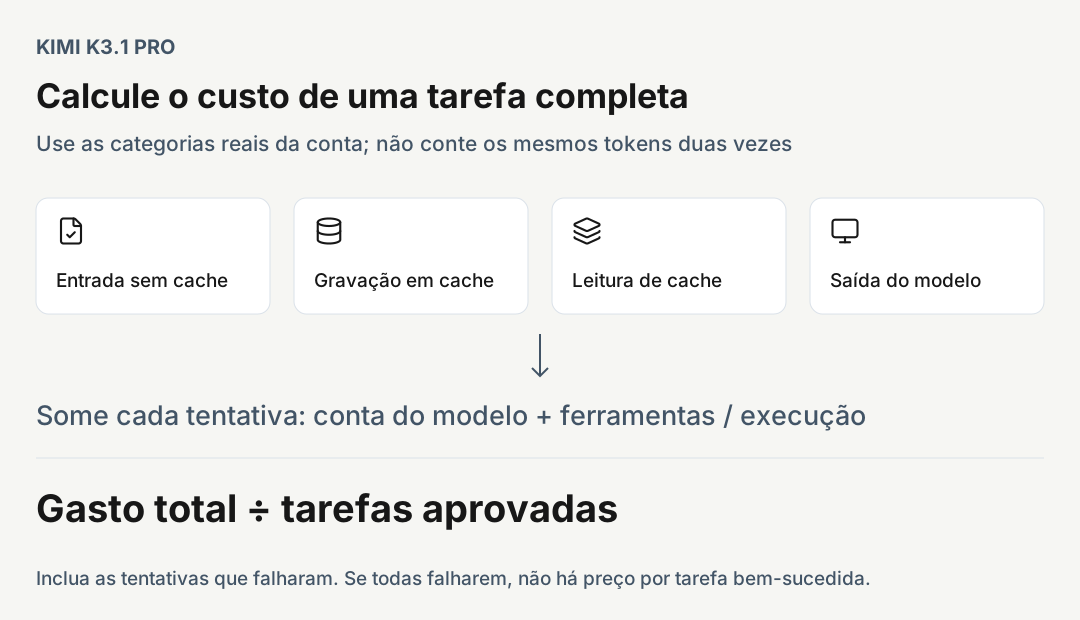
A página oficial de preços e a versão em Markdown consultadas nesta verificação não retornaram uma linha de preço completa e verificável para o K3.1 Pro. Por isso, este artigo não informa preços em dólar nem toma emprestados os preços do K3 ou de revendas. Esse resultado não prova que os preços oficiais não tenham sido publicados; significa que este artigo não tem evidências suficientes para colocar um número numa tabela de preços.
O que dá para verificar é a estrutura de cobrança: a API é cobrada por uso, separadamente da assinatura do Kimi e do Kimi Code; a gravação em cache varia conforme o TTL, e a leitura com acerto de cache é cobrada separadamente da entrada sem cache. O guia de início rápido diz que não há faixas de preço por tamanho de contexto. A documentação de cache é o ponto de partida para conferir as regras de reutilização e a validade.
Isso significa que tarefas de contexto longo precisam ser analisadas por partes: quais entradas não acertaram o cache, quais acionaram gravação em cache, quais foram cobradas como leitura de cache e quanto de saída foi gerado no fim. Serviços de ferramentas, ambiente de execução e novas tentativas após falhas também podem aumentar o gasto total. Siga as categorias reais da conta para não contar o mesmo lote de tokens em mais de um item.
Uma métrica útil para discussões de compra e migração é: gasto total do lote ÷ número de tarefas aprovadas na aceitação. As tentativas que falharam continuam no numerador; se todas falharem, não há preço por tarefa bem-sucedida para informar. Esse é o critério de comparação que sugerimos, não um resultado medido pelo Folkbench.
A lista oficial de modelos descreve o Highspeed como uma variante com a mesma capacidade e cerca de 2–3× a velocidade. É uma afirmação do provedor e não pode ser convertida diretamente em um fluxo de trabalho inteiro 2–3× mais rápido. Se a geração do modelo ocupa metade do tempo total, mesmo que essa metade caia para um terço, o total passa de 1 para cerca de 0,67, ou seja, cerca de 1,5× mais rápido. É um cálculo hipotético para ilustrar o gargalo, não a latência medida do Kimi.
Que tarefas vale testar primeiro
| Tipo de trabalho | Capacidade a observar | Resultado que só vale se passar na aceitação |
|---|---|---|
| Alterações de código em vários arquivos | Preservação de restrições, uso de ferramentas, recuperação de falhas | Testes passando, funcionalidades antigas preservadas, reparo manual aceitável |
| 3D programático e interação web | Relações espaciais, geração de scripts, iteração | Arquivos editáveis, interações funcionando, desempenho adequado |
| Pesquisa com vários documentos e análise de planilhas | Localização de evidências, conferência entre documentos | Citações rastreáveis, unidades consistentes, cálculos verificáveis |
| Extração simples ou classificação de alto volume | Latência e custo por tarefa | Com o mesmo patamar de qualidade, orçamento melhor que o da solução atual |
Os três primeiros tipos correspondem ao posicionamento oficial, mas posicionamento não é garantia de qualidade. Em pesquisa, principalmente, texto fluente e muitas citações não substituem a conferência item por item: se a fonte sustenta mesmo a conclusão, se anos e unidades batem, se as fórmulas da planilha podem ser recalculadas. Para classificação simples, um modelo carro-chefe com max por padrão nem sempre é a opção mais econômica.
A avaliação do Folkbench
O material oficial do Kimi K3.1 Pro traz sinais de capacidade que merecem verificação séria: tanto as tarefas longas de programação quanto a modelagem programática já estão na faixa de comparação de alto nível. O valor real depende de essas capacidades se converterem, de forma estável, em entregas aprovadas com suas entradas, ferramentas e orçamento.
Ainda faltam registros de chamadas próprios deste artigo, experimentos repetidos, a distribuição das falhas e preços unitários verificáveis; por isso, não publicamos uma nota geral nem afirmamos que ele tem “o melhor custo-benefício”. Alguns trechos de benchmarks do guia de início rápido ainda têm marcadores de posição e trazem versões diferentes das do blog técnico; os dois números deste artigo vêm apenas da comparação na mesma página do blog técnico, sem misturar versões.
Se você está avaliando um fluxo de trabalho de código, continue com o [guia de avaliação de engenharia de software do Folkbench](/pt/blog/ai-api-relay-software-engineering-evaluation-guide). Para os limites das fontes sobre outros modelos, veja [Claude Opus 5.5](/pt/blog/claude-opus-5-5-review-pricing) e [GPT-6.1 Sol](/pt/blog/gpt-6-1-sol-review-pricing); este último não é o GPT-6 Astra da tabela acima, e modelos e notas não podem ser misturados.


