Folkbench hat im Integrity Monitor die Erkennung von Modelldrosselung eingeführt. Klassische Modell-Ranglisten messen das theoretische Leistungslimit unter offiziellen Bedingungen, während typische Relay-Verzeichnisse bei Preislisten, HTTP-Uptime und Latenz stehen bleiben. Keine der beiden Seiten beantwortet die entscheidende Betriebsfrage: Liefert ein Drittanbieter-API-Relay bei einem bestimmten Modell weiterhin die volle Denktiefe, Regelbefolgung und Identität der direkten offiziellen API?
Um diese Lücke zu schließen, bettet Folkbench automatisierte Sonden über zwei Dimensionen ein—aktuelle Ereignisse und Modell-Fingerprints—und kalibriert jede Messung fortlaufend über unabhängige offizielle Direct-API-Keys im selben Zeitfenster. Durch die Verankerung jeder Relay-Route an einer Live-Referenzlinie werden schleichende Abweichungen rechtzeitig erkannt und in öffentlich nachprüfbare Signale überführt.
Kernpunkte der neuen Funktion:
- Zweidimensionale Sondenarchitektur: Kombiniert fortlaufend aktualisierte Aktualitäts-Sonden mit Fingerprint-Sonden für Denkgewohnheiten, Token-Budget und API-Fingerprints und verhindert statisches Caching sowie oberflächliche Antworten.
- Unabhängige offizielle Kalibrierung: Führt dieselben Sonden über isolierte offizielle Direct-API-Keys zeitgleich aus, um anbieterweite Updates sauber von Relay-spezifischen Abweichungen zu trennen.
- Modell- und Gruppengranularität: Misst Sonden-Übereinstimmung, Input-Tokens, Reasoning-Tokens, Modell-Fingerprints und verfügbare Cache-Prüfungen getrennt nach Modell und Servicegruppe.
- Durchgängiger Workflow von Messung bis Umschaltung: Verbindet den Integrity Monitor mit vier öffentlichen Ranglisten, dem direkten Relay-Vergleich und dem Open-Source-Client Folkbench Switch.
Warum klassische Ranglisten und Uptime-Checks Drosselung übersehen
Zwischen Client und Modellanbieter geschaltete Relays können unter Kostendruck oder Lastspitzen drei Qualitätsverluste verursachen, die in reinen Netzwerkwerten unsichtbar bleiben:
- Stiller Modelltausch: Angefordert wird ein Flaggschiff-Modell, doch bei hoher Last oder langen Kontexten wird die Anfrage auf ein kleineres Modell oder einen älteren Snapshot umgeleitet.
- Gekürztes Denkbudget: Der Modellname bleibt identisch, aber Reasoning Effort oder interne Denkschritte werden heruntergeregelt, sodass Antworten verfrüht abbrechen.
- Kontext- und Ausgabekürzung: Frühere Gesprächsrunden oder maximale Ausgabelängen werden beschnitten, was zu vergessenen Bedingungen und brüchiger Logik führt.
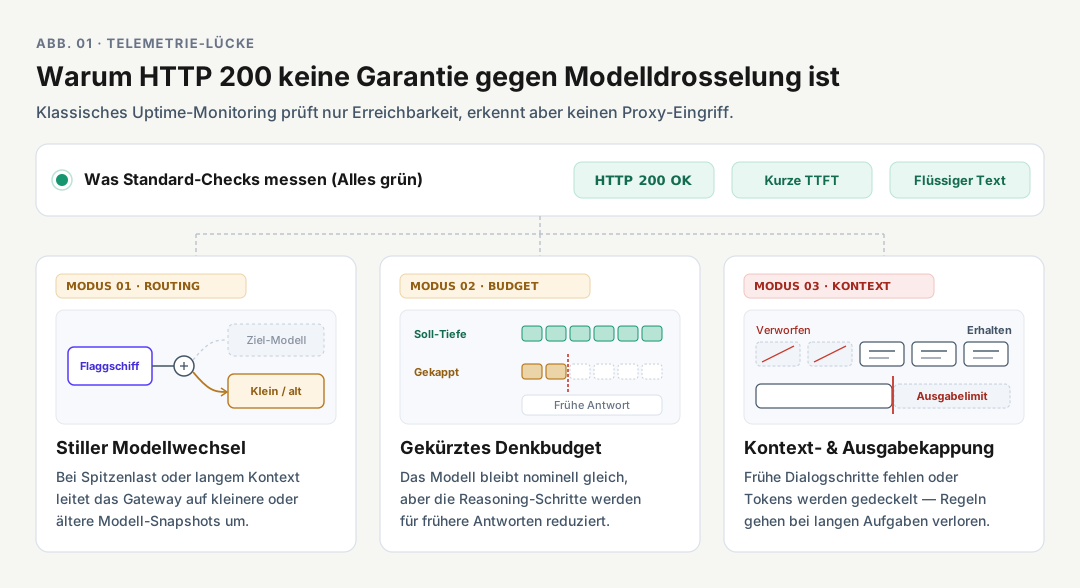
Abbildung 1: Grüne Erreichbarkeitswerte (`HTTP 200`, niedrige TTFT, flüssige Kurzantworten) beweisen keine ungekürzte Modellleistung. Modelltausch, beschnittenes Reasoning-Budget und Kontext-Kappung greifen unterhalb klassischer Ping-Metriken.
Alle drei Eingriffe lassen die Netzwerkhülle intakt: Der Endpoint liefert weiterhin HTTP 200, Smalltalk klingt flüssig und verkürztes Denken senkt oft sogar die Latenz. Gleichzeitig gehören vereinzelte Ausreißer zur natürlichen Stichprobenvarianz—wie in [Ist das Modell wirklich dümmer geworden?](/de/blog/did-the-model-get-dumber/) erläutert, reicht ein einzelner Screenshot nicht zur Ursachenklärung.
Warum naive Selbsttests gegen moderne Routing-Logik versagen
Besteht der Verdacht auf Leistungseinbußen, scheitern zwei weit verbreitete manuelle Selbsttests an moderner Gateway-Steuerung:
- Fragen nach dem Modellnamen: Ein Sprachmodell kennt die vorgeschaltete Proxy-Infrastruktur nicht. Ein System-Prompt mit dem gewünschten Modellnamen oder antrainierte Standardantworten genügen, damit auch ein Ersatzmodell diesen Namen nennt.
- Statische Standardrätsel: Bekannte Testfragen stecken längst in öffentlichen Trainingsdaten kleiner Modelle und lassen sich bei Wiederholung leicht per statischem Cache oder Test-Prompt-Whitelisting abfangen.
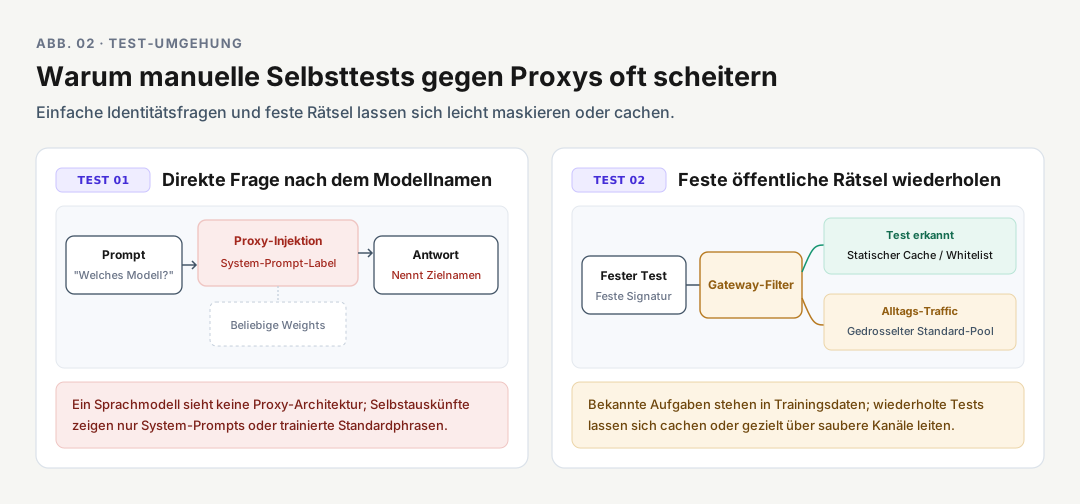
Abbildung 2: Warum naive Selbsttests versagen. Links: Ein vom Gateway injizierter System-Prompt überschreibt Modellnamen unabhängig von den aktiven Gewichten. Rechts: Wiederholte Standardfragen werden vom Filter erkannt, statisch gecacht oder auf saubere Pools umgeleitet, während regulärer Verkehr gedrosselt bleibt.
Zweidimensionale Sonden: Aktuelles Verständnis und Modell-Fingerprints gemeinsam prüfen
Um versteckte Abweichungen zuverlässig zu erkennen, führt Folkbench innerhalb jedes Messfensters zwei komplementäre Sondendimensionen parallel aus:
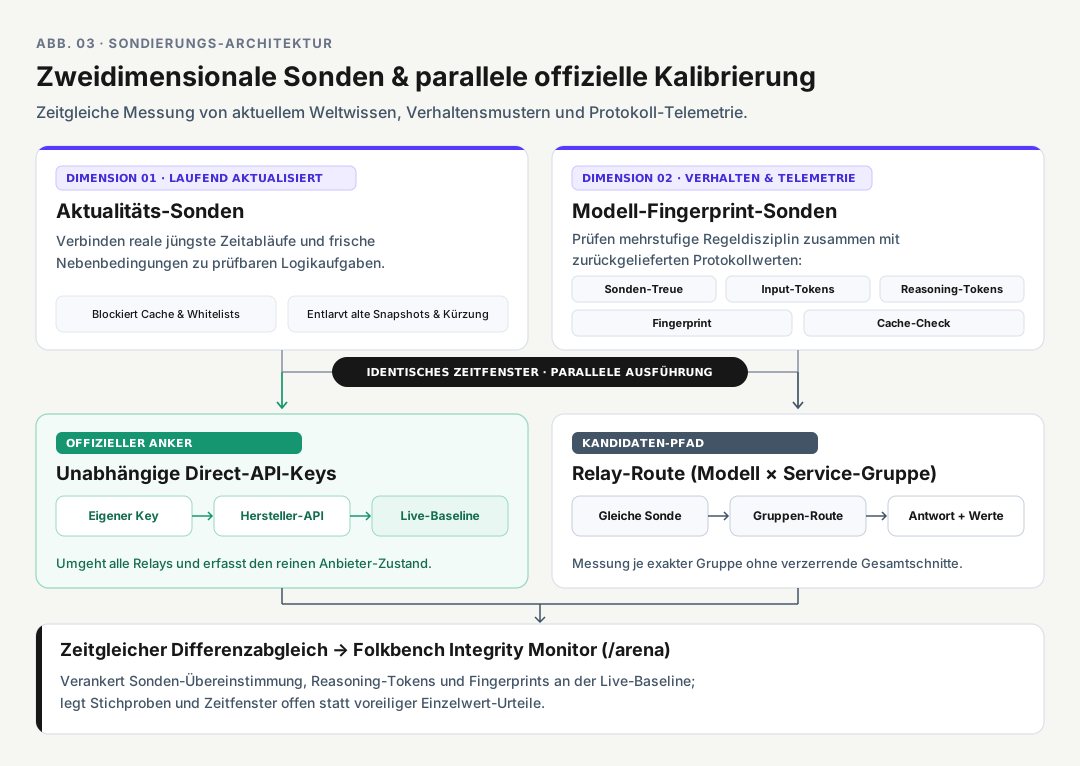
Abbildung 3: Zeitgleiche Doppel-Sonden-Architektur. Aktualitäts-Sonden verhindern statisches Caching; Fingerprint-Sonden erfassen Sonden-Übereinstimmung, Input-Tokens, Reasoning-Tokens, Modell-Fingerprints und Cache-Checks parallel gegen isolierte offizielle Direct-API-Keys.
1. Aktualitäts-Sonden: Schutz vor statischem Caching und veralteten Snapshots
Aktualitäts-Sonden verknüpfen jüngste reale Ereignisse, aktuelle Zeitachsen und veränderliche Randbedingungen in mehrstufigen Aufgaben. Da sich die Testbasis kontinuierlich erneuert, laufen vorab gespeicherte Antworten ins Leere; zugleich geraten ältere Ersatz-Snapshots bei Aufgaben mit jüngeren Zeitbezügen und mehrstufiger Bedingungsprüfung sichtbar ins Stolpern.
2. Fingerprint-Sonden: Denkgewohnheiten und Token-Telemetrie erfassen
Wenn ein fähiges Fremdmodell eingesetzt oder das Denkbudget des richtigen Modells halbiert wird, reicht reines Richtig/Falsch bei einfachen Fragen nicht aus. Fingerprint-Sonden prüfen feine Formatregeln, mehrstufige Denkpfade und API-Telemetrie: Sonden-Übereinstimmung, Input-Tokens, Reasoning-Tokens sowie zurückgemeldete Modell-Fingerprints (und Cache-Checks, sofern Daten vorliegen). Sinkt das Denkbudget im Hintergrund, bleiben Sätze oft flüssig, während Reasoning-Tokens und Sonden-Übereinstimmung gemeinsam abfallen.
Kalibrierung mit unabhängigen offiziellen Direct-API-Keys
Ein Rückgang auf einem Relay allein beweist noch nicht, ob der Relay gedrosselt hat oder ob der offizielle Modellanbieter ein Update ausgerollt hat bzw. die aktuelle Aufgabenserie selbst niedriger liegt. Deshalb laufen alle Sonden zeitgleich über isolierte, unabhängige offizielle Direct-API-Keys direkt zum Hersteller—ohne jedes Relay dazwischen.
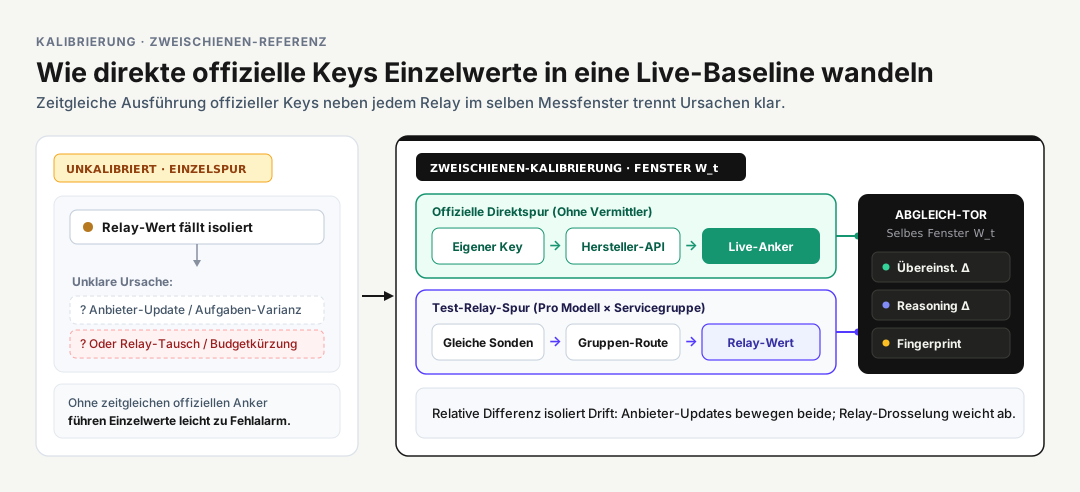
Kalibrierungsmechanismus: Ohne zeitgleichen offiziellen Anker (links) bleibt unklar, ob ein Abfall vom Anbieter oder vom Relay stammt. Die Zweischienen-Kalibrierung (rechts) führt isolierte offizielle Keys parallel zu jeder `Modell × Servicegruppe`-Route im selben Fenster `W_t` durch das Abgleich-Tor.
| Beobachtung | Unkalibriertes Relay-Monitoring | Kalibrierung mit unabhängigen offiziellen Keys |
|---|---|---|
| Offizielles Modell schwankt oder wird aktualisiert | Gefahr von Fehlalarmen gegen das Relay | Offizielle Baseline bewegt sich mit und trennt globales Rauschen ab |
| Offizielle Baseline stabil, einzelnes Relay fällt ab | Keine gleichzeitige Referenz zur Einordnung | Sonden-Übereinstimmung und Reasoning-Tokens weichen klar ab |
| Unterschiede zwischen Gruppen eines Relays | Ein schneller Pool überdeckt gedrosselte Billig-Pools | Jede Modell × Servicegruppe-Route wird separat gegen die Baseline geprüft |
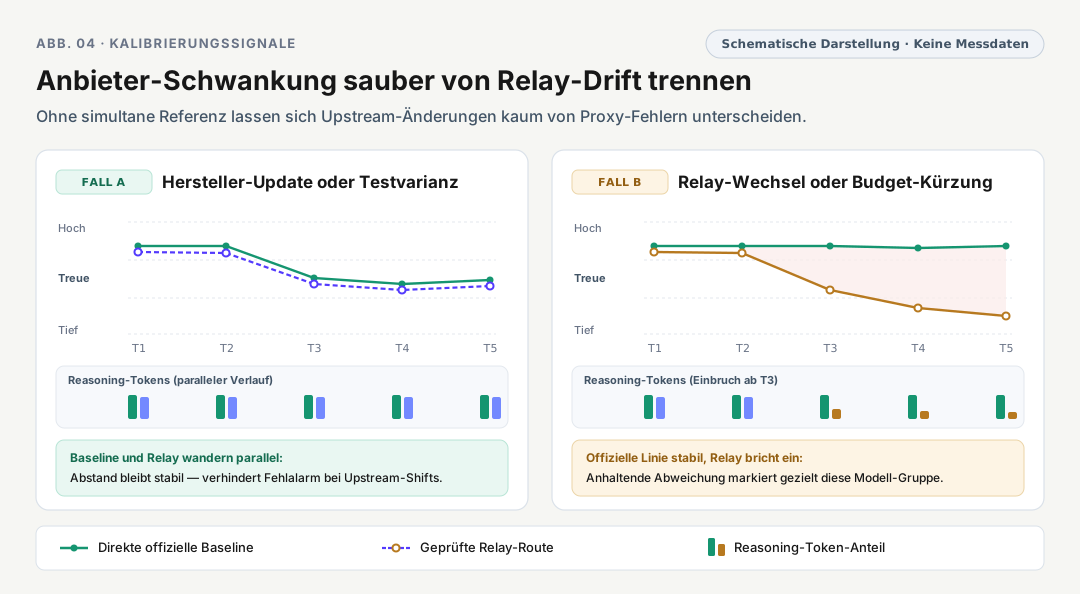
Abbildung 4 (Schema-Illustration, keine realen Messdaten): Unterscheidung zwischen globaler Anbieter-Varianz (Fall A, beide Linien verlaufen ab `T3` parallel) und lokaler Relay-Drosselung (Fall B, offizielle Baseline stabil, Sonden-Übereinstimmung und Reasoning-Tokens des Relays fallen ab `T3` ab).
Gemäß den Grenzen im [Integrity Monitor](/de/arena) beweist ein einzelner Treffer oder Prozentwert allein keinen Modelltausch. Erst Stichprobengröße, aufeinanderfolgende Zeitfenster und Token-Verteilungen ergeben ein belastbares Frühwarnsignal.
Was Folkbench von klassischen Modell- und Relay-Portalen unterscheidet
Herkömmliche KI-Portale prüfen entweder theoretische Modellwerte auf festen Datensätzen oder nur Preise und HTTP-Pings. Folkbench schließt diese Lücke durch eine vierstufige Prüf- und Wechselkette:
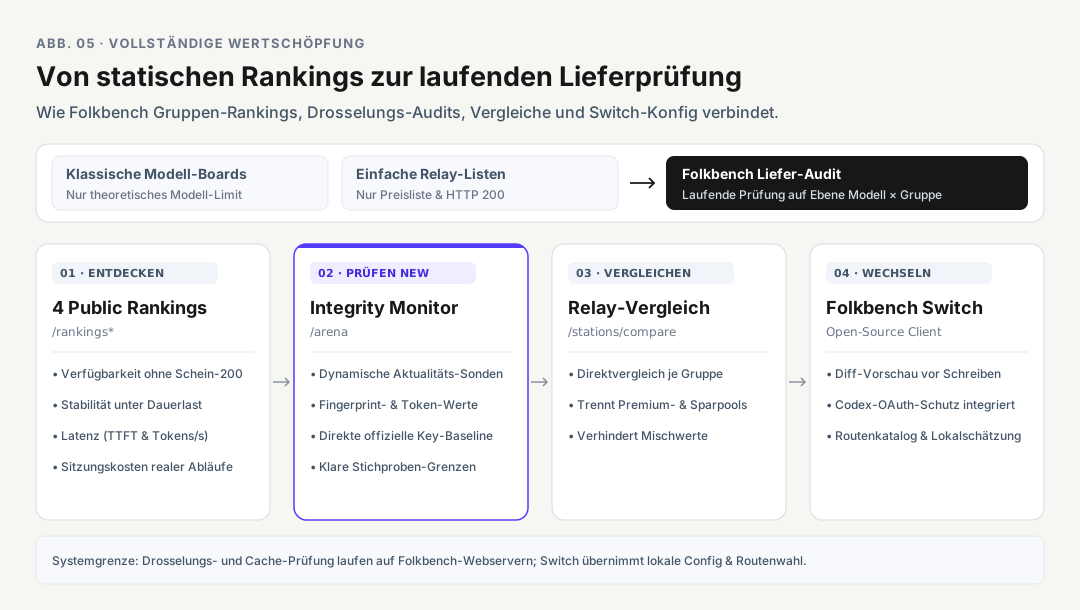
Abbildung 5: Vom theoretischen Modell-Ranking zur kontinuierlichen Lieferprüfung. Folkbench verbindet Gruppen-Rankings (`/rankings), Integritäts-Audit (/arena), direkten Gruppenvergleich (/stations/compare) und sicheres lokales Umschalten (Folkbench Switch`); Integritäts- und Cache-Tracking laufen dabei webbasiert.*
- Messung auf Modell- und Gruppenebene: Jede Preis- oder Routinggruppe eines Anbieters wird getrennt bewertet, statt ein ganzes Domain-Label pauschal zusammenzufassen.
- Vier spezialisierte Ranglisten: [Verfügbarkeit](/de/rankings) (filtert Fake-
200-Fehler und Stream-Abbrüche), [Stabilität](/de/rankings/stability) (Dauerlast & Stoßzeiten), [Latenz](/de/rankings/latency) (TTFT getrennt von Ausgabetempo) und [Sitzungskosten](/de/rankings/cost) (reale Arbeitskosten statt Lock-Multiplikatoren). - Offener [Integrity Monitor](/de/arena) & [Relay-Vergleich](/de/stations/compare): Kalibrierte Integritätsdaten und direkter Routenvergleich ohne eigene Test-Keys.
- Open-Source-Client [Folkbench Switch](https://github.com/Folkbench/folkbench/releases): Tauri-+-Rust-Desktop-App (macOS
.dmg, Windows.exe) für Claude Code, Codex, Gemini CLI, Aider, OpenCode und Kimi CLI mit Diff-Vorschau vor dem Schreiben, Codex-OAuth-Schutz und lokaler Nutzungsabschätzung. (Integritäts- und Cache-Tracking bleiben Web-Evaluationsfunktionen.)
Praktischer Einsatz im Alltag
- Wählen Sie passende Modell-und-Gruppen-Kandidaten über [Verfügbarkeit](/de/rankings), [Stabilität](/de/rankings/stability), [Latenz](/de/rankings/latency) und [Sitzungskosten](/de/rankings/cost).
- Prüfen Sie im [Integrity Monitor](/de/arena) die Übereinstimmung von Sonden, Reasoning-Tokens und Fingerprints mit der offiziellen Live-Baseline über mehrere Zeitfenster.
- Vergleichen Sie vor der Buchung exakt die gewünschte Gruppe unter [Relay-Vergleich](/de/stations/compare).
- Verwalten Sie Haupt- und Ersatzroute in Folkbench Switch, um bei Abweichungen per Diff-Vorschau in Sekunden umzuschalten.
Moderne KI-Bewertung muss nicht nur zeigen, welches Modell auf dem Papier führt, sondern ob jede bezahlte Route diese Leistung tatsächlich ausliefert. Durch Aktualitäts-Sonden, Modell-Fingerprints und unabhängige offizielle Kalibrierung setzt Folkbench dafür einen transparenten Maßstab.