Ein Fehlschlag kann beweisen, dass ein Modell einen Fehler gemacht hat. Für sich allein beweist er nicht, dass das Modell häufiger scheitert als früher.
„Ist dieses Modell schon wieder dümmer geworden?“ Ein Pelikan, dessen einer Fuß neben dem Pedal baumelt, ein Fahrrad, dessen Rahmen zu einem Knoten verdreht ist, und daneben ein Screenshot, der letzte Woche noch richtig gut aussah: Mehr braucht es nicht, damit die Frage aufkommt.
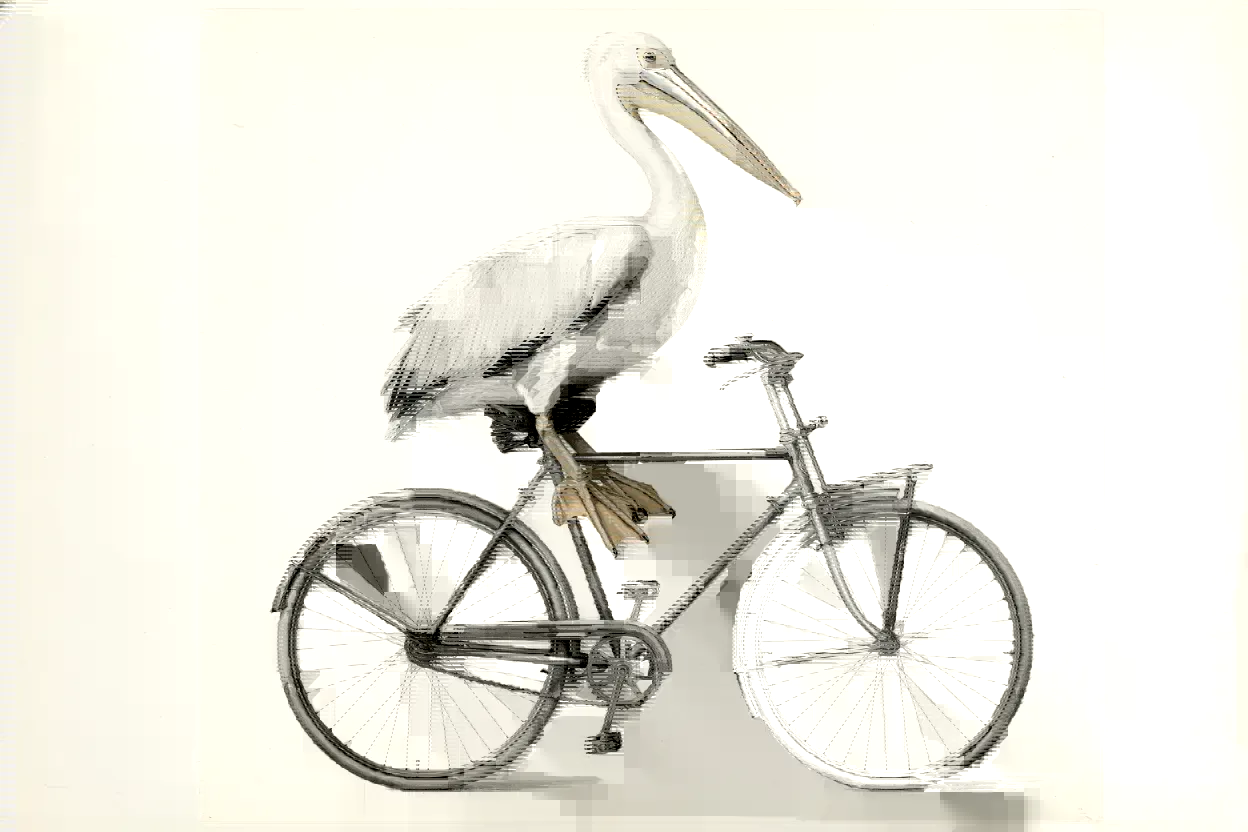
Dieser Verdacht sollte nicht mit „Modelle sind eben zufällig“ abgetan werden. Jemand hat für eine Aufgabe bezahlt, die der Dienst früher erledigt hat, und jetzt gelingt sie nicht mehr. Da ist Nachfragen berechtigt. Zwei Screenshots reichen allerdings nicht, um zu zeigen, dass das Modell ausgetauscht, das Reasoning-Budget gekürzt oder ein bestimmter Dienst verwässert wurde.
Vor einiger Zeit habe ich den Pelikan-Test Dutzende Male laufen lassen. Nützlich ist die Aufgabe, weil viele ihrer Fehler sichtbar im Bild landen. Code, der läuft, heißt noch nicht, dass das Fahrrad richtig gebaut ist. Dass Vogel und Fahrrad beide da sind, heißt noch nicht, dass der Fuß wirklich auf dem Pedal steht. Solche räumlichen Beziehungen fallen dem Auge leichter auf als eine flüssige Antwort, in der trotzdem eine logische Lücke stecken kann. Je mehr Durchläufe ich aufbewahrte, desto deutlicher wurde ein anderer Punkt: Wir beurteilen oft einen ganzen Dienst nach einem einzigen Werk.
Dieser Artikel will kein Modell entschuldigen, und er bringt niemandem bei, ein „falsches Modell“ an ein paar oberflächlichen Merkmalen zu erkennen. Mich interessiert eine engere Frage: Wenn wir vermuten, dass ein Modell schlechter geworden ist – wie machen wir aus diesem Gefühl Nachweise, die andere nachprüfen können?
Hinweis: Die Dienste A und B weiter unten und alle zugehörigen Testzahlen sind Lehrbeispiele. Sie beziehen sich auf keinen realen Dienst und sind weder eine Messung noch eine Rangliste von Folkbench.
1. Zuerst die Frage trennen: Was meinen Sie mit „dümmer“?
„Dümmer geworden“ ist eine bequeme Formulierung, und sie fasst mehrere verschiedene Fragen in eine. Die direkteste Ebene lautet: Genau diese Antwort ist falsch. Der Pelikan hat ein zusätzliches Bein bekommen, der Fuß hat das Pedal verfehlt, oder die Räder haben sich vom Rahmen gelöst. Jedes davon ist ein konkreter Fehler, den man überprüfen kann. Eine einzige Stichprobe genügt, um zu beweisen, dass „diese Art von Fehler vorgekommen ist“, und sie genügt, um das Versprechen „so einen Fehler würde es nie machen“ zu widerlegen. Die zweite Ebene lautet: Unter denselben oder hinreichend ähnlichen Bedingungen scheitert dieser Dienst häufiger.
Dann geht es nicht mehr darum, ob der Fehler existiert, sondern darum, wie oft er auftritt. Am meisten lohnt es sich, an „das Erlebnis ist schlechter geworden“ den Wechsel von „meistens hat es geklappt“ zu „meistens klappt es nicht“ zu messen. Die dritte Ebene lautet: Die Veränderung wurde durch eine Änderung am Modell selbst oder an der serverseitigen Konfiguration verursacht. Das ist bereits eine Aussage über die Ursache. Dasselbe schlechte Ergebnis kann verschiedene Erklärungen haben: andere Anfrageparameter, ein anderer Kontext, eine abgeschnittene Ausgabe oder eine echte Änderung am zugrunde liegenden Modell und an den Inferenzeinstellungen. Am Ergebnis allein lässt sich meist keine dieser Erklärungen eindeutig herausgreifen.
„Diese Antwort war falsch“, „dieser Dienst ist weniger zuverlässig“ und „dieser Dienst hat heimlich das Modell ausgetauscht“ verlangen deshalb nicht gleich starke Nachweise. Diesen Unterschied anzuerkennen, legt die Messlatte für Beschwerden von Nutzern nicht höher. Im Gegenteil: Wer die Frage klar benennt, verhindert, dass ein Anbieter jeden Fehler mit „Zufall“ erklärt, und dass ein Tester jeden Unterschied mit „die haben das Modell ausgetauscht“ erklärt.
2. Sehen Sie ein einzelnes Werk oder eine Verteilung von Ausgaben?
Wenn eine Generierungseinstellung zufällig sampelt, kann dieselbe Eingabe unterschiedliche Ausgaben erzeugen. Selbst wenn Sie eine Einstellung nutzen, die die Reproduzierbarkeit verbessern soll, ist „so einheitlich wie möglich“ nicht als „jedes Mal identisch“ zu lesen. Ein älterer technischer Hinweis von OpenAI sagt das ausdrücklich: Bei gleichem Seed, gleichen Parametern und gleichem Backend-Fingerabdruck ist die Ausgabe trotzdem nicht garantiert identisch. Das ist eine Grenze der Reproduzierbarkeit. Es bedeutet nicht, dass heute jedes Modell dieselben Parameter unterstützt.1
Beim Pelikan-Test wollen wir meist nicht wissen, ob das Modell „gelegentlich ein gutes Bild zeichnen kann“. Wir wollen wissen: „Wenn ich die Aufgabe unter den festgelegten Bedingungen noch einmal stelle, wie wahrscheinlich ist ein bestandenes Ergebnis?“ Ein vereinfachtes Beispiel zeigt das Problem mit einem einzelnen Screenshot. Angenommen, die tatsächliche Bestehensquote eines Dienstes pro Versuch liegt bei 80 %, jede Generierung ist unabhängig, und sein Zustand ändert sich während des Tests nicht. Die Wahrscheinlichkeit für mindestens einen Fehlschlag in 20 aufeinanderfolgenden Versuchen beträgt dann: 1 − 0.8²⁰ ≈ 98.85% Ein Dienst, der die Aufgabe meistens gut erledigt, hinterlässt in diesen 20 Versuchen also fast sicher irgendwo einen Fehlschlag, den man per Screenshot festhalten kann.
Und umgekehrt: Angenommen, die tatsächliche Bestehensquote eines anderen Dienstes pro Versuch liegt nur bei 40 %. Unter denselben Annahmen von Unabhängigkeit und Stabilität beträgt die Wahrscheinlichkeit für mindestens ein bestandenes Ergebnis in 20 Versuchen: 1 − 0.6²⁰ ≈ 99.996% Auch dieser Dienst liefert also fast sicher ein Werk, das man vorzeigen kann. Diese beiden Rechnungen behaupten nicht, dass jeder echte Aufruf unabhängig ist, und auch nicht, dass echte Bestehensquoten genau diesen Zahlen entsprechen. Sie zeigen auf ein Auswahlproblem: Wer nur den besten Versuch zeigt, überschätzt leicht die Zuverlässigkeit, und wer nur den schlechtesten zeigt, übertreibt leicht den Rückgang.
Derselbe Dienst kann deshalb in einem Beitrag auftauchen, der ein Bild als Beweis für volle Leistung nimmt, und in einem anderen, der ein Bild als Beweis dafür nimmt, dass er dümmer geworden ist. Beide Screenshots können echt sein. Die Schlussfolgerung muss es nicht sein. Es gibt noch einen Unterschied, den man leicht übersieht. Beim ersten Generieren erfolgreich zu sein und zehnmal zu generieren und dann den Erfolg herauszusuchen, ist nicht dieselbe Fähigkeit. Das Zweite enthält zusätzliche Aufrufe, Wartezeit und die Kosten der Auswahl. Wenn Sie zwei Arbeitsabläufe vergleichen, geben Sie beiden dasselbe Versuchsbudget. Vergleichen Sie nicht den ersten Versuch von A mit der handverlesenen Auswahl von B.
3. Macht ein Test mit 20 Durchläufen einen Unterschied automatisch statistisch aussagekräftig?
Nein. Zwanzig Durchläufe können ein vernünftiges Versuchsbudget sein. Ein statistischer Freifahrtschein sind sie nicht. Nehmen wir dasselbe konkrete Beispiel. Kanal A wird 20-mal getestet und besteht 16-mal. Kanal B wird 20-mal getestet und besteht 8-mal. Beide nutzen dieselbe feste Aufgabe und dieselbe Bewertungsregel, und jede Stichprobe wird aufbewahrt.
| Kanal | Bestanden / gesamt | Quote in der Stichprobe | 95-%-Wilson-Intervall der Quote |
|---|---|---|---|
| A | 16 / 20 | 80 % | 58,4–91,9 % |
| B | 8 / 20 | 40 % | 21,9–61,3 % |
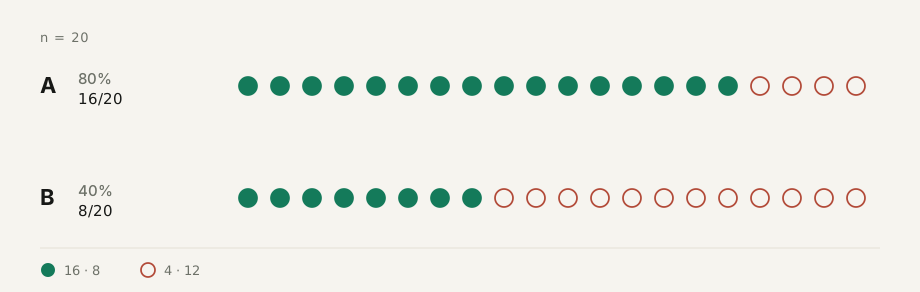
Die Intervalle sind zweiseitige 95-%-Wilson-Intervalle für einen Binomialanteil. Sie drücken die Unsicherheit der geschätzten Bestehensquote aus. Sie sind keine Punktespanne für die Bildqualität.2 Der Unterschied in der Stichprobe beträgt 40 Prozentpunkte. Mit nur 20 Versuchen pro Seite ist die Schätzung noch grob. 80 % und 40 % sollten nicht als wahre Fähigkeit behandelt werden, die exakt gemessen ist und sich nie verändert.
Nehmen wir zusätzlich an, dass die Aufrufe unabhängig sind, dass die Bestehenswahrscheinlichkeit jedes Kanals innerhalb des Zeitfensters stabil ist und dass dieser Vergleich vorab festgelegt wurde. Dann ergibt ein zweiseitiger exakter Fisher-Test auf die Zählungen „bestanden / nicht bestanden“ p ≈ 0.0225. Bei einem vorab gewählten Signifikanzniveau von 5 % stützt dieses Beispiel die Aussage „die Bestehensquoten unterscheiden sich unter diesen Bedingungen“.3 Diese Zahl bedeutet nicht „mit 97,75 % Wahrscheinlichkeit wurde B verwässert“, und sie bedeutet nicht „mit 97,75 % Wahrscheinlichkeit ist A für immer besser“. Ein p-Wert ist die Wahrscheinlichkeit für Daten, die so extrem oder noch extremer sind, unter der Hypothese, dass kein Unterschied besteht, und unter den Bedingungen des Tests. Er ist nicht die Wahrscheinlichkeit einer verborgenen Ursache.3
Ersetzen Sie einen Test des Unterschieds nicht durch einen Blick darauf, ob sich die beiden Intervalle überschneiden. Jedes Intervall schätzt eine einzelne Quote. Der Test betrifft den Unterschied zwischen ihnen. Drei Grenzen sind wichtiger, als sich einen bestimmten Test zu merken. Betrachten Sie die Größe des Abstands und den Stichprobenumfang zusammen. 16 zu 8 sollte keine gleich starke Schlussfolgerung stützen wie 16 zu 15. Wie viele Stichproben Sie brauchen, hängt davon ab, wie kleine Unterschiede Sie erkennen wollen und wie viel Risiko einer Fehlentscheidung Sie in Kauf nehmen. Ein „mindestens so oft testen“, das für jede Aufgabe passt, gibt es nicht.
Keinen signifikanten Unterschied zu finden, beweist nicht, dass beide gleich sind. Die Daten können schlicht zu wenige oder zu instabil sein, um schon etwas daraus zu folgern. Um zu zeigen, dass ein Unterschied klein genug ist, um ihn zu ignorieren, legen Sie vorab fest, was „klein genug“ heißt. Ein nicht signifikantes Ergebnis ist kein Äquivalenznachweis. Ein statistischer Unterschied ist für sich genommen kein Grund, den Dienst zu wechseln. Nutzer müssen weiterhin die Kosten eines Fehlschlags, den Preis eines Aufrufs, die Latenz und die Kosten für Nacharbeit abwägen. Ein Unterschied kann echt und trotzdem zu klein sein, um die Wahl zu ändern. Die Statistik soll hier keinen professionell wirkenden p-Wert produzieren. Sie soll uns davon abhalten, mehr zu behaupten, als die Nachweise tragen.
4. Eine Baseline ist ein Versuchsvertrag, nicht der Satz „der Prompt war derselbe“
Viele Vergleiche scheitern, bevor der Stichprobenumfang überhaupt zum Thema wird. Die Stichproben waren von Anfang an nicht vergleichbar. Beide Seiten sollen „einen Pelikan zeichnen, der Fahrrad fährt“. Der eine Aufruf ist eine API-Anfrage in einer neuen Sitzung. Der andere läuft in einem Chatfenster, das schon Dutzende Runden hinter sich hat und in dem Tools aktiviert sind. Die eine Seite darf eine lange Ausgabe schreiben. Die andere stößt mittendrin an ein Längenlimit. Auch hundertfache Wiederholung erlaubt dann nicht, das Ergebnis einem Unterschied in der Modellfähigkeit zuzuschreiben.
Forschung zum Evaluationsstandard OLMES weist darauf hin, dass Evaluationsentscheidungen wie Prompt-Format, In-Context-Beispiele und Aufgabenformulierung die gemessene Leistung verändern. Ein reproduzierbarer Vergleich muss diese Einstellungen festhalten. Die Aufgaben dieser Arbeit sind nicht das Pelikan-SVG, aber ihre Warnung zur Versuchskonfiguration ist es wert, beherzigt zu werden.4 Ich würde die Baseline als Vertrag darüber verstehen, „was diese Runde eigentlich misst“.
Das Vergleichsobjekt sollte konkret sein: der Dienst, die Gruppe oder Route und die Modellversion, die Sie tatsächlich erhalten können. Wenn Sie nur einen Modell-Alias haben, der sich mit der Zeit ändern kann, notieren Sie den Alias. Wenn Sie den zugrunde liegenden Snapshot nicht kennen, schreiben Sie „unbekannt“. Behandeln Sie den Modellnamen, den die Schnittstelle zurückgibt, nicht als unabhängige Bestätigung der zugrunde liegenden Identität. Speichern Sie die Eingabe so vollständig wie möglich. Das ist mehr als der letzte Prompt. Dazu gehören System-Prompt, Verlauf, Anhänge und Tool-Einstellungen, soweit Sie sie steuern und beobachten können. Wenn die sichtbaren Bedingungen übereinstimmen, ist damit nicht bewiesen, dass auch die unsichtbaren übereinstimmen.
Notieren Sie bei den Generierungseinstellungen die Reasoning-Stufe, das Ausgabelimit und die Sampling-Parameter, die die Schnittstelle tatsächlich unterstützt. Schreiben Sie „nicht unterstützt“ für ein Feld, das die Schnittstelle nicht anbietet, und „unbekannt“ für ein Feld, bei dem Sie nicht bestätigen können, dass es gewirkt hat. Behandeln Sie diese Felder nicht stillschweigend als übereinstimmend. Eine Einstellung namens „high“ sollte bei zwei verschiedenen Modellen nicht automatisch dasselbe Rechenbudget bedeuten.
Zur Evaluationsumgebung gehört, wie Sie rendern und wie Sie bewerten. Prüfen Sie dasselbe SVG im selben Viewport und mit demselben Renderer. Nutzen Sie bei einer Animationsaufgabe den vereinbarten Beobachtungszeitraum. Sehen Sie sich nicht auf der einen Seite die ganze Bewegung an und picken auf der anderen ein einzelnes Bild heraus. Wenn die Aufgabe keine Animation verlangt hat, ziehen Sie keine Punkte dafür ab, dass die Ausgabe ein Standbild ist. Und schließlich: Legen Sie die Wiederholungsregel fest, bevor der Test beginnt. Ob ein erster Fehlschlag wiederholt werden darf, wie oft und ob Feedback erlaubt ist, gehört zu den Testbedingungen. Das improvisiert man nicht, wenn die Ergebnisse schon vorliegen.
Diese Dinge festzulegen, ist kein Versuch, ein „Labormodell“ zu bauen, das die Wirklichkeit hinter sich gelassen hat. Sie können durchaus das Standarderlebnis zweier Chatprodukte vergleichen. Die Schlussfolgerung sollte dann lauten: „Diese beiden Produkte unterscheiden sich darin, was sie mit Standardeinstellungen liefern“, und nicht: „Ich habe isoliert, welche zugrunde liegenden Modellgewichte besser sind.“ Eine Bedingung, die Sie nicht kontrollieren können, darf unbekannt bleiben. Eine unbekannte Bedingung darf nicht als kontrolliert aufgeschrieben werden.
5. Wie Sie den Test anordnen, ist oft wichtiger, als ihn einfach öfter laufen zu lassen
Binden Sie den Kanal nicht an die Tageszeit
Wer A komplett am Morgen und B komplett spät in der Nacht laufen lässt, vermischt „einen Unterschied zwischen den Kanälen“ mit „einem Unterschied über die Zeit“. Selbst wenn Sie einen Abstand sehen, lässt sich schwer sagen, wie viel davon an diesem Zeitfenster hängt. Für einen einfachen direkten Vergleich würde ich A und B innerhalb eines vorab gewählten Zeitfensters abwechselnd testen und die Reihenfolge zufällig wählen. Halten Sie die Parallelität so ähnlich wie möglich. Lassen Sie nicht eine Seite eine Anfrage nach der anderen abarbeiten, während die andere eine Lastspitze abbekommt.
Sie können noch einen Schritt weitergehen und das Zeitfenster in kleine Blöcke teilen, mit A und B in jedem Block. Neben dem Gesamtergebnis sehen Sie dann, ob sich der Unterschied auf einen einzelnen Block konzentriert. Eine zufällige Reihenfolge hilft, zeitliche Störeinflüsse zu verringern. Korrelationen durch ein gemeinsames Backend, einen kurzen Ausfall oder Ähnliches beseitigt sie nicht automatisch.
Eine Längsschnittfrage wie „Ist es schlechter als letzte Woche?“ ist etwas anderes. Die Zeit ist hier genau die Variable, die Sie untersuchen, also können Sie nicht beide Seiten auf denselben Moment festlegen. Behalten Sie Kernaufgabe, Konfiguration und Bewertungsregel so weit wie möglich bei, und lassen Sie in jedem Beobachtungszeitraum einen Referenzdienst mitlaufen. Vergleichen Sie die heutigen Ergebnisse nicht ewig mit dem einen besten Bild der letzten Woche. Behalten Sie beim Lesen eines Längsschnittergebnisses sowohl die absolute Bestehensquote als auch den relativen Abstand im Blick. Wenn der getestete Dienst und die Referenz beide nachlassen, kann der Abstand zwischen ihnen gleich bleiben. Das heißt nicht, dass sich das Erlebnis für die Nutzer nicht verschlechtert hat. Eine Referenz ist keine Wahrheit, die für immer richtig und für immer stabil ist.
Entscheiden Sie nicht beim Blick auf die Ergebnisse, wann Sie aufhören
„Fünfmal laufen lassen. Wenn A gewinnt, posten. Wenn A nicht gewinnt, weitermachen, bis der Unterschied signifikant ist.“ Das sieht aus, als kämen nur Stichproben hinzu. Tatsächlich ändert es die statistische Regel. Wer bei einem Test mit festem Stichprobenumfang immer wieder in die Daten schaut und aufgrund dessen aufhört, hebelt die Kontrolle falsch positiver Ergebnisse aus, für die der Test gebaut wurde. Ein Test, bei dem die Daten laufend beobachtet werden sollen, braucht ein Verfahren, das für die sequenzielle Analyse entwickelt wurde.5 Die meisten Menschen müssen nicht mit sequenzieller Statistik anfangen. Am einfachsten ist es, vor der Runde aufzuschreiben, wie viele Durchläufe Sie machen, welche primäre Kennzahl Sie verwenden und welche primären Vergleiche Sie anstellen. Bewahren Sie dann jedes Ergebnis auf.
Erst ein paar Aufrufe auszuprobieren, um zu bestätigen, dass Schnittstelle und Bewertungsablauf funktionieren, ist in Ordnung. Das sind Probeläufe. Wenn Sie mit den Änderungen am Ablauf fertig sind, starten Sie den formalen Test separat. Vermischen Sie die Ergebnisse aus der Feinabstimmung der Aufgabe nicht mit den formalen Ergebnissen. Dasselbe gilt für zwei weitere Gewohnheiten. Dutzende Aufgaben auszuprobieren und nur die zu veröffentlichen, die am besten aussieht, oder zu sehen, dass die Gesamtpunktzahl zurückliegt, und dann in einer Teilwertung den Sieg auszurufen, ist nicht der Vergleich, den Sie vorab vereinbart haben.
Behandeln Sie hundert Wiederholungen einer Aufgabe nicht wie hundert Aufgaben
Wiederholtes Generieren zeigt Ihnen, wie zuverlässig der Dienst bei dieser einen Aufgabe ist. Es erweitert die Aussage nicht automatisch. Ein Pelikan, der stabil gelingt, bedeutet für sich genommen nicht, dass Code-Debugging, lange Analysen und das Befolgen komplexer Anweisungen genauso zuverlässig sind. Wenn Sie auf eine ganze Klasse von Aufgaben schließen, sind die Schwankung zwischen Aufgaben und die Schwankung über Wiederholungen einer Aufgabe zwei verschiedene Arten von Unsicherheit. Die Evaluationsforschung unterscheidet zwischen wiederholtem Sampling, Vergleichen auf Aufgabenebene und dem Umgang mit geclusterten, voneinander abhängigen Stichproben.6
Ich würde deshalb zuerst mit einer Prüffrage die Wiederholbarkeit beobachten und dann einen kleinen Satz fester Aufgaben hinzunehmen, die mit dem tatsächlichen Einsatz zu tun haben. Beide Seiten beantworten denselben Satz. Berechnen Sie das Ergebnis pro Aufgabe und den Unterschied pro Aufgabe, bevor Sie aggregieren. Präsentieren Sie nicht nur eine Gesamtpunktzahl. Wenn Sie eine formale Analyse über mehrere Aufgaben durchführen, erhalten Sie die Zuordnung nach gleicher Aufgabe und gleichem Block. Sie können „10 Aufgaben, je 10-mal“ nicht als „100 unabhängige Aufgaben“ behandeln und die Rechnung für eine einzelne Aufgabe von oben wiederverwenden.
Es gibt noch eine kleinere Falle. Ein fester Seed ist nützlich, wenn Sie einem Reproduktionsproblem nachgehen. Eine fast unveränderte Ausgabe desselben Seeds zwanzigmal zu kopieren, ergibt aber keine zwanzig unabhängigen Beobachtungen der zufälligen Ausgabeverteilung. Wenn Sie Stabilität messen, vereinbaren Sie die Sampling-Strategie vorab. Eine Schnittstelle, die Seeds unterstützt, kann mehrere vorab erzeugte Seeds verwenden. Bei einer Schnittstelle, die das nicht tut, sollte diese Einschränkung festgehalten werden. Wie ein Aufgabensatz langfristig aktualisiert werden sollte, ist eine eigene Frage. Zumindest innerhalb dieses einen Vergleichs sollten Sie nicht die Aufgaben wechseln und dann alte und neue Punktzahlen zu einer Kurve „das Modell wird besser“ verbinden.
6. Timeouts, Abbrüche und eine falsche Zeichnung gehören nicht auf einen Haufen
Eine häufige statistische Verzerrung besteht darin, nur die Werke zu bewerten, die erfolgreich zurückkamen, und Timeouts und Fehler einfach zu löschen. Die Punktzahl, die Sie dann erhalten, beantwortet die Frage: „Wenn eine vollständige Ausgabe vorliegt, wie oft besteht sie?“ Sie beantwortet nicht die Frage, die Nutzern wichtiger ist: „Wenn ich eine Anfrage sende, bekomme ich dann ein bestandenes Ergebnis?“ Angenommen, 20 Anfragen wurden vorab eingeplant, und 4 davon liefen in einen Timeout. Die übrigen 16 lieferten ein vollständiges Werk, und 8 davon bestanden. Die Bestehensquote unter den vollständigen Ausgaben liegt bei 50 %. Die Quote bestandener Erstlieferungen, gezählt über alle 20 Anfragen, liegt bei 40 %. Wer nur die erste Zahl veröffentlicht, lässt die vier Fälle weg, in denen die Nutzer gar nichts bekommen haben.
Ich würde drei Arten von Ergebnissen gleichzeitig festhalten: einen technischen Lieferausfall, eine vollständige Rückgabe, die die Aufgabe nicht besteht, und eine vollständige Rückgabe, die die Aufgabe besteht. Timeouts, Schnittstellenfehler, abgebrochene Streams und das Erreichen des Längenlimits sollten jeweils mit ihrem eigenen Grund erfasst werden. Sie getrennt zu erfassen, entschuldigt keinen Ausfall des Dienstes. Für jemanden, der einen Dienst auswählt, kosten ein Timeout und eine falsche Zeichnung beide Zeit. Wenn Sie aber einer Ursache nachgehen, sollten nicht alle als „die Intelligenz des Modells hat nachgelassen“ beschrieben werden. Ein Fehler im lokalen Netzwerk oder im Testskript sollte gesondert aufgeführt werden. Ob er ausgeschlossen wird, braucht eine vorab festgelegte Regel. Sie können keine Stichprobe löschen, nachdem Sie gesehen haben, welche Seite verloren hat.
Ich würde lieber den Anteil erster Anfragen mit bestandenem Ergebnis zur primären Kennzahl machen und die inhaltliche Bestehensquote unter vollständigen Ausgaben, die technische Ausfallquote, die Latenz und die Kosten als Erklärung danebenstellen. Die inhaltliche Bestehensquote bei vollständigen Ausgaben ist ebenfalls kein unverzerrter Wert für „reine Fähigkeit“. Wenn komplexe Anfragen eher in einen Timeout laufen, waren die verbleibenden Werke womöglich von vornherein einfacher. Diese Quote kann helfen, ein Problem einzugrenzen. Das über alle Anfragen gezählte Ergebnis kann sie nicht ersetzen.
„Gelingt es nach einer Korrektur?“ kann ein eigener Test sein, mit derselben Korrekturchance für beide Seiten. Begleiten Sie nicht die eine Seite geduldig durch fünf Korrekturrunden, während Sie die andere beim ersten Fehler abschreiben.
7. Ein minimaler Vergleich, den jeder tatsächlich durchführen kann
Sie müssen keine Evaluationsplattform bauen, bevor Sie einen Pelikan testen. Hier ist ein Plan für den Einstieg. Er dient dazu, einen offensichtlichen Unterschied bei einer festen Prüffrage zu prüfen. Er ist kein Stichprobendesign, das garantiert, einen kleinen Rückgang zu erkennen.
| Punkt | Vereinbarung für diese Runde |
|---|---|
| Frage | Unterscheiden sich die Dienste A und B bei dieser festen Aufgabe im Anteil bestandener Erstlieferungen? |
| Eingabe und Einstellungen | Die vollständige sichtbare Anfrage speichern. Die steuerbaren Parameter angleichen. Unterschiede festhalten, die sich nicht bestätigen lassen. |
| Stichprobe | Pro Seite vorab 20 formale Anfragen einplanen. Probeläufe aus der formalen Stichprobe heraushalten. |
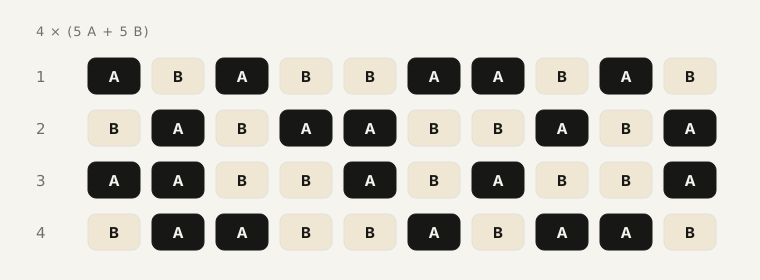
| Zeit und Reihenfolge | Ein vorab festgelegtes Zeitfenster in 4 Blöcke mit je 5 Aufrufen für A und B teilen. Innerhalb des Blocks zufällig abwechseln, nach derselben Regel für die Parallelität. |
| Wiederholungen | Der formale Erstantwort-Test sieht keine Wiederholung vor. Für die Messung von Korrekturen ein eigenes Experiment aufsetzen. |
| Bewertung | Die Bestehensregel vor dem ersten Durchlauf festlegen. Nach dem Rendern den Kanalnamen verbergen, die Reihenfolge mischen und erst dann bewerten. |
| Ausgabe | Jedes Rohergebnis, den Status jedes Aufrufs, die Begründung jeder Bewertung sowie die Statistik pro Block und insgesamt speichern. |
Eine einfache Bestehensregel ist für die Pelikan-Aufgabe ein guter Anfang. Rendert die Datei in der vereinbarten Umgebung? Sind Figur und Fahrrad vollständig genug, um sie zu erkennen? Ist eine zentrale Struktur offensichtlich falsch? Halten die Kontakte, die die Aufgabe verlangt, etwa zwischen Fuß und Pedal, tatsächlich? Schönheit können Sie gesondert notieren. Eine sorgfältige Farbgebung kann einen strukturellen Fehler nicht ausgleichen.
Wenn jemand bei einer Grenzfall-Stichprobe unsicher ist, markieren Sie sie als strittig und folgen der vorab festgelegten Prüfregel. Entscheiden Sie nicht erst über das Bestehen, nachdem Sie den Kanalnamen gesehen haben. Ein kleiner Test lässt sich von Hand und blind bewerten. Wächst der Umfang, sind automatische Bewertung und die Kalibrierung der Bewerter die nächste Frage. Das muss nicht alles schon in der ersten Runde gelöst sein. Das Protokollieren wird viel einfacher, wenn Sie die Konfiguration, die zur Runde gehört, vom Log mit einer Zeile pro Aufruf trennen. Die Rundenkonfiguration enthält die rohe Anfragevorlage, die Parameter, die Aufgabenversion, die Version der Bewertungsregel, das Zeitfenster sowie die Vereinbarung zu Timeout und Wiederholungen. Jeder Aufruf sollte mindestens diese Felder festhalten:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathSchreiben Sie Zeitangaben mit Zeitzone. Verknüpfen Sie die rohe Antwort, das extrahierte SVG und das gerenderte Bild über artifact_path. Token-Zahlen, Backend-Fingerabdrücke und alles andere, was die Schnittstelle offenlegt, können Sie daneben speichern. Wurde etwas nicht bereitgestellt, notieren Sie es als leer oder unbekannt. request_hash prüft, ob die Anfrage gleich geblieben ist. Die rohe Anfrage ersetzt es nicht. Wenn Sie das Log speichern oder teilen, entfernen Sie API-Schlüssel und schwärzen Sie privaten Kontext oder andere sensible Inhalte. Für eine öffentliche Überprüfung braucht man die Versuchsbedingungen – nicht gleich auch die Zugangsdaten des Kontos.
Schauen Sie bei der Auswertung zuerst auf den Gesamtabstand und auf das Ergebnis jedes Blocks. Das Binomialintervall und der exakte Fisher-Test von oben gelten, wenn ihre Annahmen, darunter Unabhängigkeit und Stabilität, ungefähr erfüllt sind. Wenn das Ergebnis deutlich vom Block abhängt oder Sie später auf wiederholte Tests mit mehreren Aufgaben erweitern, werten Sie passend zum verbundenen Design aus. Verwenden Sie die Formel für eine einzelne Aufgabe nicht mechanisch wieder. Wenn ein erster Unterschied es wert ist, ihm nachzugehen, testen Sie erneut in einem neuen, vorab festgelegten Zeitfenster und nehmen Aufgaben hinzu, die mit Ihrem tatsächlichen Einsatz zu tun haben. Die erste Runde ist ein Hinweis auf eine Auffälligkeit. Erst eine separate neue Runde hilft zu beurteilen, ob sie weiterhin besteht.
8. Wie sollte die Schlussfolgerung lauten, wenn Sie einen Unterschied gefunden haben?
Mit denselben Lehrbeispielzahlen kann eine zurückhaltende und trotzdem nützliche Schlussfolgerung so lauten:
Mit der festen Aufgabe dieser Runde, angeglichenen sichtbaren Einstellungen und in einem vorab festgelegten Zeitfenster wurden A und B jeweils 20-mal getestet. Bestandene Erstlieferungen: 16 und 8. Die Bestehensquoten in der Stichprobe unterscheiden sich um 40 Prozentpunkte. Unter Annahmen, zu denen unabhängiges Sampling gehört, ergibt ein zweiseitiger exakter Fisher-Test einen p-Wert von etwa 0,0225. Das stützt einen Unterschied unter den Bedingungen dieser Runde. Das Ergebnis muss noch in anderen Zeitfenstern und bei verwandten Aufgaben geprüft werden. Für sich allein kann es die konkrete Ursache einer Änderung am zugrunde liegenden Modell oder an der Serverkonfiguration nicht identifizieren.
Das ist weniger aufregend als ein „Beweis für volle Leistung“. Dafür gibt es der nächsten Person die Bedingungen an die Hand, die sie braucht, um das Ergebnis nachzuprüfen. Wenn spätere Tests zu anderen Zeiten und bei verwandten Aufgaben weiter in dieselbe Richtung zeigen, haben wir einen stärkeren Grund zu sagen, dass dieser Dienst für diese Einsätze weniger zuverlässig ist als die Referenz oder tatsächlich hinter seine eigene historische Baseline zurückgefallen ist. Der Sprung von „die gelieferten Ergebnisse sind schlechter geworden“ zu „die haben heimlich ein kleineres Modell eingesetzt“ bleibt trotzdem ein zusätzlicher Schritt. Um einen konkreten Mechanismus zu bestätigen, braucht es unabhängige Nachweise, die die Erklärungen voneinander unterscheiden können, etwa Routing- oder Konfigurationsaufzeichnungen, die sich überprüfen lassen. Der Ausgabestil reicht nicht aus, um das Modell zu erraten.
Das heißt auch nicht, dass Nutzer warten müssen, bis die Ursache bekannt ist, bevor sie wechseln dürfen. Die Wahl eines Dienstes hängt davon ab, ob er Ihre Anforderungen erfüllt. Wer eine konkrete Ursache behauptet, braucht Nachweise für genau diese Ursache. Beides lässt sich getrennt halten.
9. Was sich wirklich einsparen lässt, ist der Aufwand, die Frage sauber zu belegen
Das Anstrengende an einem manuellen Test ist meist nicht der Klick auf „Ausführen“. Es ist die wiederholte Arbeit danach. Wo liegt die Datei? Haben sich die Parameter geändert? Die wievielte Generierung ist dieses Bild? War es eine Wiederholung? Lässt sich der Screenshot noch der rohen Antwort zuordnen? Ohne diese Aufzeichnungen können von der Überzeugung „es ist wirklich dümmer geworden“ eine Woche später nur noch ein paar Screenshots übrig sein, die niemand nachprüfen kann.
Wenn Sie sich nur einen ersten Eindruck verschaffen wollen, wie sich verschiedene Dienste verhalten, muss nicht jeder bei null anfangen. Sie können bei Folkbench beginnen, sich die öffentlichen Ranglisten und den Zugang zu den Testberichten ansehen und prüfen, ob es für das Modell, die Dienstgruppe und die Kennzahl, die Sie interessieren, schon ein Ergebnis gibt. Die öffentlichen Seiten betonen den Vergleich von Diensten unter demselben Modell, und die Ranglisten weisen auch darauf hin, dass die Zahlen der Gruppe in einer Zeile nicht für alle Gruppen dieses Relays stehen.7
Eine veröffentlichte Rangliste sollte den Aufwand für Sammeln und Aufbereiten verringern. Sie sollte kein Grund sein, die Bedingungen nicht mehr zu prüfen. Bei jeder Rangliste, auch bei Folkbench, lohnt es sich nachzufragen: Wann wurde gemessen, was wurde gemessen, wie groß war die Stichprobe, wurden die Fehlschläge aufbewahrt, und für welchen Bereich gilt die Schlussfolgerung? Informationen, die nicht öffentlich sind, bleiben unbekannt. Zurück zur Ausgangsfrage: Wie viel von „das Modell ist dümmer geworden“ ist echt, und wie viel ist die Täuschung durch eine einzelne Stichprobe?
Solange es keine gemeinsame Definition, keine vollständige Stichprobe und keine vergleichbaren Bedingungen gibt, schafft eine einzelne Gesamtprozentzahl nur neuen Aberglauben. Besser machen können wir es, indem wir jeden konkreten Verdacht Schritt für Schritt in ein Urteil verwandeln, das sich überprüfen lässt. Wenn Sie einen Fehlschlag sehen, bewahren Sie das Rohergebnis auf. Wenn Sie einen Rückgang vermuten, starten Sie einen Vergleich. Wenn Sie einen Unterschied finden, gehen Sie erst dann der Ursache nach. Versuchen Sie nicht, all diese Schritte in einem einzigen Screenshot zu erledigen. Ein Screenshot kann eine gute Frage stellen. Um sie zu beantworten, braucht es trotzdem ein ordentliches Experiment.
Anmerkungen und Quellen
- OpenAI, How to make your completions outputs consistent with the new seed parameter, ein archiviertes Cookbook-Beispiel. Der Hinweis beschreibt einen festen Seed als Bemühen um Determinismus, nicht als Garantie. Dieser Artikel zitiert nur diese Grenze der Reproduzierbarkeit. Er behandelt die älteren Modellnamen und die Parameterunterstützung auf jener Seite nicht als aktuelle Produktbeschreibung. Quelle↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, Abschnitt 7.2.4.1, Confidence intervals, Wilson-Intervall für einen Anteil. Dieser Artikel verwendet zweiseitige 95-%-Wilson-Intervalle für 16/20 und 8/20. Die Autorin hat sie nach der Formel berechnet und in Prozent auf eine Nachkommastelle gerundet. Das Konfidenzniveau beschreibt die langfristige Überdeckung des Intervallverfahrens. Das Wilson-Verfahren ist eine Näherung. Quelle↩
- SciPy-Dokumentation,
scipy.stats.fisher_exact. Dieser Artikel verwendet die Kontingenztafel[[16, 4], [8, 12]]mitalternative="two-sided"und erhältp = 0.0224774273717544. Das ist eine Berechnung mit den Beispieldaten, kein gemessenes Ergebnis aus einer Veröffentlichung oder einem Plattformbericht. Das Beispiel vergleicht unabhängige binomiale Ergebnisse. Gepaarte Daten, Clusterung über Aufgaben, zeitliche Abhängigkeit oder Mehrfachvergleiche erfordern eine Analyse, die zum Design passt. Quelle↩ - Yuling Gu et al., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. Die Arbeit diskutiert Evaluationsdetails wie Prompt-Format, die Auswahl von In-Context-Beispielen und die Aufgabenformulierung sowie die Anforderungen an einen reproduzierbaren Vergleich. Quelle↩
- Ramesh Johari, Leo Pekelis und David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, überarbeitete Fassung von 2019. Die Arbeit diskutiert das Problem, Ergebnisse laufend zu beobachten und davon den Stichprobenumfang abhängig zu machen, sowie die sequenziellen Inferenzverfahren, die dieses Problem lösen. Quelle↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Zu Unsicherheit auf Aufgabenebene, wiederholtem Sampling, gepaarten Vergleichen und geclusterten Stichproben siehe die Abschnitte 2, 3 und 4. Zur Planung des Stichprobenumfangs siehe Abschnitt 5. Quelle↩
- Öffentliche Startseite und Ranglisten-Seiten von Folkbench, abgerufen am 5. Oktober 2026. Dieser Artikel nutzt diese öffentlichen Seiten nur, um den Einstieg, den Vergleichsumfang und den Hinweis auf Gruppenebene zu beschreiben. Er bestätigt keine konkrete Zahl einer Rangliste unabhängig, und er behauptet nicht, dass Folkbench bereits jedes hier vorgeschlagene Versuchsverfahren umsetzt. Startseite; Ranglisten↩