Cuando alguien pide a un modelo que resuelva un conflicto en el trabajo, la pregunta suele ser: «El jefe dijo esto. ¿Cómo le contesto?»
Parece un ejercicio de pulir el tono. Se parece más a un problema con varias metas que se estorban. No basta con ser cortés. La respuesta tiene que hacer varias cosas a la vez: no puede aceptar en silencio un reproche inexacto, no puede convertir la sala en un enfrentamiento, no puede apartar la parte que sí le toca a quien escribe, y no puede cargar con la responsabilidad de los demás. Al mismo tiempo tiene que dejar los hechos necesarios, el tiempo y el siguiente paso, para que el trabajo siga adelante.
La prueba de Folkbench, «Un jefe sarcástico: ¿quién lo resuelve?», mide justo esa capa. No pide un consejo genérico sobre qué hacer ante la manipulación en el trabajo. Da 12 situaciones con un contexto concreto, una relación de poder y una restricción de entrega, y pide una respuesta que una persona normal se atrevería a enviar sin agrandar el problema.
Esto no es una prueba de cómo replicarle al jefe
Las 12 situaciones cubren varias presiones habituales: en el grupo dejan caer que «últimamente se te ve bastante relajado»; en público preguntan si ya no quieres el puesto; tras un mal resultado del proyecto dicen que «deberías haberlo pensado antes»; un cambio de requisitos no se avisó y aun así te piden que lo empujes; el plan queda vacío porque faltan datos de arriba; el jefe resta importancia a una contribución; delante del cliente dicen que «no lo tienes muy visto»; la evaluación solo dice «falta de iniciativa»; el fin de semana piden «echarle un vistazo»; hay que dejar constancia por escrito después de un cambio de prioridad; y detrás de «los jóvenes deben aguantar un poco más» hay una negociación de calendario.
Cómo se hace la prueba
Los cuatro modelos vieron las mismas situaciones de la versión 1 actual y las mismas reglas de salida. La página solo recoge los 48 resultados cuyo promptHash coincide: 12 preguntas, con la respuesta de cada uno de los cuatro modelos.
La puntuación por reglas mira cinco cosas:
- ¿Se puede enviar tal cual?
- ¿Protege los hechos propios y el límite de responsabilidad?
- ¿Hace que el asunto crezca?
- ¿Tiene sentido de la medida?
- ¿El siguiente paso está claro?
La página también anota avisos de regla y riesgos duros. La puntuación solo compara estos 12 enunciados compartidos. No significa que un modelo tenga una habilidad laboral general, y no es un consejo de derecho laboral.
El resultado: las medias están cerca y los perfiles no
| Modelo | Media de reglas | Preguntas en cabeza, con empates | Riesgos duros | Avisos de regla |
|---|---|---|---|---|
| GPT-5.6 Sol | 74.3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72.5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72.2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70.2 | 2/12 | 0 | 6 |
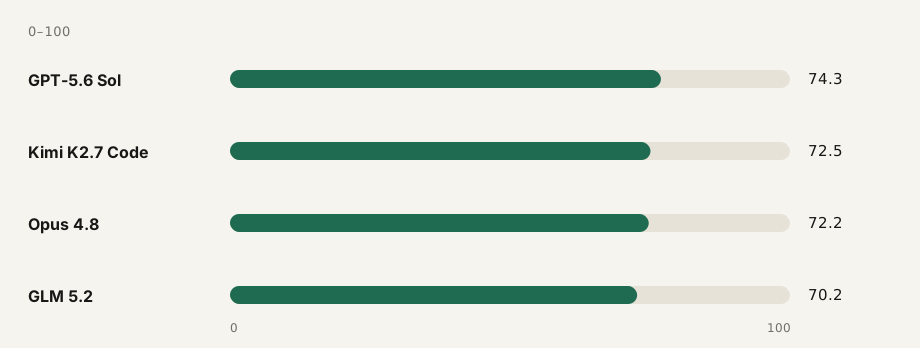
GPT-5.6 Sol solo saca 1.8 puntos al segundo. En la página, aun así, queda primero de los cuatro en «se puede enviar», en el límite y en el siguiente paso. Encaja sobre todo cuando hay que dejar claras la prioridad, la hora y la relación de responsabilidad.
Kimi K2.7 Code saca 80.7 en reconocimiento de la situación, la nota más alta de los cuatro. En «siguiente paso» se queda en 58.3. A veces ya ha visto el problema y no deja fijados el responsable, el momento o el gesto de confirmación.
Opus 4.8 saca 70.3 en bajar la temperatura, un poco por encima de los demás, y destaca en preguntas de límite como «echarle un vistazo el fin de semana» y «los jóvenes deben aguantar un poco más». La página también registra un arranque de plantilla en 4 preguntas y un marcador de posición sin sustituir en 1 pregunta. Hay que leerlo entero antes de copiarlo.
GLM 5.2 lista bien hechos, huecos y acciones siguientes cuando faltan datos o cuando toca reconocer un error en el grupo. Seis preguntas llevan un aviso de plantilla del tipo «podrías contestar así», y el tono de plantilla pesa más.
Cuatro escenas, cuatro problemas de trabajo
«Últimamente se te ve bastante relajado»: no aceptes la etiqueta equivocada
Quien escribe está corrigiendo un plan que el viernes se entrega al cliente y no ha respondido a tiempo un mensaje no urgente del grupo. El jefe dice: «Últimamente se te ve bastante relajado».
Sol no discute «yo no estoy nada relajado». Explica que está concentrado en la corrección, que la estructura y los datos centrales ya están revisados, que la primera versión sale a las 17:00, y que la prioridad se puede mover si aparece algo más urgente.
El mensaje explica primero la razón concreta de la respuesta tardía, luego usa el avance y la hora de entrega para mostrar que el trabajo sigue, y al final devuelve la conversación de «¿estás vagueando?» a «¿qué es más urgente ahora?». No acepta el juicio implícito de «relajado» y no desenmascara en el grupo la ironía del jefe.
«Falta de iniciativa»: convertir una etiqueta vaga en un criterio de conducta
En la conversación de desempeño el jefe solo dice: «La actitud está bien; lo que falta es iniciativa». El formulario dice lo mismo, «falta de iniciativa». El siguiente ciclo de evaluación dura 6 semanas.
Kimi no rebate al momento ni dice un «me esforzaré por mejorar» vacío. Pregunta a qué se refiere «iniciativa»: a intentar una salida antes de escalar, o a informar sin que se lo pidan; a poca actividad entre equipos, o a no pedir tareas nuevas. Después pregunta cuál es el criterio de aprobado y el de notable en el siguiente ciclo, para que la evaluación caiga en cada semana o en cada hito del proyecto.
Así una etiqueta de carácter, difícil de discutir, se vuelve un criterio de conducta que se puede ejemplificar, observar y revisar. La versión de Sol da un paso más: informe semanal de riesgos, una alternativa cuando aparece un problema y una revisión a mitad de camino en la semana 3. Ver el problema y hacerlo avanzar son dos capacidades distintas.
«¿Por qué el plan sigue tan vacío?»: el límite de responsabilidad se construye con hechos
Al plan del evento le faltan el alcance confirmado por arriba, los datos de conversión de los últimos 30 días y el techo de presupuesto. El índice, el flujo y las partes generales que no dependen de esos datos ya están hechos, y la lista de materiales se envió dos veces. En el grupo el jefe dice: «¿Por qué el plan sigue tan vacío? No lo estás empujando con suficiente iniciativa, ¿verdad?»
GLM saca 81.4 en esta pregunta, la nota más alta de los cuatro. Escribe primero lo que ya está hecho, lista los tres huecos, recuerda los envíos y los avisos anteriores, y cierra con un plan: respuesta antes de las 17:00 de mañana y, cuando lleguen los datos, completar el plan en dos días hábiles. Si el material formal todavía no se puede dar, basta un alcance o un valor provisional para seguir con supuestos explícitos.
Esta respuesta no convierte «no me pasaron los datos» en una queja. Lo convierte en una dependencia que el equipo puede tratar junto. El límite de responsabilidad no se construye con un «esto no es culpa mía». Se construye con el registro de lo hecho, la dependencia y el momento.
«Los jóvenes deben aguantar un poco más»: devolver un juicio de valor al calendario
Quien escribe lleva a la vez la liquidación de miembros que sale este viernes, el informe de operaciones que se entrega el martes siguiente y un ajuste de estilo del panel interno que no depende de nadie más. El jefe dice que «aguantar un poco más es bueno para los jóvenes». La persona quiere un calendario razonable y no quiere cerrar la conversación de un portazo.
Opus saca 82.1 en esta pregunta, la nota más alta de una sola pregunta en todo el conjunto. No abre un debate sobre el valor de «aguantar». Ordena los tres trabajos por fecha: primero la liquidación de miembros, segundo el informe de operaciones, y el ajuste de estilo se corre una semana. Si ese ajuste también tiene una fecha rígida, el orden se revisa.
Una respuesta útil no rebate la frase. Cambia «¿estás dispuesto a aguantar?» por «en el tiempo que hay, qué entregas conviene asegurar primero».
A qué se parece cada modelo
GPT-5.6 Sol: una respuesta de entrega, estable. Suele bajar el texto a hechos, tiempo y siguiente paso. La constancia escrita, el momento delante del cliente y la confirmación del calendario le salen con más firmeza. La página también avisa de que las respuestas de Sol a veces se alargan. En una disputa de desempeño o de responsabilidad, quien escribe todavía tiene que añadir un criterio más claro, un responsable y una fecha límite.
Kimi K2.7 Code: lee la situación, y hay que revisar el cierre. Sabe leer la relación y la presión que hay detrás de una frase, sobre todo en una conversación de desempeño o en una repregunta de reunión. Antes de usarlo, conviene mirar si quedaron escritos el responsable, el momento y la confirmación.
Opus 4.8: baja la temperatura, y antes de copiar hay que limpiar. Sabe dejar una salida a la otra persona y trata bien los límites, como negar el trabajo de fin de semana o pedir un calendario. El texto se alarga y la plantilla se nota más. Hay que quitar la explicación, los paréntesis y los marcadores, y luego comprobar que el mensaje encaja con la relación real.
GLM 5.2: fuerte en la lista, y hay que quitarle el tono de clase. Separa bien «hecho, hueco, responsable, siguiente paso», y eso sirve para empujar un proyecto o revisar un retraso. El problema es que la respuesta y la explicación didáctica suelen ir mezcladas. Conviene pedirle que escriba solo el texto final que se puede enviar.
Un marco de cuatro pasos que cualquiera puede reutilizar
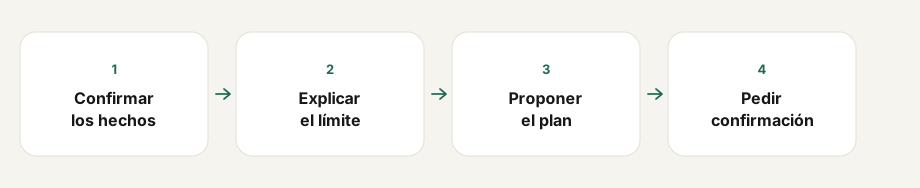
Sea cual sea el modelo, una respuesta de trabajo se puede ordenar así:
- Confirmar los hechos. Escribir qué se está haciendo, qué ya está hecho y cuándo ocurrió el cambio.
- Reconocer la parte controlable. Si el calendario no dejó margen, o el riesgo se avisó tarde, se admite esa conducta concreta. No se asume toda la responsabilidad en una frase vaga.
- Escribir el límite como un plan. Nombrar la dependencia, la prioridad, la entrega que se mueve y la nueva hora. No quedarse en «esto no es responsabilidad mía».
- Dar el siguiente paso y pedir confirmación. Dejar claro quién hace qué, para cuándo, y cómo se ajusta el plan si cambia una condición.
Cabe en una frase:
Confirmar los hechos → Explicar el límite → Proponer el plan → Pedir confirmación.
Poder copiar y enviar también debería ser una medida
Aunque el modelo juzgue bien, la salida puede no servir para enviarla. El riesgo no está solo en un hecho falso o en un tono inadecuado. El mensaje puede llevar todavía un «podrías contestar así», un «abajo va la razón», un nombre que nadie sustituyó, una nota entre paréntesis, o un párrafo entero de análisis que solo debía ver quien pregunta.
Una evaluación de tareas reales tiene que separar al menos dos cosas: si el modelo propuso una estrategia de comunicación acertada, y si separó el mensaje final de la explicación. Lo primero es la calidad del consejo. Lo segundo es si se puede copiar y enviar. Folkbench puntúa aparte «¿se puede enviar tal cual?» porque quien lo usa no necesita solo una respuesta que suene lista. Necesita un texto de trabajo que pueda controlar, corregir y mandar.
El límite de este conjunto de resultados
En las 12 situaciones concretas de la versión 1 actual, los cuatro modelos tratan los hechos, el límite, la relación y el siguiente paso de formas que se pueden observar. Sol entrega con más estabilidad una respuesta que se puede mandar. Kimi lee mejor la situación. Opus baja mejor la temperatura y negocia el límite. GLM avanza mejor en forma de lista.
El conjunto no demuestra que un modelo sea mejor en toda comunicación de trabajo, ni que uno «entienda mejor a las personas». El tamaño de la muestra, los enunciados, la versión del modelo, las reglas de salida y las reglas de puntuación cambian el resultado. Sol solo saca 1.8 puntos a Kimi, y eso no sostiene una conclusión de barrido total. La puntuación de la página tampoco es una opinión de derecho laboral. Una decisión real sobre desempeño, disciplina, sueldo o un conflicto laboral no puede apoyarse solo en un mensaje generado por un modelo.
El título de un jefe sarcástico hace pensar en técnicas para replicar. Lo que esta prueba mide es otra capacidad, más difícil: dentro de una relación desigual, no entregarse a una etiqueta vaga, no empujar la conversación a un conflicto abierto, y aun así dejar constancia, obtener una confirmación y seguir avanzando.