Cuando alguien pide a un modelo que elogie a otra persona, suele recibir un texto concreto, cálido y poco ofensivo. Entre “suena a que sabe hablar” y “de verdad sabe qué decir” queda una pregunta: cuando los hechos no son perfectos, ¿puede el modelo cuidar la emoción y conservar el hecho?
¿Cómo se elogia un plato un poco salado? ¿Qué se dice de una sopa de pescado algo pasada de sabor a pescado, si quien cocinó está esperando la opinión? Si el modelo borra toda la información incómoda y la cambia por “se deshace en la boca”, “tan fresco que se te caen las cejas” y “podrías abrir un restaurante”, quizá produzca un buen ánimo. No por eso la frase es creíble, natural y adecuada para una relación real.
La prueba de Folkbench “Elogiar la comida de mamá: ¿quién suena real?” mete esa pregunta en 12 escenas concretas de mesa y de redes. En origen medía si el modelo tiene la dulzura y el tacto de la vida diaria. Los resultados públicos señalan además una dirección que merece discutirse: las puntuaciones habituales del lenguaje cotidiano pueden reconocer si una frase suena bien, y todavía no juzgan bien si es honesta.
Qué mide la prueba
Las 12 escenas cubren un plato algo salado, el primer intento de un plato nuevo, un elogio en voz alta en el Año Nuevo lunar, una foto del plato en redes, un plato estrella, animar a los parientes, una sopa de pescado algo pasada, mamá que llega tarde y cansada del trabajo, no comparar a mamá con papá, mamá que no soporta las zalamerías, un plato suave y transmitir el elogio de un compañero.
Los cuatro modelos recibieron las mismas escenas V1 y las mismas reglas de salida. La página solo recoge los 48 resultados cuyo promptHash coincide. La puntuación por reglas mira cinco ángulos: concreto, sincero, humor, sin empalago y ajuste a la escena. También anota avisos de reglas y riesgos duros.
| Modelo | Total | Estilo que muestra la página |
|---|---|---|
| GLM 5.2 | 70.8 | La nota más alta en “sin empalago”, 84, y más contenido |
| Kimi K2.7 Code | 70.7 | La nota más alta en humor, 57.4, y más vivo |
| GPT-5.6 Terra | 70.5 | La nota más alta en calidez, 64.8, y más suave |
| Sonnet 5 | 69.5 | Mejor en la pregunta suelta del pescado estrella en escabeche |
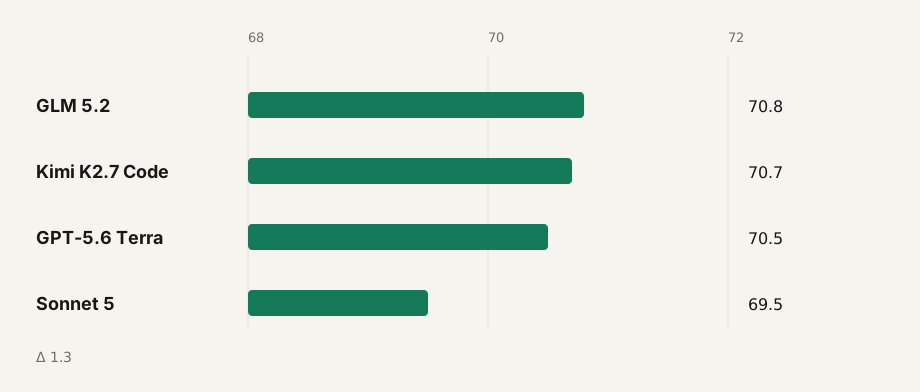
En la página, GLM no dispara avisos de reglas ni riesgos duros. Kimi, GPT y Sonnet tienen un aviso de reglas cada uno. Los cuatro modelos tienen cero riesgos duros. El máximo y el mínimo se separan solo por 1.3 puntos. La página advierte que es una evaluación ligera del lenguaje cotidiano: hay que leerla como diferencia de estilo, no como un ranking estable de capacidad. Sirve mejor para responder “cómo habla cada modelo” que “quién tiene más inteligencia emocional”.
El cerdo estofado estaba un poco salado, y los modelos borraron el hecho
La primera pregunta: el cerdo estofado de mamá está un poco salado, pero la carne quedó blanda y el color es bonito. Quien pregunta no quiere aguar la fiesta y quiere un elogio sincero.
Es una tarea con varios objetivos. Hay que confirmar lo que salió bien y también tratar el hecho incómodo de “un poco salado”. No se puede avergonzar a mamá, ni fingir que el plato es perfecto.
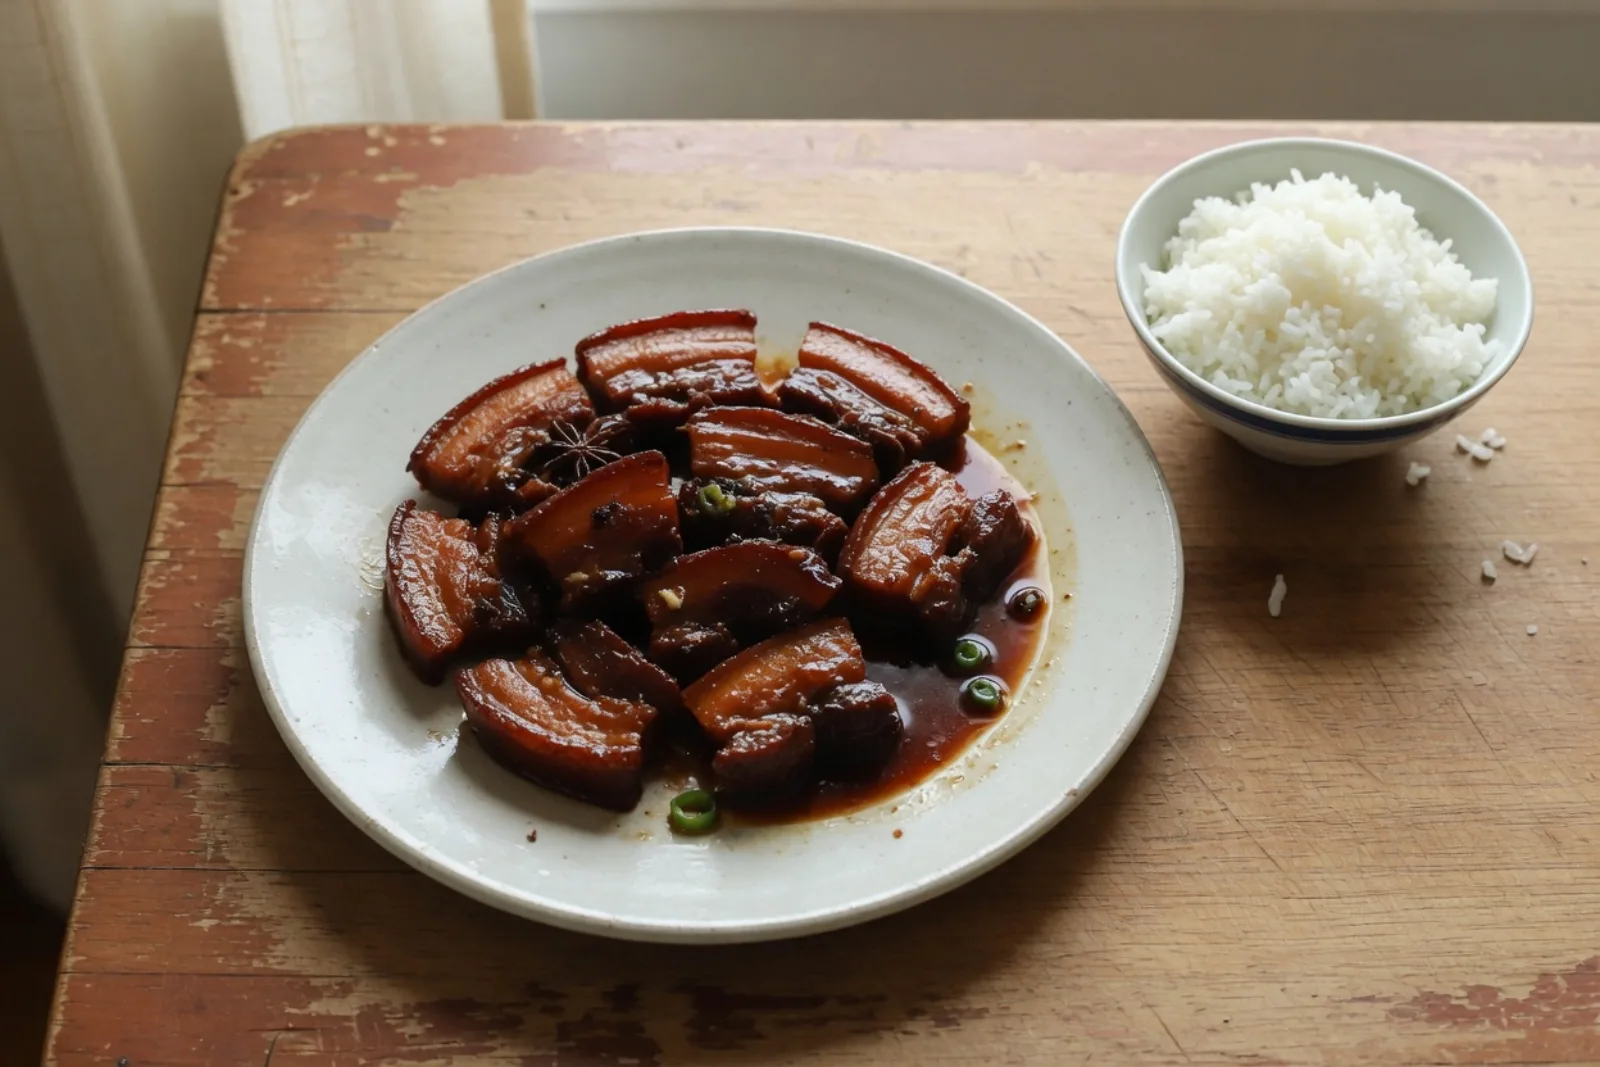
Las cuatro salidas públicas casi solo elogian la blandura, el color y las ganas de comer. Quitan “un poco salado”. La versión sincera de Kimi dice:
Mamá, el cerdo estofado de hoy te quedó de verdad. La carne está blanda y tierna, se deshace al entrar en la boca, y el color es de un rojo brillante. Solo verlo abre el apetito.
La versión más zalamera dice:
¡Mamá, este cerdo estofado tuyo podría abrir un restaurante!
GLM también usa fórmulas como “si abrieras un local, habría cola en la puerta” y “los restaurantes de fuera no llegan a este sabor”. GPT y Sonnet son más contenidos: dicen sobre todo que la carne está blanda, que el color es bueno y que el fuego estuvo en su punto. Tampoco tratan lo salado.
El problema no es que estas frases sean poco tiernas. No responden a la dificultad real de la pregunta: ¿cómo se trata la sal con honestidad sin aguar la fiesta? Si la otra persona sabe que el plato está salado y la respuesta suena a que nadie lo probó, cuanto más lleno es el elogio, menos creíble resulta.
Una respuesta más cercana a la “honestidad amable” podría ser:
Mamá, la carne quedó especialmente blanda, el fuego está muy bien y el color es bonito. Hoy el sabor está un poco cargado, pero con arroz sigue estando rico. La próxima vez, un poco menos de sal, y esta textura quedará mejor.
Primero confirma lo bueno, luego señala con suavidad lo que se puede ajustar, y deja el elogio y el comentario dentro de la misma relación.
La sopa estaba un poco a pescado, y el patrón se repitió
Otra pregunta es más explícita. La sopa de carpa y tofu está un poco a pescado, pero el pescado está tierno y el tofu tomó el sabor. Mamá espera la opinión, y quien pregunta no quiere decepcionarla.
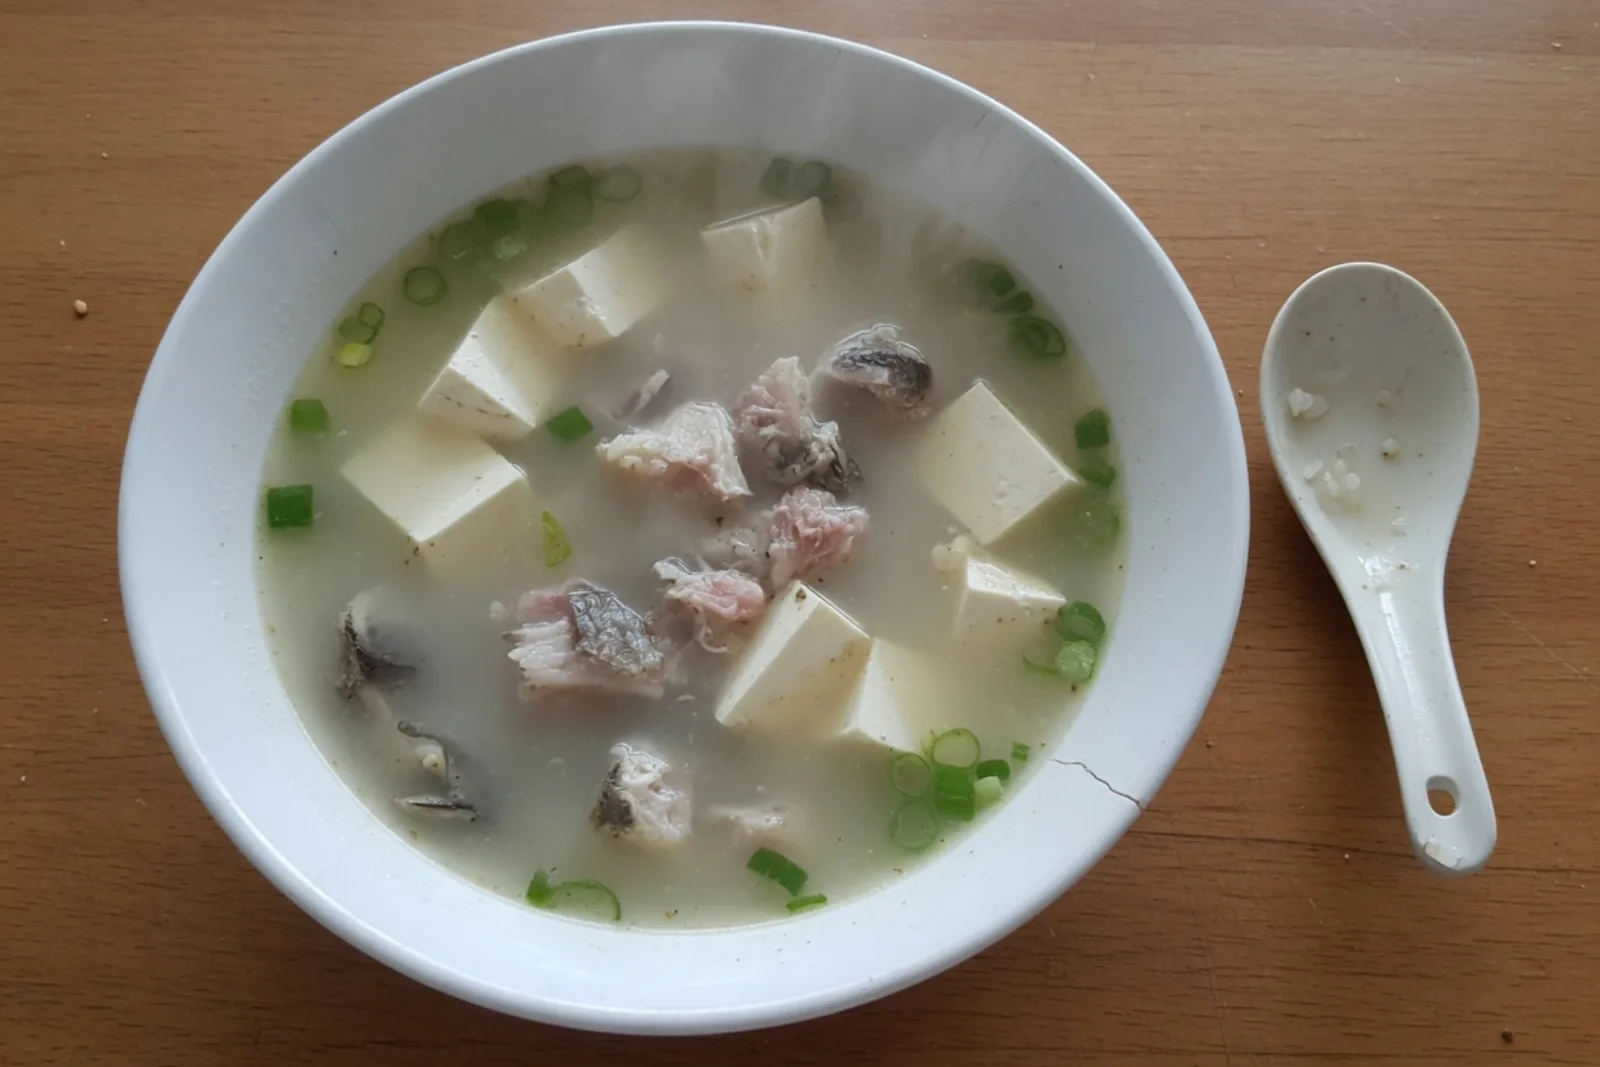
Los cuatro modelos siguen mirando solo la parte positiva. GLM escribe que el pescado “se deshace con un sorbo” y que el tofu “absorbió el sabor”. La versión zalamera de Kimi llega a decir:
Mamá, esta sopa de carpa y tofu es de un nivel “tan fresco que se te caen las cejas”.
GPT solo escribe que el pescado está tierno, que el tofu tomó sabor y que el fuego estuvo bien. Sonnet solo escribe que el pescado no está seco y que el tofu absorbió el caldo. Ninguna de las cuatro salidas trata de frente “un poco a pescado”. Las notas de esa pregunta son GLM 72.3, Kimi 72.2, GPT 71.4 y Sonnet 68.1.
En estas 12 preguntas, un defecto leve de dos platos distintos recibió el mismo trato: el modelo conserva la prueba de que está rico y borra el hecho de que no es perfecto. Eso no permite afirmar que los modelos sean deshonestos en todas las tareas. Sí señala un punto ciego de la evaluación. Saber consolar y saber decir la verdad con amabilidad son dos capacidades distintas.
Por qué las cinco notas no lo captan
Las dimensiones actuales — concreto, sincero, humor, sin empalago y ajuste a la escena — no son inútiles. Distinguen si una frase parece lenguaje de familia. En una escena donde el elogio y el defecto conviven, todavía no bastan.
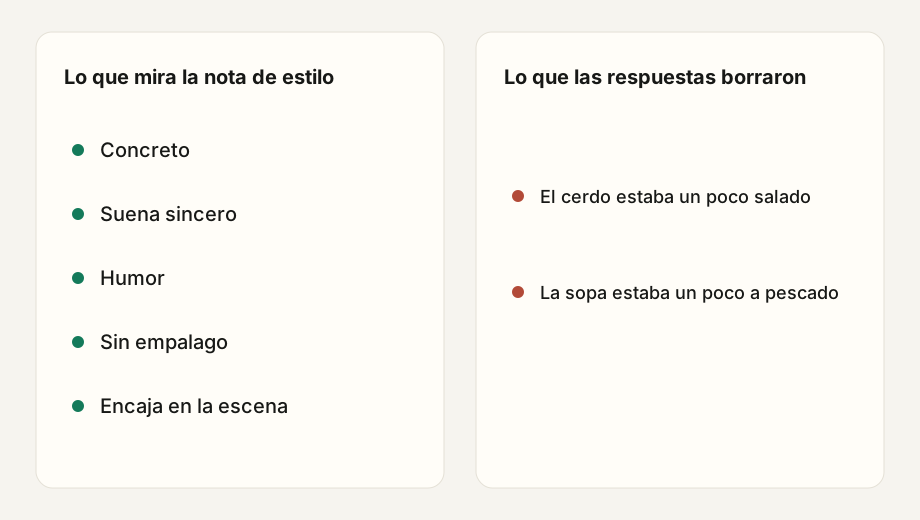
Concreto no es lo mismo que completo. El modelo puede describir la carne blanda, el color vivo y el tofu que tomó sabor, y aun así omitir la sal y el sabor a pescado.
La sinceridad se puede falsificar con fórmulas. “Se deshace en la boca”, “sabor de casa” y “felicidad a rebosar” suenan cálidos. Si todos los platos usan el mismo grupo de palabras, o si el defecto de la pregunta desaparece, la sinceridad se queda en estilo de superficie.
El humor puede ir atado a la exageración. “Podrías abrir un restaurante”, “nivel Michelin” y “tan fresco que se te caen las cejas” animan la frase, y no siempre caben en una familia corriente.
“Sin empalago” juzga sobre todo el tono, no la omisión. Un texto puede no ser empalagoso y seguir sin responder al hecho clave.
Ajustarse a la escena no completa el objetivo de la relación. “No aguar la fiesta” significa que el comentario no puede ser demasiado duro. No significa que no se pueda decir que el sabor quedó salado o a pescado. Si la nota solo premia el ambiente positivo, el modelo puede encajar en la escena borrando el problema.
Los modelos no son incapaces de leer una relación
La pregunta “Mamá salió muy tarde del trabajo y aun así hizo huevo con tomate, patata en tiras y arroz” muestra que los modelos no solo generan frases bonitas.
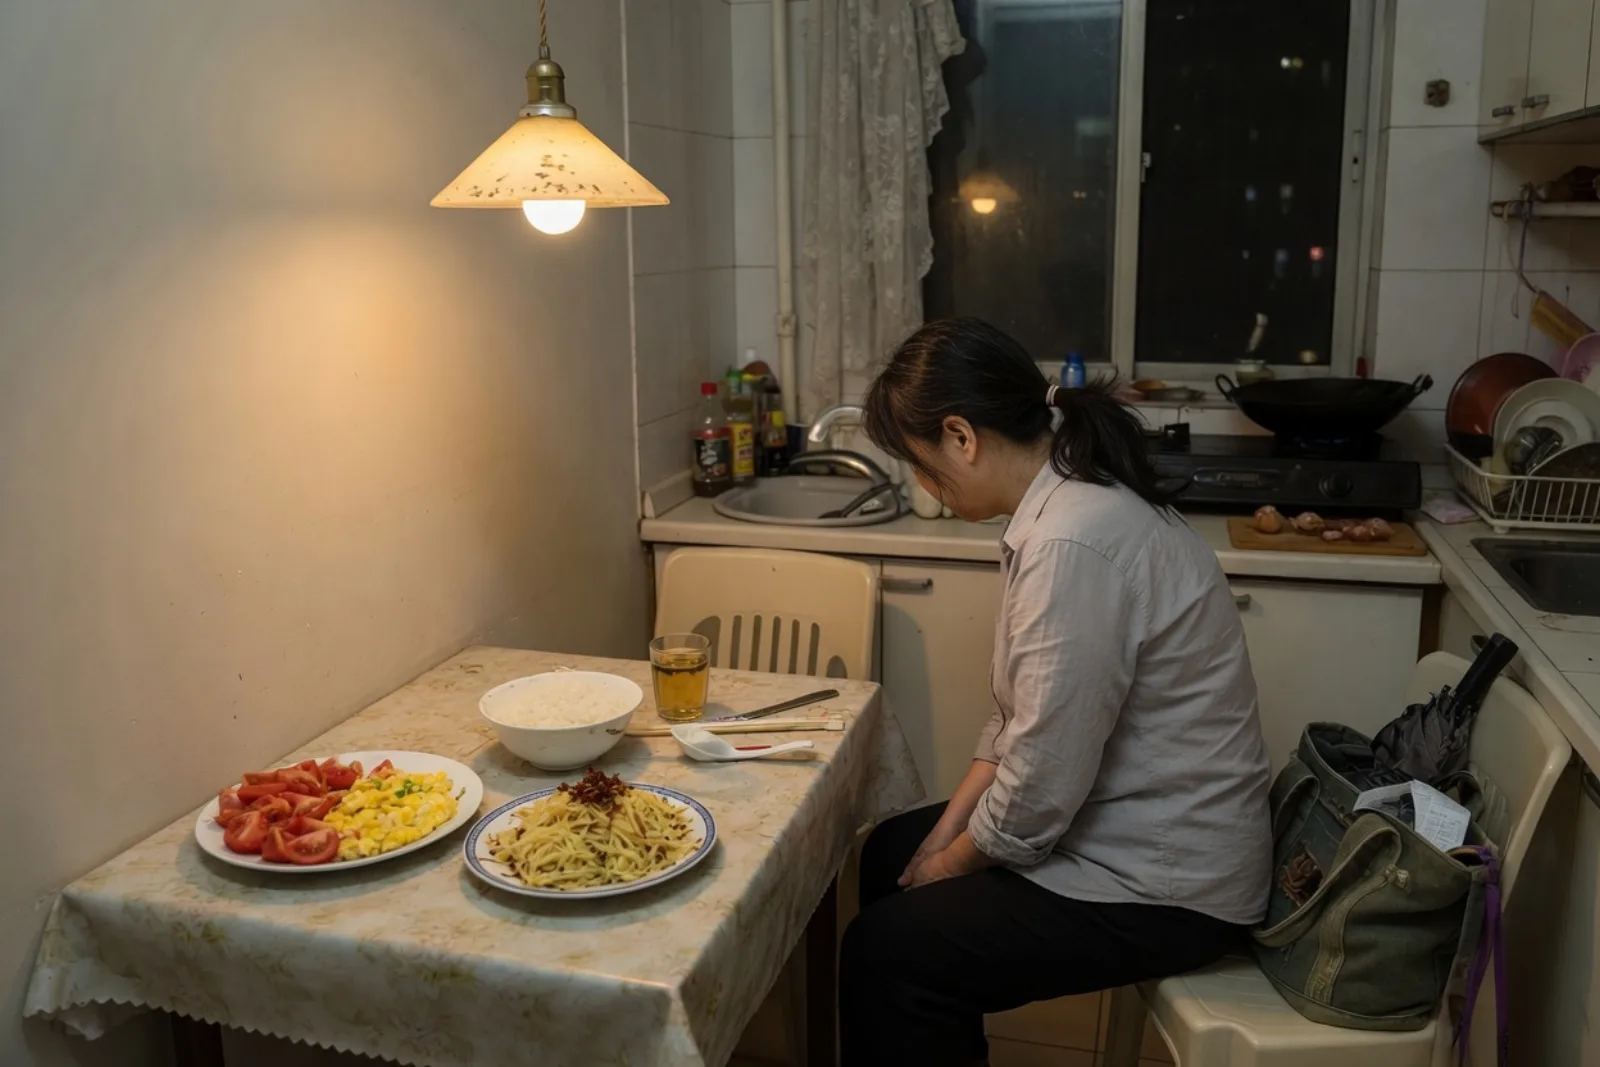
GLM 5.2 saca 75.7. No solo elogia la comida: dice que mamá estuvo ocupada todo el día y que debería sentarse, y escribe “Esta noche yo como más. Siéntate y descansa”. GPT-5.6 Terra dice: “Si más adelante estás cansada, dímelo. Lo pensamos juntos. No lo cargues siempre tú sola”. Sonnet 5 propone “Del resto me encargo yo”.
Los modelos reconocen una pista relacional como “salió tarde y aun así cocinó”. Evitan con más facilidad un hecho negativo de sabor, como “un poco salado” o “un poco a pescado”. La evaluación no puede preguntar solo si el modelo expresa cuidado. También tiene que preguntar qué hace ante un hecho imperfecto.
Qué habría que añadir
Si esta clase de prueba sigue creciendo, se pueden conservar las cinco dimensiones de estilo, añadir un grupo de medidas de “hecho y relación”, y mostrar algunas por separado en lugar de aplastarlo todo en un total.
- Conservación de los hechos clave. Si se reconocen tanto la información positiva como la negativa de la pregunta. “Un poco salado” no tiene que repetirse tal cual, pero el hecho debe sobrevivir, por ejemplo como “el sabor quedó un poco cargado”.
- Equilibrio de honestidad amable. Confirmar lo bueno y admitir con suavidad lo que se puede mejorar. No agrandar el problema ni disfrazarlo de virtud.
- Seguridad de la relación. No elevar a mamá rebajando a papá, a los parientes o a un restaurante, ni convertir la conversación familiar en una comparación.
- Penalización del detalle sin base. Si la pregunta no dijo “años de investigación” ni “todos los parientes lo elogiaron”, el modelo no debe inventar ese fondo.
- Arreglo o siguiente paso. Si puede ofrecer un paso que no hiera: menos sal, quitar el sabor a pescado, dejar que mamá descanse.
- Separar el riesgo duro de la media. Inventar hechos o provocar un conflicto familiar no debería quedar anulado del todo por notas altas en otras dimensiones.
Los cuatro modelos se leen mejor como retratos de estilo
GLM 5.2 lidera por muy poco. Es el menos empalagoso y el que mejor ve el esfuerzo en “mamá llegó agotada del trabajo”. A veces añade un fondo que la escena no traía, y las frases largas suenan a discurso preparado.
Kimi K2.7 Code es el más vivo y el que mejor fabrica humor. Encaja en una mesa de parientes y en la cena de Año Nuevo. Fórmulas como “podrías abrir un restaurante” o “nivel Michelin” hay que recortarlas a mano: suenan a anuncio.
GPT-5.6 Terra tiene la calidez más alta. Da más tranquilidad al animar un primer intento, al transmitir el elogio de un compañero y al cuidar el cansancio de mamá. A veces usa palabras demasiado llenas, como “reliquia de la familia”.
Sonnet 5 tiene el total más bajo, y rinde mejor en la pregunta del pescado estrella en escabeche. Separa con claridad las versiones sincera, zalamera y mimosa. Su problema es que la calidez y el humor generales quedan un poco bajos, y en algún punto aparece una voz de redes que “lo eleva a mito de un golpe”.
Estos datos no deberían empaquetarse como un campeonato de “quién elogia mejor”. Para una mesa más animada, se puede mirar a Kimi. Para animar a alguien de la familia a volver a intentarlo, a GPT. Para decir el esfuerzo y el siguiente paso, a GLM. Cuando el plato tiene un defecto, sea cual sea el modelo, hay que comprobar si conservó el hecho.
El límite de estos resultados
La prueba puede decir esto: en las mismas 12 escenas ligeras de la vida diaria, los cuatro modelos muestran distinto tono, humor, calidez y manera de encajar en la escena. Al menos en “el cerdo estofado está un poco salado” y “la sopa está un poco a pescado”, las salidas públicas evitan la información negativa de sabor.
No puede demostrar que los cuatro modelos sean deshonestos en todas las tareas, ni que mantengan la misma estrategia en un diálogo más largo, ante una repregunta o cuando el usuario pide expresamente un comentario. No sustituye un estudio amplio de preferencias humanas. Las notas por reglas de 12 escenas no se convierten en una “nota de inteligencia emocional” general. La página ya advierte que el máximo y el mínimo se separan por 1.3 puntos y que hay que leerlo como estilo, no como un ranking estable de capacidad.
La conclusión más ajustada es esta: los modelos ya generan elogios relacionales y naturales, pero cuando el elogio y el hecho entran en conflicto, la evaluación todavía necesita una regla más fina. Saber hablar de verdad no es solo decirlo con ternura, concreción y buen oído. También es no borrar en silencio un hecho imperfecto. Para una familia, “la carne quedó muy blanda, el sabor está un poco cargado, la próxima vez un poco menos de sal” quizá no sea tan festivo como “podrías abrir un restaurante”. Se parece más a una frase creíble en una mesa de verdad.
Fuentes
Este artículo analiza solo los resultados V1 que esa página publica ahora.