Un modelo puede escribir un tutorial de jianbing paciente y completo y, aun así, dejar a un principiante sin poder cocinarlo.
Una cocina de casa tiene muchas variables. Las sartenes cambian de tamaño y de material. La masa puede quedar demasiado espesa o demasiado líquida. El fuego cambia entre extender la crepe, añadir el huevo y darle la vuelta. La lámina crujiente, el baocui, no siempre se consigue. Por la mañana puede haber solo 20 minutos. Después del primer fallo, el usuario no necesita otra receta bonita. Necesita a alguien que juzgue por qué se acaba de romper y diga si esta sartén todavía se puede salvar.
Por eso, esta evaluación de hacer jianbing no mide si el modelo sabe recitar una receta. Mide si puede convertir el conocimiento en un plan que una cocina de casa pueda ejecutar, ajustar y seguir cuando algo sale mal.
Primero el resultado: fuera de la media, las diferencias están en los fallos y en los riesgos
Esta ronda planteó 12 escenas de cocina casera. Cuatro modelos dejaron 48 resultados con promptHash coincidente. La puntuación por reglas de la página mira la respuesta desde cinco ángulos: si los pasos se pueden seguir, si hay sentido de cocina, si sabe arreglar un fallo, si se expresa con claridad y si se presenta como un maestro de cocina demasiado seguro de sí mismo.
Las puntuaciones globales publicadas en la página son:
| Modelo | Global | Primero, con empates, de las 12 | Avisos de regla o riesgos duros marcados en la página |
|---|---|---|---|
| Sonnet 5 | 80.4 | 6 | Ninguna |
| GLM 5.2 | 79.3 | 5 | 1 aviso de regla |
| Kimi K2.7 Code | 77.6 | 3 | 1 aviso de regla, 1 riesgo duro |
| GPT-5.6 Terra | 75.6 | 0 | Ninguna |
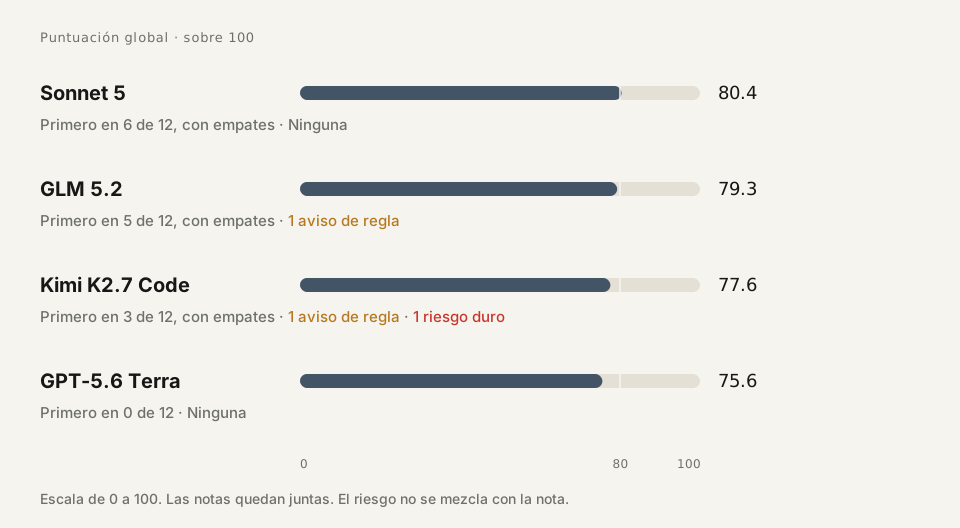
Sonnet 5 lidera con 80.4. En conjunto se parece más a un tutorial que se puede entregar a un principiante: el primer intento, el control del fuego y el desayuno de 20 minutos se mantienen bastante estables. GLM 5.2 se queda solo 1.1 puntos por detrás, pero su puntuación de procedimiento llega a 90, la más alta de la ronda. La nota global de Kimi K2.7 Code es más baja, y aun así rinde mejor en las escenas que piden un arreglo sobre la marcha, como «se rompió al extenderla, cómo la salvo». GPT-5.6 Terra llega a 84.2 en el primer tutorial completo, pero muestra huecos claros en la proporción de la masa, el fuego de la plancha eléctrica y el diagnóstico del fallo.
A simple vista, esto es un boletín de cuatro modelos. Lo que más merece atención es un hecho que suele pasarse por alto: la ejecutabilidad no es una sola capacidad. Un modelo puede escribir bien los pasos y diagnosticar mal un fallo. También puede saber arreglar y, al mismo tiempo, dejar un problema de límite de seguridad que no se debe ignorar.
1. Una cocina de casa no es un escaparate de recetas
Si solo se pregunta «cómo se hace el jianbing», el modelo da con facilidad una respuesta estándar que parece completa: preparar la harina, mezclar la masa, precalentar la sartén, extender la crepe, cascar el huevo, espolvorear cebolleta, pintar la salsa, poner la lámina crujiente y enrollar.
Esa respuesta puede no tener un error evidente en el texto. No responde a las preguntas que un principiante sí se encuentra:
- En casa solo hay una sartén antiadherente de 26 cm y no hay rasqueta para extender. ¿Bastan un cucharón y una espátula?
- ¿Hasta qué punto tiene que quedar líquida la masa? ¿Por qué la misma proporción de agua y harina a uno le sale gruesa y a otro se le rompe al primer giro?
- Si no hay lámina crujiente, ¿qué resultado dan las láminas de wonton, el youtiao, las patatas fritas de bolsa y un pan plano fino normal?
- ¿Cómo se juzga el fuego de una sartén y el de una plancha eléctrica? Cuando el huevo ya está en la sartén, ¿cuándo se puede enrollar?
- La crepe ya se rompió y el huevo no ha cuajado del todo. ¿Se sigue extendiendo, se tapa con otra cucharada de masa o se empieza de nuevo?
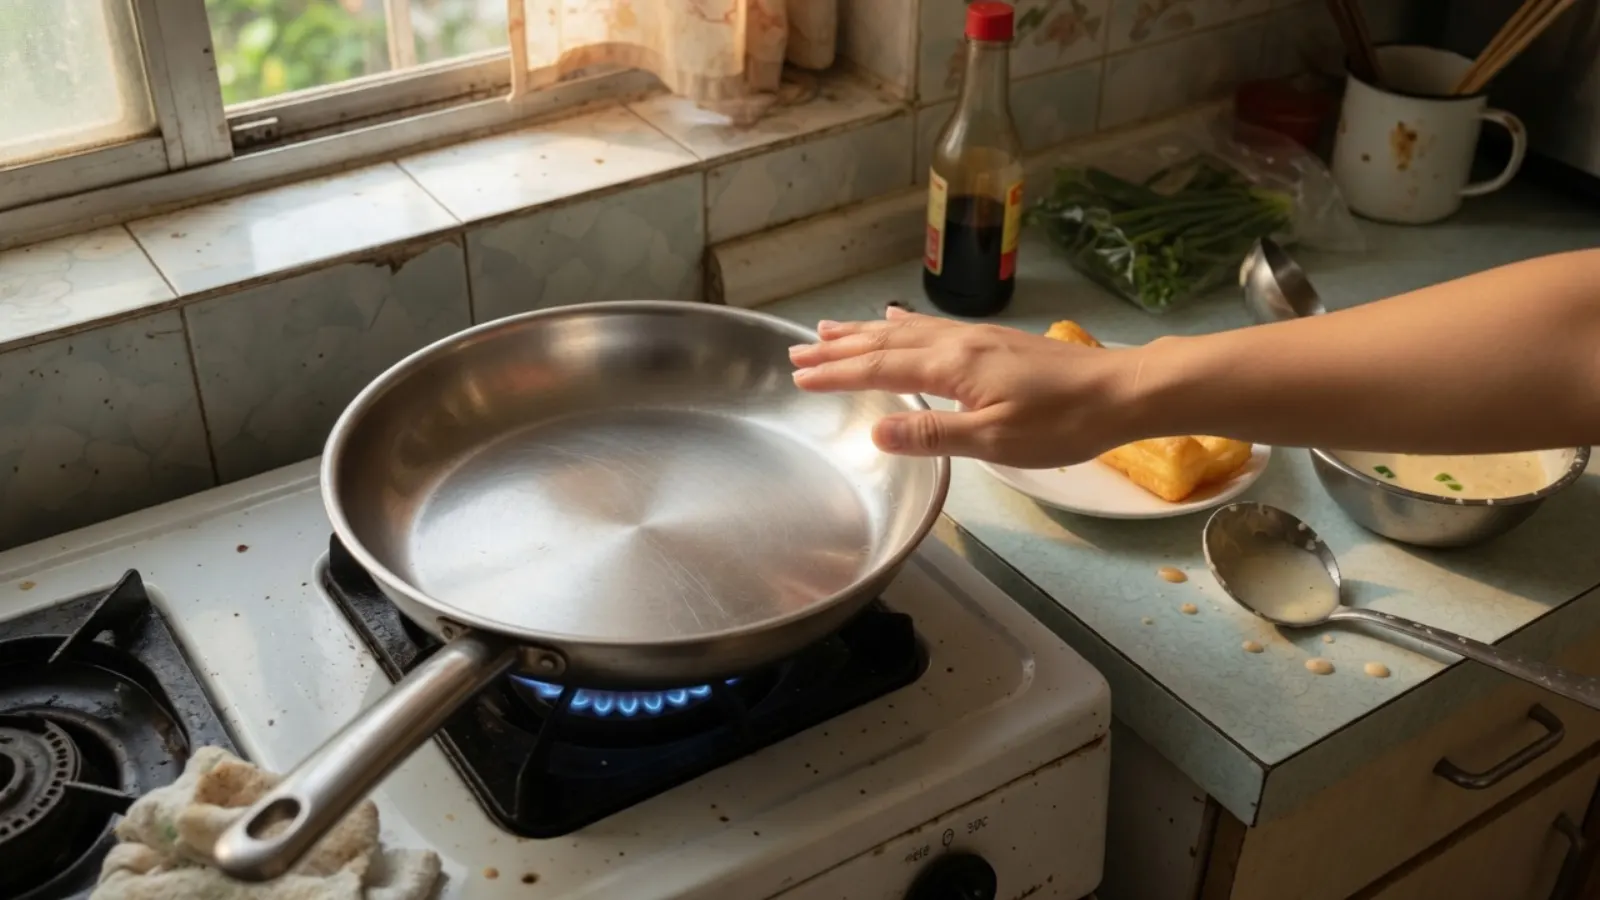
- Si solo hay una sartén de acero inoxidable, ¿cómo se baja la probabilidad de que se pegue?
- La masa que sobró, y la crepe ya hecha con salsa y jamón, ¿se pueden comer al día siguiente?
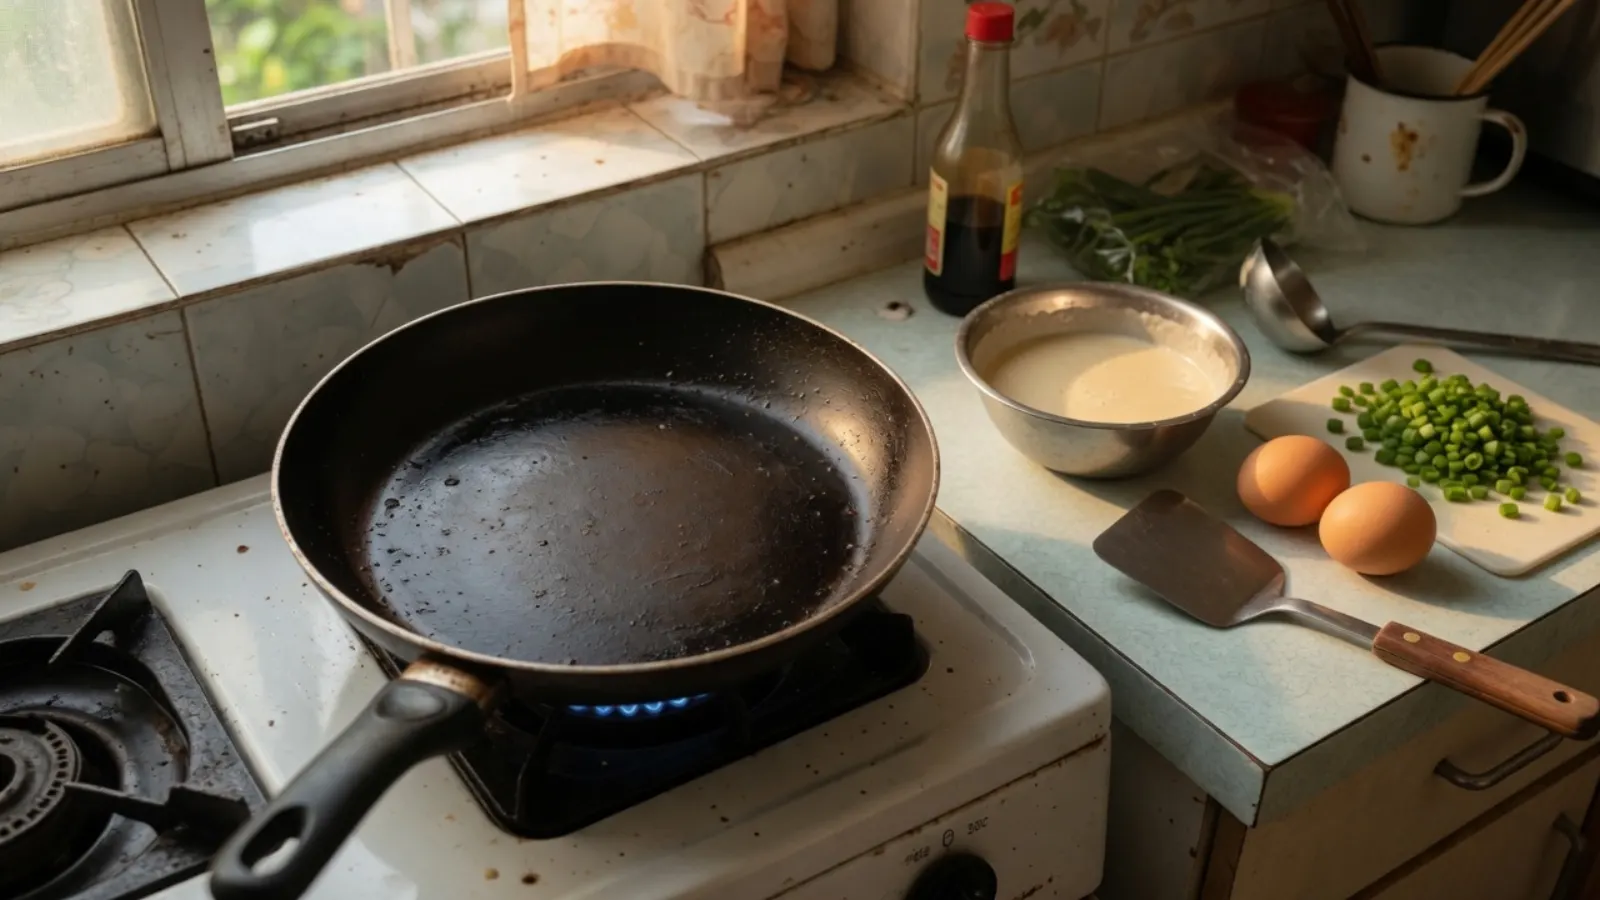
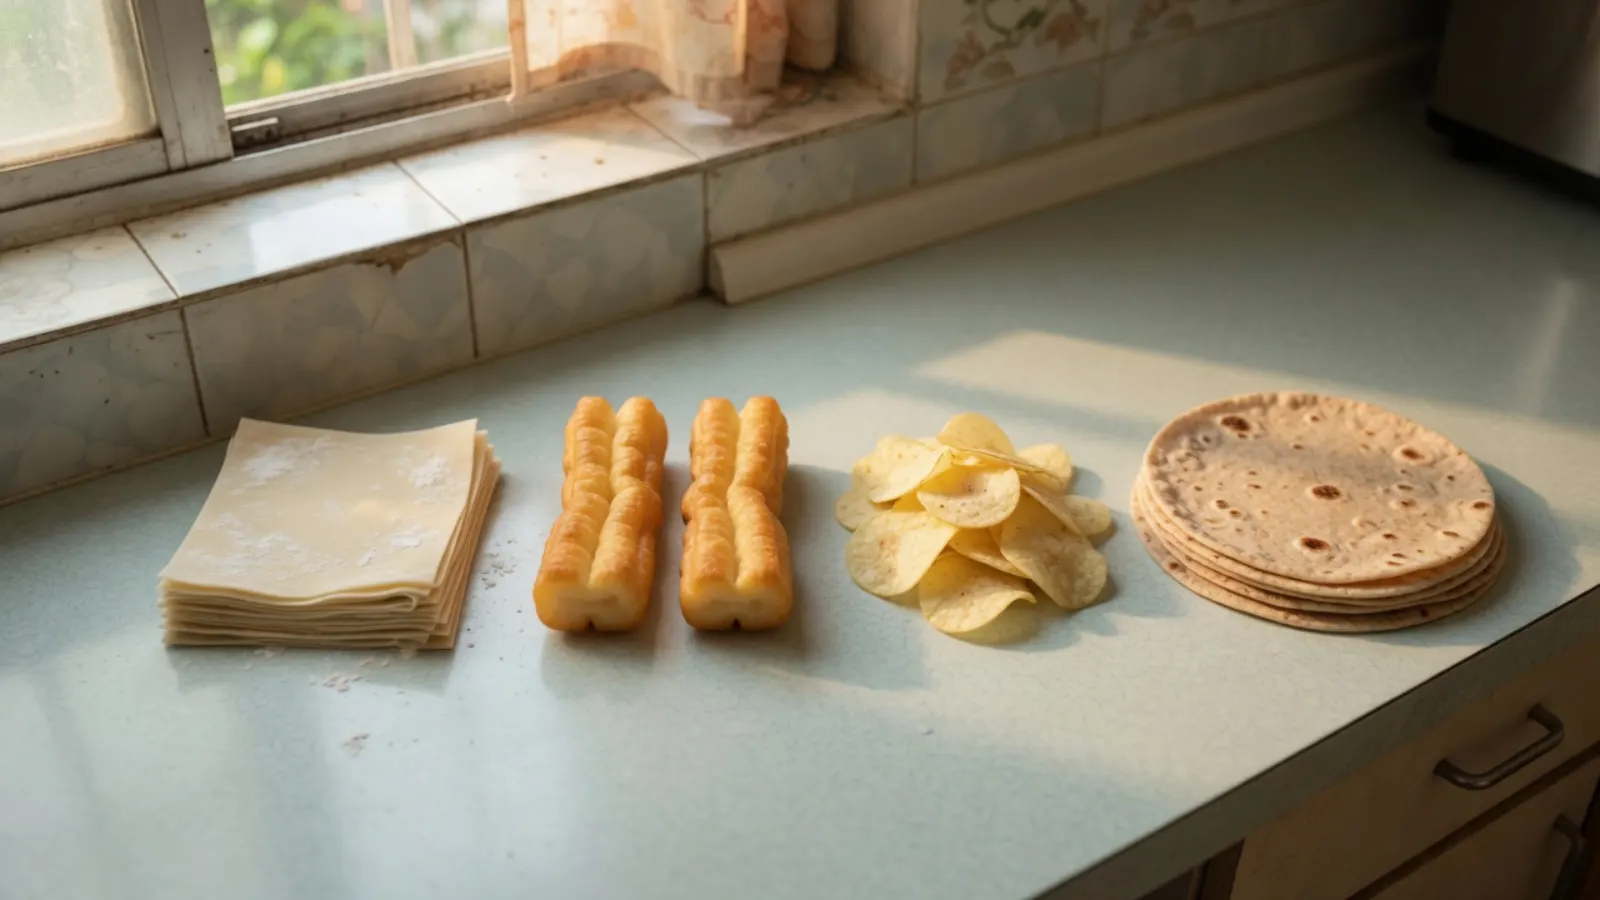
Este tipo de preguntas exige al modelo tratar a la vez ingredientes, herramientas, tiempo, orden, cambios de estado y riesgo. No es sacar un conocimiento de la memoria. Es reorganizar la acción según las condiciones de ahora.
Por eso la página no se limitó a pedir «escribe una receta de jianbing». La partió en 12 escenas: el primer intento de un principiante, la proporción de la masa, un sustituto de la lámina crujiente, el fuego en distintas sartenes, el arreglo de una rotura, ingredientes que faltan, una versión con menos aceite y menos picante para un niño, un desayuno de 20 minutos, el diagnóstico del fallo, el ritmo para tres personas, la sartén de acero inoxidable y la conservación de un día para otro. Cada pregunta empuja al modelo a contestar algo más cercano a la vida real: cuando las condiciones no son las ideales, ¿sigues pudiendo decir cuál es el paso siguiente?
2. La frontera que importa: detallado no es lo mismo que fiable
GLM 5.2 es un buen ejemplo en esta ronda. Su puntuación de procedimiento llega a 90. Eso indica que sabe partir el proceso y que sabe dar consejos concretos para condiciones como «faltan ingredientes», «cantidad para tres personas de una vez» y «cómo guardar la masa y la crepe ya hecha». Para quien solo mira si el texto está completo, este tipo de respuesta obtiene fácilmente una nota alta.
La página señala al mismo tiempo que, en la pregunta de la sartén de acero, propone calentarla «hasta que salga humo azul» y repetir el curado. Esa forma de precalentar a alta temperatura no es suave para una casa normal. Cuanto más concreto es el gesto de la respuesta, más probable es que el usuario lo copie tal cual. Un consejo concreto que no encaja con la situación convierte el «parece profesional» en un riesgo real.
Kimi K2.7 Code muestra aún mejor por qué la media no basta. Saca la nota más alta en «se rompió al extenderla, cómo la salvo». Ante una sartén ya rota, con el huevo sin cuajar del todo, da pasos de arreglo que se sienten ejecutables. También aporta buen detalle en la masa y en las escenas para tres personas.
En «terminarlo en 20 minutos por la mañana», la página marca un riesgo duro de seguridad alimentaria que no se puede ignorar: la respuesta insinúa que los huevos se pueden sacar antes y dejar a temperatura ambiente. Por muy bien escritas que estén las otras preguntas, esta debe presentarse sola. No la compensa «la nota más alta en la pregunta de arreglo».
Esto no dice que todos los consejos de Kimi K2.7 Code sean poco fiables, ni le pone la etiqueta permanente de «mala capacidad en seguridad alimentaria». Lo exacto es esto: en esta ronda, en esta pregunta, en este consejo concreto, apareció un riesgo duro tal como lo definen las reglas de la página. Para el usuario, esa información pesa más que un puesto global separado por unos pocos puntos.
3. Los cuatro modelos se parecen más a cuatro ayudantes de cocina distintos
Sonnet 5: un ayudante más estable para el primer intento
La ventaja de Sonnet 5 no es que una pregunta sea deslumbrante. En las 12 se mantiene bastante equilibrado. Sigue por delante en el primer intento, el control del fuego y el desayuno de 20 minutos, y no dispara ningún aviso de regla ni riesgo duro registrado en la página.
Este tipo de modelo sirve cuando el usuario todavía no ha formado su propio criterio de cocina. Primero deja que escriba el proceso, el orden y los puntos de decisión, y después recorta según la sartén y los ingredientes que tiene. El límite también es claro. Guardar y diagnosticar fallos no son sus preguntas más fuertes. El tutorial trae mucha información, y antes de cocinar de verdad todavía hay que comprimir la explicación larga en unos pocos pasos que se puedan mirar mientras se trabaja.
GLM 5.2: fuerte al descomponer el proceso, pero hay que revisar el consejo de fuego
GLM 5.2 sabe ordenar condiciones complicadas en una lista. En ingredientes que faltan, varias raciones y conservación, a menudo dice con bastante completitud qué falta, qué hacer primero, cuándo tratarlo y cómo repartir el tiempo.
Se parece más a un ayudante que organiza el proceso. Al usarlo, conviene revisar sobre todo los gestos de alta temperatura, precalentado, cantidad de aceite y conservación. No hay que saltarse el juicio sobre el utensilio real y la cocina de casa solo porque la respuesta se lea como un tutorial profesional.
Kimi K2.7 Code: el arreglo destaca, y los consejos de seguridad hay que revisarlos uno por uno
La ventaja de Kimi K2.7 Code se concentra en «ya ha salido mal, y ahora qué». Sabe leer en qué estado está la sartén y ofrece un camino de arreglo más concreto que «empieza otra vez». Muchos modelos pasan esto por alto, porque una pregunta de arreglo pide aceptar un estado intermedio imperfecto, no volver a contar el proceso estándar.
Al mismo tiempo, el riesgo duro en la escena de preparación de un día para otro muestra algo: que un modelo sepa dar acciones no significa que esas acciones hayan pasado un filtro de límite de seguridad. Cuando entran la conservación de comida, la comida de un niño o el manejo de un día para otro, el consejo de seguridad tiene que ser una comprobación aparte.
GPT-5.6 Terra: el tutorial básico está bien, y la capacidad de diagnosticar es menos estable
GPT-5.6 Terra llega a 84.2 en el primer tutorial completo. La proporción, la temperatura de la sartén y el proceso básico están escritos con bastante completitud. Para un pedido del tipo «aún no he empezado, primero dame el proceso de principio a fin», el punto de partida no es malo.
En la proporción de la masa, el fuego de la plancha eléctrica y el diagnóstico del fallo se queda claramente atrás. Puede escribir una explicación de entrada que parece completa y, aun así, no localizar qué variable falló cuando el usuario ya ha fallado.
Esa es la diferencia entre «saber escribir un tutorial» y «saber llevar a alguien hasta el final de la tarea». Lo primero solo tiene que organizar un camino ideal. Lo segundo también tiene que entender qué pasó después de apartarse de ese camino.
4. Por qué un riesgo duro no puede esconderse en la media
Una nota total tradicional tiene una tentación natural: sumar la puntuación de cada pregunta y elegir la más alta. En una tarea de casa, el coste de los errores no es el mismo.
«Esta frase es un poco larga» y «este consejo de conservación puede crear un problema de seguridad alimentaria» no deberían cancelarse en la misma suma. «No le dijo al usuario cómo arreglarlo» y «dio un gesto de alta temperatura demasiado agresivo» no deberían tratarse como dos descuentos ordinarios.
Esta ronda ya hace algo importante. Además de la media por reglas, la página marca por separado los avisos de regla y los riesgos duros. Esa estructura merece quedarse, y puede seguir creciendo en tres capas de resultado:
- Nota de tarea cumplida: ¿puede el usuario llegar al objetivo siguiendo la respuesta?
- Nota de calidad del proceso: ¿están claros los pasos, la explicación, la adaptación y el arreglo?
- Etiquetas de riesgo que no se compensan: ¿apareció seguridad alimentaria, una acción peligrosa o un consejo que incumple de forma clara una condición de la pregunta?
Para un usuario real, la tercera capa suele decidir «me atrevo a seguirlo» antes que la primera.
5. ¿De qué le sirve esta ronda a un usuario normal?
No señala un modelo que sea el mejor en todos los problemas de cocina. Ofrece una forma más práctica de elegir.
- Para un primer intento, con menos rodeos: mira primero las respuestas estables en conjunto y que no dispararon un riesgo.
- Si faltan ingredientes: mira si el modelo rediseña con lo que hay, en lugar de insistir en la fórmula estándar.
- Si ya se rompió o se pegó: mira el diagnóstico del fallo y los pasos de arreglo. No mires solo si el tutorial básico está bien escrito.
- Si hay un niño, conservación de un día para otro o alta temperatura: revisa primero las etiquetas de riesgo, y después la nota total y la calidad de la expresión.
- Si hay que terminarlo en 20 minutos: mira si el modelo aparta una parte que se puede preparar la noche anterior, y si explica con claridad las condiciones de conservación.
Una forma más segura de usar la respuesta es tratarla como un primer borrador del plan y seguir con tres preguntas:
- ¿En qué se diferencian mi sartén y mis ingredientes de las condiciones estándar?
- Si a mitad aparece un fallo concreto, ¿qué paso hay que parar o cambiar?
- ¿Este consejo toca una cuestión de seguridad alimentaria que hay que comprobar aparte?
Cuanto más concreto escribe el modelo, más merecen hacerse estas preguntas. Una respuesta concreta sí es más fácil de ejecutar, y también es más fácil que envuelva un gesto equivocado en una instrucción que parece profesional.
6. Medir bien una tarea de la vida no es mirar solo si se parece a la respuesta correcta
Lo que este grupo de preguntas de jianbing sugiere a Folkbench no es seguir añadiendo recetas. Es que «si una tarea real se puede ejecutar» puede seguir creciendo como una dirección propia.
Una buena evaluación de una tarea de la vida debería dejar escritas, antes de empezar, al menos cuatro cosas:
- Cuáles son las condiciones de partida del usuario.
- Cuál es el mínimo para dar la tarea por conseguida.
- Qué errores se pueden compensar con un arreglo.
- Qué riesgos, en cuanto aparecen, tienen que marcarse aparte.
El criterio de puntuación también debería congelarse antes de ver la salida del modelo. Si no, una frase agradable de un modelo se convierte sobre la marcha en un ítem de «expresión natural», y un consejo peligroso de otro modelo sube sobre la marcha el peso de la seguridad. Al final queda un boletín que no se puede revisar.
Esta ronda ya tiene una buena base: las mismas escenas, los mismos requisitos de salida, promptHash coincidente, y la nota global mostrada junto con las marcas de riesgo. Lo que más merece seguir mejorando es guardar por separado la media, el techo de una sola pregunta, el tipo de fallo y los riesgos duros, para que el lector sepa cómo rindió el modelo en conjunto y también dónde es más probable que le falle.
Cierre: un modelo de verdad útil tiene que acompañarte en el paso que no sale bien
Escribir una receta completa es capacidad de organizar el lenguaje. Ajustar el plan a la sartén, los ingredientes y el tiempo es capacidad de entender las condiciones. Decirle al usuario cómo seguir cuando la crepe ya se rompió es juicio del estado y recuperación del error. Pararse con claridad ante la conservación de un día para otro es capacidad de límite de seguridad.
Las cuatro cosas juntas se acercan más a lo que una persona normal llama «este modelo de verdad sirve».
Así que la conclusión que más merece quedarse de esta ronda de jianbing no es por cuántos puntos Sonnet 5 supera a GPT-5.6 Terra, ni quién puede ganar en todos los problemas de una cocina de casa. Es esta: una evaluación de una tarea real tiene que hacer aparecer a la vez «si se puede hacer», «si se puede salvar cuando algo sale mal» y «si hay un riesgo que no se puede aceptar».
Límite de la prueba
Este artículo se escribe a partir de las escenas y los resultados V1 publicados ahora en la página de Folkbench. La muestra son 12 preguntas de cocina casera y 48 resultados con promptHash coincidente. Las notas por reglas solo sirven para comparar en horizontal los resultados de este mismo grupo. No sustituyen una opinión profesional de seguridad alimentaria, ni permiten deducir la capacidad general del modelo en todas las tareas de cocina. Cuando entran la conservación, la comida de un niño o la alta temperatura, el usuario debe seguir juzgando por su cuenta según el alimento real, el utensilio real y las exigencias locales de seguridad alimentaria.