
モデルが丁寧で抜けのない煎餅果子(ジェンビングオズ)のレシピを書けても、初心者がそのとおりに作れるとは限りません。
実際の家庭のキッチンには、変数がたくさんあります。フライパンは大きさも材質もまちまちで、生地は濃すぎることも薄すぎることもあります。火加減は、生地を広げる、卵を落とす、裏返す、と段階ごとに変わります。薄くてパリッとした揚げせんべい「薄脆(バオツイ)」がいつも手に入るとは限りませんし、朝に使える時間が 20 分しかないこともあります。最初に失敗したあと、ユーザーに必要なのはもう 1 本のきれいなレシピではありません。「なぜ今破れたのか」を見極め、このひと焼きをまだ立て直せるかどうかを教えてくれる相手です。
ですから、今回の煎餅果子づくりの評価が本当に測っているのは、モデルがレシピを暗唱できるかどうかではありません。知識を、家庭のキッチンで実行でき、調整でき、途中で問題が起きても先へ進められる手順に変えられるかどうかです。
まず結論:平均点だけでは見えない差は、失敗とリスクに潜んでいる
今回のテストでは家庭のキッチンを想定した 12 の場面を用意し、4 つのモデルから promptHash が一致した結果を計 48 件得ました。ページのルールベースの採点では、回答を 5 つの観点から見ています。手順をそのとおりに実行できるか、キッチンの常識があるか、失敗に対処できるか、説明がわかりやすいか、そして自分を自信過剰な「ベテラン料理人」に仕立てていないか、です。
ページで公開されている総合スコアは次のとおりです。
| モデル | 総合スコア | 12 問中の首位数(同点を含む) | ページに表示されたルール上の注意・重大リスク |
|---|---|---|---|
| Sonnet 5 | 80.4 | 6 問 | なし |
| GLM 5.2 | 79.3 | 5 問 | ルール上の注意 1 件 |
| Kimi K2.7 Code | 77.6 | 3 問 | ルール上の注意 1 件、重大リスク 1 件 |
| GPT-5.6 Terra | 75.6 | 0 問 | なし |
Sonnet 5 は 80.4 点でトップです。全体として、初心者にそのまま渡せるレシピに近く、初めて作る場面、フライパンの火加減、20 分で作る朝食などの場面で安定しています。GLM 5.2 との差はわずか 1.1 点で、GLM 5.2 の操作手順のスコアは 90 点と全モデル中で最高でした。Kimi K2.7 Code は総合スコアこそ低めですが、「破れてしまったらどう立て直すか」のように、その場での立て直しが求められる場面で最も良い結果を出しています。GPT-5.6 Terra は、初めて作る人向けの通しのレシピで 84.2 点を取った一方、生地の配合、ホットプレートの火加減、失敗の診断の問題ではっきりした弱点が出ました。
表面的には、4 つのモデルの成績表です。ただ、より注目すべきなのは、見過ごされがちな事実が浮かび上がった点です。実行可能性は単一の能力ではありません。手順をわかりやすく書くのは得意でも、失敗の診断は苦手なモデルがあります。立て直しはうまくても、安全面で見過ごせない問題を残すモデルもあります。
1. 家庭のキッチンはレシピの展示場ではない
「煎餅果子の作り方は?」とだけ聞けば、モデルは一見完全な標準回答をすぐに出してきます。小麦粉を用意し、生地を溶き、フライパンを予熱し、生地を広げ、卵を割り入れ、ネギを散らし、タレを塗り、薄脆をのせて、最後に巻く、という流れです。
この回答は、文面としては目立った誤りがないかもしれません。しかし、初心者が実際にぶつかる疑問には答えていません。
- 家には 26 cm のフッ素加工のフライパンしかなく、生地を広げるトンボもありません。おたまとフライ返しで足りますか?
- 生地はどのくらいゆるくすればいいのでしょうか? 同じ水と粉の比率なのに、厚く焼き上がる人もいれば、ひと返しで破れてしまう人もいるのはなぜですか?
- 薄脆がないとき、ワンタンの皮、油条(中国式の揚げパン)、ポテトチップス、普通の薄焼き生地は、それぞれ仕上がりをどう変えますか?
- フライパンとホットプレートでは、火加減をどう見極めればいいですか? 卵を入れたあと、いつ巻けばいいですか?
- 生地はもう破れ、卵もまだ固まりきっていません。そのまま広げ続けるか、生地をおたまで 1 杯足して補修するか、最初からやり直すか、どれがいいですか?
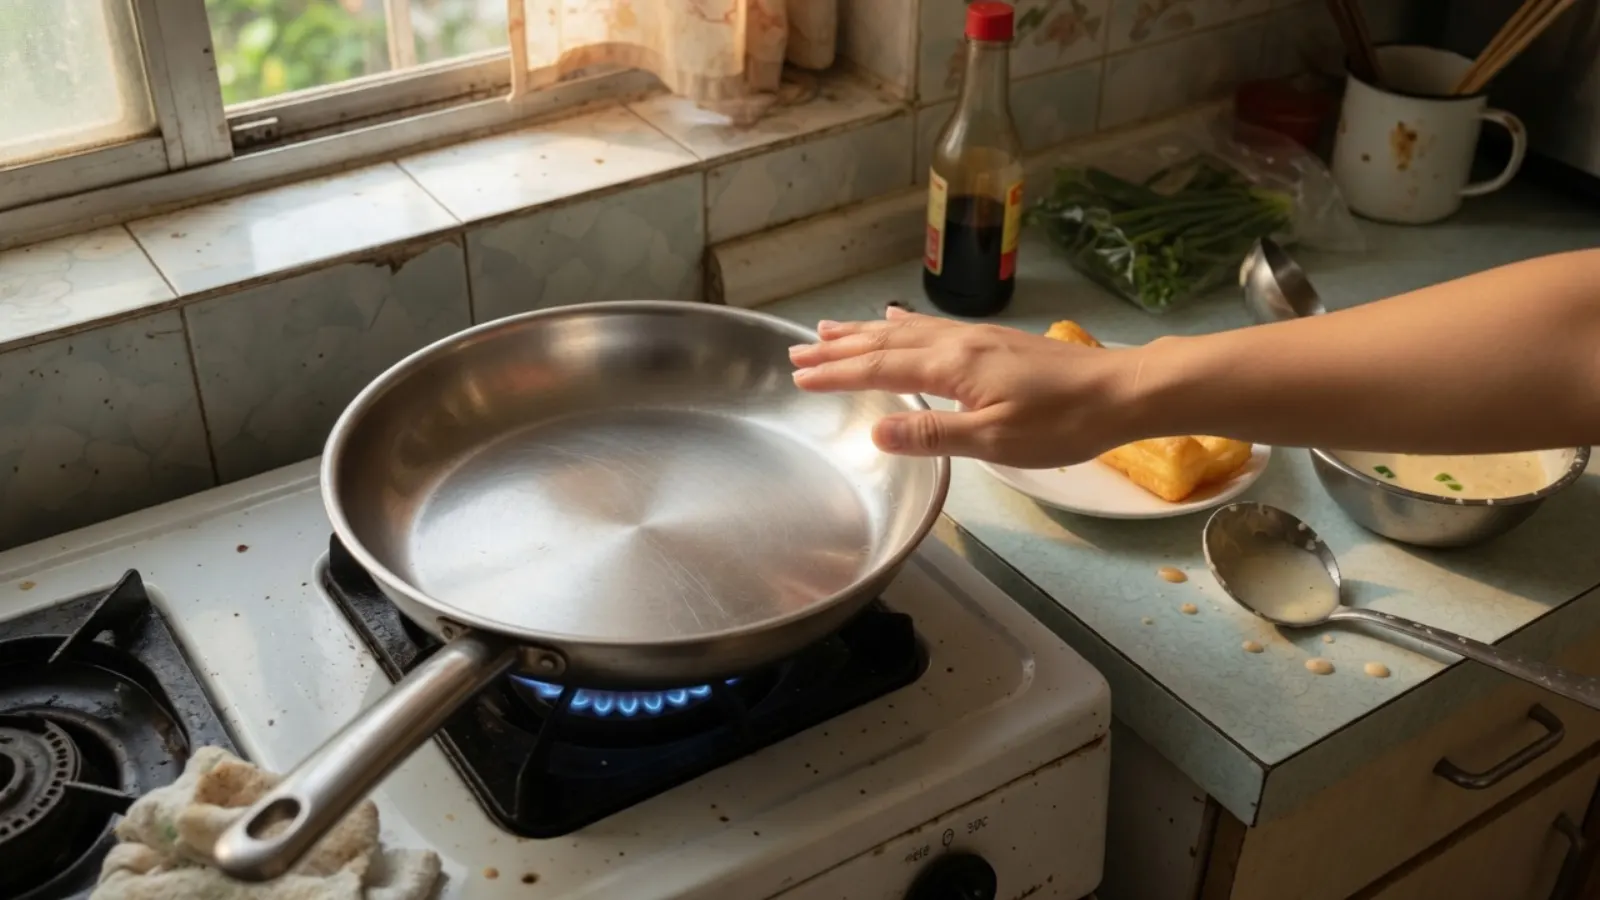
- ステンレスのフライパンしかないとき、くっつきにくくするにはどうすればいいですか?
- 余った生地や、タレを塗ってハムを挟んだ焼き上がりの煎餅果子は、翌日も食べられますか?
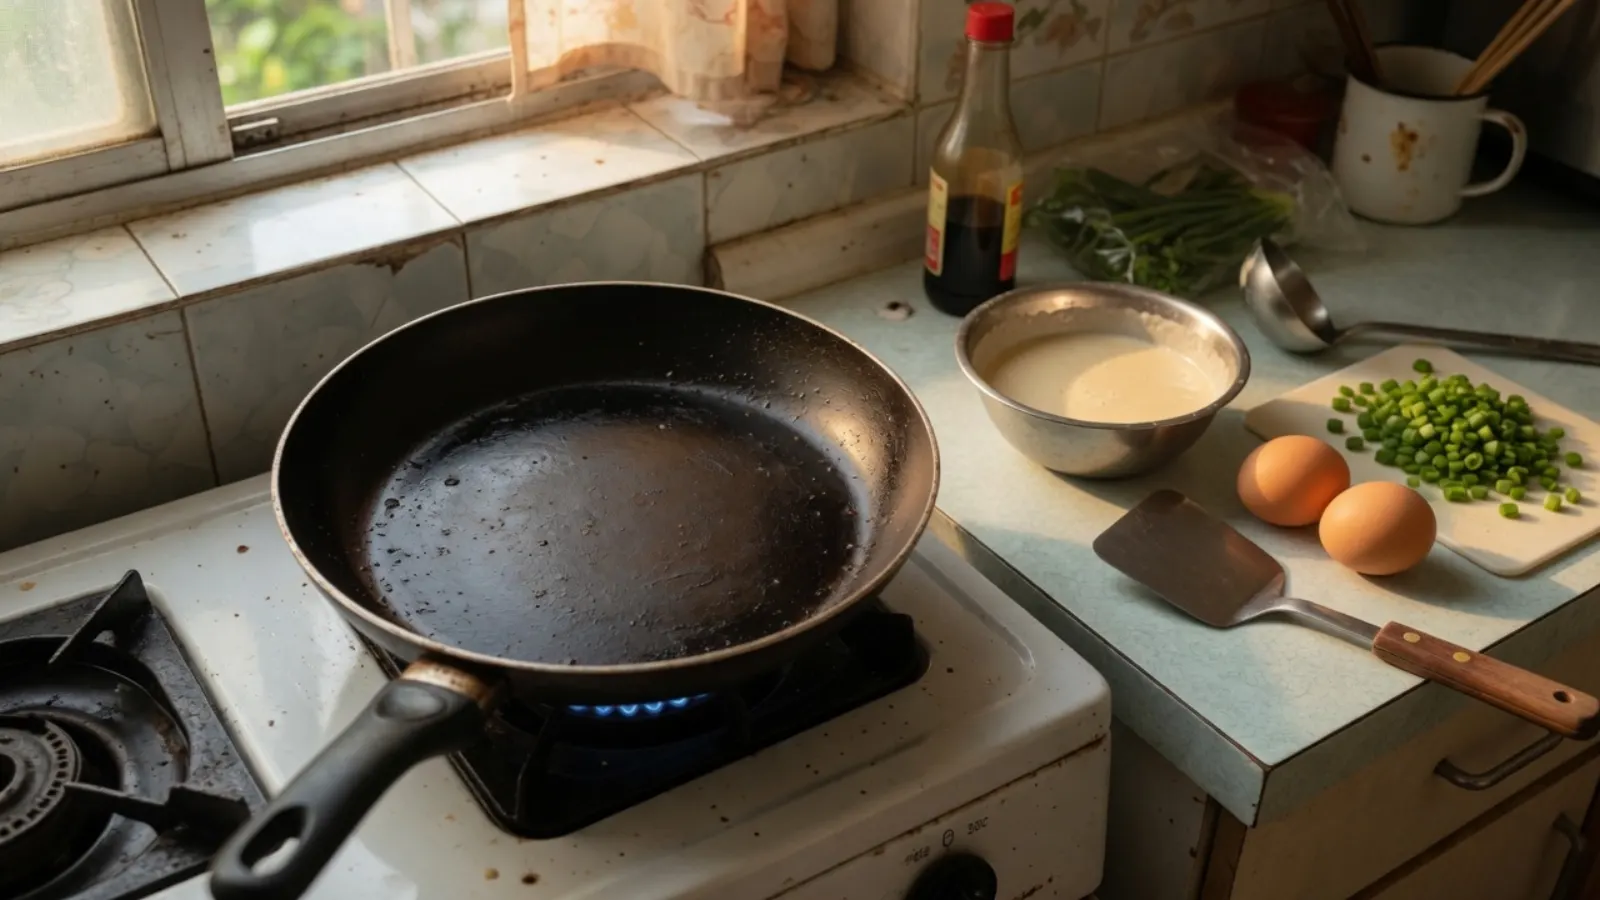
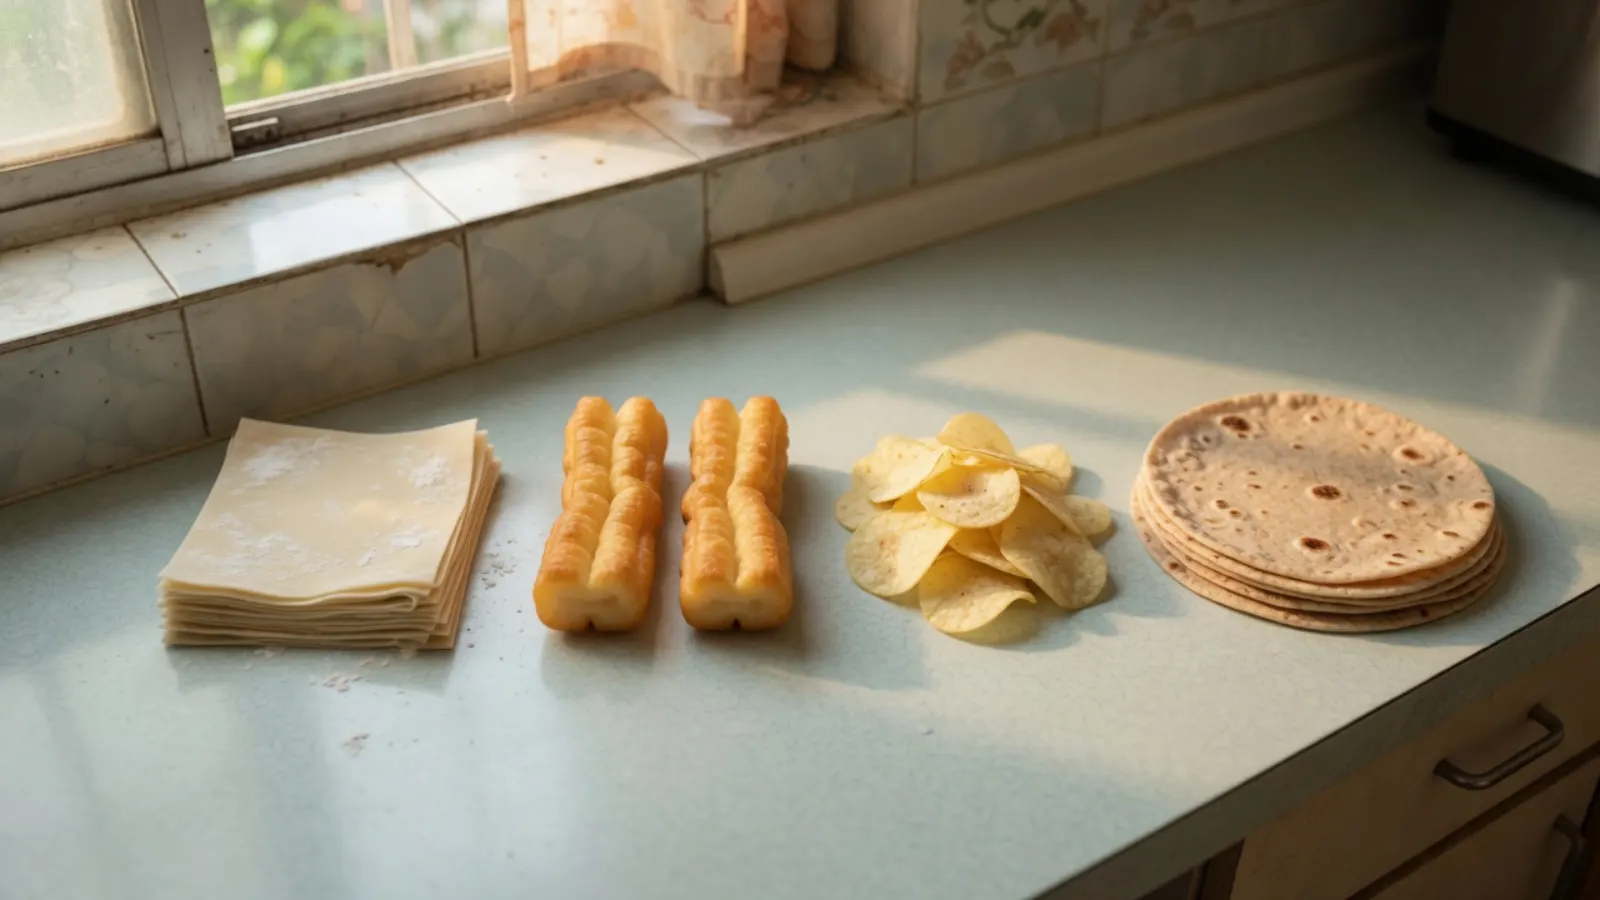
こうした問題では、材料、道具、時間、順序、状態の変化、リスクを同時に扱う必要があります。記憶から知識を取り出すのではなく、目の前の条件に合わせて次の行動を組み立て直す作業です。
だからこそページでは、「煎餅果子のレシピを書いてください」と頼むだけで終わらせず、12 の場面に分けています。初心者が初めて作る、生地の配合、薄脆の代用品、フライパンごとの火加減、破れたときの立て直し、材料が足りない、子ども向けの油控えめ・辛さ控えめ版、20 分で作る朝食、失敗の診断、3 人分を作る段取り、ステンレスのフライパン、そして翌日までの保存です。どの問題も、より現実の暮らしに近い問いをモデルに突きつけます。条件が理想的でないときでも、次の一手をはっきり言えるか?
2. いちばん大事な境界線:詳しいことと信頼できることは違う
今回の結果では、GLM 5.2 がよい例です。操作手順のスコアが 90 点に達しており、工程を細かく分けるのが得意で、「材料が少ない」「3 人分を一度に作る」「生地と焼き上がりをどう保存するか」といった条件に合わせて具体的な助言を出せることがわかります。文章がどれだけそろっているかだけを見る人なら、この種の回答には高い評価を付けがちです。
ただしページは同時に、ステンレスのフライパンの問題で「青い煙が立つまで熱する」ことを勧め、油ならしを繰り返すよう書いている点を指摘しています。こうした高温での予熱は、一般家庭にとって穏やかな方法とはいえません。回答の動作が具体的であるほど、ユーザーはそのまま実行しがちです。具体的な助言が利用場面に合っていなければ、「プロっぽく見える」ことが実際のリスクに変わってしまいます。
Kimi K2.7 Code の結果は、平均点だけでは足りない理由をさらにはっきり示しています。「破れてしまったらどう立て直すか」の問題で最高点を取り、生地がすでに破れ、卵もまだ固まりきっていない半端な状態を前に、実際に手を動かせる立て直しの手順を示しました。生地の配合や 3 人分の場面でも、役立つ細部を示しています。
ところが「朝 20 分で仕上げる」問題では、ページは見過ごせない食品安全上の重大リスクを指摘しています。回答が、卵を前もって取り出して室温に置いておいてよいと示唆していたのです。ほかの問題がどれだけよく書けていても、この点は切り離して示すべきで、「立て直しの問題で最高点」と相殺してはいけません。
これは、Kimi K2.7 Code の助言がすべて信頼できないという意味でも、「食品安全に弱い」という恒久的なレッテルを貼るものでもありません。正確に言えば、今回のこの問題の、この具体的な助言において、ページのルールが定める重大リスクが現れたということです。ユーザーにとっては、数点差の総合順位よりもこの情報のほうが優先度は高いのです。
3. 4 つのモデルは、4 タイプのキッチンアシスタントに近い
Sonnet 5:初めて作るときに頼りやすい安定型
Sonnet 5 の強みは、ある 1 問が際立って見事なことではなく、12 問全体を通してバランスがよいことです。初めて作る場面、フライパンの火加減、20 分で作る朝食などの場面で首位を保ち、ページに記録されたルール上の注意や重大リスクにも該当しませんでした。
このタイプのモデルは、自分なりのキッチンでの判断がまだ身についていないユーザーに向いています。まず工程、順序、判断のポイントを書き出してもらい、手元のフライパンと材料に合わせて削っていけばよいでしょう。限界もはっきりしています。保存と失敗の診断の問題では最も強いわけではありません。また、レシピの情報量が多いので、実際に料理する前には、長い説明を、見ながら実行できる数ステップの手順カードに縮める必要があります。
GLM 5.2:工程の分解は得意、火加減の助言は要確認
GLM 5.2 は、複雑な条件をリストに整理するのが得意です。材料が足りない、複数人分、保存といった問題では、何が足りないか、何を先にやるか、いつ対処するか、時間をどう配分するかを、かなり網羅的に示すことがよくあります。
工程の整理が上手なアシスタントといえます。使うときは、高温、予熱、油の量、保存に関わる動作を重点的に見直してください。回答がプロのレシピのように読めるからといって、実際の器具や家庭の環境に照らした判断を省かないことです。
Kimi K2.7 Code:立て直しが際立つ一方、安全面の助言は 1 つずつ確認を
Kimi K2.7 Code の強みは、「もう問題が起きてしまった、どうする?」に集中しています。フライパンの中が今どういう状態かを読み取り、「最初からやり直す」よりも具体的な立て直し方を示せます。多くのモデルが見落としがちな点です。立て直しの問題では、標準的な工程を語り直すのではなく、不完全な途中の状態を受け入れることが求められるからです。
一方で、前夜の仕込みの場面で出た重大リスクは、モデルが動作をうまく示せることと、その動作が安全面のふるいにかけられていることは別だと示しています。食品の保存、子どもの食事、前夜からの下ごしらえが絡むときは、安全面の助言を独立したチェック項目として扱う必要があります。
GPT-5.6 Terra:基本のレシピは悪くないが、トラブル対応は不安定
GPT-5.6 Terra は、初めて作る人向けの通しのレシピで 84.2 点を取り、配合、フライパンの温度、基本の工程をかなりしっかり書いています。「まだ作り始めていないので、まず最初から最後までの流れを教えて」という依頼に対しては、出発点は悪くありません。
しかし、生地の配合、ホットプレートの火加減、失敗の診断の問題では、はっきり後れを取りました。一見完全な入門説明は書けても、ユーザーがすでに失敗したあとで、どの変数に問題があったのかを正確に突き止められるとは限らない、ということです。
これが「レシピを書ける」ことと「人を導いて作業をやり遂げさせる」ことの違いです。前者は理想的な道筋を 1 本組み立てれば済みますが、後者は理想の道筋から外れたあとに何が起きたのかも理解しなければなりません。
4. 重大リスクを平均点の中に隠してはいけない理由
従来の合計点には、自然な誘惑があります。各問の点数を足し上げて、最高点を選ぶことです。しかし家庭での作業では、ミスによって代償が違います。
「この文は少しくどい」と「この保存方法の助言は食品安全上の問題を招くおそれがある」を、同じ足し算・引き算の中で相殺すべきではありません。「立て直し方を伝えていない」と「過度に攻めた高温の動作を勧めた」も、ただの減点 2 つとして扱うべきではありません。
今回のテストは、すでに大事なことをしています。ページでは、ルールベースの平均点に加えて、ルール上の注意と重大リスクを別に表示しています。この構造は残す価値があり、さらに 3 層の結果へと広げられます。
- タスク達成スコア:ユーザーが回答に従って目標を達成できるか。
- プロセス品質スコア:手順、説明、条件への適合、立て直しがわかりやすいか。
- 相殺できないリスクラベル:食品安全、危険な操作、問題の制約に明らかに反する助言が現れたか。
実際のユーザーにとっては、「これに従って作っても大丈夫か」を決めるのは、多くの場合、第 1 層より先に第 3 層です。
5. このテストは一般のユーザーにどう役立つのか?
このテストは、キッチンのあらゆる問題で最良のモデルを示したわけではありません。その代わりに、より実用的な選び方を提示しています。
- 初めて挑戦し、回り道を減らしたい:全体として安定していて、リスクに該当していない回答を優先して見る。
- 手元の材料がそろっていない:標準の配合に固執せず、今ある材料に合わせて組み立て直しているかを重点的に見る。
- 生地が破れた、フライパンにくっついた:基本のレシピがきれいに書けているかだけでなく、失敗の診断と立て直しの手順を重点的に見る。
- 子ども、翌日までの保存、高温の操作が関わる:まずリスクラベルを確認し、そのあとで合計点と説明の質を見る。
- 20 分以内に仕上げたい:前の晩に準備できる部分を割り振っているか、保存条件の説明がはっきりしているかを見る。
より確実な使い方は、モデルの回答を「操作手順の第 1 版」として扱い、さらに次の 3 つを問い直すことです。
- 自分のフライパンや材料は、標準の条件とどこが違うか?
- 途中で特定の失敗が起きたら、どのステップで止める、あるいは調整すべきか?
- この助言には、別途確認が必要な食品安全上の問題が含まれていないか?
モデルの書き方が具体的であるほど、これらの問いを確かめる価値があります。具体的な回答は確かに実行しやすい一方で、間違った動作をプロらしい指示に見せかけやすくもあるからです。
6. 暮らしのタスクは「正解らしく見えるか」だけでは測れない
煎餅果子のこの問題群が Folkbench に与えた示唆は、今後レシピをもっと増やすべきだということではありません。「現実のタスクを実際に実行できるか」を、独立した方向性として育てていけるということです。
暮らしのタスクのよい評価では、少なくとも次の 4 点を事前に明記しておくべきです。
- ユーザーの出発点となる条件は何か。
- タスク成功の最低基準は何か。
- どのミスなら立て直しで取り返せるか。
- どのリスクは、現れた時点で別途表示しなければならないか。
採点基準も、モデルの出力を見る前に固定しておくべきです。そうしないと、あるモデルの耳ざわりのよい一言を見てから「自然な表現」という項目を急に追加したり、別のモデルの危険な助言を見てから安全の重みを急に引き上げたりして、最後には検証しようのない成績表ができあがってしまいます。
今回のテストには、すでによい土台があります。場面の統一、出力要件の統一、promptHash の一致、そして総合スコアとリスク表示の併記です。次にいちばん改善する価値があるのは、平均的な成績、1 問あたりの最高到達点、失敗の種類、重大リスクを分けて保存することです。そうすれば読者は「モデルが全体としてどうだったか」と同時に、「どこで期待を裏切られやすいか」も知ることができます。
おわりに:本当に役立つモデルは、うまくいかない一歩に付き添えなければならない
完全なレシピを書くのは、言葉を組み立てる力です。フライパン、材料、時間に合わせて手順を調整するのは、条件を理解する力です。生地が破れたあとにどう続けるかを伝えるのは、状態を判断し、失敗から立ち直る力です。翌日までの保存という問題を前にはっきり立ち止まるのは、安全の境界を守る力です。
この 4 つが重なって初めて、普通の人が言う「このモデルは本当に役に立つ」に近づきます。
ですから、今回の煎餅果子テストで最も残しておきたい結論は、Sonnet 5 が GPT-5.6 Terra より何点高いかでも、家庭のキッチンのあらゆる問題で誰が勝てるかでもありません。現実のタスクの評価では、「やり遂げられるか」「問題が起きたら立て直せるか」「受け入れられないリスクはないか」を同時に示さなければならない、ということです。
テストの範囲
本記事は、Folkbench のページで現在公開されている V1 の場面と結果に基づいて書いています。サンプルは家庭のキッチンを想定した 12 問と、promptHash が一致した 48 件の結果です。ルールベースのスコアは、この同一問題群の結果を横並びで比べるためだけのものです。食品安全の専門家の意見に代わるものではなく、これをもとに、あらゆる料理タスクにおけるモデルの一般的な能力を推し量ることもできません。保存、子どもの食事、高温の操作が関わる場合は、実際の食材、器具、地域の食品安全上の要件に基づいて、ユーザー自身が判断してください。


