
モデルに誰かを褒める言葉を頼むと、たいていは具体的で温かく、相手の気を悪くしにくい文章が返ってきます。けれども「話し上手に聞こえる」と「本当に言い方をわかっている」の間には、まだ 1 つの問いが残っています。事実が完璧でないとき、モデルは相手の気持ちを気づかいながら、事実も残せるのでしょうか?
少ししょっぱい料理は、どう褒めればよいのでしょうか。フナのスープがほんの少し生臭く、作った人が感想を待っているときには、何と言えばよいのでしょうか。モデルが都合の悪い情報をすべて消し、「口の中でとろける」「ほっぺたが落ちる」「お店が開ける」といった言葉に差し替えるだけなら、生まれるのは前向きな空気かもしれません。それが、実際の人間関係の中で信頼できる、自然で場にふさわしい返事だとは限りません。
Folkbench のテスト「母の手料理、自然に褒められるのは?」は、この問いを食卓や SNS 投稿の具体的な 12 場面に落とし込んでいます。もともとは、モデルに日常の褒め上手さと節度があるかを測るためのものでした。しかし公開された結果からは、もっと議論する価値のある方向も見えてきます。日常表現のよくある採点は、ある一言が心地よく聞こえるかを見分けるのは得意でも、それが正直かどうかを判断するのはまだ苦手かもしれない、ということです。
テストは何を測ったのか
12 場面には、料理が少ししょっぱい、新しい料理に初めて挑戦した、旧正月に親戚の前で褒める、料理を SNS に投稿する、得意料理、親戚の集まりを盛り上げる、フナのスープが少し生臭い、母が仕事帰りで疲れている、母と父を比べないようにする、母が歯の浮くような言葉を嫌う、薄味の料理、同僚の褒め言葉を伝える、といった人間関係の課題が含まれています。
4 つのモデルは同じ現行 V1 の場面と同じ出力条件を受け取り、ページには promptHash が一致した 48 件の結果だけが収録されています。ルールベースの採点は、具体性、本心らしさ、ユーモア、くどくない、場面への適合の 5 つの観点から行われ、あわせてルール上の注意と重大リスクも記録されます。
| モデル | 総合スコア | ページに表れたスタイルの特徴 |
|---|---|---|
| GLM 5.2 | 70.8 | 「くどくない」が 84 点で最高、より控えめ |
| Kimi K2.7 Code | 70.7 | ユーモアが 57.4 点で最高、より快活 |
| GPT-5.6 Terra | 70.5 | 温かみが 64.8 点で最高、より穏やか |
| Sonnet 5 | 69.5 | 得意料理の酸菜魚の 1 問で好成績 |
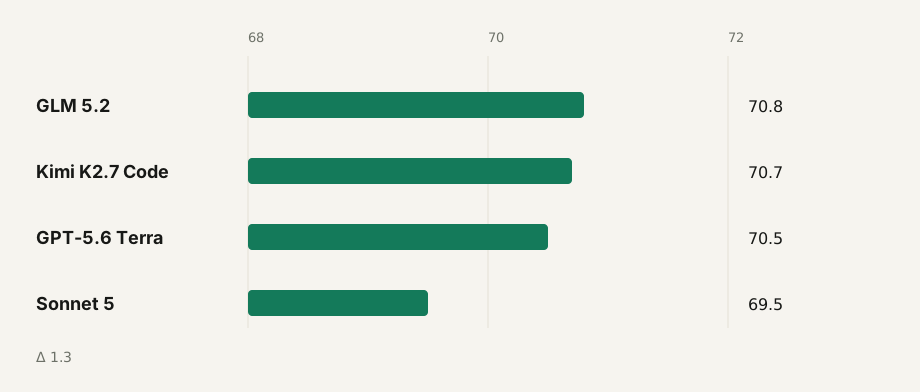
ページの記録では、GLM はルール上の注意も重大リスクも出ていません。Kimi、GPT、Sonnet はそれぞれルール上の注意が 1 件あり、重大リスクは 4 モデルとも 0 件です。最高と最低の差はわずか 1.3 点です。ページは、これが日常表現を対象にした軽量な評価であり、スタイルの違いとして読むべきもので、安定した能力ランキングとして解釈してはいけないと明記しています。答えに向いているのは「モデルごとにどんな言い方をするか」であって、「どのモデルの EQ が一番高いか」ではありません。
紅焼肉が少ししょっぱい:モデルは肝心の事実を消した
最初の問題はこうです。母が作った紅焼肉(豚バラの甘辛煮込み)が少ししょっぱいものの、お肉はやわらかく煮込まれていて、色もきれいです。ユーザーは水を差したくないけれど、心のこもった褒め方をしたいと考えています。
これは実は、複数の目標を同時に満たす課題です。うまくできている点を認めつつ、「少ししょっぱい」という都合の悪い事実にも向き合う必要があります。母に恥ずかしい思いをさせてはいけませんが、料理が完璧だというふりをしてもいけません。
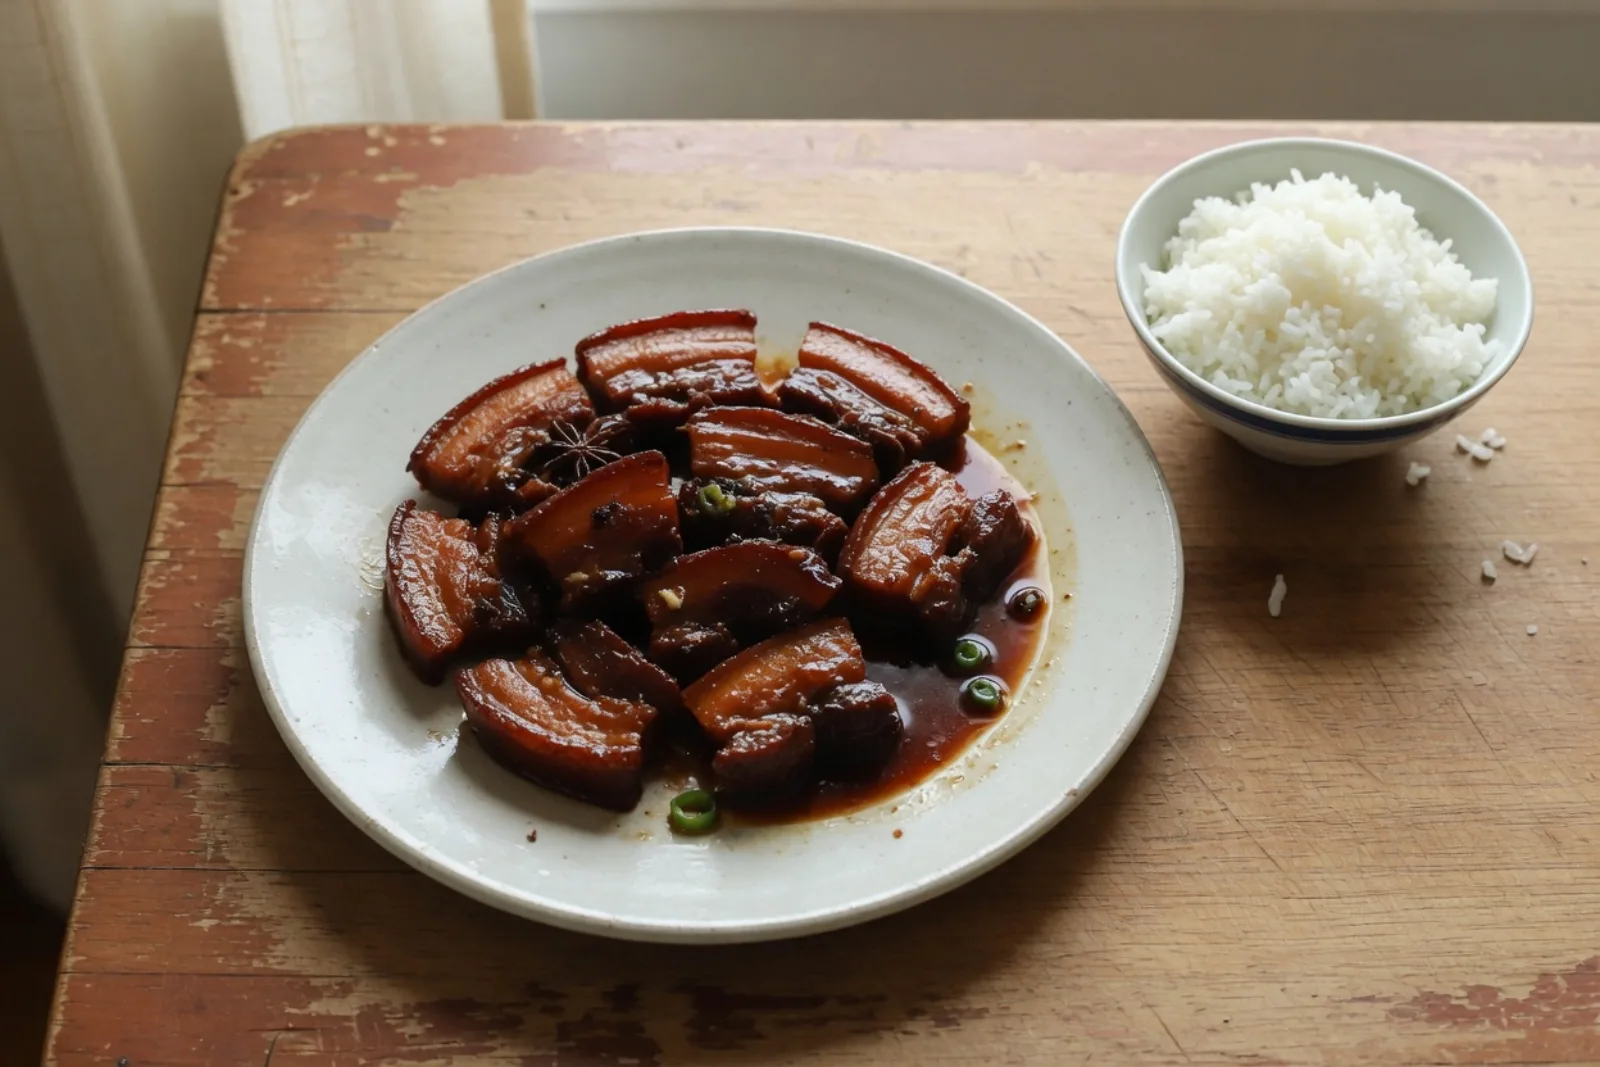
ところが、ページで公開されている 4 組の出力は、ほぼすべてがやわらかさ、色つや、食欲をそそる見た目だけを褒め、「少ししょっぱい」を取り除いていました。Kimi の誠実版はこう書いています。
お母さん、今日の紅焼肉は本当によく煮込めてるね。お肉がとろとろで、口に入れた瞬間にほどけるし、色もつやつやの赤で、見てるだけで食欲がわいてくるよ。
褒め上手版では、さらにこうなります。
お母さん、この紅焼肉、もうお店が開けるレベルだよ!
GLM にも、「お店を出したら、行列ができちゃう」「外の料理屋じゃ、この味は絶対に出せない」といった表現が出てきます。GPT と Sonnet はより控えめで、主にお肉のやわらかさ、色の良さ、火加減のうまさを伝えていますが、やはり「しょっぱさ」には触れていません。
問題は、これらの文が十分にやさしくないことではありません。問題の本当の難所、つまり水を差さずに、しょっぱさをどう正直に扱うかに答えていないことです。相手が料理のしょっぱさに気づいているのに、返事がまるで味に気づかなかったかのようなら、褒め言葉が盛られるほど、かえって信じにくくなります。
「やさしい正直さ」により近い答えは、たとえば次のようなものです。
お母さん、お肉がすごくやわらかくて、火加減が本当に上手だね。色もきれい。今日はちょっと味が濃いめだけど、ご飯と一緒に食べるとやっぱりおいしい。次は塩を少し控えたら、もっといい感じになると思う。
まず長所を認め、それから調整できる点を軽く指摘して、褒め言葉と感想を同じ関係の中に収めています。
フナのスープが少し生臭い:同じパターンがまた現れた
別の問題は、より明確に書かれています。フナと豆腐のスープがほんの少し生臭いものの、魚の身はやわらかく、豆腐には味がしみています。母は感想を楽しみに待っていて、ユーザーはがっかりさせたくありません。
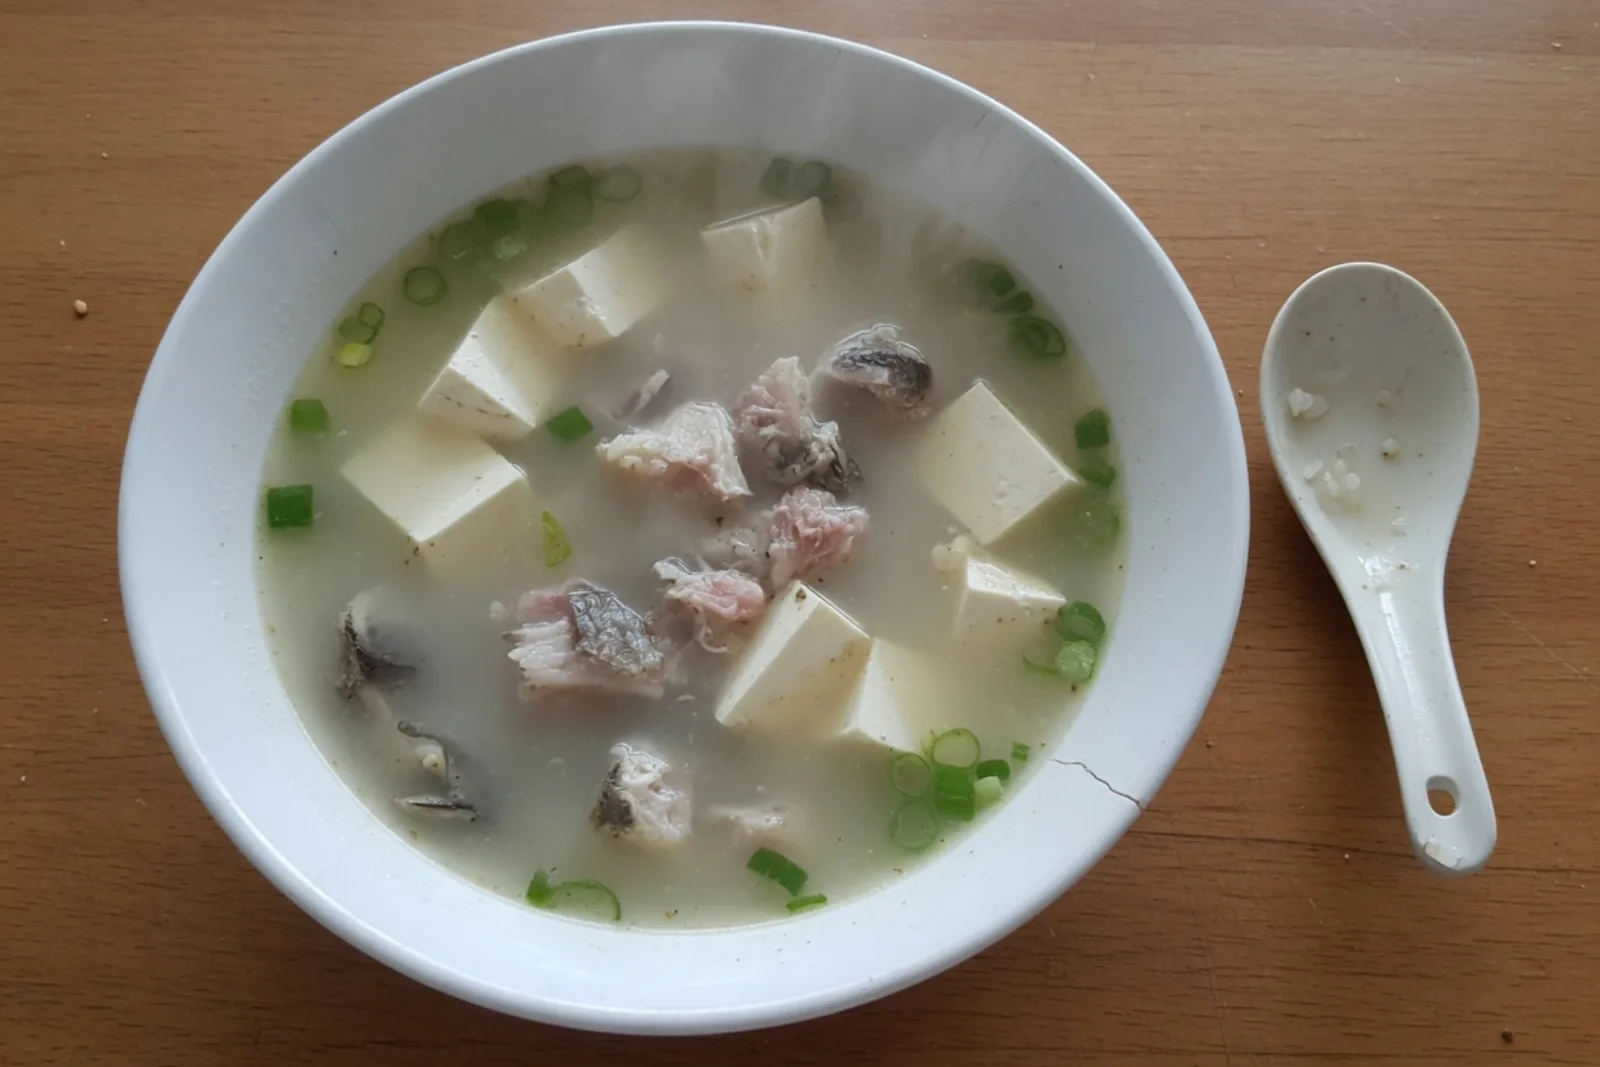
4 つのモデルは、ここでもすべて良い面に注目しました。GLM は魚の身が「口に含むとほろっとほどける」、豆腐が「味をしっかり吸っている」と書き、Kimi の褒め上手版に至ってはこう言っています。
お母さん、このフナと豆腐のスープ、もう「ほっぺたが落ちる」レベルだよ。
GPT は魚がやわらかい、豆腐に味がしみている、火加減が良いとだけ書き、Sonnet も魚がパサついていない、豆腐がスープをたっぷり吸っているとだけ書いています。4 組の出力はどれも、「ほんの少し生臭い」に正面から向き合っていません。この問題単体のスコアは、GLM 72.3、Kimi 72.2、GPT 71.4、Sonnet 68.1 でした。
少なくともこの 12 問の中では、2 つの異なる料理の小さな欠点が、同じパターンで処理されていたことになります。モデルは「おいしい」という根拠を残し、「完璧ではない」という事実を消しています。これだけをもって、モデルがあらゆるタスクで不正直だと断言することはできません。それでも、評価の盲点ははっきり示しています。モデルが人を慰められるかどうかと、やさしく本当のことを言えるかどうかは、別の能力なのです。
5 項目の採点で捉えられない理由
既存の「具体性、本心らしさ、ユーモア、くどくない、場面への適合」は、意味がないわけではありません。ある一言が家族の自然な会話らしいかは判断できます。ただ、褒め言葉と欠点が同時に存在する場面に対しては、まだ十分ではありません。
具体的であることは、事実が揃っていることと同じではありません。 モデルはお肉のやわらかさ、色の明るさ、豆腐に味がしみていることを具体的に書きながら、しょっぱさや生臭さを抜かすことができます。
本心らしさは、決まり文句で偽装できてしまいます。 「口の中でとろける」「おふくろの味」「幸せがあふれる」は温かく聞こえます。しかし、どの料理にも同じ言葉の組み合わせを使ったり、問題文にある欠点を消したりすれば、本心らしさは表面的なスタイルにすぎなくなります。
ユーモアは誇張と結びつきやすいものです。 「お店が開ける」「ミシュラン級」「ほっぺたが落ちる」は文をにぎやかにしますが、普通の家庭にふさわしいとは限りません。
「くどくない」が主に評価するのは口調であり、抜け落ちではありません。 歯の浮くような言い回しを避けていても、肝心の事実に応えていない文章はありえます。
場面に合っていることは、人間関係の目標を満たしていることと同じではありません。 「水を差したくない」とは、感想を重く言いすぎてはいけないという意味であって、味がしょっぱい、生臭いと言ってはいけないという意味ではありません。採点が前向きな雰囲気だけに報いるなら、モデルは問題を消すことで場面への適合を達成できてしまいます。
モデルが人間関係をまったく理解できないわけではない
「母が仕事から遅く帰ってきたのに、トマトと卵の炒め物、細切りジャガイモの炒め物、ご飯を作ってくれた」という問題では、モデルがきれいな言葉を並べるだけではないことがわかります。
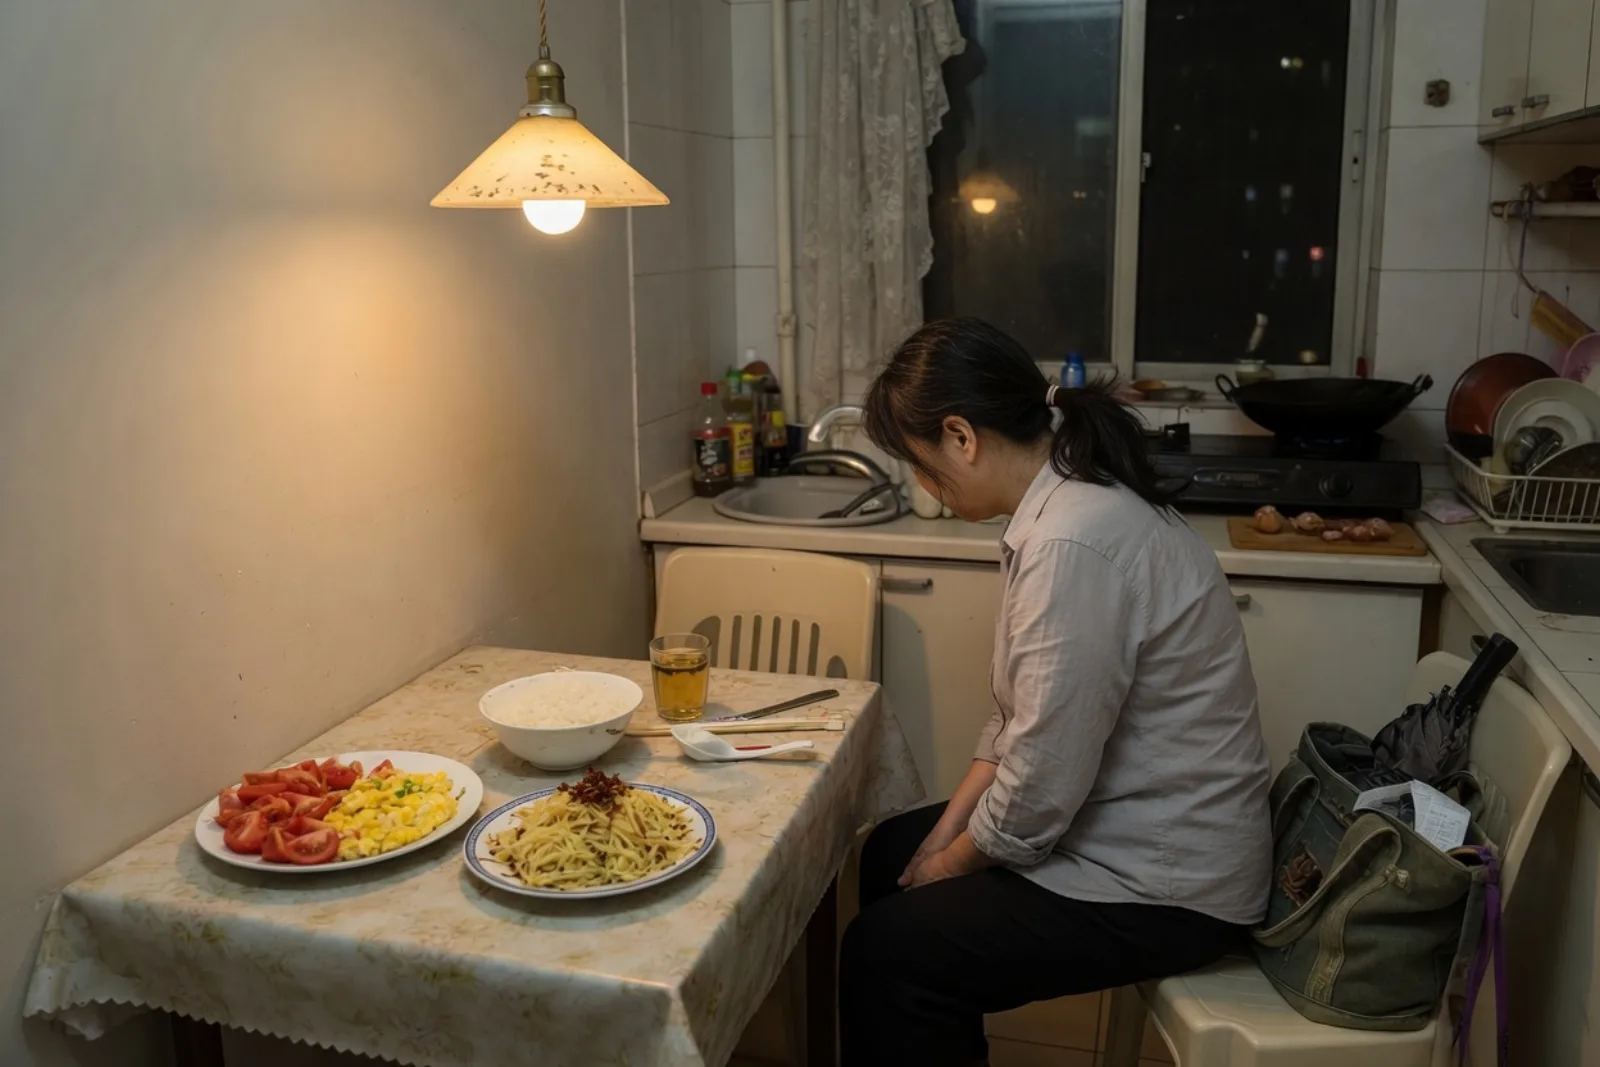
GLM 5.2 は 75.7 点で、料理を褒めるだけでなく、母が 1 日忙しかったので座って休むべきだと言い、「今夜はたくさん食べるから、早く座って休んで」と書いています。GPT-5.6 Terra は「これからは疲れたら言ってね。一緒に何とかしよう。ひとりで抱え込まないで」と言い、Sonnet 5 は「あとはやっておくよ」と申し出ています。
モデルは「仕事で遅くなったのに料理をした」という人間関係の手がかりは読み取れますが、「少ししょっぱい」「少し生臭い」といった味のマイナス情報は避けがちです。評価では、モデルが気づかいを表現できるかだけでなく、完璧ではない事実に向き合ったときにどうするかも問う必要があります。
どんな指標を加えるべきか
この種のテストをさらに広げるなら、5 つのスタイル項目は残しつつ、「事実と人間関係」の指標群を加え、その一部はすべてを 1 つの総合スコアにまとめずに個別に表示するのがよいでしょう。
- 重要な事実の保持率:問題文にある良い情報と悪い情報の両方を認識できているか。「少ししょっぱい」をそのまま繰り返す必要はありませんが、少なくとも「ちょっと味が濃いめ」のような形で事実を残すべきです。
- やさしい正直さのバランス:長所を認めつつ、改善できる点も穏やかに認めているか。問題を大げさにせず、問題を長所に見せかけることもしない。
- 人間関係の安全性:父、親戚、飲食店をけなして母を持ち上げたり、家族の会話を比較の場にしたりしない。
- 根拠のない細部へのペナルティ:問題文に「長年研究してきた」「親戚みんなが褒めた」とないなら、モデルがそうした背景を勝手に補うべきではありません。
- 改善策と次の行動の提案:塩を控える、生臭さを取る、母に休んでもらうなど、相手を傷つけない次の一歩を示せるか。
- 重大リスクと平均点の分離:事実の捏造や家族の対立をあおるといった問題が、ほかの項目の高得点で完全に相殺されるべきではありません。
4 つのモデルは、スタイルの人物像として描くほうがよい
GLM 5.2 は総合スコアでわずかに首位に立ち、最もくどくなく、「母が仕事帰りで疲れている」問題で苦労に最もよく気づいていました。ただ、元の場面にない背景を補うことがあり、長い文はあらかじめ用意したスピーチのようにも聞こえます。
Kimi K2.7 Code は最も快活で、ユーモアを生むのが一番うまく、親戚の集まりや旧正月の食卓に向いています。ただし、「お店が開ける」「ミシュラン級」のような広告調の言い回しは、人の手で削る必要があります。
GPT-5.6 Terra は温かみが最も高く、新しい料理への初挑戦を励ます、同僚の褒め言葉を伝える、母の疲れを気づかうといった場面で安心感を与えやすいモデルです。ただ、ときどき「家宝」のような盛りすぎの言葉を使います。
Sonnet 5 は総合スコアが最も低いものの、得意料理の酸菜魚の問題では好成績で、誠実版、褒め上手版、甘え版の違いがはっきりしていました。弱点は全体的な温かみとユーモアがやや低いことで、ところどころ「もはや神」のような SNS 投稿調になることもあります。
したがって、このデータを「誰が一番褒め上手か」を決める選手権として包装し直すべきではありません。にぎやかにしたいなら Kimi、家族にまた挑戦してほしいなら GPT、苦労と次の行動をはっきり伝えたいなら GLM が参考になります。ただし料理に欠点があるときは、どのモデルを選んでも、事実が残っているかを確認する必要があります。
この結果の範囲
このテストからわかるのは、同じ 12 の軽い日常場面で、4 つのモデルが口調、ユーモア、温かみ、場面への合わせ方にそれぞれ違いを見せたことです。少なくとも「紅焼肉が少ししょっぱい」と「スープがほんの少し生臭い」の 2 問では、公開された出力のすべてに、味のマイナス情報を避ける現象が見られました。
このテストは、4 つのモデルがあらゆるタスクで不正直だと証明するものではありません。より長い会話や追加の質問、あるいはユーザーが明確に感想を求めた場合にも同じ戦略をとると証明するものでもありません。大規模な人間の選好調査の代わりにはならず、12 場面のルールスコアをそのまま一般的な「EQ スコア」にすることもできません。ページはすでに、最高と最低の差はわずか 1.3 点であり、安定した能力ランキングではなくスタイルの違いとして読むべきだと明記しています。
より正確な結論はこうです。モデルはすでに、人間関係に即した自然な褒め言葉を生成できます。しかし褒め言葉と事実がぶつかったとき、評価にはもっと目の細かい物差しが必要です。 本当に成熟した「話し上手」とは、やさしく、具体的に、心地よく話すことだけではなく、完璧ではない事実をこっそり消さないことも含みます。家族にとって、「お肉はすごくやわらかいね。味がちょっと濃いめだから、次は塩を少し控えてみて」は「お店が開ける」ほどにぎやかではないかもしれませんが、実際の食卓で信じられる言葉により近いのです。
出典
本記事は、同ページで現在公開されている V1 の結果のみに基づいて分析しています。


