
O primeiro artigo dizia para não confiar cegamente em uma captura de tela. Este vai além e pergunta: por que nem mesmo uma nota merece confiança cega?
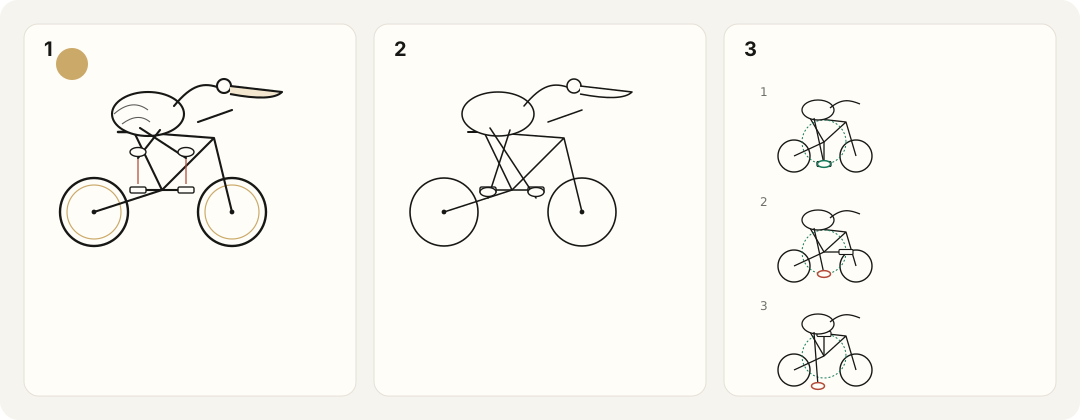
Imagine três pelicanos andando de bicicleta. O primeiro foi desenhado com muito capricho: penas em camadas, reflexos de luz nas rodas e até um pôr do sol ao fundo. Olhando de perto, porém, os dois pés estão suspensos acima dos pedais. O segundo parece um esboço de poucos traços. Não tem sombra nem uma paleta bonita. Mas o quadro se conecta de forma coerente, o corpo está sentado no selim e os pés de fato estão nos pedais. O terceiro parece correto em uma imagem estática. Aperte o play, e um pé começa a flutuar por uma trajetória própria. O pedal gira por conta própria, e o pelicano pedala por conta própria. Qual deles merece a nota mais alta?
Se a resposta for “o primeiro é o mais bonito”, estamos avaliando gosto. Se for “o segundo é o mais confiável”, estamos avaliando se a tarefa foi cumprida. Se olharmos só uma captura de tela, o erro do terceiro talvez nunca seja descoberto.
O artigo anterior defendia que, para julgar se um modelo realmente piorou, é preciso repetir testes em condições comparáveis, e não escolher uma única saída. Escondida nesse argumento há uma premissa que ainda não foi resolvida: já sabemos o que conta como aprovado. Se essa premissa for falsa, a repetição não torna a conclusão confiável automaticamente. Ela pode apenas fazer com que uma régua torta meça de forma cada vez mais estável. Este artigo começa daí. Como transformar “este pelicano parece razoável” em um método de avaliação que tenha fundamento, possa ser reverificado e possa ser automatizado passo a passo?
Observação: as amostras, os números, os esquemas de pontuação e as configurações deste artigo são exemplos metodológicos. Não correspondem a um ranking real de modelos nem significam que o Folkbench já implementou esses processos. As pesquisas citadas servem para explicar métodos e riscos relacionados; não significam que a proposta deste artigo já foi validada experimentalmente.
1. Escreva a tarefa antes de discutir como pontuá-la
O teste do pelicano atrai porque desenha o erro na superfície. Uma perna a mais, um quadro que não se fecha e um pé que não alcança o pedal dificilmente são disfarçados por uma frase bem construída. Mas o que ele mede de fato ainda precisa ser dito com mais precisão. Pedir a um modelo que “desenhe em SVG um pelicano andando de bicicleta” observa diretamente se ele consegue transformar um pedido escrito em código, e se esse código gera uma imagem que atende ao pedido. Só esse resultado não estabelece qual representação espacial ele usou internamente. Também não permite que “foi bem nesta questão” substitua “tem uma capacidade completa de compreensão espacial”.
Se o modelo puder renderizar, olhar a imagem e revisar várias vezes, o que se mede é um fluxo de trabalho com feedback, não uma única geração de código. As duas coisas merecem ser medidas, mas não devem se misturar no mesmo ranking de primeira resposta. O ponto mais prático é este: um requisito que não foi escrito na tarefa não deve aparecer de repente na hora de pontuar. Se a tarefa original é só “desenhe um pelicano andando de bicicleta”, não devemos exigir depois uma bicicleta de estrada padrão, duas rodas exatamente do mesmo tamanho, as duas asas no guidão ou todas as peças claramente à mostra. Perspectiva, oclusão e estilização de desenho animado razoáveis fazem parte do desenho aberto. Eu dividiria o teste em dois tipos.
Um mantém a tarefa aberta e observa como o modelo entende e expressa o “andar de bicicleta”. A pontuação cobra apenas os requisitos claros e necessários, e aceita que amostras de fronteira possam ser contestadas. O outro é uma tarefa restrita. Ela define, antes de qualquer execução, o ponto de vista, as relações visíveis, o formato de saída e as técnicas permitidas. Por exemplo: a vista é principalmente lateral; um leve deslocamento é permitido para mostrar os dois pés; o contato de cada pé com seu pedal precisa estar visível; a entrega é um único SVG autocontido; nenhuma imagem ou script externo é usado.
Uma tarefa restrita muda a tarefa original. Isso não é um defeito. Desde que a versão da tarefa esteja identificada, ela permite fazer uma pergunta mais específica: o modelo errou o ponto de vista, não deixou o contato claro ou desenhou errado a estrutura da bicicleta? A questão não é qual versão é mais “autêntica”. Pontue uma tarefa aberta como tarefa aberta e uma tarefa restrita como tarefa restrita. Não combine uma tarefa vaga com um critério rígido inventado depois.
2. Não corra para a nota total. Primeiro, decomponha o “andar de bicicleta”
“No geral, está bom. Nota 8.” Essa é a forma mais cômoda de pontuar, e a mais difícil de reverificar. O 8 veio de uma figura correta, de uma estrutura coerente ou de uma paleta agradável? Na próxima vez que o mesmo erro aparecer, o juiz vai dar 9? Eu começaria com quatro dimensões, sem tratá-las como quatro números preenchidos no olhômetro.
| Dimensão | O que verifica principalmente | O que não deve entrar na conta |
|---|---|---|
| Pelican: a figura | Se é reconhecível como pelicano; se o corpo ou os membros têm anomalias evidentes; se atende à visibilidade que a tarefa exigiu explicitamente | Grau de realismo, detalhe das penas ou preferência pessoal de estilo que a tarefa não exigiu |
| Bicycle: a bicicleta | Se rodas, quadro, pedivela, pedais etc. formam a estrutura coerente que a tarefa exigiu | Marca, modelo, decoração ou um jeito específico de escrever SVG que a tarefa não exigiu |
| Riding: a relação de pedalar | Se o corpo está apoiado de forma coerente; se os pés correspondem aos pedais; se uma relação de controle exigida pela tarefa se sustenta | Apenas “o pássaro está ao lado da bicicleta” ou “os dois objetos existem” |
| Animation: relações no tempo | Se um movimento exigido acontece; se contato e conexão se mantêm durante o movimento; se há saltos ou interpenetrações incoerentes | Animação que uma tarefa estática nunca exigiu; efeitos sem relação com a tarefa |
Um objeto existir não é o mesmo que uma relação se sustentar. “Há um pé” e “há um pedal” são dois julgamentos sobre objetos. “O pé está no pedal” é um julgamento sobre uma relação. Um passo adiante, “o pé continua no pedal enquanto o pedal gira” é um julgamento sobre uma relação ao longo do tempo. Por isso, verificar só “se o pelicano, a bicicleta e as duas rodas estão todos presentes” está longe de bastar. O que deve ser separado é o vínculo entre corpo e selim, pé e pedal, pedal e pedivela, quadro e eixo da roda.
Há trabalhos relacionados em que se inspirar. O TIFA transforma os requisitos de um texto em várias perguntas e depois usa resposta a perguntas visuais para verificar se uma imagem gerada os atende. Ele não é um avaliador de pelicanos pronto para uso, mas mostra uma direção útil: conferir a imagem com os requisitos item por item, em vez de dar só uma impressão geral. 1 Na implementação, eu manteria quatro estados em cada verificação: pass, fail, uncertain e not_applicable. Eles significam passou, falhou, evidência insuficiente e não se aplica.
A distinção importante é entre os dois últimos. Se uma tarefa estática não exigiu animação, Animation “não se aplica”. Se a animação foi exigida, mas o material não basta para julgar a interpenetração, há “evidência insuficiente”. O primeiro caso não deve tirar pontos. O segundo não pode contar automaticamente como aprovado. Depois, separe os itens em condições necessárias e itens adicionais de qualidade. As condições necessárias decidem se o resultado é aprovado. Os itens adicionais descrevem detalhes e aparência. Uma falha clara em uma condição necessária não pode ser compensada com penas bonitas, um fundo ou um degradê.
Um relatório inicial pode dizer apenas quantas verificações da figura passaram, em qual item da estrutura da bicicleta houve falha, se a relação de pedalar tem alguma questão em aberto e se a animação se aplica. Ele não precisa de uma nota total com duas casas decimais. Se uma nota combinada for realmente necessária, publique com antecedência os itens aplicáveis, os pesos e o tratamento dos valores ausentes, e mostre à parte as falhas de condições necessárias. Os rankings produzidos por pesos diferentes também merecem uma verificação de robustez. Uma nota total é um resumo comprimido. Não é motivo para substituir a evidência original.
3. O DOM do SVG ajuda, mas não é um diagrama estrutural que já vem com a resposta
Ao ver um SVG, o instinto de engenharia vem fácil: se tem código-fonte, por que não analisá-lo diretamente? As regras saem rápido. Encontrou dois elementos circle, há duas rodas. Encontrou um elemento chamado foot, há um pé. Se as caixas delimitadoras do pé e do pedal se cruzam, o pé está no pedal. O problema é que cada um desses passos confunde “uma forma de expressar algo em código” com “um fato semântico na imagem”.
Uma roda pode ser um elemento de círculo ou um caminho (path). Duas rodas podem ser escritas separadamente ou reaproveitadas com use. Um único objeto visual também pode ser formado por vários grupos e caminhos. A especificação SVG permite essas diferentes formas de expressão; ela não exige que um objeto do mundo real corresponda a um nó do DOM. 2 Assim, não encontrar dois elementos circle não prova que falta uma roda, e encontrar dois não prova que estejam em uma posição coerente. Um elemento chamado foot tem apenas um nome dado por quem o gerou; isso não é uma verificação independente.
As regras estáticas servem melhor para verificar restrições que podem ser decididas
Por exemplo: se a saída pode ser analisada no formato combinado, se contém uma referência externa que a tarefa proíbe, se contém um script não permitido e se renderiza conteúdo não vazio no ambiente especificado. Essas verificações têm uma base clara e são fáceis de registrar em log. Elas respondem “se atende às restrições técnicas e de entrega”, não “se este pássaro andou de bicicleta corretamente”. Uma renderização bem-sucedida também não substitui uma verificação de formato. A especificação SVG distingue formas de documento e modos de processamento. Um fragmento embutido em uma página web e um arquivo SVG independente não devem ser aceitos sob o mesmo requisito de análise sem que essa escolha seja declarada. 3
Uma verificação geométrica precisa antes definir o que está sendo medido
Depois que as regiões geométricas visíveis correspondentes ao pé e ao pedal forem identificadas com confiabilidade, é possível calcular distância, sobreposição e trajetória. Por exemplo, divida a distância entre a sola do pé e a superfície de contato do pedal por um diâmetro de roda de referência, combinado previamente, na mesma imagem. Isso dá uma distância relativa. Discutir “quão longe do pedal” nesse formato é mais interpretável do que aplicar um limiar fixo de pixels. Como a superfície de contato é definida e quanto erro se tolera ainda precisam ser calibrados em amostras anotadas. Não dá para anunciar do nada que “cinco pixels de diferença é certamente um erro”.
A medição também precisa considerar transformações de coordenadas, contorno (stroke), recorte e visibilidade real. Um elemento SVG pode estar em um sistema de coordenadas aninhado. A especificação também prevê casos em que um elemento que não é de fato renderizado ainda tem uma caixa delimitadora. Ter uma caixa delimitadora não é o mesmo que ter o limite do objeto visível na imagem. 4 Duas caixas delimitadoras que se cruzam não significam que a sola toca o pedal. Duas regiões planas sobrepostas podem ser só oclusão em profundidade, e não um apoio coerente. Em SVG genérico, regras geométricas servem melhor como evidência auxiliar depois de validadas, não como um juiz sem calibração com poder de veto.
É possível, para facilitar a automação, exigir um conjunto uniforme de IDs de peças, pontos-chave e estrutura de grupos. Isso deveria ser uma trilha separada de “saída estruturada”: verificar se essas declarações correspondem à imagem real. Não deixe o modelo escrever “contato correto” e o programa de avaliação simplesmente acreditar. O DOM nos dá mais informação verificável. Ele não resolve de graça o reconhecimento semântico.
4. Antes que um juiz visual assuma o posto, aplique uma prova ao juiz
Se as regras estáticas não bastam, deixe um modelo que enxerga imagens dar a nota. Vale a pena seguir esse caminho. Mas “o modelo consegue descrever uma imagem” não deve ser tratado como “o modelo consegue julgar de forma estável um erro espacial sutil”. O trabalho de 2023 sobre MT-Bench e Chatbot Arena discute o viés de posição, o viés de prolixidade e a autopreferência em juízes LLM, e também relata que modelos fortes concordaram razoavelmente bem com a preferência humana em avaliações de texto específicas. A conclusão razoável não é “juízes de modelo não são confiáveis”. É “a credibilidade deles depende da tarefa e precisa ser verificada”. Esses resultados de avaliação de texto também não podem ser usados diretamente como taxa de acerto da pontuação visual. 5
A própria capacidade visual precisa ser verificada. O estudo BlindTest, de 2024, constatou que os modelos de visão e linguagem testados ainda erravam em geometria simples, como saber se círculos se sobrepõem ou se linhas se cruzam. Isso não significa que todos os modelos de hoje continuem naquele nível. Basta para lembrar que uma relação de contato sutil não deve ser considerada correta só porque o modelo é famoso. 6 Eu montaria primeiro um conjunto de amostras de referência humanas, em vez de entregar o ranking a um juiz de imediato.
O conjunto precisa de acertos e erros óbvios, e também de casos de fronteira: esboços, traços finos, oclusão razoável, caminhos complexos e trabalhos que estão certos parados, mas errados em movimento. Providencie pelo menos dois anotadores para pontuar de forma independente e às cegas, e depois revise as divergências. Os humanos também não são uma verdade de referência natural. Se duas pessoas lendo a mesma regra chegam sempre a conclusões opostas, talvez a primeira coisa a revisar seja a tarefa ou as instruções de pontuação. Uma amostra que não pode ser esclarecida pode continuar em disputa. Não é preciso inventar uma “resposta padrão”.
O juiz deve responder a perguntas concretas, não dar uma opinião de gosto
Dê a ele a tarefa original, as regras de pontuação congeladas e uma imagem renderizada de forma uniforme. Para um item de animação, dê também frames com marcação de tempo ou um vídeo. Não forneça junto o nome do provedor, uma posição no ranking ou a declaração do próprio modelo gerador de que “esta imagem atende totalmente aos requisitos”. Pergunte ao juiz item por item: “Cada pé toca o seu próprio pedal?” “O quadro visível se conecta de forma coerente aos eixos dianteiro e traseiro?” “Nestes momentos, o vínculo entre pé e pedal se mantém?”
Anexe a cada julgamento uma evidência curta e localizável, por exemplo: “em 2,0 segundos, o pé mais próximo do observador tem uma folga nítida em relação ao pedal”. Quando a evidência for insuficiente, retorne uncertain. Não encubra uma visão pouco clara com um parágrafo fluente. Texto na imagem, comentários do SVG e metadados só podem ser conteúdo sob teste. Não podem ser instruções que mudam as regras de pontuação. Ocultar um nome de arquivo ou um rótulo de canal não autoriza alterar o trabalho. Se for preciso um recorte ou uma imagem auxiliar anotada, guarde tanto a original quanto o registro do processamento.
A calibração não pode se apoiar em uma única “taxa de concordância geral”
Suponha que um conjunto de referência tenha 90 imagens aprovadas e 10 com um erro grave. Um juiz que sempre responde “passou” ainda obtém 90% de acerto geral, e deixa passar todos os erros graves. Por isso, eu verificaria separadamente quantos erros críticos foram perdidos, quantos trabalhos corretos foram rejeitados, se o desempenho é consistente entre estilos e se notas repetidas do mesmo trabalho são estáveis. Nas amostras de fronteira, veja também se o juiz está disposto a admitir que a evidência é insuficiente.
Algumas amostras que “mudam um único fator” são úteis: mantenha a original e tire um pé do pedal, ou mude só o fundo e deixe a estrutura intacta. A primeira mudança deve afetar a nota relacionada. A segunda não deve alterar sem motivo um julgamento estrutural. Essas amostras construídas são boas para diagnóstico, mas não podem substituir totalmente a saída real dos modelos. As amostras usadas para revisar o prompt de pontuação e as amostras reservadas para a verificação final do juiz precisam ficar separadas. Não ajuste tudo contra as mesmas respostas até o resultado parecer satisfatório para depois tratar essa nota como prova de generalização.
Uma votação entre vários juízes pode revelar divergências. Usar três modelos não torna os três julgamentos independentes: eles podem cometer o mesmo erro. A afirmação do próprio juiz de que “tenho 95% de certeza” não pode, sem calibração, ser tratada como 95% de acerto real. O que um juiz precisa provar é que consegue reconhecer um erro, não só que consegue explicar a própria nota.
5. Animação não é tirar mais algumas capturas. É verificar se uma relação se rompe no tempo
Uma pontuação estática pergunta: “Está no pedal agora?” Uma pontuação de animação pergunta: “Depois que começa a se mover, essa relação continua valendo?” Um pé que por acaso toca o pedal no primeiro frame não está, só por isso, acompanhando depois a trajetória do pedal. Por outro lado, fixar pé e pedal para que nenhum dos dois se mova não completa uma pedalada que a tarefa exigiu. A animação tem, portanto, pelo menos duas perguntas diferentes: se o que deveria se mover realmente se move, e se a conexão que deveria se manter durante o movimento continua se mantendo.
Primeiro, combine o cenário da animação. Pedalar parado no lugar, avançar e uma câmera que acompanha são tarefas diferentes. Se a tarefa não exigiu uma simulação mecânica precisa, uma restrição extra como a relação de marchas não deve ser acrescentada às escondidas. Se ela exige explicitamente que o pedivela gire e que o pé permaneça em contato com o pedal, esses requisitos entram na aceitação.
O ambiente de avaliação também precisa preservar o estado real da animação. Eis uma armadilha de engenharia bem concreta. A opção de captura de tela do Playwright animations="disabled" interrompe as animações compatíveis: animações finitas são avançadas até o fim, e animações infinitas são canceladas e voltam ao estado inicial. Ela não é sinônimo de “capturar exatamente um momento qualquer”. 7 Portanto, uma animação não pode ser marcada como aprovada porque alguém desligou a animação e capturou uma imagem bonita. Primeiro use um arquivo de teste com um movimento conhecido para verificar o controle de tempo e o método de captura, e só depois aplique-os à saída dos modelos. Os mecanismos de animação suportados também devem ser documentados.
Suponha que a tarefa exija um loop de 4 segundos. Um plano inicial é observar dois loops completos, amostrar a uma frequência predefinida e inspecionar, além disso, a transição entre loops e qualquer intervalo que pareça errado. A janela de observação, a frequência de amostragem e as regras para verificações extras devem ser fixadas antes da avaliação formal, e não endurecidas depois de ver de que lado está o problema. Mesmo assim, um conjunto finito de frames pode deixar passar uma falha breve entre eles. O relatório deve dizer “nenhum erro evidente foi encontrado na janela e nas condições de amostragem combinadas”, e não “está matematicamente provado que não houve interpenetração em momento algum”.
A oclusão normal em uma imagem plana também exige cuidado. Quando uma perna passa por trás do quadro, contornos sobrepostos não significam automaticamente interpenetração. O que precisa ser verificado é se a ordem de profundidade ou a conexão mudam de forma incoerente. Uma ampliação local ajuda a observar, mas não deve descartar o contexto espacial global. Se um juiz automático hoje só consegue lidar com imagens estáticas de forma confiável, publique os resultados estáticos e deixe a animação para revisão humana. Melhor admitir que esta régua ainda não alcança tão longe do que embutir em uma nota total uma capacidade que não foi medida.
6. O sistema de pontuação também erra, e pode criar a ilusão de que um modelo piorou de repente
Verificações estáticas, um juiz visual e revisão humana não encerram o problema. O próprio sistema pode mudar. O juiz de ontem era tolerante com uma pequena folga. Hoje, uma nova versão desconta pontos com rigor. O trabalho gerado não mudou nada, mas a taxa de aprovação no ranking cai. Se tudo o que se guarda é “nome do modelo, data, nota total”, uma mudança no juiz é facilmente confundida com degradação do modelo. Além do modelo gerador e dos parâmetros da requisição, registre a versão da tarefa, a versão da rubrica, o modelo e a configuração do juiz, a versão do renderizador e a versão do verificador automático. Uma mudança em qualquer um deles pode alterar o significado de uma nota.
Antes de trocar um juiz ou uma regra, eu faria a versão antiga e a nova pontuarem os mesmos trabalhos salvos, e veria onde as diferenças se concentram. Trabalhos históricos podem ser repontuados quando necessário, mas isso deve ser identificado como “uma nova pontuação do mesmo artefato”, e não disfarçado como se o modelo tivesse acabado de responder de novo.
Outra classe de problema é a avaliação que não terminou. Um timeout do serviço, um SVG corrompido, um programa de captura que travou ou uma requisição ao juiz que falhou não devem ser todos reduzidos a “o modelo desenhou errado”. Se o próprio trabalho viola as regras, ele pode ser reprovado pela regra predefinida. Se a infraestrutura de avaliação falhou, registre a avaliação como pendente e conclua-a por um procedimento fixo. Para um trabalho, uma condição necessária que falhou claramente basta para marcar o resultado inteiro como reprovado. Na direção oposta, se nada falhou claramente, mas uma condição necessária ainda não está clara, ele não pode simplesmente ser liberado.
Suponha que 100 requisições programadas incluam 72 aprovações confirmadas, 18 reprovações confirmadas e 10 ainda sem decisão. O relatório pode informar primeiro essas três contagens, em vez de apagar as amostras pendentes e anunciar “uma taxa de aprovação de 80%”. Se os rótulos já decididos forem tratados como corretos por ora, a proporção final de aprovados deste lote pode ficar entre 72% e 82%: o limite inferior conta todo item pendente como reprovação, e o superior conta cada um como aprovação. Esse intervalo vem dos rótulos pendentes. Não é um intervalo de confiança estatístico, e não inclui o erro do juiz nem a incerteza de generalizar para outras amostras.
A revisão humana também não pode olhar só as falhas e disputas que o juiz marcou. Uma amostra aleatória predefinida dos trabalhos aprovados automaticamente também deve ser verificada. Caso contrário, os erros mais perigosos que passaram despercebidos podem continuar escondidos na região de “aprovado”. Nenhuma avaliação automática pode provar que não erra dizendo que nunca se pegou errando. Ela precisa de um procedimento de auditoria capaz de encontrar ativamente os próprios erros.
7. As tarefas envelhecem, mas trocá-las todo dia não é mais científico
Quando uma questão viraliza, vêm em seguida exemplos, tutoriais, dicas de correção e otimizações voltadas especificamente para ela. Ver um modelo desenhar um bom pelicano não justifica, por si só, dizer que ele trapaceou. A exposição de uma questão pública, o aprendizado de um tipo de tarefa e a entrada de amostras de teste nos dados de treinamento são problemas de níveis diferentes. Saber se um modelo específico viu um material de teste específico exige evidência. “Essa questão é famosa demais” não é essa evidência.
A entrada de material de teste nos dados de treinamento continua sendo um risco que a avaliação precisa enfrentar. A prática do LiveBench inclui usar fontes de informação mais recentes, atualizar as questões continuamente e pontuar automaticamente com base em respostas verificáveis. É uma prática para reduzir o risco relacionado, não uma garantia de que “trocar as questões todo mês significa ausência absoluta de contaminação”. 8 Para uma questão de geração aberta como a do pelicano, eu prefiro manter três usos de tarefas. Questões centrais estáveis, para acompanhar mudanças de longo prazo. Questões de extensão em rodízio, para observar a transferência. Questões reservadas, ainda não públicas, para uma verificação depois que o procedimento for congelado, e não para ajustar as regras sem fim.
O valor de uma questão central é a comparabilidade, não a imunidade à contaminação do treinamento. O valor de uma questão de extensão é ampliar a cobertura, não ter um enunciado mais estranho.
O que vale mudar é a restrição, não só o nome do protagonista
Trocar o pelicano por um pato é uma mudança. Mas ela não muda automaticamente a estrutura de relações. Uma variante mais diagnóstica altera uma condição de propósito. Quando a direção é invertida, a conexão continua correta? Quando a oclusão aumenta, as peças-chave continuam completas? Quando a tarefa diz “fique ao lado da bicicleta e empurre-a”, o modelo ainda aplica uma pose de quem pedala? Depois que a mesma relação de contato entra em uma animação, ela falha?
A tarefa também pode passar para uma relação diferente: uma mão segurando a alça de uma xícara, um objeto apoiado em uma bandeja ou várias peças ligadas em uma ordem especificada. A ideia não é empilhar todo requisito raro em uma única imagem. É saber o que cada variante está testando. Substituir mecanicamente cem animais em um mesmo template pode, claro, produzir cem questões. Isso não autoriza chamá-las de cem evidências independentes de capacidade. A agregação deve preservar a categoria da tarefa e a família de templates, para que um template não domine a maior parte da nota total só porque tem muitas variantes.
Questões novas geradas automaticamente também precisam passar por aceitação. Uma questão pode ser vaga, contraditória ou impossível de verificar a partir da imagem final. Se a questão, a resposta e as regras do juiz forem todas propostas pelo mesmo modelo e depois confirmadas por esse mesmo modelo, uma verificação independente é ainda mais necessária.
Quando o banco de questões mudar, não desenhe uma mudança de dificuldade como progresso do modelo
Oitenta pontos este mês e noventa no próximo não significam necessariamente que o modelo ficou mais forte. As questões novas podem simplesmente ser mais fáceis. Quando um banco antigo é substituído por um novo, é melhor manter questões em comum e fazer um conjunto de sistemas de referência rodar os dois bancos em condições semelhantes. Informe a mudança de cada categoria de tarefa separadamente. Questões em comum e sistemas de referência não são uma verdade que permanece correta para sempre. Eles ajudam a identificar mudanças; não completam automaticamente uma equalização rigorosa de dificuldade. Quando a evidência é insuficiente, a prática honesta é mostrar os resultados por versão, em vez de emendar notas brutas de provas diferentes em uma única curva.
Uma questão pode ser publicada depois de aposentada, para que outras pessoas possam reverificar, aprender e melhorar. Depois de pública, seu papel pode passar de “uma verificação ainda não vista” para “um teste de regressão repetível”. Uma questão não se limita a um único uso, mas também não pode servir para sempre como o mesmo instrumento de medida. O objetivo de um banco de questões dinâmico não é perseguir a novidade para sempre. É administrar que conclusão uma questão pode sustentar em cada fase.
8. O que realmente vale automatizar é um processo que possa ser auditado depois
A essa altura, é fácil fazer o plano crescer cada vez mais: vários juízes, análise de trajetória, banco de questões dinâmico, arbitragem automática, e nenhum deles opcional. Uma versão mínima utilizável não precisa começar como uma fábrica totalmente automática. Escolha um pequeno conjunto de questões, escreva as condições de aceitação, colete saídas reais, monte uma referência humana e só então verifique quais itens podem ficar com as regras e quais podem ficar com um juiz visual. Mantenha o tratamento humano para a parte que ainda não é automatizada com confiabilidade.
Enquanto os dados são poucos, o objetivo é encontrar furos nas regras, não anunciar que “a precisão da pontuação atingiu certo nível”. Uma verificação formal da capacidade automatizada precisa de um conjunto separado de amostras reservadas e de um relato da incerteza. Um procedimento razoável é:
Congelar a tarefa e as regras de aceitação → gerar conforme o cronograma → salvar a saída bruta completa
→ analisar e renderizar sob controle → verificações estáticas / pontuação visual item por item
→ revisar disputas conforme as regras e auditar por amostragem os itens aprovados automaticamente
→ consolidar os resultados da primeira entrega, o desempenho por item e o status pendente
Cada etapa deve ser rastreável até a anterior. A resposta bruta, o SVG extraído, a renderização real, o registro de observação da animação, o retorno bruto do juiz e a conclusão da revisão ficam ligados por um mesmo identificador de execução. Quando um arquivo for extraído ou normalizado, salve a versão de antes e a de depois. Se um trecho de SVG precisou ser corrigido para renderizar, registre isso como resultado de um procedimento de correção. Não sobrescreva silenciosamente a primeira resposta. Quando as regras de pontuação forem atualizadas, acrescente um novo registro de avaliação, em vez de apagar o antigo.
Há uma premissa de engenharia que não pode ser pulada: trate a saída do modelo como conteúdo não confiável. Os modos de processamento do SVG podem envolver scripts, eventos e recursos externos. “A extensão diz que é uma imagem” não significa que seja seguro executar o arquivo em um navegador no qual alguém está logado para o uso do dia a dia. 3
O ambiente de renderização deve isolar credenciais de conta, a rede e os arquivos do host, limitar o uso de recursos e usar uma configuração de sandbox adequada a conteúdo não confiável. Usar o Playwright não resolve o problema só porque o navegador foi “colocado no Docker”. A documentação dele alerta explicitamente sobre os limites da imagem de contêiner padrão e sobre a relação entre rodar como root e o sandbox do Chromium. 9 As medidas de segurança concretas ainda precisam ser verificadas no ambiente em que rodam. O que a tarefa permite e o que o ambiente de execução permite devem ser combinados com antecedência. Não deixe o modelo usar um script para depois, na hora de pontuar, desativar todos os scripts sem avisar.
O que realmente precisa ser economizado não é a “verificação cuidadosa” em si. É o trabalho repetitivo de achar o arquivo de novo, comparar os parâmetros e preencher o carimbo de data e hora a cada verificação.
9. Um ranking que vale a pena ler deve permitir que se continue a interrogá-lo
Quando vejo uma nota, quero poder continuar investigando a que serviço de modelo ela pertence, a qual banco de questões e a qual janela de tempo; quantas amostras havia e se as falhas e os casos pendentes foram mantidos; quem pontuou, como foi feita a calibração e se é possível encontrar a base de um julgamento. Essas informações dizem mais sobre se uma avaliação levou a sério os próprios limites do que uma nota total que parece muito precisa.
Quem não pretende montar o procedimento pode começar pelo ranking público, pelos relatórios e pelas notas de avaliação do Folkbench e verificar se o modelo e o serviço que lhe interessam já têm um resultado publicado aplicável. A página inicial pública descreve a comparação como serviços diferentes de um mesmo modelo. A cobertura, o status dos recursos e a base de uma conclusão devem seguir as informações públicas no momento. 10
O mesmo vale para o Folkbench e para outros rankings. A informação que falta continua desconhecida. A apresentação de uma plataforma não substitui o relatório real. A proposta de avaliação deste artigo não é a mesma coisa que uma capacidade que alguma plataforma já tenha. Uma boa avaliação não pede ao leitor que “confie nesta minha nota”. Ela permite que o leitor siga a nota até o trabalho, as condições, as regras e as divergências. Voltemos aos três pelicanos.
Não precisamos discutir se o primeiro é o mais bonito, nem aprovar toda a animação do terceiro porque um frame ficou bonito. Uma vez combinado o que se mede e registradas com clareza as evidências, muito do que se chama de mistério vira uma questão que pode ser discutida item por item. O primeiro artigo dizia que uma captura de tela pode levantar uma boa pergunta, mas que respondê-la exige um experimento decente. O que este quer acrescentar é: um experimento decente também precisa de uma régua que tenha sido verificada.
Apêndice A. Uma tarefa restrita e uma tabela de aceitação para começar
A questão estática abaixo é um exemplo criado para este artigo. Não é um padrão do setor nem uma questão oficial de nenhuma plataforma. Deve ser testada e calibrada com anotação antes do uso. Depois que uma comparação formal começar, não mude a questão por causa dos resultados.
Prompt de exemplo
Produza apenas o conteúdo de um único arquivo SVG estático e autocontido, que possa ser aberto sozinho.
Use viewBox "0 0 800 600". Não acrescente delimitadores de código Markdown nem explicações.

Desenhe um pelicano em estilo cartoon andando em uma bicicleta comum de duas rodas.
Use uma vista principalmente lateral. Um leve deslocamento das peças é permitido para que a relação de pedalar fique clara.

O desenho precisa cumprir todos os itens a seguir:
1. O pelicano e a bicicleta estão inteiramente dentro da imagem, sem pernas extras.
2. As rodas dianteira e traseira, o quadro, o selim, o guidão, o pedivela e os dois pedais são reconhecíveis.
   O quadro se conecta de forma coerente aos dois eixos das rodas, e os pedais se relacionam de forma coerente com o pedivela.
3. O corpo está sentado no selim. Cada pé toca o seu próprio pedal,
   e os dois contatos precisam estar claramente visíveis. Pelo menos uma asa toca o guidão.
4. Use apenas gráficos vetoriais SVG e estilos inline. Não use bitmaps incorporados, recursos externos,
   scripts, foreignObject nem animação.

Realismo, fundo complexo, textura de penas e efeitos decorativos não são exigidos.
Tabela de aceitação de exemplo
| ID | Verificação | Tipo |
|---|---|---|
| F1 | Atende ao formato de arquivo independente, à área de visualização e aos limites de recursos combinados | Condição necessária |
| P1 | A figura é reconhecível como pelicano, a imagem está completa e não há perna extra evidente | Condição necessária |
| B1 | Duas rodas, quadro, selim, guidão, pedivela e dois pedais são reconhecíveis | Condição necessária |
| B2 | O quadro se conecta de forma coerente aos dois eixos, e os pedais se relacionam de forma coerente com o pedivela | Condição necessária |
| R1 | O corpo e o selim formam um apoio claro de quem está sentado | Condição necessária |
| R2 | Cada pé toca o seu próprio pedal, e os contatos atendem ao requisito de visibilidade | Condição necessária |
| R3 | Pelo menos uma asa toca o guidão | Condição necessária |
| A | Esta é uma questão estática. A animação não foi testada | Não se aplica |
| Q1 | Cor, traço e detalhes | Item de exibição opcional. Não anula uma condição necessária reprovada |
“Reconhecível”, “coerente” e “claro” ainda precisam de pares de exemplos positivos e negativos e de uma nota sobre a fronteira. A tabela é um esqueleto das regras; algumas frases não eliminam, por si sós, o julgamento. O resultado é aprovado somente quando todas as condições necessárias passam. Uma falha clara em uma condição necessária torna o resultado reprovado. Se nada falhou claramente, mas uma condição necessária está pendente, ele vai para revisão. O R3 é verificado porque este prompt de exemplo o exige explicitamente. Ele não deve ser aplicado, sem aviso, a toda questão de pelicano.
Apêndice B. Exemplo de um registro de saída do juiz
O JSON abaixo é um registro fictício de um único item. Ele mostra como os campos se relacionam e não corresponde a uma imagem real. Não é um relatório completo nem uma configuração que alguma biblioteca possa executar diretamente.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "O pé mais próximo do observador tem uma folga claramente visível em relação ao pedal correspondente."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id deve permitir localizar o modelo específico do juiz, o prompt, os parâmetros e o registro de versão. render_profile_id deve permitir localizar o navegador, a área de visualização e outras configurações relacionadas. A evidência de animação deve registrar o momento real. Não deve dizer apenas “em algum ponto no meio há um frame”. review_required é definido pelo sistema de avaliação conforme uma regra estabelecida; o juiz não decide isso sozinho. Mesmo quando o campo é false, a amostra ainda pode entrar em uma auditoria aleatória. Uma falha da pontuação automática, material visual insuficiente e uma tarefa reprovada devem ser registrados separadamente. Não devem compartilhar um mesmo status vago de “falha”.
Notas e fontes
- Yushi Hu et al., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. O trabalho transforma requisitos textuais em verificações por perguntas e respostas para avaliar a consistência entre imagem e texto. Este artigo aproveita a ideia de decomposição. Não transfere os resultados experimentais do trabalho original para tarefas de SVG ou de animação com pelicanos. Artigo↩
- W3C, Scalable Vector Graphics (SVG) 2, capítulos sobre estrutura do documento e caminhos (paths). Veja agrupamento, reutilização por meio de
usee expressões de caminho. A ideia de que um nó do DOM não corresponde naturalmente a um objeto semântico do mundo real é um juízo de desenho da avaliação feito aqui com base nisso. Estrutura do documento; Caminhos↩ - W3C, SVG 2 — Conformance Criteria, seções sobre modos de processamento e conformidade de documentos. A especificação distingue capacidades como execução de scripts, recursos externos e animação declarativa, e distingue formas de documento. O suporte dos navegadores e os limites de execução ainda precisam ser verificados no ambiente real. Especificação↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, trechos sobre transformações de coordenadas e caixas delimitadoras. As sugestões feitas aqui sobre distância de contato, limiares e reconhecimento semântico são exemplos de desenho de avaliação. Não são um algoritmo de “pedalar corretamente” definido pela especificação SVG. Especificação↩
- Lianmin Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Este artigo o usa apenas pelo que diz sobre a capacidade e o viés de juízes em avaliações de texto específicas. Não infere que todo juiz visual tenha a mesma magnitude de viés ou a mesma taxa de acerto. Artigo↩
- Pooyan Rahmanzadehgervi et al., Vision language models are blind, 2024. Este artigo se refere ao estudo original de 2024 e cita especificamente o arXiv v1, para não misturar revisões posteriores dos modelos, do título e dos resultados. Esse estudo não pode servir como ranking atual dos modelos de 2026. Versão do artigo↩
- Documentação do Playwright sobre a opção
animationsdepage.screenshot, consultada em 5 de outubro de 2026. A documentação descreve como essa opção trata animações CSS, transições CSS e Web Animations. Ela não deve ser estendida, sem verificação, a um controle de tempo único para todos os mecanismos de animação do SVG. Documentação↩ - Colin White et al., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. Um título anterior usava “Contamination-Free”. Este artigo segue a redação da revisão de 2025 sobre atualizações contínuas, pontuação verificável e redução do risco de contaminação. Não promete que a contaminação esteja absolutamente ausente. Artigo↩
- Documentação do Playwright sobre Docker, consultada em 5 de outubro de 2026. A documentação alerta que a imagem padrão não é recomendada para acessar sites não confiáveis e explica que rodar como root por padrão desativa o sandbox do Chromium. Este artigo não oferece uma implantação segura completa. Isolamento, rede e política de permissões ainda precisam ser implementados e testados no ambiente em que rodam. Documentação↩
- Página inicial pública do Folkbench, consultada em 5 de outubro de 2026. A página inicial oferece acesso ao ranking, aos relatórios e às notas relacionadas, e descreve a comparação como serviços diferentes de um mesmo modelo. Sua entrada de verificação também está marcada como um fluxo de preparação Beta e como uma sondagem real que ainda não foi ativada; a entrada atual serve para mostrar o fluxo de preparação. Este artigo apenas aponta para as informações públicas. Não trata uma entrada de demonstração como uma medição concluída, não endossa de forma independente um ranking específico e não afirma que o Folkbench implementou a pontuação em quatro dimensões, a calibração do juiz ou o banco de questões dinâmico propostos aqui. Início↩


