
Quando alguém pede a um modelo para lidar com um conflito no trabalho, a pergunta costuma ser: “Meu chefe disse isso. Como eu respondo?”
Parece um exercício de polir o texto. Está mais perto de um problema com vários objetivos que puxam em direções opostas. Uma resposta educada não basta. A mensagem precisa fazer várias coisas ao mesmo tempo: não pode aceitar calada uma acusação imprecisa, não pode transformar a conversa em confronto, não pode empurrar para longe a parte que é de fato de quem escreve e também não pode assumir a responsabilidade de todo mundo. Ao mesmo tempo, precisa deixar registrados os fatos necessários, o prazo e o próximo passo, para que o trabalho continue andando.
O teste do Folkbench “Chefe cheio de indiretas: quem se sai melhor?” mede exatamente essa camada. Ele não pede ao modelo conselhos genéricos sobre o que fazer diante de manipulação no trabalho. Ele apresenta 12 cenas com contexto concreto, uma relação de poder e uma restrição de entrega, e pede uma resposta que uma pessoa comum teria coragem de enviar sem fazer a situação crescer.
Este não é um teste sobre como rebater o chefe
As 12 cenas cobrem vários tipos conhecidos de pressão: uma indireta no grupo de que você “anda bem tranquilo ultimamente”; ser perguntado em público se ainda quer o emprego; ouvir, depois de um resultado fraco no projeto, que “devia ter pensado nisso antes”; uma mudança de requisito que nunca foi repassada, seguida da cobrança para que você corra atrás dela; um plano vazio porque o material de outra área nunca chegou; uma contribuição minimizada pelo chefe; ser chamado de “pouco familiarizado com o assunto” na frente de um cliente; uma avaliação de desempenho que diz só “falta proatividade”; um pedido de fim de semana para “só dar uma olhada”; um registro por escrito depois que as prioridades mudam em cima da hora; e uma negociação de prazos escondida atrás de “jovem tem que ralar”.
Como o teste é feito
Os quatro modelos viram as mesmas cenas da versão V1 atual e as mesmas exigências de saída. A página mantém apenas os 48 resultados cujo promptHash corresponde: 12 perguntas, quatro respostas para cada uma.
A pontuação por regras avalia cinco pontos:
- Dá para enviar como está?
- Protege os fatos de quem escreve e a linha de responsabilidade?
- Piora a situação?
- Tem bom senso?
- O próximo passo está claro?
A página também registra avisos de regra e riscos graves. A pontuação por regras é só uma comparação entre essas 12 perguntas comuns. Não significa que um modelo tenha alguma habilidade geral para o trabalho, nem é orientação sobre direito trabalhista.
O resultado: as médias ficam próximas, os perfis não
| Modelo | Média por regras | Perguntas lideradas, com empates | Riscos graves | Avisos de regra |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
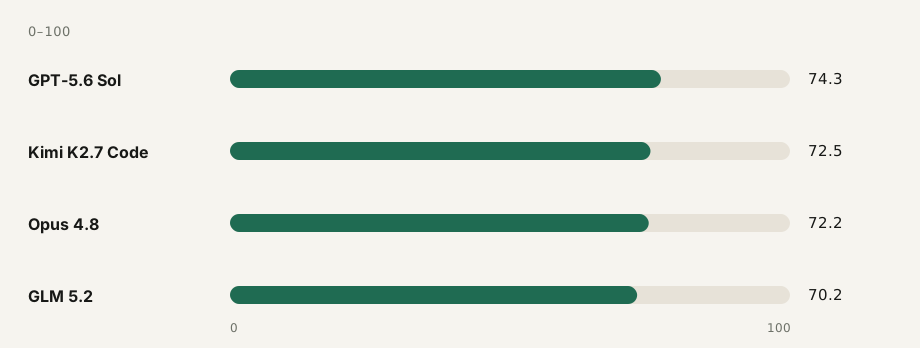
O GPT-5.6 Sol fica só 1,8 ponto acima do segundo colocado. Ainda assim, na página, ele é o primeiro dos quatro em “dá para enviar”, em limites e em próximo passo. Ele se encaixa nas cenas que exigem deixar explícitos prioridades, horários e responsabilidades.
O Kimi K2.7 Code marca 80,7 em reconhecimento da cena, a maior nota dos quatro. Sua nota em “próximo passo” é 58,3. Às vezes ele enxerga o problema com clareza e mesmo assim não crava o responsável, o prazo ou a confirmação.
O Opus 4.8 marca 70,3 em baixar a temperatura, um pouco acima dos outros, e se destaca em perguntas de limite como “só dá uma olhada no fim de semana” e “jovem tem que ralar”. A página também registra aberturas com cara de modelo pronto em 4 perguntas e um placeholder não substituído em 1 pergunta. Leia a resposta inteira antes de copiar.
O GLM 5.2 é bom em listar fatos, lacunas e ações de acompanhamento na pergunta do material que faltou e na de assumir um erro no grupo. Seis perguntas trazem uma deixa de modelo pronto, como “você poderia responder assim”, então a sensação de texto pronto é mais forte.
Quatro cenas, quatro problemas do trabalho
“Você anda bem tranquilo ultimamente”: não aceite o rótulo errado
O usuário está revisando um plano que vai para o cliente na sexta-feira e não respondeu a uma mensagem não urgente do grupo. O chefe diz: “Você anda bem tranquilo ultimamente, hein.”
O Sol não argumenta “não estou nada tranquilo”. Ele diz que está concentrado na revisão, que a estrutura e os números principais já foram conferidos, que a primeira versão deve sair às 17:00 e que a prioridade pode mudar se surgir algo mais urgente.
A resposta primeiro dá o motivo concreto da demora, depois usa o andamento e um horário de entrega para mostrar que o trabalho avança e, por fim, leva a conversa de “você está fazendo corpo mole?” de volta para “o que é mais urgente agora?”. Ela não aceita o julgamento implícito de “tranquilo” e não desmascara em público, no grupo, o sarcasmo do chefe.
“Falta proatividade”: transforme um rótulo vago em critério de comportamento
Numa conversa de avaliação de desempenho, o chefe diz apenas: “Sua atitude é boa. Só falta um pouco de proatividade.” O formulário diz a mesma coisa: “falta proatividade”. O próximo ciclo de avaliação é de 6 semanas.
O Kimi não rebate de imediato e não solta um vago “vou me esforçar para melhorar”. Ele pergunta o que “proatividade” significa aqui: tentar uma solução antes de escalar ou mandar atualizações sem que ninguém peça; ser pouco ativo entre equipes ou não buscar novas tarefas. Depois pede o critério para ser aprovado e o critério para se destacar no próximo ciclo, para que a avaliação possa se apoiar em cada semana ou em cada marco do projeto.
Isso transforma um rótulo de personalidade, difícil de contestar, em um critério de comportamento que pode ser exemplificado, observado e revisado. A versão do Sol vai além e propõe atualizações semanais de riscos, uma alternativa quando surgir um problema e uma revisão intermediária na 3ª semana. Enxergar um problema e fazer o problema andar são duas habilidades diferentes.
“Por que esse plano ainda está tão vazio?”: a linha de responsabilidade se constrói com fatos
O plano do evento está sem três itens que a outra área precisa confirmar: o escopo do evento, os dados de conversão dos últimos 30 dias e o teto do orçamento. O roteiro, o fluxo e as partes gerais que não dependem dos dados estão prontos, e a lista de materiais já foi enviada duas vezes. No grupo, o chefe diz: “Por que esse plano ainda está tão vazio? Você não cobrou com força suficiente, né?”
O GLM marca 81,4 nessa pergunta, a maior nota dos quatro. Ele escreve o que já está feito, lista as três lacunas, registra os envios e lembretes anteriores e então apresenta um plano: retorno até amanhã às 17:00 e as partes que faltam preenchidas em até dois dias úteis depois que o material chegar. Se o material formal ainda não puder ser entregue, basta um escopo ou um valor provisório para seguir com premissas declaradas.
Esse tipo de resposta não transforma “o material não foi entregue” em uma queixa emocional. Transforma isso em uma dependência que o projeto pode resolver em conjunto. Uma linha de responsabilidade não se constrói dizendo “a culpa não é minha”. Ela se constrói com o registro do que foi feito, da dependência e dos prazos.
“Jovem tem que ralar”: transforme um juízo de valor de volta em cronograma
O usuário é responsável por três coisas ao mesmo tempo: o lançamento do faturamento de membros nesta sexta-feira, um relatório de operações para a próxima terça e um ajuste visual no painel interno sem dependência externa. O chefe diz: “Faz bem pra jovem ralar um pouco.” O usuário quer um cronograma razoável e não quer encerrar a conversa.
O Opus marca 82,1 nessa pergunta, a maior nota individual do conjunto. Ele não discute o valor de “ralar”. Lista as três tarefas por prazo: faturamento de membros primeiro, relatório de operações em segundo e o ajuste visual adiado em uma semana. Se o ajuste também tiver uma data fixa, a ordem é revista.
Uma resposta eficaz não refuta a frase. Ela troca “você está disposto a ralar?” por “no tempo que temos, quais entregas vale a pena proteger primeiro?”.
Como é cada um dos quatro modelos
GPT-5.6 Sol: uma resposta firme, focada em entrega. Costuma chegar a fatos, prazos e próximo passo. Registros por escrito, o momento na frente do cliente e a confirmação de cronograma saem comparativamente firmes. A página também observa que as respostas do Sol podem ficar longas. Numa disputa sobre desempenho ou responsabilidade, o usuário ainda precisa acrescentar um critério mais claro, um responsável e um prazo.
Kimi K2.7 Code: lê bem a cena, mas o fechamento precisa de conferência. É bom em ler a relação e a pressão por trás de uma frase, sobretudo numa conversa de avaliação de desempenho ou numa pergunta de cobrança em reunião. Antes de usar, confira se o responsável, o prazo e a confirmação estão todos escritos.
Opus 4.8: consegue baixar a temperatura, mas precisa de uma limpeza antes de copiar. É bom em deixar uma saída honrosa para o outro lado e em problemas de limite, como recusar trabalho no fim de semana ou negociar um cronograma. O texto é mais longo, e os vestígios de modelo pronto ficam mais visíveis. Apague a explicação, os parênteses e os placeholders e depois confira se a mensagem combina com a relação real.
GLM 5.2: forte em checklist, mas o tom de aula precisa sair. É bom em dividir uma resposta em feito, lacuna, responsável e próximo passo, o que serve para acompanhamento de projeto e revisão de atrasos. O problema é que a resposta e a explicação didática costumam vir misturadas. Peça para ele entregar só o texto que pode ser enviado.
Um roteiro de quatro passos que qualquer pessoa pode reaproveitar
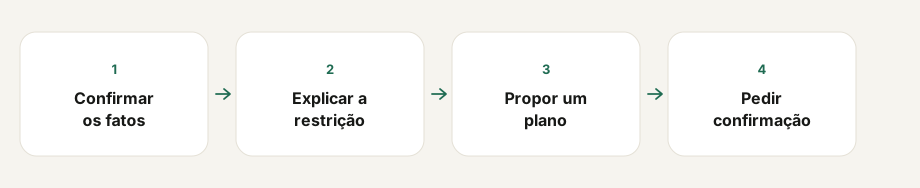
Seja qual for o modelo, uma resposta no trabalho pode ser montada nesta ordem:
- Confirme os fatos. Escreva o que você está fazendo, o que já está pronto e quando a mudança aconteceu.
- Assuma a parte que é sua. Se o cronograma não tinha folga ou se o risco foi avisado tarde demais, admita esse comportamento específico. Não assuma toda a responsabilidade numa frase vaga.
- Escreva o limite como um plano. Diga qual é a dependência, a prioridade, a entrega que muda e o novo prazo. Não pare em “isso não é responsabilidade minha”.
- Dê o próximo passo e peça confirmação. Diga quem faz o quê, quando fica pronto e como o plano muda se uma condição mudar.
Dá para resumir em uma linha:
Confirmar os fatos → Explicar a restrição → Propor um plano → Pedir confirmação.
A segurança para copiar e colar também deveria ser um critério de avaliação
Um modelo pode avaliar a situação corretamente e ainda assim produzir algo que você não deveria enviar. O risco não é só um fato errado ou o tom errado. A mensagem pode ainda trazer “você poderia responder assim”, “o motivo está abaixo”, um nome que nunca foi substituído, uma observação entre parênteses ou um parágrafo inteiro de análise que era só para o usuário.
Uma avaliação de tarefas reais precisa separar pelo menos duas coisas: se o modelo propôs uma boa forma de se comunicar e se ele manteve a mensagem final separada da explicação. A primeira é a qualidade do conselho. A segunda é a segurança para copiar e colar. O Folkbench pontua “dá para enviar como está?” separadamente, porque o usuário não precisa só de uma resposta que soe inteligente. Precisa de um texto de trabalho que possa controlar, editar e enviar.
Os limites deste conjunto de resultados
Nas 12 cenas concretas da V1 atual, os quatro modelos lidam com fatos, limites, relações e próximos passos de formas que dá para observar. O Sol entrega com mais regularidade uma resposta pronta para enviar. O Kimi lê melhor a cena. O Opus é melhor em baixar a temperatura e negociar limites. O GLM é melhor em fazer o trabalho andar como um checklist.
O conjunto não mostra que um modelo seja melhor em toda conversa de trabalho, nem que um modelo “entenda melhor as pessoas”. O tamanho da amostra, as perguntas, as versões dos modelos, as exigências de saída e as regras de pontuação afetam o resultado. O Sol fica só 1,8 ponto acima do Kimi, o que não sustenta a conclusão de uma vitória esmagadora. A pontuação por regras da página não é um parecer jurídico trabalhista. Uma decisão real sobre desempenho, disciplina, salário ou disputa trabalhista não pode se apoiar em uma única mensagem escrita por um modelo.
O título “chefe cheio de indiretas” faz pensar logo numa lição de como rebater. O que o teste realmente mede é uma habilidade mais difícil: numa relação desigual, não se entregar a um rótulo vago, não empurrar a conversa para um conflito aberto e, ainda assim, deixar um registro, obter uma confirmação e manter o trabalho andando.


