
Когда люди просят модель помочь с конфликтом на работе, вопрос часто звучит так: «Начальник написал вот это. Как мне ответить?»
Это похоже на задачу по шлифовке текста, но на деле ближе к задаче с несколькими целями, которые тянут в разные стороны. Одной вежливости мало. Ответ должен одновременно решить несколько задач, которые мешают друг другу: не принять молча неточное обвинение, не превратить разговор в противостояние, не отмахнуться от той части, за которую автор действительно отвечает, и не взвалить на себя чужую ответственность. При этом в нём должны остаться нужные факты, сроки и следующий шаг, чтобы работа шла дальше.
Тест Folkbench «Начальник язвит: кто справится?» измеряет именно этот уровень. Он не просит модель дать общий совет о том, что делать с манипуляциями на работе. Вместо этого он предлагает 12 ситуаций с конкретным контекстом, расстановкой сил и ограничениями по срокам сдачи и просит написать ответ, который обычный человек действительно решится отправить и который не раздует ситуацию.
Это не тест на то, как отбрить начальника
12 ситуаций охватывают несколько знакомых видов давления: намёк в рабочем чате, что вы «что-то в последнее время совсем расслабились»; вопрос при всех, хотите ли вы вообще здесь работать; упрёк после слабого результата проекта, что вы «должны были подумать об этом раньше»; изменение требований, о котором вам никто не сообщил, а потом от вас же требуют самим всё выяснять; план с пробелами, потому что смежная сторона так и не прислала материалы; вклад, который начальник небрежно обесценил; слова при клиенте, что вы «не очень в теме»; оценку эффективности, где написано только «не хватает инициативы»; просьбу в выходные «просто глянуть»; письменную фиксацию после того, как приоритеты поменяли в последний момент; и переговоры о сроках, которые стоят за фразой «молодым полезно хлебнуть трудностей».
Как проводится тест
Четыре модели получили одни и те же ситуации текущей версии V1 и одинаковые требования к ответу. На странице оставлены только 48 результатов с совпадающим promptHash: 12 вопросов, по четыре ответа на каждый.
Оценка по правилам учитывает пять аспектов:
- Можно ли отправить ответ как есть?
- Защищает ли он факты автора и границу ответственности?
- Не обостряет ли он ситуацию?
- Есть ли в нём чувство меры?
- Ясен ли следующий шаг?
На странице также фиксируются замечания правил и критические риски. Оценка по правилам — это только сравнение по этим 12 общим вопросам. Она не означает, что у модели есть некий общий навык делового общения, и не является юридической консультацией по трудовому праву.
Результат: средние баллы близки, а профили разные
| Модель | Средний балл по правилам | Первое место в вопросах (с ничьими) | Критические риски | Замечания правил |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
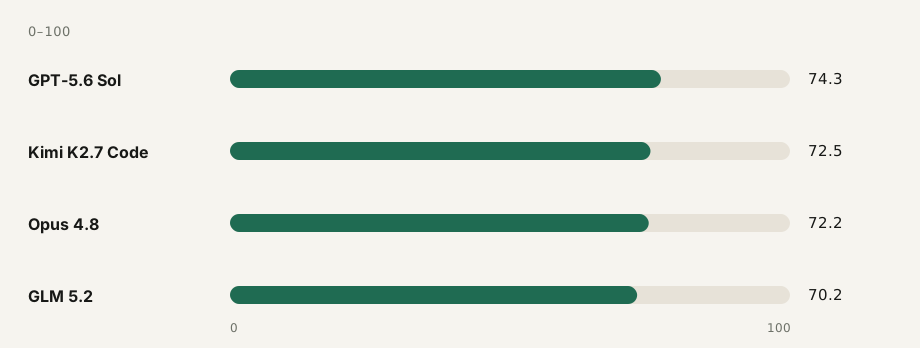
GPT-5.6 Sol опережает второе место всего на 1,8 балла. Но, по данным страницы, среди четырёх моделей она первая сразу по трём критериям: «можно отправить как есть», граница ответственности и следующий шаг. Она особенно хорошо подходит для ситуаций, где нужно чётко проговорить приоритеты, сроки и распределение ответственности.
У Kimi K2.7 Code оценка за распознавание ситуации — 80,7, самая высокая из четырёх. Но за «следующий шаг» у неё только 58,3: иногда она точно видит проблему, но так и не фиксирует ответственного, срок или действие для подтверждения.
Opus 4.8 получает 70,3 за снижение градуса — немного больше остальных — и выделяется в вопросах о границах, таких как «просто глянуть в выходные» и «молодым полезно хлебнуть трудностей». Однако на странице также отмечены шаблонные вступления в 4 вопросах и незаменённый плейсхолдер в 1 вопросе. Прежде чем копировать ответ, прочитайте его целиком.
GLM 5.2 хорошо перечисляет факты, пробелы и дальнейшие действия в вопросе о недостающих материалах и в ситуации, когда нужно признать ошибку в рабочем чате. Но в 6 вопросах у неё встречаются шаблонные подсказки вроде «можно ответить так», поэтому ощущение шаблонности сильнее.
Четыре ситуации — четыре рабочие проблемы
«Что-то вы в последнее время совсем расслабились»: не принимайте ложный ярлык
Пользователь дорабатывает план, который в пятницу уходит клиенту, и не ответил на несрочное сообщение в рабочем чате. Начальник пишет: «Что-то вы в последнее время совсем расслабились».
Sol не спорит в духе «я вовсе не прохлаждаюсь». В ответе сказано, что автор сосредоточен на доработке плана, структура и ключевые цифры уже сверены, первая версия ожидается к 17:00, а приоритет можно сдвинуть, если появится что-то более срочное.
Ответ сначала называет конкретную причину, по которой реакция задержалась, затем ходом работы и сроком сдачи показывает, что дело движется, и наконец переводит разговор с «вы что, бездельничаете?» на «что сейчас срочнее». Он не принимает подразумеваемую оценку «расслабились» и не разоблачает публично сарказм начальника в рабочем чате.
«Не хватает инициативы»: превратить расплывчатый ярлык в поведенческий стандарт
На беседе об оценке эффективности начальник говорит только: «К отношению вопросов нет, просто инициативы маловато». В форме оценки написано то же самое — «не хватает инициативы». Следующий цикл оценки длится 6 недель.
Kimi не возражает сразу и не отделывается расплывчатым «постараюсь исправиться». Она уточняет, что здесь значит «инициатива»: сначала самому искать решение или сообщать о ходе работы, не дожидаясь вопросов; недостаточная активность в работе с другими отделами или то, что вы не просите новых задач. Затем она спрашивает, какие критерии означают «соответствует» и «отлично» в следующем цикле, чтобы оценка опиралась на каждую неделю или каждую контрольную точку проекта.
Так черта характера, с которой трудно спорить, превращается в поведенческий стандарт, который можно проиллюстрировать примерами, отслеживать и разбирать. Версия Sol идёт дальше и предлагает еженедельно сообщать о рисках, при возникновении проблемы сразу предлагать альтернативу и провести промежуточный разбор на третьей неделе. Увидеть проблему и сдвинуть её с места — две разные способности.
«Почему план до сих пор такой пустой?»: граница ответственности строится на фактах
В плане мероприятия не хватает трёх вещей, которые должна подтвердить смежная сторона: охвата мероприятия, данных о конверсии за последние 30 дней и потолка бюджета. Структура, порядок проведения и общие разделы, не зависящие от данных, готовы, а список нужных материалов отправлялся дважды. Тем не менее начальник пишет в рабочем чате: «Почему план до сих пор такой пустой? Вы, кажется, недостаточно активно его двигаете?»
GLM получает за этот вопрос 81,4 — лучший результат среди четырёх моделей. Сначала она описывает, что уже сделано, затем перечисляет три пробела, упоминает прежние отправки и напоминания и в конце предлагает план: обратная связь до 17:00 завтра, а недостающее будет заполнено в течение двух рабочих дней после получения материалов. Если официальные материалы пока предоставить нельзя, достаточно примерного охвата или предварительных значений, чтобы двигаться дальше на оговорённых допущениях.
Такой ответ не превращает «материалы не дали» в эмоциональную жалобу, а делает из этого зависимость, с которой может разобраться вся команда проекта. Граница ответственности строится не фразой «это не моя вина», а записью о сделанном, зависимостями и сроками.
«Молодым полезно хлебнуть трудностей»: свести оценочное суждение к вопросу сроков
Пользователь отвечает сразу за три вещи: запуск биллинга подписок в эту пятницу, операционный отчёт к следующему вторнику и доработку стилей админ-панели без внешних зависимостей. Начальник говорит: «Молодым полезно хлебнуть трудностей». Пользователь хочет добиться разумных сроков, но не хочет обрывать разговор.
Opus получает за этот вопрос 82,1 — самый высокий результат за отдельный вопрос во всём наборе. Она не спорит о том, полезно ли «хлебнуть трудностей», а выстраивает три задачи по срокам: биллинг подписок — в первую очередь, операционный отчёт — во вторую, доработку стилей сдвинуть на неделю. Если и у доработки стилей есть жёсткий срок, порядок пересматривается.
Действенный ответ не опровергает эту фразу, а заменяет вопрос «готовы ли вы терпеть» вопросом «какие результаты в отведённое время стоит обеспечить в первую очередь».
На что похожа каждая из четырёх моделей
GPT-5.6 Sol: надёжный ответ, нацеленный на результат. Обычно она опирается на факты, сроки и следующий шаг; письменная фиксация, ситуации при клиенте и согласование сроков получаются у неё сравнительно стабильно. На странице также отмечено, что ответы Sol бывают длинноватыми. В спорах об оценке эффективности или ответственности пользователю всё равно нужно добавить более чёткий критерий, ответственного и срок.
Kimi K2.7 Code: читает ситуацию, но проверяйте, доведён ли ответ до конкретики. Она хорошо считывает отношения и давление за одной фразой, особенно на беседе об оценке эффективности или при уточняющих вопросах на совещании. Перед использованием проверьте, что ответственный, срок и действие для подтверждения прописаны.
Opus 4.8: умеет снизить градус, но перед копированием ответ нужно почистить. Она хорошо оставляет собеседнику возможность сохранить лицо и справляется с вопросами границ, такими как отказ от работы в выходные или согласование сроков. Формулировки у неё длиннее, следы шаблона заметнее. Удалите пояснения, скобки и плейсхолдеры, а затем убедитесь, что сообщение соответствует реальным отношениям.
GLM 5.2: сильна в чек-листах, но лекторский тон нужно убрать. Она хорошо раскладывает ответ на «сделано — пробел — ответственный — следующий шаг», что подходит для ведения проекта и разбора задержек. Проблема в том, что сам ответ и учебные пояснения часто перемешаны. Попросите её выводить только тот текст, который можно отправить.
Схема из четырёх шагов, которую может повторить каждый
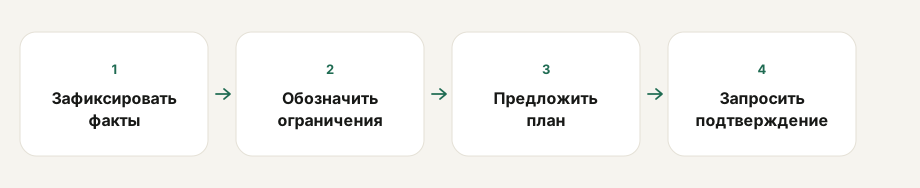
Какую бы модель вы ни использовали, рабочий ответ можно выстроить в таком порядке:
- Зафиксируйте факты. Напишите, чем вы заняты, что уже сделано и когда произошли изменения.
- Признайте то, что зависело от вас. Если в графике не было запаса или о риске сообщили слишком поздно, признайте именно это. Не берите на себя всю ответственность одной расплывчатой фразой.
- Оформите границу как план. Назовите зависимость, приоритет, сдвигаемый результат и новый срок. Не ограничивайтесь фразой «это не моя ответственность».
- Предложите следующий шаг и запросите подтверждение. Укажите, кто что делает, когда это будет готово и как изменится план, если изменятся условия.
Всё это укладывается в одну строку:
Зафиксируйте факты → обозначьте ограничения → предложите план → запросите подтверждение.
«Безопасность копирования» тоже должна стать метрикой оценки
Модель может правильно оценить ситуацию и всё равно выдать то, что нельзя отправлять. Риск — не только в ошибочном факте или неподходящем тоне. В сообщении могут остаться «можно ответить так», «причины — ниже», так и не заменённое имя, пояснение в скобках или целый абзац анализа, предназначенный только для пользователя.
Поэтому тестирование на реальных задачах должно различать как минимум две вещи: предложила ли модель разумную стратегию общения и отделила ли она итоговое сообщение от пояснений. Первое — качество совета, второе — безопасность копирования. Folkbench оценивает «можно ли отправить как есть» отдельно, потому что пользователю нужен не просто ответ, который звучит умно, а рабочий текст, который можно контролировать, править и отправить.
Границы этих результатов
На 12 конкретных ситуациях текущей версии V1 видно, что четыре модели по-разному обращаются с фактами, границами, отношениями и следующими шагами: Sol стабильнее выдаёт ответ, готовый к отправке, Kimi лучше считывает ситуацию, Opus лучше снижает градус и договаривается о границах, GLM лучше продвигает работу через чек-листы.
Эти результаты не доказывают, что какая-то модель лучше во всех рабочих разговорах, и не доказывают, что какая-то модель «лучше понимает людей». На результат влияют размер выборки, формулировки вопросов, версии моделей, требования к ответу и правила оценки. Sol опережает Kimi всего на 1,8 балла, и это не даёт оснований говорить о безоговорочном превосходстве. Оценка по правилам на странице — не заключение по трудовому праву. Реальные решения об оценке эффективности, дисциплине, оплате или трудовых спорах нельзя принимать на основании одного сообщения, написанного моделью.
Заголовок «Начальник язвит» легко принять за урок того, как отбрить собеседника. Но на самом деле тест измеряет более трудную способность: в неравных отношениях не отдавать себя во власть расплывчатого ярлыка, не доводить разговор до открытого конфликта и при этом оставить письменный след, получить подтверждение и продолжать двигать работу.


