Одна неудача доказывает, что модель ошиблась. Сама по себе она не доказывает, что теперь модель ошибается чаще, чем раньше.
«Неужели модель опять отупела?» Пеликан, у которого одна лапа свисает мимо педали, велосипед с рамой, закрученной узлом, а рядом скриншот, который на прошлой неделе выглядел вполне прилично, — этого достаточно, чтобы возник такой вопрос.
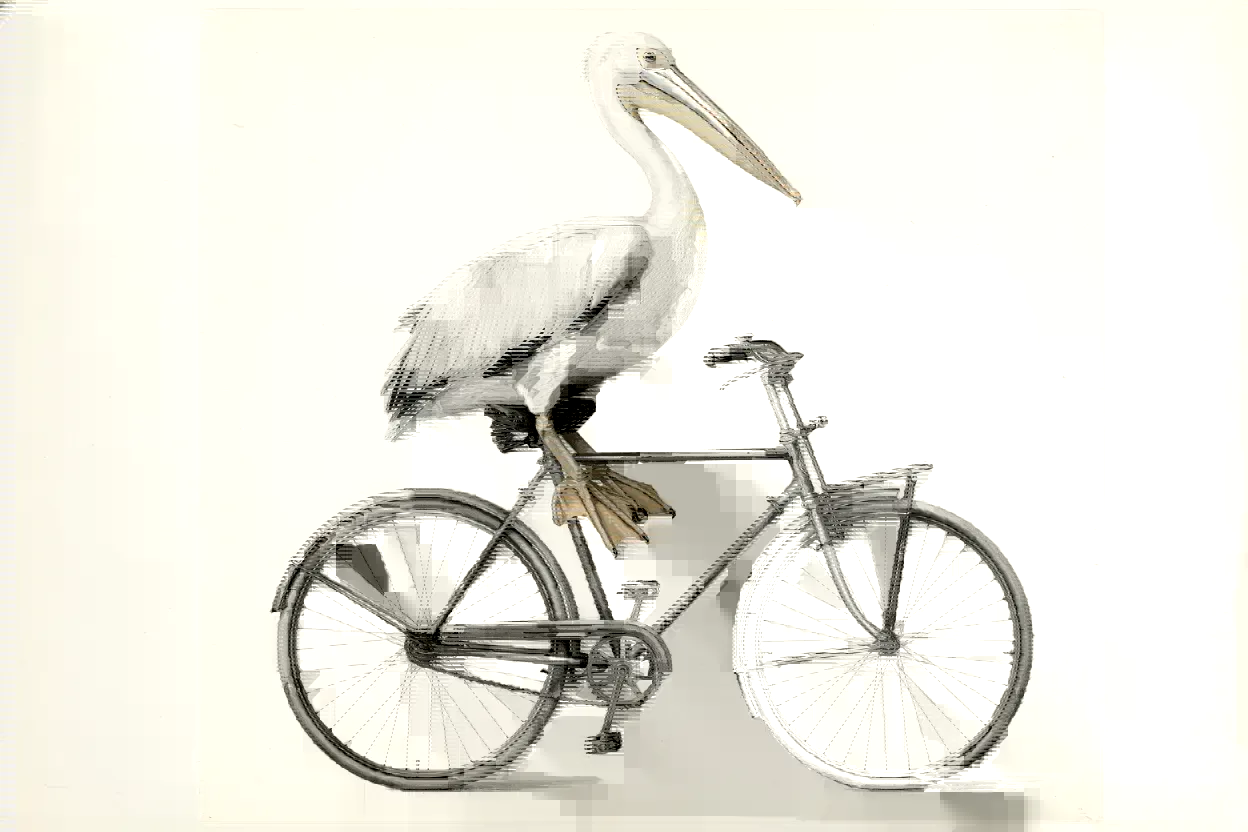
От такого подозрения нельзя отмахнуться фразой «модели случайны». Человек заплатил за задачу, с которой сервис раньше справлялся, а теперь не справляется. Об этом стоит спросить. Но двух скриншотов недостаточно, чтобы показать, что модель подменили, что бюджет на рассуждения урезали или что конкретный сервис «разбавили».
Некоторое время назад я прогнал тест с пеликаном несколько десятков раз. Полезен он тем, что многие ошибки в нём нарисованы так, что их видно. Работающий код ещё не означает, что велосипед устроен правильно. Если на картинке есть и птица, и велосипед, это ещё не значит, что лапа действительно стоит на педали. Такие пространственные отношения проще заметить глазом, чем гладкий ответ, в котором всё равно может прятаться логическая дыра. Чем больше прогонов я сохранял, тем яснее становилось другое: мы часто судим о сервисе целиком по одной-единственной работе.
Эта статья не оправдывает ни одну модель и не учит распознавать «поддельную модель» по паре внешних признаков. Меня интересует более узкий вопрос. Когда мы подозреваем, что модель стала хуже, как превратить это ощущение в доказательства, которые сможет перепроверить кто-то другой?
Примечание: сервисы A и B ниже и все связанные с ними результаты тестов — учебные примеры. Они не относятся ни к какому реальному сервису и не являются измерениями или рейтингом Folkbench.
1. Сначала разделите вопрос: что вы имеете в виду под «отупела»?
«Отупела» — удобное слово, но оно сворачивает несколько разных вопросов в один. Самый прямой уровень: вот этот конкретный ответ неверен. У пеликана выросла лишняя нога, лапа промахнулась мимо педали или колёса отделились от рамы. Каждая такая ошибка — конкретная неудача, которую можно проверить. Одного образца достаточно, чтобы доказать, что «такая ошибка случилась», и достаточно, чтобы опровергнуть обещание, что «модель никогда так не ошибётся». Второй уровень: в тех же или достаточно близких условиях этот сервис ошибается чаще.
Это уже не вопрос о том, существует ли ошибка. Это вопрос о том, как часто она появляется. Больше всего в «стало хуже работать» стоит измерять переход от «обычно получалось» к «обычно не получается». Третий уровень: изменение вызвано изменением самой модели или конфигурации на стороне сервера. Это уже утверждение о причине. У одного и того же плохого результата могут быть разные объяснения: другие параметры запроса, другой контекст, обрезанный вывод или реальное изменение базовой модели и настроек инференса. Только по результату обычно нельзя выделить какое-то одно из этих объяснений.
Поэтому «этот ответ неверен», «этот сервис менее надёжен» и «этот сервис втихую подменил модель» требуют доказательств разной силы. Замечать эту разницу — не значит поднимать планку для жалоб пользователей. Наоборот. Чётко названный вопрос не даёт провайдеру объяснять каждый сбой «случайностью», а тому, кто проводит тестирование, — объяснять каждое различие тем, что «модель подменили».
2. Вы смотрите на одну работу или на распределение ответов?
При настройках генерации со случайной выборкой один и тот же вход может давать разные выходы. Даже если вы используете какой-то механизм, повышающий воспроизводимость, «настолько одинаково, насколько получится» не следует понимать как «каждый раз одинаково». В одной старой технической заметке OpenAI это сказано прямо: при том же seed, тех же параметрах и том же отпечатке бэкенда идентичный вывод всё равно не гарантирован. Это граница воспроизводимости. Это не значит, что все современные модели принимают одни и те же параметры.1
В тесте с пеликаном нас обычно интересует не «может ли модель иногда нарисовать одну хорошую картинку?», а «если в заданных мной условиях дать ей задачу ещё раз, насколько вероятен годный результат?». Упрощённый пример показывает, в чём проблема одного скриншота. Допустим, истинная доля годных результатов у сервиса с одной попытки — 80%, каждая генерация независима, а состояние сервиса во время теста не меняется. Вероятность хотя бы одной неудачи за 20 попыток подряд равна: 1 − 0.8²⁰ ≈ 98.85% Сервис, который обычно хорошо справляется с задачей, почти наверняка оставит где-то в этих 20 попытках неудачу, которую можно заскриншотить.
Теперь наоборот. Допустим, у другого сервиса истинная доля годных результатов с одной попытки всего 40%. При тех же допущениях о независимости и стабильности вероятность хотя бы одного годного результата за 20 попыток равна: 1 − 0.6²⁰ ≈ 99.996% Он тоже почти наверняка выдаст одну работу, которую можно показать. Эти два расчёта не утверждают, что все реальные вызовы независимы, и не утверждают, что реальные доли годных результатов равны именно этим числам. Они указывают на проблему отбора: если показывать только лучшую попытку, надёжность легко переоценить, а если только худшую — легко преувеличить ухудшение.
Поэтому один и тот же сервис может оказаться и в посте, где одна картинка служит доказательством, что модель работает в полную силу, и в посте, где одна картинка доказывает, что она отупела. Оба скриншота могут быть настоящими. Вывод — не обязательно. Есть и ещё одно различие, которое легко пропустить. Успех с первой генерации и успех, выбранный из десяти генераций, — это не одна и та же способность. Второй вариант включает дополнительные вызовы, ожидание и затраты на отбор. Если вы сравниваете два рабочих процесса, дайте обоим одинаковый бюджет попыток. Не сравнивайте первую попытку A с отобранной лучшей работой B.
3. Делают ли 20 прогонов разницу статистически значимой автоматически?
Нет. Двадцать прогонов могут быть разумным бюджетом эксперимента. Статистическим пропуском они не являются. Возьмём тот же конкретный пример. Канал A прогнали 20 раз, годный результат получен 16 раз. Канал B прогнали 20 раз, годный результат получен 8 раз. В обоих случаях используются одна фиксированная задача и одно и то же правило оценки, и сохранён каждый образец.
| Канал | Годных / всего | Доля в выборке | 95% интервал Уилсона для доли |
|---|---|---|---|
| A | 16 / 20 | 80% | 58,4–91,9% |
| B | 8 / 20 | 40% | 21,9–61,3% |
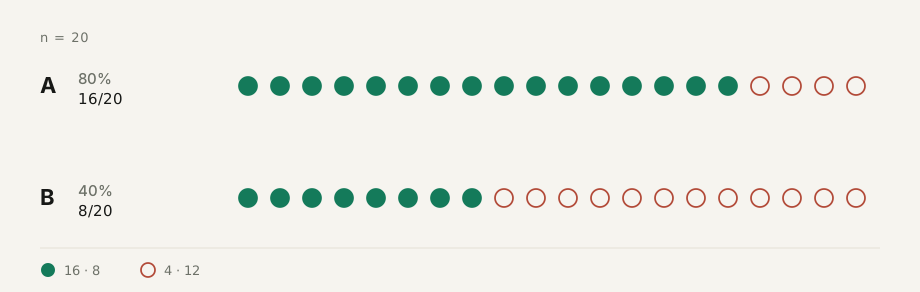
Интервалы — двусторонние 95% интервалы Уилсона для биномиальной доли. Они выражают неопределённость оценки доли годных результатов. Это не диапазон оценок качества картинки.2 Разница в выборке — 40 процентных пунктов. При всего 20 попытках с каждой стороны оценка остаётся грубой. 80% и 40% не следует считать истинной способностью, которая измерена точно и никогда не изменится.
Если дополнительно предположить, что вызовы независимы, что вероятность годного результата у каждого канала стабильна внутри окна и что это сравнение было выбрано заранее, двусторонний точный тест Фишера по числам «годный / негодный» даёт p ≈ 0.0225. При уровне значимости 5%, выбранном заранее, этот пример подтверждает, что «в этих условиях доли годных результатов различаются».3 Это число не означает «с вероятностью 97,75% B разбавили» и не означает «с вероятностью 97,75% A навсегда лучше». p-значение — это вероятность получить столь же экстремальные или ещё более экстремальные данные при гипотезе об отсутствии различий и в условиях теста. Это не вероятность скрытой причины.3
Не заменяйте проверку разницы взглядом на то, пересекаются ли два интервала. Каждый интервал оценивает одну долю. Тест же касается разницы между ними. Три границы важнее, чем заученный наизусть тест. Смотрите на величину разрыва и размер выборки вместе. 16 против 8 не должно давать вывод той же силы, что 16 против 15. Сколько нужно образцов, зависит от того, насколько малый разрыв вы хотите обнаружить и какой риск ошибочного вывода готовы принять. Универсального правила «прогоните минимум столько-то раз» для всех задач нет.
Если значимая разница не найдена, это не доказывает, что сервисы одинаковы. Данных может быть просто слишком мало, или они слишком нестабильны, чтобы делать вывод. Чтобы показать, что разница настолько мала, что ею можно пренебречь, заранее определите, что значит «достаточно мала». Незначимый результат — не доказательство эквивалентности. Статистическая разница сама по себе не повод менять сервис. Пользователю всё равно нужно взвесить цену неудачи, стоимость вызова, задержку и затраты на повторную работу. Разница может быть реальной и всё же слишком малой, чтобы изменить выбор. Задача статистики здесь не в том, чтобы выдать солидно выглядящее p-значение. Она в том, чтобы не дать нам утверждать больше, чем выдерживают доказательства.
4. Базовая линия — это договор об эксперименте, а не фраза «промпт был тот же»
Многие сравнения проваливаются ещё до того, как дело доходит до размера выборки. Образцы с самого начала были несопоставимы. Обе стороны просят «нарисовать пеликана на велосипеде». Один вызов — это API-запрос в новой сессии. Другой — окно чата, где позади уже несколько десятков реплик и включены инструменты. Одна сторона может написать длинный ответ. Другая на полпути упирается в лимит длины. Повторите это сто раз — и результат всё равно нельзя будет приписать разнице в способностях модели.
Исследование стандарта оценки OLMES показывает, что такие решения при оценке, как формат промпта, примеры в контексте и формулировка задачи, меняют измеряемый результат. Воспроизводимое сравнение должно фиксировать эти настройки. Задачи в той работе — не SVG с пеликаном, но к предупреждению о конфигурации эксперимента стоит прислушаться.4 Я бы относился к базовой линии как к договору о том, «что именно измеряет этот раунд».
Объект сравнения должен быть конкретным: сервис, группа или маршрут и версия модели, которую вы реально можете получить. Если у вас есть только псевдоним модели, который со временем может меняться, запишите псевдоним. Если вы не знаете базовый снимок модели, напишите «неизвестно». Не считайте строку с названием модели, которую возвращает интерфейс, независимым подтверждением того, что стоит за ней на самом деле. Сохраняйте вход как можно полнее. Это не только финальный промпт. Сюда входят системный промпт, история, вложения и настройки инструментов, которые вы можете контролировать и наблюдать. Совпадение видимых условий не доказывает, что совпали и невидимые.
Для настроек генерации запишите уровень рассуждений, лимит вывода и параметры сэмплирования, которые интерфейс действительно поддерживает. Для поля, которого интерфейс не предлагает, пишите «не поддерживается», а для поля, применение которого вы не можете подтвердить, — «неизвестно». Не считайте такие поля втихую совпадающими. Не стоит предполагать, что настройка с названием «high» означает одинаковый вычислительный бюджет у двух разных моделей.
Среда оценки включает то, как вы рендерите и как оцениваете. Проверяйте один и тот же SVG в одном и том же окне просмотра и рендерере. Для задачи с анимацией используйте согласованное окно наблюдения. Не смотрите движение целиком у одной стороны, выбирая один-единственный кадр у другой. Если задача не требовала анимации, не снимайте баллы за то, что результат — статичная картинка. Наконец, запишите правило повторных попыток до начала теста. Можно ли повторить попытку после первой неудачи, сколько раз и допускается ли обратная связь — всё это часть условий теста. Это не то, что импровизируют, когда результаты уже получены.
Фиксировать всё это — не попытка построить оторванную от реального мира «лабораторную модель». Вы вполне можете сравнить, как работают два чат-продукта по умолчанию. Тогда вывод должен звучать как «эти два продукта различаются тем, что выдают при настройках по умолчанию», а не «я выделил, какие веса базовой модели лучше». Условие, которое вы не можете контролировать, может остаться неизвестным. Неизвестное условие нельзя записать как контролируемое.
5. Как вы организуете тест, часто важнее, чем просто прогнать его больше раз
Не привязывайте канал ко времени суток
Если прогнать весь A утром, а потом весь B поздно ночью, «разница между каналами» смешивается с «разницей во времени». Даже если разрыв виден, трудно сказать, в какой мере он зависит от этого окна. Для лёгкого сравнения бок о бок я бы чередовал A и B внутри заранее выбранного окна и рандомизировал порядок. Держите уровень параллельности запросов как можно более одинаковым. Не допускайте, чтобы одна сторона генерировала по одному запросу за раз, а другая принимала на себя всплеск.
Можно пойти на шаг дальше и разбить окно на небольшие серии, в каждой из которых есть и A, и B. Тогда, помимо общего результата, видно, не сосредоточена ли разница в одной серии. Случайный порядок помогает снизить смешение с фактором времени. Он не устраняет автоматически корреляцию из-за общего бэкенда, кратковременного сбоя и тому подобного.
Продольный вопрос «хуже ли, чем на прошлой неделе?» устроен иначе. Время здесь и есть изучаемая переменная, поэтому привязать обе стороны к одному моменту нельзя. По возможности сохраняйте ту же основную задачу, конфигурацию и правило оценки и в каждом окне наблюдения заново прогоняйте эталонный сервис. Не сравнивайте раз за разом сегодняшние результаты с единственной лучшей картинкой прошлой недели. Читая продольный результат, учитывайте и абсолютную долю годных, и относительный разрыв. Если просели и тестируемый сервис, и эталон, разрыв между ними может остаться прежним. Это не значит, что опыт пользователя не ухудшился. Эталон — не истина, навсегда правильная и навсегда стабильная.
Не решайте, когда остановиться, глядя на результаты
«Прогоню пять раз. Если A выиграет, опубликую. Если нет — продолжу, пока разница не станет значимой». Выглядит как добавление образцов. На деле это меняет статистическое правило. Если раз за разом подглядывать в тест с фиксированной выборкой и останавливаться из-за увиденного, ломается контроль ложноположительных результатов, ради которого этот тест создан. Тест, в котором нужно непрерывно следить за данными, должен использовать метод, разработанный для последовательного анализа.5 Большинству людей не нужно начинать с последовательной статистики. Проще всего до начала раунда записать, сколько прогонов вы сделаете, какую основную метрику используете и какие основные сравнения проведёте. А затем сохранить все результаты.
Сделать сначала несколько вызовов, чтобы убедиться, что интерфейс и процесс оценки работают, — нормально. Это пробные прогоны. Когда закончите менять процедуру, запустите формальный тест отдельно. Не смешивайте результаты настройки задачи с формальными результатами. То же касается двух других привычек. Попробовать несколько десятков задач и опубликовать только ту, что выглядит лучше всего, или, увидев отставание по общему баллу, объявить победу по одной подшкале — это не то сравнение, о котором вы договорились заранее.
Не считайте сто повторов одной задачи сотней задач
Повторная генерация показывает, насколько надёжен сервис на этой задаче. Она не расширяет вывод автоматически. Если пеликан стабильно получается, это само по себе не значит, что отладка кода, анализ длинных текстов и выполнение сложных инструкций так же надёжны. Когда вы делаете вывод о классе задач, разброс между задачами и разброс между повторами одной задачи — два разных вида неопределённости. Исследования по оценке моделей различают повторную выборку, сравнения на уровне задач и обработку кластеризованных, зависимых образцов.6
Поэтому я бы сначала с помощью одного контрольного вопроса смотрел на повторяемость, а затем добавил небольшой набор фиксированных задач, связанных с реальным применением. Обе стороны отвечают на один и тот же набор. Прежде чем агрегировать, посчитайте результат и разницу по каждой задаче. Не ограничивайтесь одним общим баллом. Если вы проводите формальный анализ на нескольких задачах, сохраняйте привязку к одной задаче и одной серии. Нельзя считать «10 задач по 10 раз» «100 независимыми задачами» и повторно использовать приведённый выше расчёт для одной задачи.
Есть ловушка поменьше. Фиксированный seed полезен, когда вы разбираетесь с проблемой воспроизведения. Но двадцать копий почти неизменного вывода с одним и тем же seed — это не двадцать независимых наблюдений случайного распределения выходов. Когда измеряете стабильность, заранее договоритесь о стратегии сэмплирования. Если интерфейс поддерживает seed, можно использовать несколько seed, сгенерированных заранее. Если не поддерживает, это ограничение нужно записать. Как набор задач должен обновляться в долгосрочной перспективе — отдельный вопрос. По крайней мере внутри одного сравнения не меняйте задачи, чтобы потом соединять старые и новые баллы в кривую «модель улучшается».
6. Тайм-ауты, обрывы и неверный рисунок нельзя валить в одну кучу
Распространённое статистическое искажение — оценивать только работы, которые успешно вернулись, и удалять тайм-ауты и ошибки. Полученный балл отвечает на вопрос «если полный ответ уже на руках, как часто он годный?». Он не отвечает на вопрос, который для пользователя важнее: «если я отправлю один запрос, получу ли я годный результат?». Допустим, заранее запланировано 20 запросов, и 4 из них завершились тайм-аутом. Остальные 16 вернули полную работу, и 8 из них годные. Доля годных среди полных ответов — 50%. Доля годных результатов с первой попытки, посчитанная по всем 20 запросам, — 40%. Если публиковать только первое число, выпадают те четыре раза, когда пользователь не получил ничего.
Я бы сохранял сразу три вида результатов: технический сбой доставки, полный ответ, который не решает задачу, и полный ответ, который её решает. У тайм-аутов, ошибок интерфейса, прерванных потоков и достижения лимита длины должна сохраняться каждая своя причина. Раздельная запись не оправдывает сбой сервиса. Для того, кто выбирает сервис, и тайм-аут, и неверный рисунок стоят времени. Но когда вы ищете причину, их не следует все описывать как «снизился интеллект модели». Сбой локальной сети или тестового скрипта нужно указать отдельно. Исключать ли его, решает правило, записанное заранее. Нельзя удалить образец после того, как вы увидели, какая сторона проиграла.
Основной метрикой я бы скорее сделал долю первых запросов, которые вернули годный результат, а рядом в качестве пояснений держал долю годных по содержанию среди полных ответов, долю технических сбоев, задержку и стоимость. Доля годных по содержанию среди полных ответов — тоже не несмещённая оценка «чистой способности». Если сложные запросы чаще завершаются тайм-аутом, оставшиеся работы могли с самого начала быть проще. Эта доля помогает локализовать проблему. Заменить результат, посчитанный по всем запросам, она не может.
«Получится ли после одного исправления?» может быть отдельным тестом, в котором у обеих сторон одинаковая возможность исправить ответ. Нельзя терпеливо проводить одну сторону через пять раундов исправлений, а другую списывать после первой же ошибки.
7. Минимальное сравнение, которое реально провести обычному человеку
Не нужно строить платформу для тестирования, прежде чем проверить одного пеликана. Вот план для начала. Он предназначен для проверки очевидной разницы на одном фиксированном контрольном вопросе. Это не расчёт размера выборки, гарантирующий, что вы обнаружите небольшое ухудшение.
| Пункт | Договорённость на этот раунд |
|---|---|
| Вопрос | Различаются ли сервисы A и B на этой фиксированной задаче по доле годных результатов с первой попытки? |
| Вход и настройки | Сохраните полный видимый запрос. Выровняйте параметры, которые можете контролировать. Запишите различия, которые не можете подтвердить. |
| Выборка | Заранее запланируйте по 20 формальных запросов с каждой стороны. Не включайте пробные прогоны в формальную выборку. |
| Время и порядок | Разбейте заранее объявленное окно на 4 серии, по 5 вызовов A и B в каждой. Чередуйте их в случайном порядке внутри серии при одинаковом правиле параллельности. |
| Повторные попытки | В формальном тесте первого ответа повторных попыток нет. Если хотите измерить исправление, откройте отдельный эксперимент. |
| Оценка | Зафиксируйте правило годности до первого прогона. После рендеринга скройте название канала, перемешайте порядок и только потом оценивайте. |
| Результат | Сохраните каждый исходный результат, статус каждого вызова, обоснование каждой оценки, а также статистику по сериям и общую статистику. |
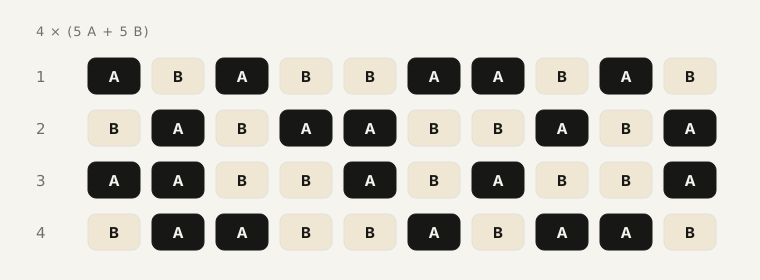
Для задачи с пеликаном хорошо начать с простого правила годности. Отображается ли файл в согласованной среде? Достаточно ли цельны фигура и велосипед, чтобы их узнать? Нет ли явной ошибки в ключевой конструкции? Действительно ли соблюдены контакты, которых требует задача, например лапа на педали? Красоту можно отметить отдельно. Аккуратно подобранные цвета не перекрывают структурную ошибку.
Если кто-то сомневается в пограничном образце, отметьте его как спорный и действуйте по правилу перепроверки, установленному заранее. Не решайте, засчитан ли он, после того как увидели название канала. Небольшой тест можно оценивать вручную, вслепую. Когда масштаб растёт, следующий вопрос — автоматическая оценка и калибровка судей. Решать всё это в первом раунде не обязательно. Записывать гораздо проще, если отделить конфигурацию, относящуюся к раунду, от журнала, где каждому вызову соответствует одна строка. Конфигурация раунда хранит исходный шаблон запроса, параметры, версию задачи, версию правила оценки, временное окно и договорённость о тайм-аутах и повторных попытках. Для каждого вызова стоит записывать как минимум эти поля:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathЗаписывайте время с часовым поясом. Связывайте исходный ответ, извлечённый SVG и отрендеренное изображение через artifact_path. Число токенов, отпечатки бэкенда и всё остальное, что раскрывает интерфейс, можно хранить рядом. Если что-то не предоставлено, записывайте пустое значение или «неизвестно». request_hash — проверка того, что запрос не изменился. Исходный запрос он не заменяет. Сохраняя журнал или делясь им, удаляйте API-ключи и скрывайте приватный контекст и другие чувствительные данные. Для публичной проверки нужны условия эксперимента, а не учётные данные аккаунта в придачу к ним.
Подводя итоги, сначала смотрите на общий разрыв и на результат каждой серии. Биномиальный интервал и точный тест Фишера, описанные выше, применимы, когда их допущения, включая независимость и стабильность, примерно выполняются. Если результат явно зависит от серии или если позже вы расширите тест до повторов на нескольких задачах, проводите анализ, соответствующий плану эксперимента. Не применяйте механически формулу для одной задачи. Если первая обнаруженная разница стоит дальнейшего изучения, перепроверьте её в новом заранее объявленном окне и добавьте задачи, связанные с вашим реальным применением. Первый раунд — зацепка за аномалию. Отдельный новый раунд помогает судить, сохраняется ли она.
8. Как сформулировать вывод, если разница найдена?
На тех же учебных числах сдержанный и при этом полезный вывод может звучать так:
При фиксированной задаче этого раунда, совпадающих видимых настройках и заранее объявленном временном окне A и B протестированы по 20 раз. Годных результатов с первой попытки — 16 и 8. Доли годных в выборке различаются на 40 процентных пунктов. При допущениях, включающих независимую выборку, двусторонний точный тест Фишера даёт p-значение около 0,0225, что подтверждает наличие разницы в условиях этого раунда. Результат ещё нужно проверить в других окнах и на связанных задачах. Сам по себе он не позволяет установить конкретную причину изменения базовой модели или конфигурации сервера.
Это менее эффектно, чем «доказательство полной мощности». Зато следующий человек получает условия, нужные, чтобы всё перепроверить. Если последующие тесты в разное время и на связанных задачах продолжают указывать в ту же сторону, у нас появляется более веское основание сказать, что для этих задач сервис менее надёжен, чем эталон, или что он действительно отстал от собственной исторической базовой линии. Перескочить от «результаты стали хуже» к «втихую подставили модель поменьше» — всё ещё лишний шаг. Чтобы подтвердить конкретный механизм, нужны независимые доказательства, позволяющие различить объяснения, например проверяемая запись о маршруте или конфигурации. Стиля вывода недостаточно, чтобы угадать модель.
Это также не значит, что пользователь должен дождаться выяснения причины, прежде чем ему позволят перейти на другой сервис. Выбор сервиса зависит от того, отвечает ли он вашим требованиям. Обвинение в конкретной причине зависит от доказательств этой причины. Одно можно держать отдельно от другого.
9. Экономить на самом деле стоит на цене ясного доказательства
Утомительная часть ручного теста — обычно не нажатие кнопки запуска. Это повторяющаяся работа потом. Где файл? Менялись ли параметры? Какая это по счёту генерация? Была ли это повторная попытка? Можно ли ещё сопоставить скриншот с исходным ответом? Без этих записей твёрдая уверенность в том, что «модель правда отупела», через неделю может свестись к нескольким скриншотам, которые никто не может перепроверить.
Если вы хотите лишь для начала посмотреть, как ведут себя разные сервисы, не всем нужно собирать всё это с нуля. Можно начать с Folkbench: посмотреть публичные рейтинги и вход в отчёты и проверить, есть ли уже результат для интересующих вас модели, группы сервиса и метрики. Публичные страницы делают акцент на сравнении сервисов в рамках одной модели, а в рейтингах также указано, что данные группы в одной строке не отражают все группы этого прокси.7
Опубликованный рейтинг должен снижать затраты на сбор и упорядочивание данных. Он не должен становиться поводом перестать проверять условия. Любой рейтинг, включая Folkbench, стоит расспросить подробнее: когда измеряли, что измеряли, насколько велика выборка, сохранены ли неудачи и на какую область распространяется вывод? Информация, которая не опубликована, остаётся неизвестной. Вернёмся к вопросу из начала. Сколько в «модель отупела» правды, а сколько иллюзии единичной выборки?
Пока нет общего определения, полной выборки и сопоставимых условий, публикация одного общего процента лишь порождает новый фольклор. Что мы можем делать лучше, так это брать каждое конкретное подозрение и шаг за шагом превращать его в суждение, которое можно проверить. Увидели неудачу — сохраните исходный результат. Подозреваете ухудшение — начните сравнение. Нашли разницу — тогда ищите причину. Не пытайтесь уложить все эти шаги в один скриншот. Скриншот может задать хороший вопрос. Чтобы ответить на него, всё равно нужен добротный эксперимент.
Примечания и источники
- OpenAI, How to make your completions outputs consistent with the new seed parameter, архивный пример из Cookbook. В заметке фиксированный seed описан как попытка по возможности добиться детерминизма, а не как гарантия. Эта статья ссылается только на эту границу воспроизводимости. Она не считает устаревшие названия моделей и описанную на той странице поддержку параметров описанием актуального продукта. Источник↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, раздел 7.2.4.1, Confidence intervals, интервал Уилсона для доли. В статье используются двусторонние 95% интервалы Уилсона для 16/20 и 8/20. Автор вычислил их по формуле и округлил до одного знака после запятой в процентах. Уровень доверия описывает долгосрочное покрытие метода построения интервала. Метод Уилсона является приближённым. Источник↩
- Документация SciPy,
scipy.stats.fisher_exact. В статье используется таблица сопряжённости[[16, 4], [8, 12]]сalternative="two-sided", результат —p = 0.0224774273717544. Это расчёт на данных примера, а не результат измерений из научной статьи или отчёта платформы. Пример сравнивает независимые биномиальные исходы. Для парных данных, кластеризации по задачам, зависимости от времени или множественных сравнений нужен анализ, соответствующий плану эксперимента. Источник↩ - Yuling Gu и др., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. В работе обсуждаются такие детали оценки, как формат промпта, выбор примеров в контексте и формулировка задачи, а также то, что требуется для воспроизводимого сравнения. Источник↩
- Ramesh Johari, Leo Pekelis и David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, редакция 2019 г. В работе обсуждается проблема непрерывного наблюдения за результатами, когда от увиденного зависит размер выборки, и методы последовательного вывода, которые её решают. Источник↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. О неопределённости на уровне задач, повторной выборке, парных сравнениях и кластеризованных выборках см. разделы 2, 3 и 4. О планировании размера выборки — раздел 5. Источник↩
- Публичная главная страница и страницы рейтингов Folkbench, проверено 5 октября 2026 г. Статья использует эти публичные страницы только для описания точки входа, области сравнения и предупреждения на уровне групп. Она не подтверждает независимо ни одно конкретное число в рейтинге и не утверждает, что Folkbench уже реализует все предложенные здесь экспериментальные процедуры. Главная; Рейтинги↩