
Модель может написать терпеливую и полную инструкцию по приготовлению цзяньбина — и новичок всё равно ничего по ней не приготовит.
На настоящей домашней кухне много переменных. Сковороды бывают разного размера и из разных материалов. Тесто может оказаться слишком густым или слишком жидким. Нагрев меняется, пока вы разливаете блин, добавляете яйцо и переворачиваете его. Тонкий хрустящий крекер баоцуй не всегда есть в продаже. Утром может быть всего 20 минут. После первой неудачи пользователю не нужен ещё один красивый рецепт. Ему нужен кто-то, кто поймёт, почему блин только что порвался, и скажет, можно ли ещё спасти то, что на сковороде.
Поэтому это тестирование на приготовление цзяньбина проверяет не то, может ли модель пересказать рецепт. Оно проверяет, может ли модель превратить знания в план, который на домашней кухне можно выполнить, скорректировать и продолжить, если что-то пошло не так.
Сначала результат: за средним баллом различия кроются в неудачах и рисках
В этом раунде было 12 сценариев домашней кухни. Четыре модели оставили 48 результатов с совпадающим promptHash. Оценка по правилам на странице рассматривает ответ с пяти сторон: можно ли следовать шагам, видно ли в них кухонное чутьё, справляется ли модель с неудачей, понятно ли написан ответ и не выставляет ли себя модель чересчур самоуверенным «бывалым поваром».
Общие баллы, опубликованные на странице:
| Модель | Общий балл | Первых мест из 12 (с учётом ничьих) | Замечания по правилам или критические риски, отмеченные на странице |
|---|---|---|---|
| Sonnet 5 | 80,4 | 6 | Нет |
| GLM 5.2 | 79,3 | 5 | 1 замечание по правилам |
| Kimi K2.7 Code | 77,6 | 3 | 1 замечание по правилам, 1 критический риск |
| GPT-5.6 Terra | 75,6 | 0 | Нет |
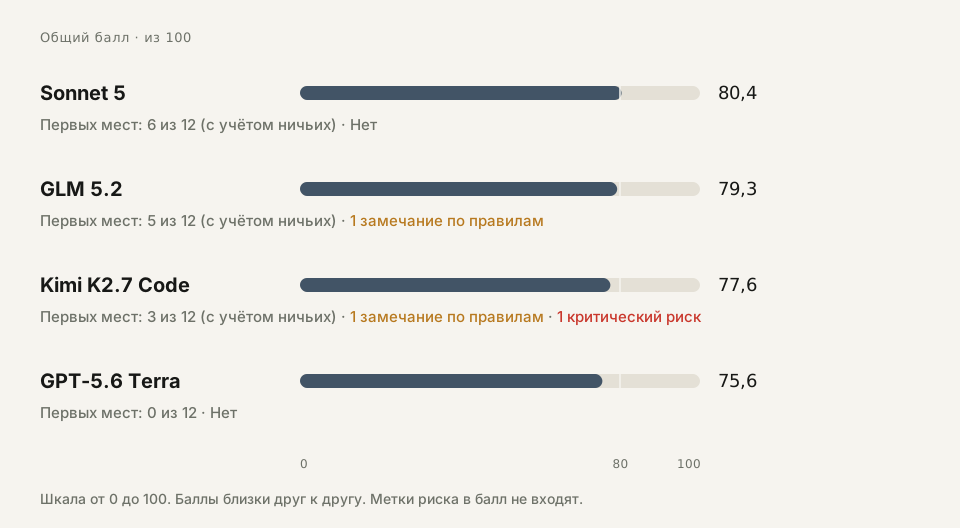
Sonnet 5 лидирует с 80,4 балла. В целом её ответы ближе всего к инструкции, которую можно дать новичку: первая попытка, управление сковородой и завтрак за 20 минут у неё сравнительно стабильны. GLM 5.2 отстаёт всего на 1,1 балла, но её балл за последовательность действий достигает 90 — это лучший результат в раунде. Общий балл Kimi K2.7 Code ниже, зато она лучше всех справляется со сценариями, где нужно исправлять ситуацию на ходу, например «блин порвался, как его спасти». GPT-5.6 Terra получает 84,2 балла за первую полную инструкцию, но заметно проседает на пропорциях теста, нагреве электросковороды и диагностике неудач.
Внешне это табель успеваемости четырёх моделей. Но больше внимания заслуживает факт, который легко упустить: выполнимость — это не одна способность. Модель может хорошо расписывать шаги и плохо диагностировать неудачу. Она может отлично спасать ситуацию и при этом оставить проблему на границе безопасности, которую нельзя игнорировать.
1. Домашняя кухня — не витрина рецептов
Если спросить только «как приготовить цзяньбин», модель охотно выдаст то, что выглядит как полный стандартный ответ: подготовить муку, замешать тесто, разогреть сковороду, разлить блин, разбить яйцо, посыпать зелёным луком, смазать соусом, положить хрустящий крекер и свернуть.
На уровне слов в таком ответе может не быть явных ошибок. Но он не отвечает на вопросы, с которыми новичок сталкивается на самом деле:
- Дома есть только антипригарная сковорода диаметром 26 см, а разравнивателя для теста нет. Хватит ли половника и лопатки?
- Насколько жидким на самом деле должно быть тесто? Почему при одном и том же соотношении воды и муки у одного блин выходит толстым, а у другого рвётся при первом же перевороте?
- Если хрустящего крекера нет, как на результат повлияют листы для вонтонов, ютяо, картофельные чипсы и обычные тонкие лепёшки?
- Как определить нагрев обычной сковороды и электросковороды? Когда после яйца можно сворачивать?
- Блин уже порвался, а яйцо ещё не схватилось. Продолжать разравнивать, залатать дыру ещё одной ложкой теста или начать заново?
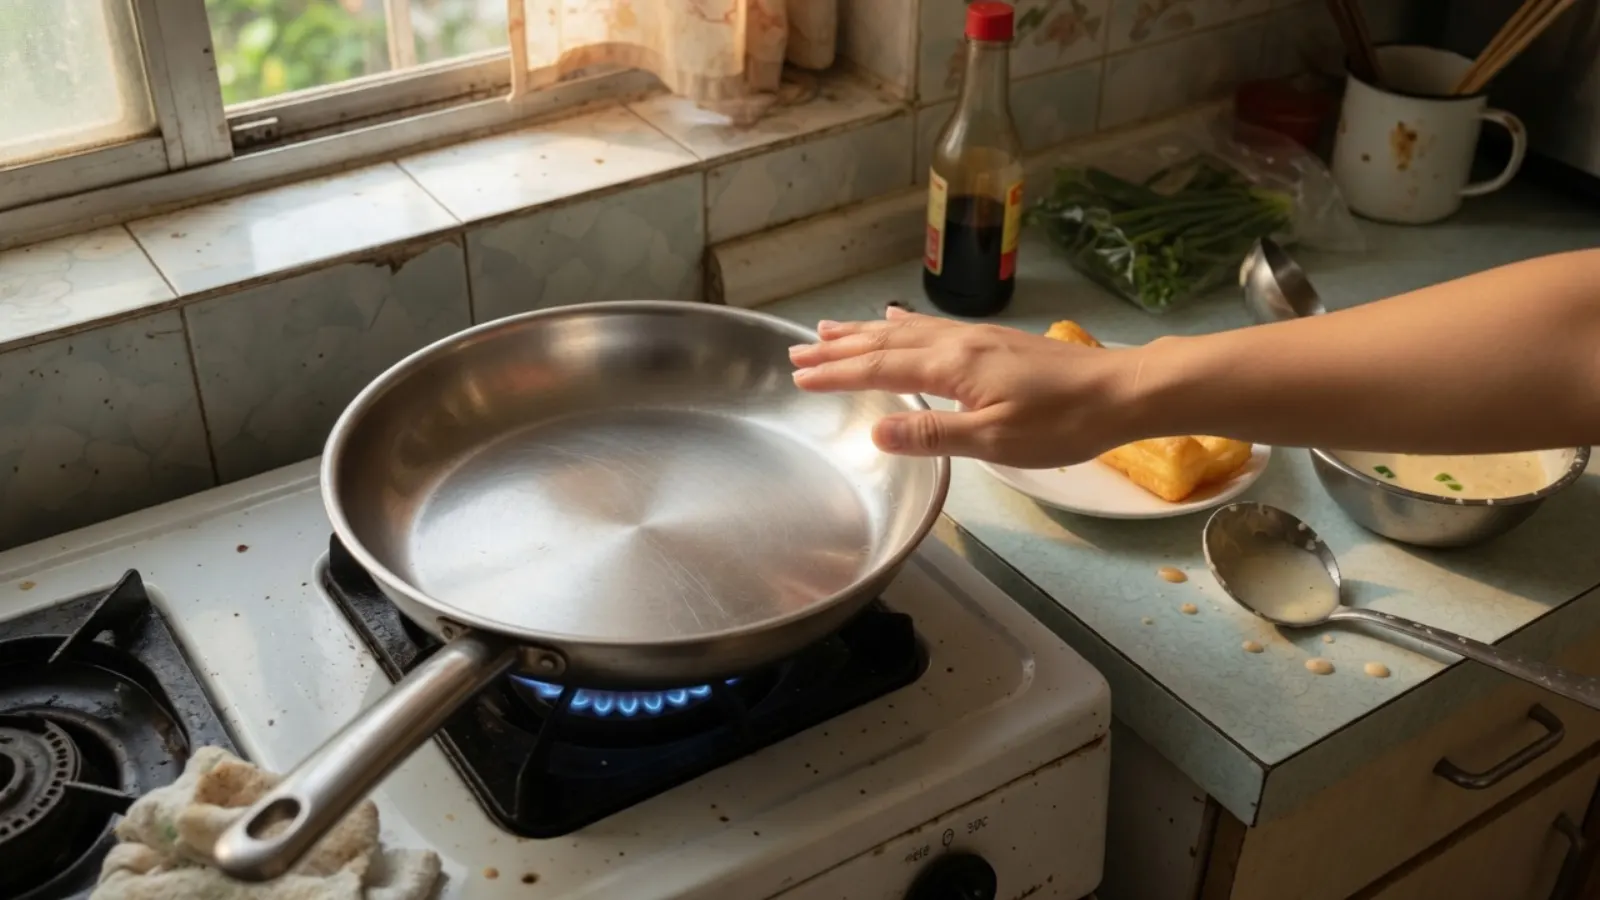
- Если есть только сковорода из нержавеющей стали, как снизить риск того, что блин прилипнет?
- Можно ли на следующий день есть оставшееся тесто и готовый блин, уже смазанный соусом и с ветчиной внутри?
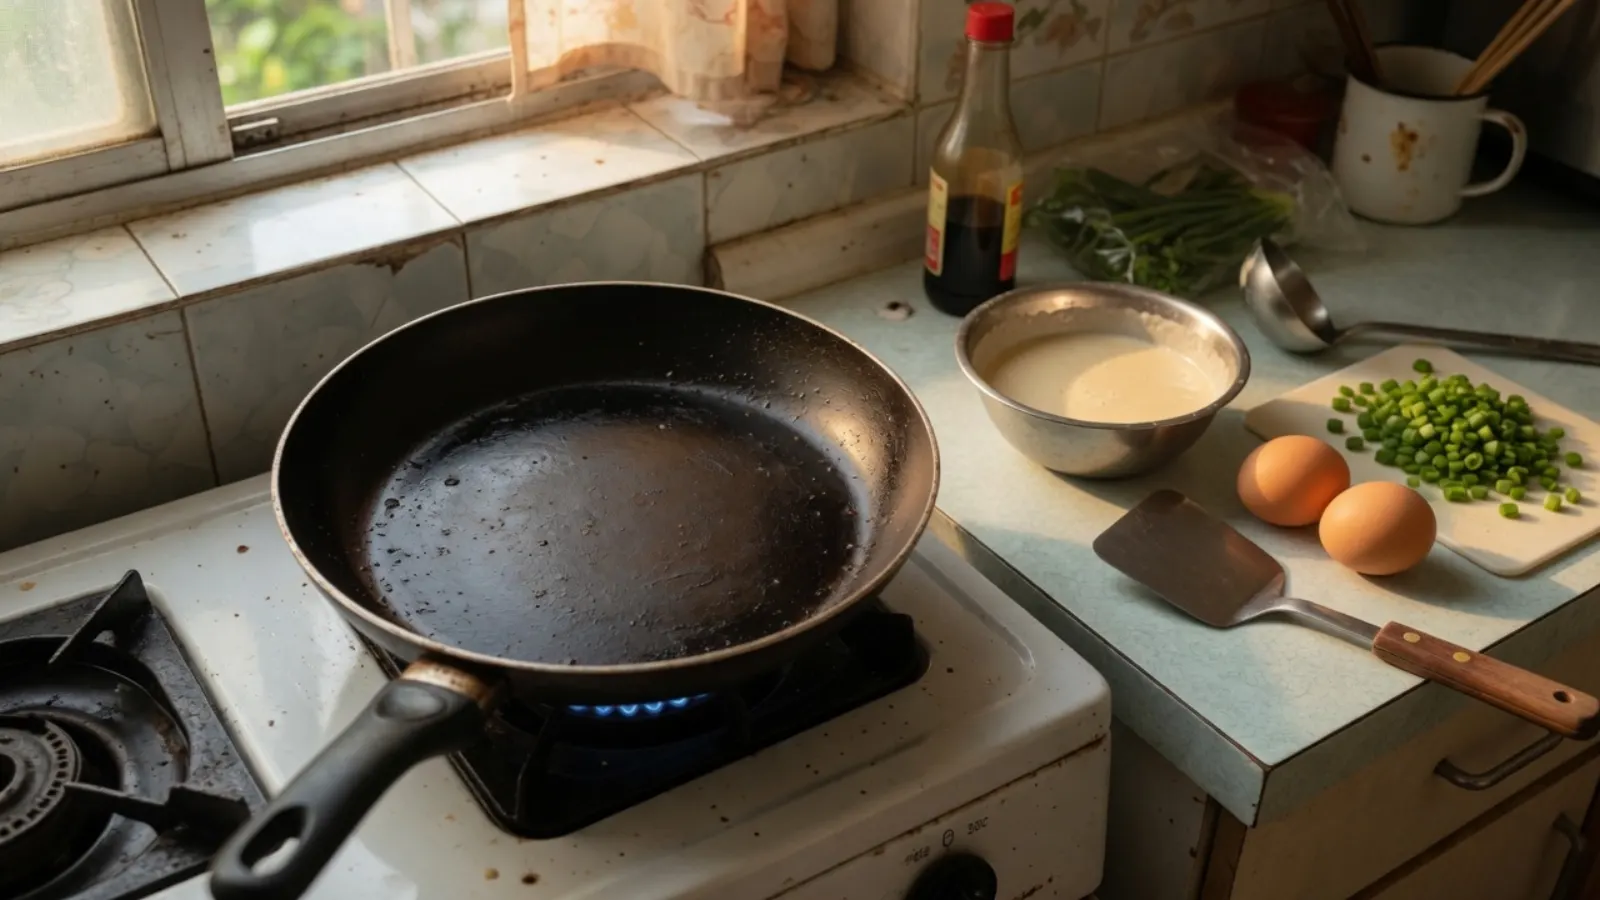
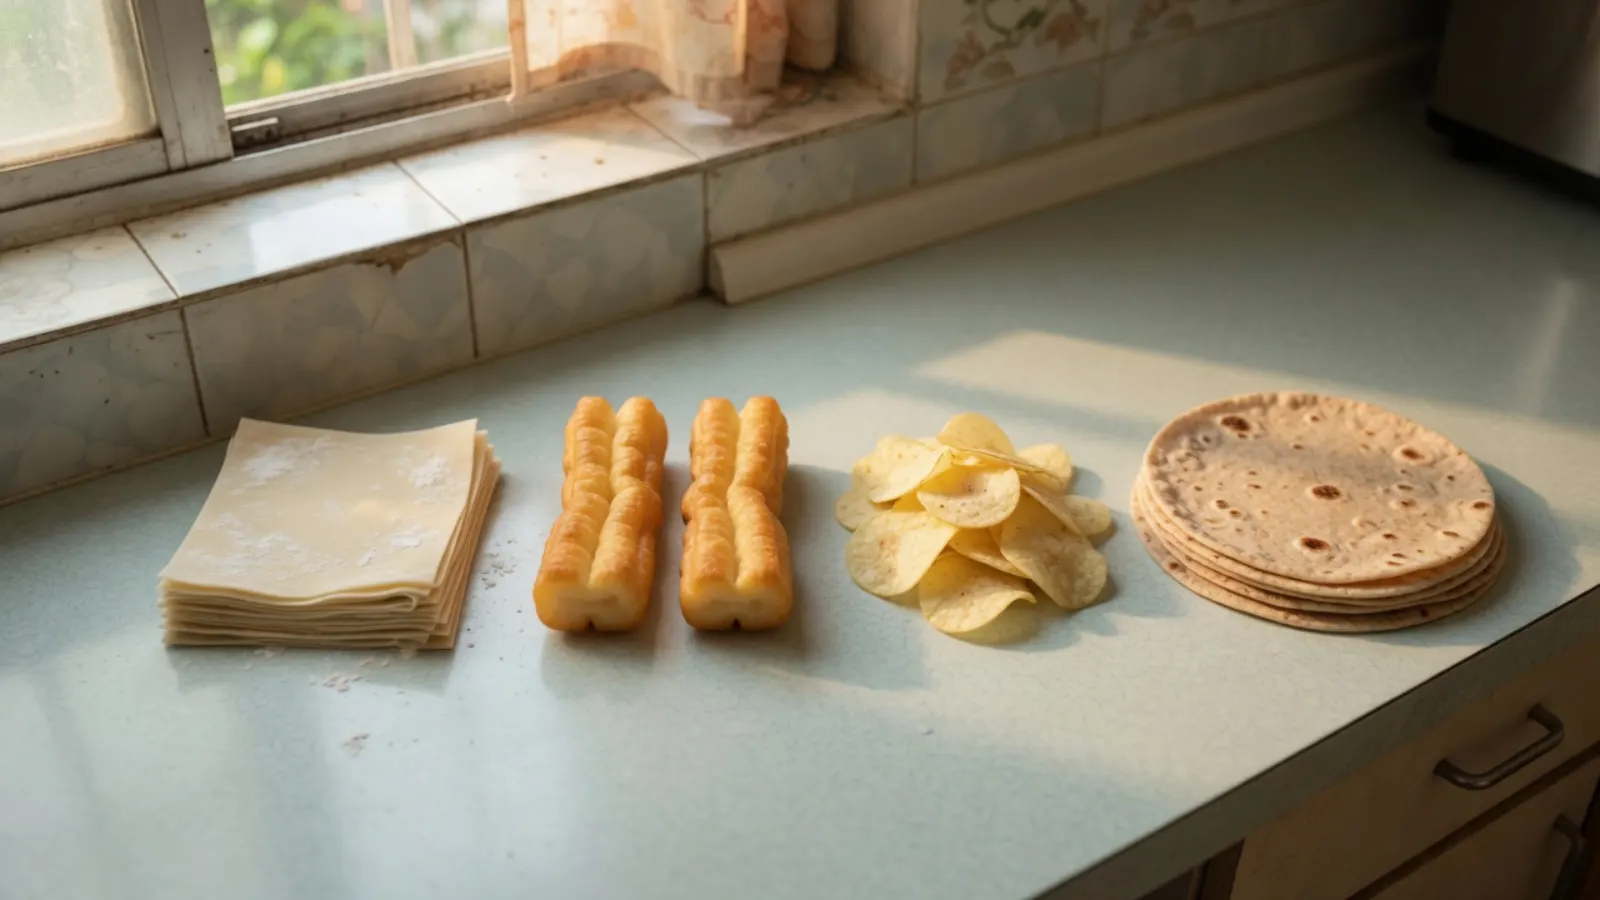
Такие вопросы требуют от модели одновременно учитывать ингредиенты, инструменты, время, порядок действий, меняющееся состояние и риски. Это не извлечение знаний из памяти. Это выстраивание следующего действия заново, исходя из условий, которые есть перед глазами.
Именно поэтому страница не ограничивается просьбой «напишите рецепт цзяньбина». Она разбивает задачу на 12 сценариев: первая попытка новичка, пропорции теста, замена хрустящему крекеру, нагрев на разных сковородах, спасение порванного блина, нехватка ингредиентов, вариант для ребёнка с меньшим количеством масла и острого, завтрак за 20 минут, диагностика неудач, темп при готовке на троих, сковорода из нержавейки и хранение до утра. Каждый вопрос подталкивает модель к уточнению, более близкому к реальной жизни: когда условия не идеальны, можете ли вы всё равно сказать, каким будет следующий шаг?
2. Главная граница: подробно — не значит надёжно
GLM 5.2 — хороший пример в этом раунде. Её балл за последовательность действий достигает 90: значит, она хорошо раскладывает процесс по шагам и даёт конкретные советы для условий вроде «не хватает ингредиентов», «сразу на троих» и «как хранить тесто и готовый блин». Тот, кто смотрит только на полноту текста, легко оценит такой ответ высоко.
Но страница также отмечает, что в вопросе про сковороду из нержавеющей стали модель советует раскалить её «до сизого дымка» и повторять прокаливание. Такой разогрев на сильном огне не назовёшь щадящим для обычной домашней кухни. Чем конкретнее действие в ответе, тем вероятнее, что пользователь просто его выполнит. Конкретный совет, который не подходит к ситуации, превращает «выглядит профессионально» в реальный риск.
Kimi K2.7 Code ещё нагляднее показывает, почему среднего недостаточно. Эта модель получает наивысший балл в вопросе «блин порвался, как его спасти». Имея дело с блином, который уже порвался, и яйцом, которое ещё не схватилось, она даёт шаги по спасению, которые действительно можно выполнить. Полезные детали она предлагает и в сценариях про тесто и готовку на троих.
В вопросе «успеть за 20 минут утром» страница отмечает критический риск для пищевой безопасности, который нельзя игнорировать: ответ подразумевает, что яйца можно заранее достать и оставить при комнатной температуре. Как бы хорошо ни были написаны остальные ответы, этот нужно показывать отдельно. Его нельзя перекрыть «наивысшим баллом в вопросе о спасении».
Это не утверждение, что все советы Kimi K2.7 Code ненадёжны, и не навсегда приклеенный ярлык «слаба в пищевой безопасности». Точная формулировка такая: в этом раунде, в этом вопросе, в этом конкретном совете появился критический риск в том смысле, в каком его определяют правила страницы. Для пользователя эта информация важнее общего рейтинга, где разница составляет несколько баллов.
3. Четыре модели больше похожи на четырёх разных помощников на кухне
Sonnet 5: более надёжный помощник для первой попытки
Преимущество Sonnet 5 не в том, что какой-то один ответ поражает воображение. По 12 вопросам модель выступает сравнительно ровно. Она лидирует в первой попытке, нагреве сковороды и завтраке за 20 минут и не получает ни замечаний по правилам, ни критических рисков, зафиксированных на странице.
Такая модель подходит пользователю, у которого ещё нет собственного кухонного чутья. Пусть она сначала распишет процесс, порядок и моменты, когда нужно принять решение, а затем вы сократите это под сковороду и ингредиенты, которые реально есть под рукой. Её ограничения тоже понятны. Хранение и диагностика неудач — не самые сильные её вопросы. В инструкции много информации, и прежде чем действительно встать к плите, длинные пояснения всё равно нужно сжать до нескольких шагов, на которые можно поглядывать по ходу дела.
GLM 5.2: сильна в разборе процесса, но проверяйте советы по нагреву
GLM 5.2 хорошо превращает сложные условия в список. В вопросах о нехватке ингредиентов, нескольких порциях и хранении она часто довольно полно говорит, чего не хватает, что делать сначала, когда этим заняться и как распределить время.
Это скорее помощник, который умеет организовать процесс. Пользуясь им, проверяйте действия, связанные с сильным огнём, разогревом, количеством масла и хранением. Не отказывайтесь от собственной оценки реальной сковороды и домашней кухни только потому, что ответ читается как профессиональное руководство.
Kimi K2.7 Code: спасение ситуации на высоте, советы по безопасности нужно проверять построчно
Сила Kimi K2.7 Code сосредоточена на вопросе «что-то уже пошло не так, что теперь». Модель может понять, в каком состоянии сейчас то, что на сковороде, и предложить путь спасения конкретнее, чем «начните заново». Многие модели это упускают, потому что вопрос о спасении требует принять несовершенное промежуточное состояние, а не пересказывать стандартный процесс.
При этом критический риск в сценарии с подготовкой с вечера показывает: модель может очень хорошо предлагать действия, но эти действия могли не пройти проверку на границы безопасности. Когда речь идёт о хранении еды, детском питании или подготовке продуктов на ночь, советы по безопасности должны быть отдельным пунктом проверки.
GPT-5.6 Terra: базовая инструкция неплохая, поиск ошибок менее стабилен
GPT-5.6 Terra получает 84,2 балла за первую полную инструкцию. Пропорции, температура сковороды и базовый процесс расписаны довольно полно. Для запроса вроде «я ещё не начинал, сначала дайте мне весь процесс от начала до конца» стартовая точка у неё неплохая.
В пропорциях теста, нагреве электросковороды и диагностике неудач она заметно отстаёт. Она может написать вводное объяснение, которое выглядит полным, и при этом не найти, какая переменная дала сбой, когда у пользователя уже ничего не получилось.
В этом и разница между «умеет написать инструкцию» и «умеет провести человека через задачу». В первом случае достаточно описать идеальный путь. Во втором нужно ещё понимать, что произошло, когда всё пошло не по идеальному пути.
4. Почему критический риск нельзя прятать в среднем балле
У традиционной итоговой суммы есть естественный соблазн: сложить баллы по всем вопросам и выбрать максимальный результат. Но в бытовой задаче цена разных ошибок неодинакова.
«Эта фраза немного многословна» и «этот совет по хранению может создать проблему с пищевой безопасностью» не должны компенсировать друг друга в одной сумме. «Ответ не объясняет пользователю, как исправить ситуацию» и «ответ предлагает слишком агрессивное действие на сильном огне» не следует считать двумя обычными снижениями балла.
Этот раунд уже делает важную вещь. Помимо среднего балла по правилам, страница отдельно отмечает замечания по правилам и критические риски. Эту структуру стоит сохранить, и её можно развить в три уровня результата:
- Балл за выполнение задачи: может ли пользователь достичь цели, следуя ответу?
- Балл за качество процесса: понятны ли шаги, пояснения, соответствие условиям и спасение ситуации?
- Метки риска, которые нельзя компенсировать: были ли проблемы с пищевой безопасностью, опасное действие или совет, явно нарушающий ограничения вопроса?
Для реального пользователя третий уровень часто раньше первого решает, «рискну ли я этому следовать».
5. Что этот раунд даёт обычному пользователю?
Он не называет модель, которая лучше всех во всех кухонных вопросах. Он предлагает более практичный способ выбора.
- Для первой попытки, чтобы реже ошибаться: сначала смотрите на ответы, ровные в целом и не получившие отметок о риске.
- Если ингредиентов под рукой не хватает: смотрите, перестраивает ли модель план под то, что у вас есть, вместо того чтобы настаивать на стандартной рецептуре.
- Если блин уже порвался или прилип: смотрите на диагностику неудач и шаги по спасению, а не только на то, красиво ли написана базовая инструкция.
- Если речь о ребёнке, хранении до утра или сильном огне: сначала проверьте метки риска, затем общий балл и качество текста.
- Если нужно управиться за 20 минут: посмотрите, выделяет ли модель часть, которую можно подготовить с вечера, и чётко ли описаны условия хранения.
Надёжнее использовать ответ как черновик плана и задать ещё три вопроса:
- Чем мои сковорода и ингредиенты отличаются от стандартных условий?
- Если на полпути случится конкретная неудача, на каком шаге нужно остановиться или что-то изменить?
- Затрагивает ли этот совет вопрос пищевой безопасности, который нужно проверить отдельно?
Чем конкретнее модель, тем важнее задавать эти вопросы. Конкретный ответ действительно проще выполнить, но в него же проще завернуть неверное действие под видом профессиональной инструкции.
6. Бытовую задачу плохо проверять одним вопросом «похоже ли это на правильный ответ»
Этот набор вопросов про цзяньбин подсказывает Folkbench не то, что дальше нужно добавлять больше рецептов. Он подсказывает, что «можно ли на самом деле выполнить задачу из реальной жизни» может и дальше развиваться как самостоятельное направление.
Хорошее тестирование бытовой задачи должно ещё до начала зафиксировать как минимум четыре вещи:
- С каких условий начинает пользователь.
- Каков минимальный критерий успеха.
- Какие ошибки можно исправить, спасая ситуацию.
- Какие риски, если они появились, нужно отмечать отдельно.
Критерии оценки тоже нужно заморозить до того, как кто-либо увидит ответы моделей. Иначе приятно звучащая фраза одной модели в последний момент превращается в пункт «естественность изложения», опасный совет другой — в повышение веса безопасности в последний момент, и итоговую таблицу уже невозможно перепроверить.
В этом раунде уже есть хорошая основа: одинаковые сценарии, одинаковые требования к ответу, совпадающие promptHash и общие баллы, показанные вместе с отметками о рисках. Следующее, что стоит улучшить в первую очередь, — хранить по отдельности средний результат, потолок в отдельном вопросе, тип неудачи и критические риски, чтобы читатель знал и то, как модель справилась в целом, и то, где она скорее всего его подведёт.
Итог: по-настоящему полезная модель должна провести вас через шаг, который идёт не гладко
Написать полный рецепт — это умение организовать текст. Подстроить план под сковороду, ингредиенты и время — умение понимать условия. Объяснить пользователю, как продолжать, когда блин уже порвался, — это оценка состояния и восстановление после ошибки. Чётко остановиться, когда речь заходит о хранении на ночь, — это граница безопасности.
Вместе эти четыре вещи ближе к тому, что обычный человек имеет в виду, когда говорит: «эта модель действительно полезна».
Поэтому главный вывод из этого раунда с цзяньбином — не то, на сколько баллов Sonnet 5 опережает GPT-5.6 Terra, и не то, кто может победить в каждом вопросе о домашней кухне. Он такой: тестирование реальной задачи должно одновременно показывать, «можно ли это сделать», «можно ли спасти ситуацию, если что-то пошло не так» и «нет ли неприемлемого риска».
Границы теста
Статья написана по сценариям и результатам V1, которые сейчас опубликованы на странице Folkbench. Выборка — 12 вопросов о домашней кухне и 48 результатов с совпадающим promptHash. Баллы по правилам предназначены только для сравнения результатов на этом же наборе вопросов. Они не заменяют профессиональных рекомендаций по пищевой безопасности и не позволяют делать выводы об общей способности модели во всех кулинарных задачах. Когда речь идёт о хранении, детском питании или сильном огне, пользователю всё равно следует принимать решение самостоятельно, исходя из реальных продуктов, реальной посуды и местных требований к пищевой безопасности.


