
В первой статье речь шла о том, что не стоит верить одному скриншоту. Здесь мы спрашиваем дальше: почему нельзя слепо верить даже баллу?
Представим трёх пеликанов на велосипедах. Первый нарисован очень тщательно: перья лежат слоями, на колёсах блики, на заднем плане даже закат. Но если присмотреться, обе лапы висят над педалями. Второй похож на набросок в несколько штрихов: ни теней, ни красивой палитры. Зато рама соединена правдоподобно, тело сидит на седле, а лапы действительно стоят на педалях. Третий на статичном кадре выглядит нормально. Но стоит нажать «воспроизвести», и лапа начинает плыть по собственной траектории: педаль крутится сама по себе, а пеликан крутит лапами сам по себе. Кто из них заслуживает высшего балла?
Если ответ — «первый самый красивый», мы оцениваем эстетику. Если «второй самый надёжный» — оцениваем, выполнено ли задание. А если смотреть только на скриншот, ошибку третьего можно так и не заметить.
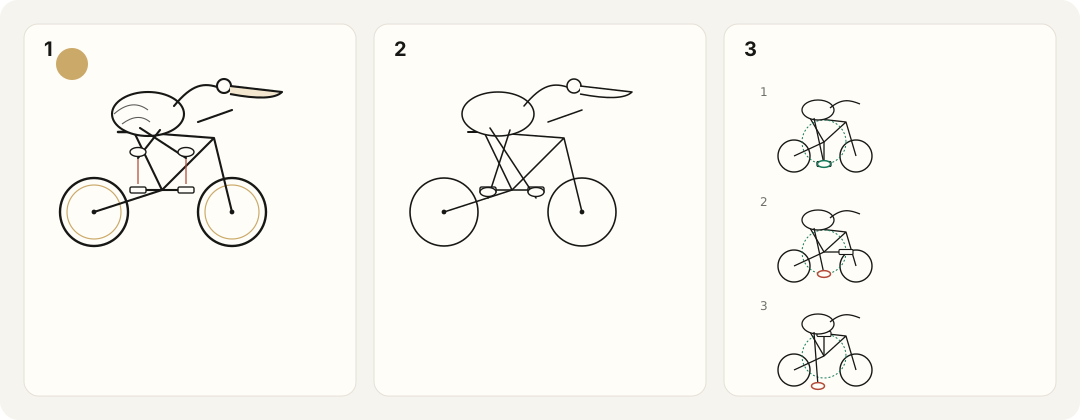
В предыдущей статье говорилось, что для вывода о том, действительно ли модель стала хуже, нужны повторные тесты в сопоставимых условиях, а не один выбранный ответ. Но в этом рассуждении спрятана посылка, которая пока не обоснована: мы уже знаем, что считать зачётом. Если эта посылка неверна, повторение само по себе не делает вывод достоверным. Оно может лишь заставить кривую линейку мерить всё стабильнее. С этого мы и начнём. Как превратить «этот пеликан вроде ничего» в метод оценки, у которого есть основания, который можно перепроверить и шаг за шагом автоматизировать?
Примечание: примеры, числа, схемы оценивания и конфигурации в этой статье — методологические иллюстрации. Они не соответствуют реальному рейтингу моделей и не означают, что Folkbench уже внедрил эти процедуры. Цитируемые исследования приводятся, чтобы объяснить связанные методы и риски; это не значит, что предложенный здесь подход прошёл экспериментальную проверку.
1. Сначала запишите задание, потом обсуждайте оценку
Тест с пеликаном привлекателен тем, что выносит ошибку на поверхность. Лишнюю ногу, несоединённую раму или лапу мимо педали трудно прикрыть гладкой фразой. Но что именно он измеряет, всё равно нужно сформулировать точнее. Когда модель просят «нарисовать в SVG пеликана, который едет на велосипеде», напрямую наблюдается вот что: может ли она превратить письменное требование в код и даёт ли этот код картинку, которая требованию соответствует. Сам по себе такой результат не говорит, какое пространственное представление модель использовала внутри. И он не позволяет подменять утверждение «хорошо справилась с этим заданием» утверждением «обладает полноценным пространственным мышлением».
Если модели разрешено отрендерить картинку, посмотреть на неё и многократно исправлять, то измеряется уже рабочий процесс с обратной связью, а не однократная генерация кода. Измерять стоит и то и другое, но смешивать их в одном рейтинге первых ответов не следует. Практический вывод такой: требование, не записанное в задании, не должно внезапно появляться при оценке. Если исходное задание звучит только как «нарисуй пеликана на велосипеде», нельзя задним числом требовать стандартный шоссейный велосипед, два колеса строго одного размера, оба крыла на руле или чтобы все детали были отчётливо видны. Разумная перспектива, перекрытия и мультяшная стилизация — естественная часть открытого рисования. Я бы разделил тест на два вида.
Первый сохраняет открытое задание и смотрит, как модель понимает и передаёт «езду». Оценивание фиксирует только ясные и необходимые требования и допускает, что пограничные примеры могут быть спорными. Второй — задание с ограничениями. В нём ещё до запуска оговорены ракурс, видимые связи, формат вывода и разрешённые техники. Например: вид в основном сбоку; допускается небольшое смещение, чтобы показать обе лапы; контакт каждой лапы со своей педалью должен быть виден; результат — один самодостаточный SVG; внешние изображения и скрипты не используются.
Задание с ограничениями меняет исходную задачу. Это не недостаток. Если версия задания помечена, она позволяет задать более конкретный вопрос: модель не выдержала ракурс, не показала контакт явно или неправильно нарисовала саму конструкцию велосипеда? Важно не то, какая версия «аутентичнее». Открытое задание оценивайте как открытое, задание с ограничениями — как задание с ограничениями. Не сочетайте расплывчатое задание со строгим стандартом, придуманным задним числом.
2. Не спешите с итоговым баллом. Сначала разберите «езду» на части
«В целом неплохо. Восемь баллов». Это самый удобный способ оценки и самый трудный для перепроверки. Откуда взялись 8: из правильного персонажа, правдоподобной конструкции или приятной палитры? Когда в следующий раз встретится та же ошибка, не поставит ли судья 9? Я бы начал с четырёх параметров, но не как с четырёх чисел, которые заполняют на глаз.
| Параметр | Что в основном проверяет | Что не должно примешиваться |
|---|---|---|
| Pelican: персонаж | Узнаётся ли пеликан; нет ли явных аномалий тела или конечностей; соблюдена ли видимость, которую задание прямо требовало | Степень реализма, детализация перьев или личные стилистические предпочтения, которых задание не требовало |
| Bicycle: велосипед | Образуют ли колёса, рама, шатун, педали и т. д. правдоподобную конструкцию, которую требовало задание | Марка, модель, декор или конкретный приём записи SVG, которых задание не требовало |
| Riding: езда | Правдоподобно ли поддерживается тело; соответствуют ли лапы педалям; выполняется ли связь управления, которую требовало задание | Лишь «птица рядом с велосипедом» или «оба объекта присутствуют» |
| Animation: связи во времени | Происходит ли требуемое движение; сохраняются ли контакт и соединение во время движения; нет ли неправдоподобных скачков или взаимопроникновения | Анимация, которой статичное задание вовсе не требовало; эффекты, не связанные с задачей |
Наличие объекта ещё не означает, что выполняется связь. «Есть лапа» и «есть педаль» — два суждения об объектах. «Лапа стоит на педали» — суждение о связи. Ещё шаг — «лапа остаётся на педали, пока педаль вращается» — и это уже суждение о связи во времени. Поэтому проверки «есть ли пеликан, велосипед и два колеса» далеко не достаточно. Выделять нужно связи: тело и седло, лапа и педаль, педаль и шатун, рама и ось колеса.
Здесь есть на что опереться. TIFA превращает требования из текста в набор вопросов, а затем методом визуальных вопросов и ответов проверяет, удовлетворяет ли им сгенерированное изображение. Это не готовый оценщик пеликанов, но он показывает полезное направление: сверять изображение с требованиями пункт за пунктом, а не ограничиваться общим впечатлением. 1 Для реализации я бы предусмотрел у каждой проверки четыре состояния: pass, fail, uncertain и not_applicable. Они означают «пройдено», «провалено», «недостаточно доказательств» и «неприменимо».
Главное — различать два последних. Если статичное задание не требовало анимации, Animation — «неприменимо». Если анимация требовалась, но материала недостаточно, чтобы судить о взаимопроникновении, — это «недостаточно доказательств». Первое не должно стоить баллов. Второе нельзя автоматически засчитывать как пройденное. Затем разделите пункты на необходимые условия и дополнительные критерии качества. Необходимые условия решают, засчитывается ли результат. Дополнительные описывают детали и внешний вид. Явный провал необходимого условия нельзя компенсировать красивыми перьями, фоном или градиентом.
В стартовом отчёте достаточно указать, сколько проверок персонажа пройдено, на каком пункте провалилась конструкция велосипеда, есть ли нерешённый вопрос по езде и применима ли анимация. Итоговый балл с точностью до двух знаков после запятой ему не нужен. Если сводная оценка действительно нужна, заранее опубликуйте применимые пункты, веса и правила обработки пропусков, а провалы необходимых условий показывайте отдельно. Рейтинги, полученные при разных весах, сами по себе стоит проверить на устойчивость. Итоговый балл — это сжатая сводка, а не повод отказаться от исходных доказательств.
3. SVG DOM помогает, но это не структурная схема, приложенная к ответу
Инженерный инстинкт при виде SVG очевиден: исходный код есть — почему бы не разобрать его напрямую? И правила пишутся быстро. Нашлись два элемента circle — значит, два колеса. Нашёлся элемент с именем foot — значит, есть лапа. Пересекаются ограничивающие рамки лапы и педали — значит, лапа на педали. Проблема в том, что на каждом из этих шагов «способ выражения в коде» принимают за «смысловой факт на картинке».
Колесо может быть элементом-окружностью или путём. Два колеса можно записать по отдельности или переиспользовать через use. Один визуальный объект может состоять из нескольких групп и путей. Спецификация SVG допускает все эти способы выражения и не требует, чтобы одному реальному объекту соответствовал один узел DOM. 2 Поэтому если не удалось насчитать два элемента circle, это не доказывает, что колеса нет, а если удалось — не доказывает, что они стоят на правдоподобных местах. Элемент с именем foot — лишь имя, которое дал ему генератор, а не независимая проверка.
Статические правила лучше всего проверяют ограничения, которые можно однозначно установить
Например: разбирается ли вывод в оговорённом формате, есть ли в нём внешние ссылки, запрещённые заданием, есть ли недопустимые скрипты и рендерится ли непустое содержимое в заданной среде. У таких проверок ясное основание, и их легко логировать. Они отвечают на вопрос «соответствует ли результат требованиям к сдаче и техническим ограничениям», а не «правильно ли эта птица едет на велосипеде». Успешный рендеринг тоже не заменяет проверку формата. Спецификация SVG различает формы документов и режимы обработки. Встроенный фрагмент на веб-странице и отдельный SVG-файл не следует принимать по одному и тому же требованию к разбору, если такой выбор не оговорён. 3
Геометрическая проверка сначала должна определить, что именно измеряется
Когда видимые геометрические области, соответствующие лапе и педали, надёжно определены, можно вычислять расстояние, перекрытие и траекторию. Например, разделить расстояние между подошвой и контактной поверхностью педали на оговорённый эталонный диаметр колеса на той же картинке. Получится относительное расстояние. Обсуждать в такой форме, «насколько лапа отошла от педали», понятнее, чем подставлять фиксированный порог в пикселях. Как определить контактную поверхность и какую погрешность допускать, всё равно нужно калибровать на размеченных примерах. Нельзя на пустом месте объявить, что «разница в пять пикселей — это точно ошибка».
При измерении нужно учитывать также преобразования координат, обводку, обрезку и фактическую видимость. Элемент SVG может находиться во вложенной системе координат. В спецификации описаны и случаи, когда у элемента, который на самом деле не отрисовывается, всё равно есть ограничивающая рамка. Получить ограничивающую рамку — не то же самое, что получить границу видимого объекта на картинке. 4 Пересечение двух рамок не означает, что подошва касается педали. Перекрытие двух плоских областей может оказаться просто перекрытием по глубине, а не правдоподобной опорой. На произвольном SVG геометрические правила лучше использовать как вспомогательные доказательства после их проверки, а не как некалиброванного судью с правом вето.
Ради автоматизации можно потребовать единый набор ID деталей, ключевых точек и структуры групп. Но это должен быть отдельный трек «структурированный вывод», где проверяется, соответствуют ли эти объявления реальной картинке. Нельзя допускать, чтобы модель написала «контакт правильный», а программа оценки ей поверила. DOM даёт нам больше проверяемой информации, но не решает задачу смыслового распознавания бесплатно.
4. Прежде чем визуальный судья приступит к работе, устройте ему экзамен
Если статических правил мало, пусть оценивает модель, которая умеет смотреть на картинки. Этот путь стоит пройти. Но «модель умеет описать картинку» не следует приравнивать к «модель стабильно распознаёт тонкую пространственную ошибку». Работа 2023 года о MT-Bench и Chatbot Arena обсуждает у LLM-судей предвзятость к позиции ответа, к многословию и к собственным ответам, а также сообщает, что сильные модели неплохо согласуются с предпочтениями людей в определённых текстовых оценках. Разумный вывод — не «модельным судьям нельзя доверять», а «их надёжность зависит от задачи и требует проверки». Кроме того, результаты текстовых оценок нельзя напрямую считать точностью визуального оценивания. 5
Визуальные способности тоже нужно проверять. Исследование BlindTest 2024 года показало, что протестированные визуально-языковые модели всё ещё ошибались в простой геометрии, например в том, перекрываются ли окружности и пересекаются ли линии. Это не значит, что все сегодняшние модели остались на уровне того года. Но этого достаточно, чтобы помнить: тонкую связь по контакту нельзя считать распознанной верно только потому, что модель известная. 6 Я бы сначала собрал набор эталонных примеров, размеченных людьми, а не сразу отдал рейтинг судье.
В наборе нужны явные успехи и явные провалы, а также пограничные случаи: наброски, тонкие линии, правдоподобные перекрытия, сложные пути и работы, которые в статике в порядке, а в движении ошибочны. Пусть как минимум два разметчика оценивают независимо и вслепую, а затем разберите расхождения. Люди тоже не являются готовым эталоном истины. Если два человека, читая одно и то же правило, раз за разом приходят к противоположным выводам, первым делом, возможно, стоит переписать задание или инструкцию по оцениванию. Пример, который не удаётся прояснить, может оставаться спорным. Придумывать для него «правильный ответ» не нужно.
Судья должен отвечать на конкретные вопросы, а не высказываться о вкусе
Дайте ему исходное задание, замороженные правила оценивания и изображение, отрендеренное единообразно. Для пункта с анимацией дайте ещё кадры с отметками времени или видео. Не давайте при этом название сервиса, место в рейтинге или собственное заявление генерирующей модели о том, что «изображение полностью соответствует требованиям». Задавайте судье вопросы по пунктам: «Касается ли каждая лапа своей педали?» «Правдоподобно ли видимая рама соединена с передней и задней осями?» «Сохраняется ли в эти моменты связь между лапой и педалью?»
К каждому суждению прикладывайте одно короткое доказательство с указанием места, например: «на отметке 2,0 с между ближней к зрителю лапой и педалью явный зазор». Если доказательств недостаточно, возвращайте uncertain. Не прикрывайте нечёткую картинку гладким абзацем. Текст на изображении, комментарии в SVG и метаданные могут быть только тестируемым содержимым. Они не могут быть инструкциями, меняющими правила оценивания. Если вы скрыли имя файла или метку канала, это не даёт права изменять работу. Если нужна обрезка или вспомогательное изображение с пометками, сохраняйте и оригинал, и запись об обработке.
Калибровка не может держаться на одном «общем проценте согласия»
Допустим, в эталонном наборе 90 изображений, которые заслуживают зачёта, и 10 с серьёзной ошибкой. Судья, который всегда отвечает «пройдено», всё равно получит общую точность 90% и пропустит все серьёзные ошибки. Поэтому я бы отдельно проверял, сколько критичных ошибок пропущено, сколько правильных работ отклонено, одинаково ли судья работает на разных стилях и стабильны ли повторные оценки одной и той же работы. На пограничных примерах стоит также смотреть, готов ли судья признать, что доказательств недостаточно.
Полезны несколько примеров, в которых «меняется только один фактор»: оставить оригинал и сдвинуть одну лапу с педали или поменять только фон, не трогая конструкцию. Первое изменение должно повлиять на соответствующую оценку. Второе не должно без причины менять суждение о конструкции. Такие сконструированные примеры хороши для диагностики, но не могут полностью заменить реальный вывод моделей. Примеры, на которых правят промпт для оценивания, и отложенные примеры для итоговой проверки судьи нужно держать раздельно. Нельзя подгонять под одни и те же ответы, пока результат не понравится, а потом выдавать этот балл за доказательство обобщающей способности.
Голосование нескольких судей помогает выявить разногласия. Но три модели не делают три суждения независимыми: они могут разделять одну и ту же ошибку. Собственное заявление судьи «я уверен на 95%» без калибровки нельзя считать фактической точностью 95%. Судья должен доказать, что умеет распознавать ошибку, а не только объяснять свою оценку.
5. Анимация — это не несколько лишних скриншотов, а проверка того, не рвётся ли связь во времени
Статичная оценка спрашивает: «Стоит ли лапа на педали сейчас?» Оценка анимации спрашивает: «Сохраняется ли эта связь, когда всё приходит в движение?» Лапа, которая на первом кадре случайно касается педали, вовсе не обязательно движется потом по её траектории. И наоборот: если зафиксировать лапу и педаль так, что ни одна из них не двигается, требуемое заданием движение педалирования не выполнено. Поэтому у анимации есть как минимум два разных вопроса: движется ли то, что должно двигаться, и сохраняется ли во время движения соединение, которое должно сохраняться.
Сначала договоритесь о сцене анимации. Езда на месте, движение вперёд и камера, которая следует за объектом, — разные задачи. Если задание не требовало точной механической симуляции, нельзя втихую добавлять дополнительные ограничения вроде передаточного числа. Если же в нём прямо требуется, чтобы шатун вращался, а лапа не теряла контакта с педалью, эти требования входят в приёмку.
Среда оценивания также должна сохранять реальное состояние анимации. Вот конкретная инженерная ловушка. Параметр скриншота Playwright animations="disabled" останавливает поддерживаемые им анимации: конечные проматываются до конца, бесконечные сбрасываются в начальное состояние. Это не синоним «точно снять произвольный момент». 7 Поэтому нельзя засчитать анимацию на том основании, что кто-то отключил анимацию и снял один красивый кадр. Сначала проверьте тайминг и способ съёмки на тестовом файле с заранее известным движением и только потом применяйте его к выводу моделей. Поддерживаемые механизмы анимации тоже стоит записать.
Допустим, задание требует цикла длительностью 4 секунды. Один из стартовых вариантов — просмотреть два полных цикла, снимать кадры с заранее заданной частотой и дополнительно проверить границу цикла и все подозрительные интервалы. Окно наблюдения, частоту съёмки кадров и правила дополнительных проверок нужно зафиксировать до формального тестирования, а не ужесточать, увидев, где возникла проблема. Но и тогда конечный набор кадров может пропустить кратковременный сбой между кадрами. В отчёте следует писать «в оговорённом окне и при оговорённой частоте кадров явных ошибок не обнаружено», а не «математически доказано, что взаимопроникновения не было ни в один момент».
Осторожности требуют и обычные перекрытия на плоской картинке. Когда нога проходит за рамой, наложение контуров ещё не означает взаимопроникновения. Проверять нужно, не меняются ли неправдоподобно порядок по глубине или соединение. Локальное увеличение помогает наблюдению, но не должно отбрасывать общий пространственный контекст. Если автоматический судья пока надёжно справляется только со статичными изображениями, публикуйте статичные результаты, а анимацию оставьте на ручную проверку. Лучше признать, что эта линейка пока туда не дотягивается, чем вкладывать неизмеренную способность в итоговый балл.
6. Система оценивания может ошибаться и создавать иллюзию, что модель вдруг стала хуже
Статические проверки, визуальный судья и ручная проверка не закрывают проблему. Сама система может меняться. Вчерашний судья мягко относился к небольшому зазору. Сегодня новая версия строго снимает баллы. Сгенерированные работы ничуть не изменились, а доля зачтённых в рейтинге падает. Если сохранять только «название модели, дату, итоговый балл», изменение судьи легко принять за деградацию модели. Помимо генерирующей модели и параметров запроса, записывайте версию задания, версию критериев оценивания, модель и конфигурацию судьи, версию рендерера и версию автоматической проверки. Изменение любого из этих элементов может изменить смысл балла.
Перед заменой судьи или правила я бы попросил старую и новую версии оценить одни и те же сохранённые работы и посмотрел, где сосредоточены различия. Исторические работы при необходимости можно переоценить, но это следует помечать как «новую оценку того же артефакта», а не выдавать за то, что модель только что ответила заново.
Другой класс проблем — оценивание, которое не завершилось. Таймаут сервиса, сломанный SVG, упавшая программа снятия скриншотов или неудавшийся запрос к судье не должны сваливаться в одну кучу «модель нарисовала неправильно». Если работа сама нарушает правила, её можно провалить по заранее установленному правилу. Если сбой произошёл в инфраструктуре оценивания, запишите оценку как нерешённую и доведите её до конца по фиксированной процедуре. Для отдельной работы явного провала одного необходимого условия достаточно, чтобы признать весь результат незачтённым. И наоборот: если явных провалов нет, но какое-то необходимое условие всё ещё неясно, просто пропустить работу нельзя.
Допустим, из 100 запланированных запросов 72 подтверждённо засчитаны, 18 подтверждённо не засчитаны и 10 ещё не решены. В отчёте можно сначала привести эти три числа, а не удалять нерешённые примеры и объявлять: «доля зачтённых — 80%». Если пока считать уже присвоенные метки верными, итоговая доля зачтённых в этой партии может лежать между 72% и 82%: нижняя граница считает все нерешённые случаи провалами, верхняя — пройденными. Этот диапазон возникает из-за нерешённых меток. Это не статистический доверительный интервал, и он не учитывает ни ошибки судьи, ни неопределённость при обобщении на другие примеры.
Ручная проверка тоже не может ограничиваться провалами и спорными случаями, отмеченными судьёй. Заранее определённую случайную выборку работ, прошедших автоматически, тоже нужно проверять. Иначе самые опасные пропуски могут так и прятаться в зоне «пройдено». Никакая автоматическая оценка не докажет свою безошибочность тем, что ни разу не уличила себя в ошибке. Ей нужна процедура аудита, способная активно находить собственные промахи.
7. Задания устаревают, но менять их каждый день — не значит быть научнее
Как только задание становится вирусным, за ним следуют примеры, туториалы, советы по исправлению и оптимизация, нацеленная именно на него. То, что модель хорошо нарисовала пеликана, само по себе не даёт оснований говорить, что она жульничала. Огласка публичного задания, усвоение типа задач и попадание тестовых примеров в обучающие данные — проблемы разного уровня. Видела ли конкретная модель конкретный тестовый материал, нужно доказывать. «Это задание слишком известное» — не доказательство.
И всё же попадание тестовых материалов в обучающие данные — риск, с которым тестирование должно считаться. Практика LiveBench включает использование более свежих источников информации, постоянное обновление заданий и автоматическую оценку по ответам, которые можно проверить. Это одна из практик снижения соответствующего риска, а не гарантия того, что «если менять задания каждый месяц, загрязнения точно нет». 8 Для открытых генеративных заданий вроде пеликана я бы предпочёл задания трёх назначений. Стабильные основные задания — чтобы следить за долгосрочными изменениями. Ротируемые дополнительные задания — чтобы следить за переносом. Отложенные задания, пока не опубликованные, — для проверки после заморозки процедуры, а не для бесконечной подгонки правил.
Ценность основного задания — в сопоставимости, а не в иммунитете к загрязнению обучающих данных. Ценность дополнительного — в более широком охвате, а не в том, чтобы формулировка была как можно страннее.
Менять стоит ограничение, а не только имя главного героя
Замена пеликана уткой — это изменение. Но оно не меняет автоматически структуру связей. Более диагностичный вариант намеренно меняет одно условие. Если развернуть персонажа в обратную сторону, остаётся ли соединение правильным? Если перекрытий больше, остаются ли ключевые детали целыми? Если задание звучит как «стоит рядом с велосипедом и толкает его», не применяет ли модель всё равно позу езды? Когда та же связь по контакту попадает в анимацию, не ломается ли она?
Задание может также перейти к другой связи: рука держит ручку чашки, предмет стоит на подносе, несколько деталей соединены в заданном порядке. Смысл не в том, чтобы свалить все редкие требования на одну картинку, а в том, чтобы понимать, что проверяет каждый вариант. Механическая подстановка сотни животных в один шаблон, конечно, даст сотню заданий. Но назвать их сотней независимых доказательств способностей нельзя. При агрегации нужно сохранять категорию задачи и семейство шаблонов, чтобы один шаблон не занял большую часть итога только потому, что у него много вариантов.
Автоматически сгенерированные новые задания тоже требуют приёмки. Задание может быть расплывчатым, противоречивым или непроверяемым по итоговому изображению. Если задание, ответ и правила для судьи предлагает одна и та же модель, а затем она же подтверждает их правильность, независимая проверка нужна тем более.
При смене банка заданий не выдавайте изменение сложности за прогресс модели
Восемьдесят баллов в этом месяце и девяносто в следующем не обязательно означают, что модель стала сильнее. Возможно, новые задания просто легче. При замене старого банка новым лучше сохранить общие задания и прогнать набор эталонных систем на обоих банках в сходных условиях. Изменения по каждой категории задач сообщайте отдельно. Общие задания и эталонные системы — не истина, которая верна всегда. Они помогают распознать изменение, но не обеспечивают автоматически строгого выравнивания сложности. Когда доказательств недостаточно, честнее показывать результаты по версиям, чем склеивать сырые баллы из разных наборов заданий в одну кривую.
Выведенное из оборота задание можно опубликовать, чтобы другие могли перепроверять, учиться и улучшать. После публикации его роль может смениться с «проверки, которую ещё не видели» на «воспроизводимый регрессионный тест». Задание не ограничено одним применением, но и не может вечно служить одним и тем же измерительным инструментом. Смысл динамического банка заданий не в вечной погоне за новизной, а в том, чтобы управлять тем, какой вывод задание может поддержать на каждом этапе.
8. Автоматизировать стоит процедуру, которую потом можно проверить
На этом этапе легко раздувать план всё больше: несколько судей, анализ траекторий, динамический банк заданий, автоматический арбитраж — и ничего из этого нельзя опустить. Минимальная рабочая версия не обязана начинаться с полностью автоматической фабрики. Выберите небольшой набор заданий, запишите условия приёмки, соберите реальные ответы, постройте эталон, размеченный людьми, а затем проверьте, какие пункты можно отдать правилам, а какие — визуальному судье. То, что пока не автоматизировано надёжно, оставьте на ручную обработку.
Пока данных мало, цель — находить дыры в правилах, а не объявлять, что «точность оценивания достигла такого-то уровня». Формальная проверка автоматизированной части требует отдельного отложенного набора примеров и отчёта о неопределённости. Одна из разумных процедур выглядит так:
Заморозить задание и правила приёмки → сгенерировать по плану → сохранить полный сырой вывод
→ контролируемо разобрать и отрендерить → выполнить статические проверки / визуальную оценку по пунктам
→ разобрать спорные случаи по правилам и выборочно проверить автоматически пройденные
→ свести результаты первой сдачи, показатели по пунктам и нерешённые статусы
Каждый шаг должен прослеживаться до предыдущего. Сырой ответ, извлечённый SVG, фактический рендер, протокол наблюдения за анимацией, сырой ответ судьи и итог ручной проверки связаны одним идентификатором прогона. Когда файл извлекается или нормализуется, сохраняйте версии до и после обработки. Если фрагмент SVG пришлось исправить, чтобы он отрендерился, записывайте это как результат процедуры исправления. Не перезаписывайте первый ответ втихую. Когда правила оценивания обновляются, добавляйте новую запись оценки, а не стирайте старую.
Одну инженерную предпосылку пропускать нельзя: вывод модели — это недоверенное содержимое. Режимы обработки SVG могут затрагивать скрипты, события и внешние ресурсы. То, что «по расширению это картинка», не значит, что файл безопасно выполнять в браузере, где кто-то вошёл в свои аккаунты для повседневной работы. 3
Среда рендеринга должна изолировать учётные данные аккаунтов, сеть и файлы хоста, ограничивать потребление ресурсов и использовать конфигурацию песочницы, подходящую для недоверенного содержимого. Если вы используете Playwright, проблема не решена оттого, что браузер «засунули в Docker». Его документация прямо предупреждает об ограничениях образа контейнера по умолчанию и о связи между запуском от root и песочницей Chromium. 9 Конкретные меры безопасности всё равно нужно проверять в той среде, где они работают. То, что разрешает задание, и то, что разрешает среда выполнения, нужно согласовать заранее. Нельзя позволить модели использовать скрипт, а при оценке молча отключить все скрипты.
Экономить на самом деле нужно не на «тщательной проверке» как таковой, а на повторяющемся труде: при каждой проверке заново искать файл, сверять параметры и проставлять временную метку.
9. Рейтинг, который стоит читать, должен выдерживать уточняющие вопросы
Увидев балл, я хочу иметь возможность выяснить, к какому сервису модели он относится, к какому банку заданий и к какому временному окну; сколько было примеров и сохранены ли провалы и нерешённые случаи; кто оценивал, как проводилась калибровка и можно ли найти основание суждения. Эта информация больше, чем итоговый балл, который выглядит очень точным, говорит о том, всерьёз ли тестирование относится к собственным границам.
Те, кто не собирается строить процедуру сам, могут начать с публичного рейтинга, отчётов и пояснений к тестированию на Folkbench и проверить, есть ли уже применимый опубликованный результат для интересующих их модели и сервиса. Публичная главная страница описывает сравнение как сопоставление разных сервисов для одной и той же модели. Охват, состояние функций и основания выводов всё равно следует сверять с информацией, опубликованной на тот момент. 10
То же относится и к Folkbench, и к другим рейтингам. Недостающая информация остаётся неизвестной. Описание платформы не заменяет фактический отчёт. Подход к оцениванию, предложенный в этой статье, — не то же самое, что возможности, которые уже есть у какой-либо платформы. Хорошее тестирование не просит читателя «поверить моему баллу». Оно позволяет пройти от балла к работе, условиям, правилам и разногласиям. Вернёмся к трём пеликанам.
Нам не нужно спорить, самый ли красивый первый, и не нужно засчитывать всю анимацию третьего из-за одного удачного кадра. Когда договорились, что измеряем, и чётко записали доказательства, многое из того, что называют шаманством, превращается в вопросы, которые можно обсуждать по пунктам. В первой статье говорилось, что скриншот может поставить хороший вопрос, но для ответа на него нужен добротный эксперимент. Эта статья хочет добавить: добротному эксперименту нужна ещё и проверенная линейка.
Приложение A. Задание с ограничениями и таблица приёмки, с которых можно начать
Ниже — пример статичного задания, составленный для этой статьи. Это не отраслевой стандарт и не официальное задание какой-либо платформы. Перед использованием его нужно опробовать и откалибровать с помощью разметки. После начала формального сравнения не меняйте задание из-за результатов.
Пример промпта
Выведите только содержимое одного самодостаточного статичного SVG-файла, который открывается сам по себе.
Используйте viewBox "0 0 800 600". Не добавляйте оформление блока кода Markdown и пояснения.

Нарисуйте мультяшного пеликана, который едет на обычном двухколёсном велосипеде.
Вид в основном сбоку. Допускается небольшое смещение деталей, чтобы было хорошо видно, как пеликан едет.

Рисунок должен удовлетворять всем следующим условиям:
1. Пеликан и велосипед целиком помещаются в кадр, лишних ног нет.
2. Узнаваемы переднее и заднее колёса, рама, седло, руль, шатун и две педали.
   Рама правдоподобно соединена с осями обоих колёс, педали правдоподобно связаны с шатуном.
3. Тело сидит на седле. Каждая лапа касается своей педали,
   и оба контакта должны быть хорошо видны. Хотя бы одно крыло касается руля.
4. Используйте только векторную графику SVG и inline-стили. Не используйте встроенные растровые изображения, внешние ресурсы,
   скрипты, foreignObject или анимацию.

Реализм, сложный фон, текстура перьев и декоративные эффекты не требуются.
Пример таблицы приёмки
| ID | Проверка | Тип |
|---|---|---|
| F1 | Соответствует оговорённому формату отдельного файла, области просмотра и ограничениям на ресурсы | Необходимое условие |
| P1 | Персонаж узнаётся как пеликан, изображение полное, явных лишних ног нет | Необходимое условие |
| B1 | Узнаваемы два колеса, рама, седло, руль, шатун и две педали | Необходимое условие |
| B2 | Рама правдоподобно соединена с обеими осями, педали правдоподобно связаны с шатуном | Необходимое условие |
| R1 | Тело явно опирается на седло в положении сидя | Необходимое условие |
| R2 | Каждая лапа касается своей педали, контакты соответствуют требованию видимости | Необходимое условие |
| R3 | Хотя бы одно крыло касается руля | Необходимое условие |
| A | Задание статичное. Анимация не проверялась | Неприменимо |
| Q1 | Цвет, линии и детали | Необязательный показатель для отображения. Не отменяет провал необходимого условия |
Слова «узнаваемый», «правдоподобный» и «явный» по-прежнему требуют парных положительных и отрицательных примеров и пояснения границы. Таблица — лишь каркас правил. Несколько фраз сами по себе не устраняют субъективного суждения. Результат засчитывается, только если пройдены все необходимые условия. Явный провал необходимого условия означает незачёт. Если явных провалов нет, но какое-то необходимое условие не решено, работа уходит на ручную проверку. R3 проверяется потому, что этот пример промпта прямо этого требует. Без оговорки применять его ко всем заданиям с пеликаном не следует.
Приложение B. Пример одной записи вывода судьи
Приведённый ниже JSON — вымышленная запись по одному пункту. Он показывает, как связаны поля, и не соответствует реальному изображению. Это не полный отчёт и не конфигурация, которую какая-либо библиотека может запустить напрямую.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "Между ближней к зрителю лапой и соответствующей ей педалью хорошо виден зазор."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id должен указывать на конкретную модель судьи, промпт, параметры и запись о версии. render_profile_id должен указывать на браузер, область просмотра и другие связанные настройки. В доказательствах для анимации нужно указывать фактическое время, а не только «где-то в середине есть кадр». review_required выставляет система оценивания по установленному правилу; судья не решает это единолично. Даже когда поле равно false, пример всё равно может попасть в случайный аудит. Сбой автоматической оценки, недостаток визуального материала и незачёт по заданию нужно записывать по отдельности. У них не должно быть одного размытого статуса «сбой».
Примечания и источники
- Yushi Hu и др., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. Работа превращает текстовые требования в проверки в форме вопросов и ответов, чтобы оценить соответствие изображения тексту. Здесь заимствуется идея декомпозиции; экспериментальные результаты оригинальной работы не переносятся на задания с пеликаном в SVG или на анимацию. Статья↩
- W3C, Scalable Vector Graphics (SVG) 2, главы о структуре документа и путях. См. группировку, переиспользование через
useи запись путей. Вывод о том, что узел DOM сам по себе не соответствует смысловому объекту реального мира, — это суждение о дизайне оценивания, сделанное здесь на этой основе. Структура документа; Пути↩ - W3C, SVG 2 — Conformance Criteria, разделы о режимах обработки и соответствии документов. Спецификация различает такие возможности, как выполнение скриптов, внешние ресурсы и декларативная анимация, а также формы документов. Поддержку браузерами и ограничения на выполнение всё равно нужно проверять в реальной среде. Спецификация↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, фрагменты о преобразованиях координат и ограничивающих рамках. Приведённые здесь предложения о расстоянии контакта, порогах и смысловом распознавании — примеры дизайна оценивания, а не определённый спецификацией SVG алгоритм «правильной езды». Спецификация↩
- Lianmin Zheng и др., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Здесь работа используется только в той части, где она говорит о способностях и предвзятости судей в определённых текстовых оценках. Из неё не делается вывод, что у всех визуальных судей та же величина предвзятости или та же точность. Статья↩
- Pooyan Rahmanzadehgervi и др., Vision language models are blind, 2024. Здесь имеется в виду исходное исследование 2024 года, и цитируется именно arXiv v1, чтобы не смешивать с ним модели, название и результаты более поздних редакций. Это исследование не может служить текущим рейтингом моделей 2026 года. Версия статьи↩
- Документация Playwright по параметру
animationsметодаpage.screenshot, просмотрено 5 октября 2026 г. Документация описывает, как этот параметр обрабатывает CSS animations, CSS transitions и Web Animations. Без проверки не следует расширять его до единого механизма управления временем для всех видов анимации SVG. Документация↩ - Colin White и др., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. В более раннем названии было «Contamination-Free». Здесь мы следуем формулировкам редакции 2025 года о постоянном обновлении, проверяемой оценке и снижении риска загрязнения и не обещаем, что загрязнение полностью отсутствует. Статья↩
- Документация Playwright по Docker, просмотрено 5 октября 2026 г. Документация предупреждает, что образ по умолчанию не рекомендуется для посещения недоверенных сайтов, и объясняет, что запуск от root по умолчанию отключает песочницу Chromium. Эта статья не предлагает полного безопасного развёртывания. Изоляцию, сетевую политику и политику прав всё равно нужно реализовать и протестировать в той среде, где они работают. Документация↩
- Публичная главная страница Folkbench, просмотрено 5 октября 2026 г. На главной странице есть входы в рейтинг, отчёты и связанные пояснения, а сравнение описано как сопоставление разных сервисов для одной модели. Вход в проверку там же помечен как подготовительный сценарий бета-версии, а реальные проверочные запросы — как ещё не включённые; текущий вход служит для демонстрации подготовительного сценария. Эта статья лишь указывает на публичную информацию. Она не считает демонстрационный вход завершённым измерением, не поддерживает независимо какой-либо конкретный рейтинг и не утверждает, что Folkbench внедрил предложенные здесь оценку по четырём параметрам, калибровку судей или динамический банк заданий. Главная↩


