
Главный вопрос о Kimi K3.1 Pro — способна ли модель довести длинную задачу до конца: разобраться в проекте, отредактировать код, вызвать инструменты и исправиться, когда результат не прошёл проверку. Эффектный первый экран — лишь малая часть этой работы. Разработчику важнее другое: работают ли исходные функции после десятой правки и проходит ли результат приёмку?
Речь пойдёт о Kimi K3.1 Pro и о скоростном варианте Kimi K3.1 Pro Highspeed. Источники сверены по состоянию на 23 октября 2026 г. Числовые данные взяты из официальных материалов. Для этой статьи Folkbench не вызывал модели и не перезапускал их бенчмарки, и мы не присваиваем модели собственную оценку.
Сначала разберёмся, что это за модель
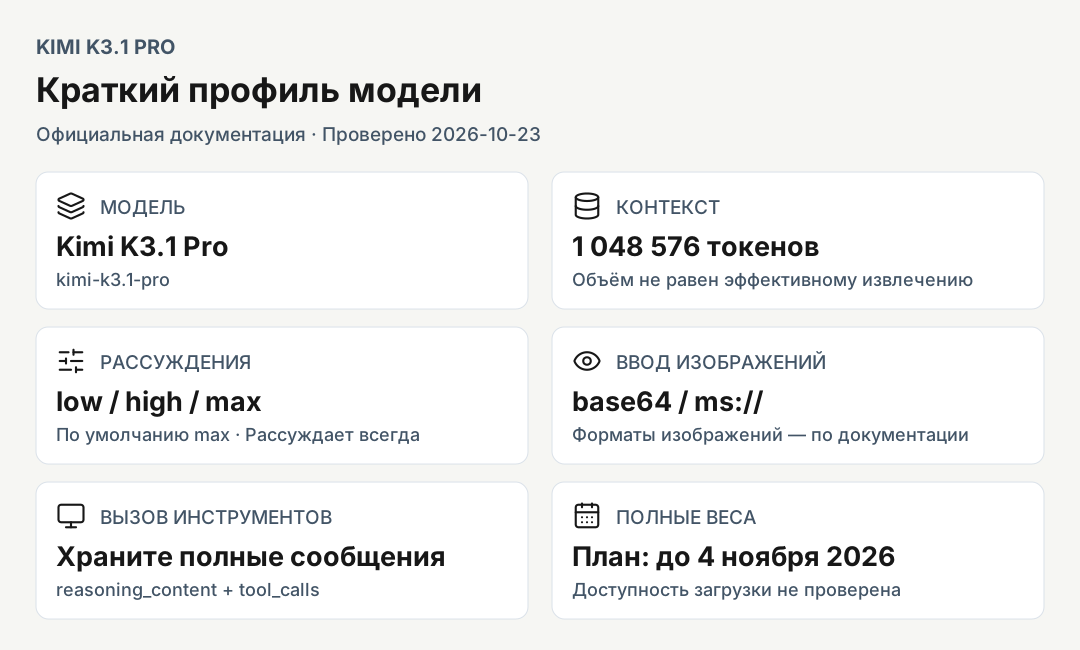
| Параметр | Что подтверждает документация |
|---|---|
| Стандартный API ID | kimi-k3.1-pro |
| API ID скоростного варианта | kimi-k3.1-pro-highspeed |
| Официальное позиционирование | Флагман для программирования, 3D-творчества и финансовых исследований |
| Заявленный масштаб | Класс 3T; из этого нельзя вывести число активных параметров на запрос |
| Окно контекста | 1 048 576 токенов |
| Уровень рассуждений | low, high, max; по умолчанию max |
| Изображения и инструменты | Ввод изображений, вызов инструментов, потоковый вывод |
| Веса | Технический блог планирует выпустить полные веса до 4 ноября 2026 г.; доступность загрузки здесь не проверялась |
Название и позиционирование взяты из списка моделей, точный размер контекста — из документации по тарификации, возможности API — из руководства по быстрому старту. Технический блог описывает модель как результат дообучения K3 и приводит план выпуска весов. По одному номеру версии нельзя заключить, что сменилась базовая архитектура, а план выпуска весов ещё не означает, что локальное развёртывание уже доступно.
Два бенчмарка — два разных вопроса
Эти цифры — сравнение, опубликованное в техническом блоге Kimi. Данные конкурентов взяты с той же страницы, а не получены Folkbench в едином окружении.
| Тест | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% |
| BenchCAD, с инструментами, Voxel IoU | 92,7% | 96,2% | 95,9% |
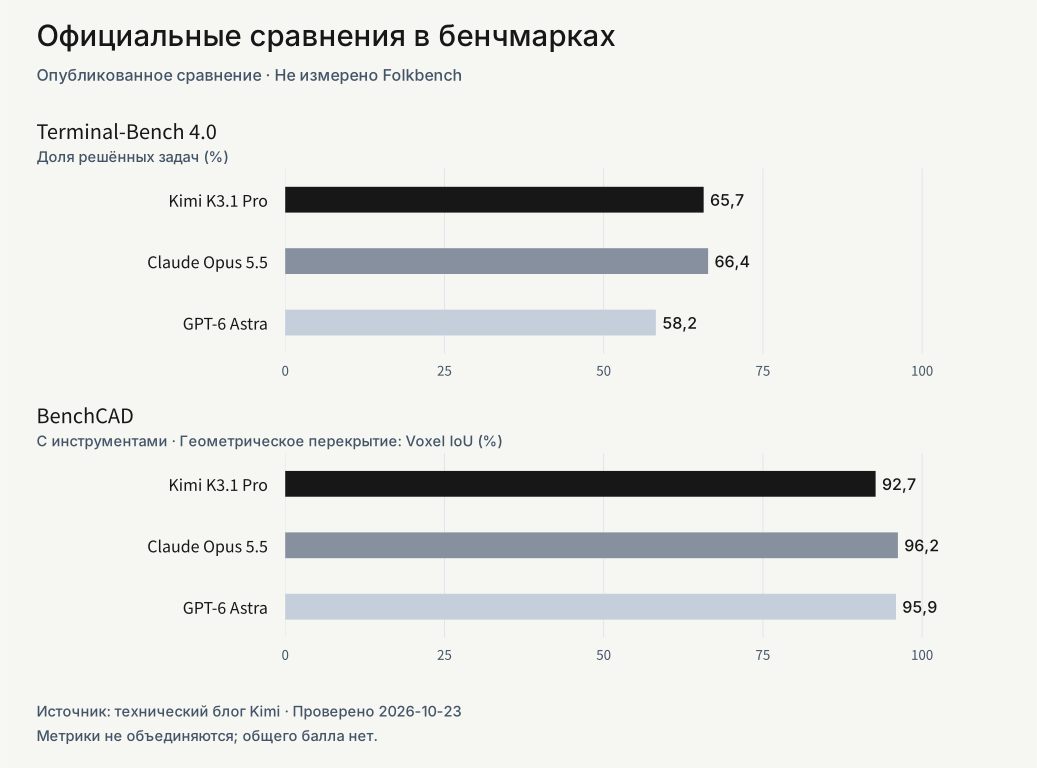
В сносках по умолчанию указан уровень рассуждений max. Прогон Kimi на Terminal-Bench выполнялся в среде Claude Code; результаты конкурентов собраны из релизных материалов или рейтингов. Открытые модели на BenchCAD тестируются на подвыборке из 1000 задач, и режим с инструментами тоже использует Claude Code. Эти условия нужно приводить вместе с цифрами.
Программирование: близкий результат ещё не заменяет приёмку на проекте
65,7% и 66,4% различаются на 0,7 процентного пункта. В этой опубликованной таблице модели идут почти вровень. Но без одинаковых бюджетов, числа повторов и оценок неопределённости этого недостаточно, чтобы говорить о равных возможностях. Точно так же более высокий результат в одном тесте не доказывает превосходства во всех задачах программирования.
В реальных проектах важнее восстановление после ошибок. Задача может требовать изменить интерфейс, обновить вызывающий код и сохранить совместимость — и всё это ничего не сломав. Объём кода, написанного с первой попытки, мало что говорит об этих обязательствах. Модель должна понимать, на что на самом деле указывает упавший тест, а не добиваться прохождения, удаляя проверку, ослабляя условие или выбрасывая функцию.
Перед миграцией прогоните заново уже решённую задачу с понятными критериями приёмки. Зафиксируйте ревизию репозитория и требования, дайте каждой модели-кандидату поработать самостоятельно, а затем сверьте результаты тестов, объём изменений и количество ручных доработок. Такая запись даёт больше оснований для решения, чем эффектная демонстрация. Это предлагаемая процедура приёмки, а не эксперимент, проведённый для этой статьи.
3D: геометрическое совпадение — лишь часть готового результата
Метрика BenchCAD здесь — Voxel IoU. Значение 92,7% не означает ни «92,7% успешно выполненных задач моделирования», ни оценки художественного качества. Геометрия, материалы, освещение, анимация, редактируемость и производственные допуски требуют разных проверок.
Для сцены на Three.js проверьте, работают ли интерактивные элементы, плавно ли сцена идёт на устройствах и загружаются ли ресурсы. Для редактируемой детали проверьте размерные соотношения, форму после изменения параметров и экспортированные файлы. Убедительный рендер с одного ракурса может скрывать дыры на обратной стороне, пересекающуюся геометрию или непригодную топологию.
Наша редакционная оценка по этим официальным результатам: K3.1 Pro стоит включить в список кандидатов для длинных задач по программированию и программного моделирования. Заменит ли она существующее решение, должны показать результаты целевого проекта.
Контекст в 1 млн токенов отвечает на вопрос о вместимости
Сколько файлов поместится в 1 048 576 токенов, зависит от содержимого и токенизации. Это не фиксированное число слов или строк кода. К тому же вместимость не гарантирует, что модель найдёт нужные доказательства, удержит все ограничения и после множества вызовов инструментов не отклонится от исходной цели.
Отправить в запрос весь репозиторий может быть удобно, но вместе с полезным кодом туда попадут сгенерированные файлы, устаревшая документация и противоречивые инструкции. Укажите текущую ревизию, нужные файлы, поведение, которое не должно меняться, и точку входа для приёмки. Важнее пригодный контекст, а не просто больший.
Есть и повторяющаяся статья расходов. Официальная документация по моделям с рассуждениями требует сохранять рассуждения из прошлых сообщений assistant; они продолжают занимать контекст и тарифицируются. Поэтому за коротким видимым ответом может стоять гораздо больший счёт за токены.
Настройки API меняют впечатление
Руководство по уровню рассуждений сообщает, что K3.1 Pro рассуждает всегда, а уровень по умолчанию — max. Значение low снижает уровень, но не отключает рассуждения. Перед сравнением задержки выровняйте этот параметр, иначе кажущаяся разница в скорости может отражать лишь разные бюджеты.
При миграции проверьте три вещи:
- Используйте параметр верхнего уровня
reasoning_effort, а не переносите конфигурациюthinkingиз K2. - В циклах с инструментами сохраняйте сообщения assistant целиком, включая
reasoning_contentиtool_calls. Если оставить только итоговый текст, пропадёт история, которой требует API. - Для изображений следуйте руководству по быстрому старту: используйте base64 или ссылки на файлы
ms://и не рассчитывайте, что будет принят любой публичный URL изображения.
У прокси свои вопросы: сохраняет ли он поля запроса, не обрезает ли ответы, не подменяет ли имя модели и полностью ли передаёт сведения об использовании? Успешный текстовый ответ ещё не доказывает, что цикл вызова инструментов в агенте поверх него работает правильно.
Стоимость начинается с задачи целиком
Официальная страница цен и её Markdown-версия во время этой проверки не вернули полной строки цен K3.1 Pro, которую можно было бы сверить. Поэтому мы не публикуем цены в долларах и не подставляем цены K3 или прокси. Это не доказывает, что официальные цены не опубликованы; это лишь описывает, что удалось проверить для этой статьи.
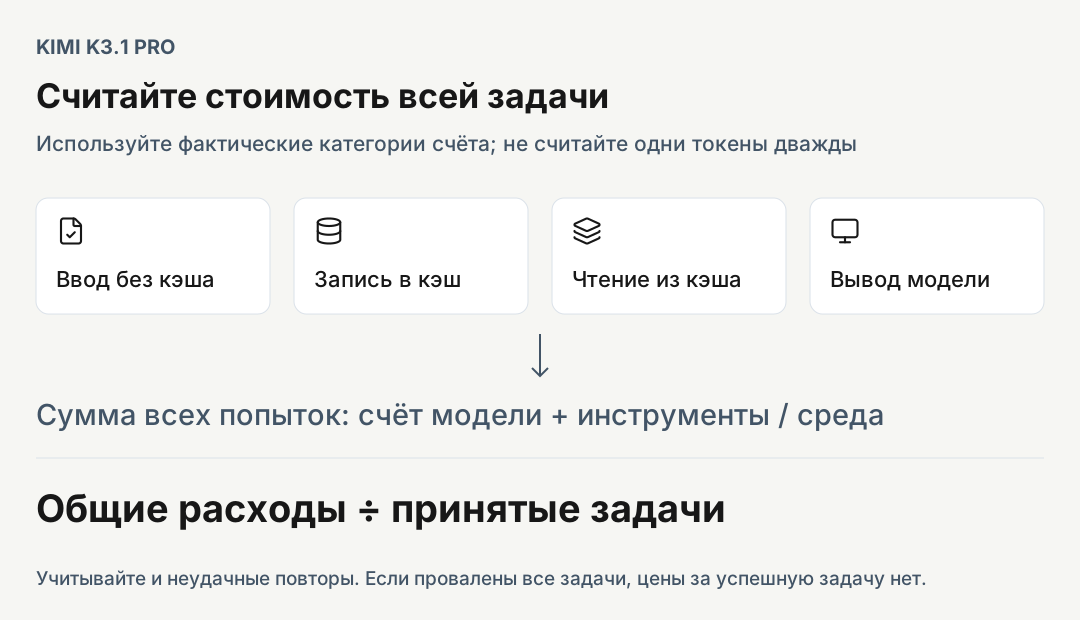
Структура тарификации задокументирована: использование API оплачивается по факту и отдельно от подписки Kimi и Kimi Code; цена записи в кэш зависит от TTL, а попадания в кэш и ввод без кэша — разные статьи счёта. В руководстве по быстрому старту сказано, что цены не делятся на уровни по длине контекста. Руководство по кэшированию описывает правила повторного использования и срок хранения.
Поэтому задачу с длинным контекстом стоит разбирать по частям: какой ввод не попал в кэш, что вызвало запись в кэш, что тарифицировалось как чтение из кэша и сколько получилось вывода. Сервисы инструментов, среды выполнения и неудачные повторы тоже могут увеличить общие расходы. Следуйте фактическим категориям счёта, чтобы одни и те же токены не учитывались дважды.
Полезная метрика для закупки и обсуждения миграции — общие расходы на пакет задач ÷ число задач, прошедших приёмку. Неудачные попытки остаются в числителе; если провалены все задачи, цены успешной задачи просто нет. Это предлагаемый способ сравнения, а не результат измерений Folkbench.
Список моделей описывает Highspeed как вариант с теми же возможностями и примерно в 2–3 раза большей скоростью. Это заявление поставщика, а не измерение всего рабочего процесса. Если генерация занимает половину общего времени и эту половину сократить втрое, общее время уменьшится с 1 примерно до 0,67 — то есть в целом работа ускорится примерно в 1,5 раза. Это гипотетический расчёт, иллюстрирующий узкое место, а не измеренная задержка Kimi.
С чего начать оценку
| Тип работы | Что проверять | Результат, который имеет смысл при приёмке |
|---|---|---|
| Изменения в нескольких файлах кода | Соблюдение ограничений, инструменты, восстановление после ошибок | Тесты проходят, старые функции сохранены, объём ручных доработок приемлем |
| Программная 3D-графика и веб-интерактив | Пространственные отношения, скрипты, итеративные правки | Файлы редактируются, интерактив работает, производительность в норме |
| Исследования по нескольким документам и таблицы | Поиск доказательств, перекрёстная сверка | Ссылки прослеживаются, единицы согласованы, расчёты воспроизводимы |
| Простое извлечение или частая классификация | Задержка и стоимость одной задачи | При том же пороге качества расходы ниже, чем у текущего решения |
Первые три типа соответствуют официальному позиционированию модели, но позиционирование не гарантирует качества. В исследовательских задачах гладкий текст и множество ссылок не заменяют проверки: действительно ли источник подтверждает каждое утверждение, совпадают ли годы и единицы измерения, можно ли пересчитать формулы в таблице. Для простой классификации флагманская модель с уровнем max по умолчанию может оказаться не самым экономичным выбором.
Оценка Folkbench
Официальные материалы дают K3.1 Pro весомый повод для серьёзной проверки: её результаты в программировании и программном моделировании находятся рядом с сильными конкурентами. Практическая ценность зависит от того, превращаются ли эти возможности в результаты, проходящие приёмку, — с вашими входными данными, инструментами и бюджетом.
У нас пока нет собственных записей вызовов, повторных экспериментов, распределения сбоев и проверенных цен, поэтому мы не публикуем ни сводный балл, ни вывод о «лучшем соотношении цены и качества». Некоторые разделы о бенчмарках в руководстве по быстрому старту всё ещё содержат заглушки и расходятся по версии с техническим блогом. Два сравнения выше последовательно взяты из блога, без смешивания версий.
Если вы оцениваете рабочие процессы с кодом, продолжите с [руководства Folkbench по оценке в программной инженерии](/ru/blog/ai-api-relay-software-engineering-evaluation-guide). Материалы о других моделях: [Claude Opus 5.5](/ru/blog/claude-opus-5-5-review-pricing) и [GPT-6.1 Sol](/ru/blog/gpt-6-1-sol-review-pricing). Sol — это не GPT-6 Astra из таблицы; их названия и результаты не взаимозаменяемы.


