
Điểm chính thức của Claude Haiku 5.5 đã được công bố. Đặt nó cạnh Haiku 4.5, GPT-6 Luna và Sonnet 5.5, câu hỏi đáng bàn không phải là nó có thắng ở mọi hạng mục hay không, mà là Haiku 5.5 đã đẩy giới hạn năng lực của một mô hình nhỏ đi xa đến đâu.
Mô hình Anthropic phát hành là Claude Haiku 5.5. ID mô hình là claude-haiku-5-5. Mô hình ra mắt ngày 7 tháng 10 năm 2026.
Anthropic định vị nó khá thẳng thắn: Haiku 5.5 là mô hình nhỏ nhanh nhất, rẻ nhất và mạnh nhất của hãng, nhắm tới các tác vụ khối lượng lớn, độ trễ thấp và nhạy cảm về chi phí. Các trường hợp sử dụng tiêu biểu mà hãng nêu gồm phân loại, trích xuất thông tin, tóm tắt, nén ngữ cảnh, truy vấn cơ sở dữ liệu, thao tác trình duyệt và làm agent con (subagent) cho Sonnet 5.5 hoặc Opus 5.5.
Bài viết này chỉ dùng các bài đánh giá chuẩn (benchmark), mức giá và thông tin sản phẩm mà Anthropic công bố, không đóng gói lại bảng điểm chính thức thành một thí nghiệm độc lập. Việc chúng tôi làm là đặt các con số trở lại bối cảnh loại tác vụ, giá và vai trò của mô hình, để xem Haiku 5.5 thực sự mạnh ở đâu và những việc nào vẫn chưa nên giao cho nó.
Tóm tắt: Haiku 5.5 đã vượt qua lằn ranh “mô hình nhỏ chỉ làm được việc đơn giản”
Ghép các số liệu chính thức lại, chân dung của Haiku 5.5 khá rõ ràng:
- So với Haiku 4.5, nó tăng mạnh ở mọi benchmark chính mà Anthropic công bố;
- Ở các hạng mục được báo cáo song song, nó vượt GPT-6 Luna;
- Ở công việc tri thức, thao tác máy tính và một số tác vụ suy luận, nó đã tiến sát Sonnet 5.5;
- Ở lập trình agent phức tạp, nó vẫn kém Sonnet 5.5 rõ rệt;
- Điểm cạnh tranh nhất của nó là sự kết hợp giữa tốc độ, giá và tỷ lệ hoàn thành tác vụ nay đã đủ cao.
Vì vậy, nên hiểu Haiku 5.5 như một lớp thực thi có năng lực tăng vọt, chứ không phải một mô hình thay thế Sonnet 5.5 trên mọi mặt.
So sánh benchmark chính thức
Anthropic công bố các số liệu sau trên trang giới thiệu Haiku 5.5. Các ô của GPT-6 Luna và Sonnet 5.5 lấy từ cùng một bảng so sánh.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1: công việc tri thức | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1: công việc tri thức | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1: thao tác máy tính | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam: không dùng công cụ | 45,9% | 10,2% | — | 56,9% |
| Humanity's Last Exam: có dùng công cụ | 57,4% | 18,7% | — | 64,5% |
| Terminal-Bench 4.0: lập trình agent | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1: lập trình agent | 46,4% | — | 42,4% | 52,1% |
| Chartography: suy luận thị giác | 46,4% | 6,4% | 29,1% | 61,6% |
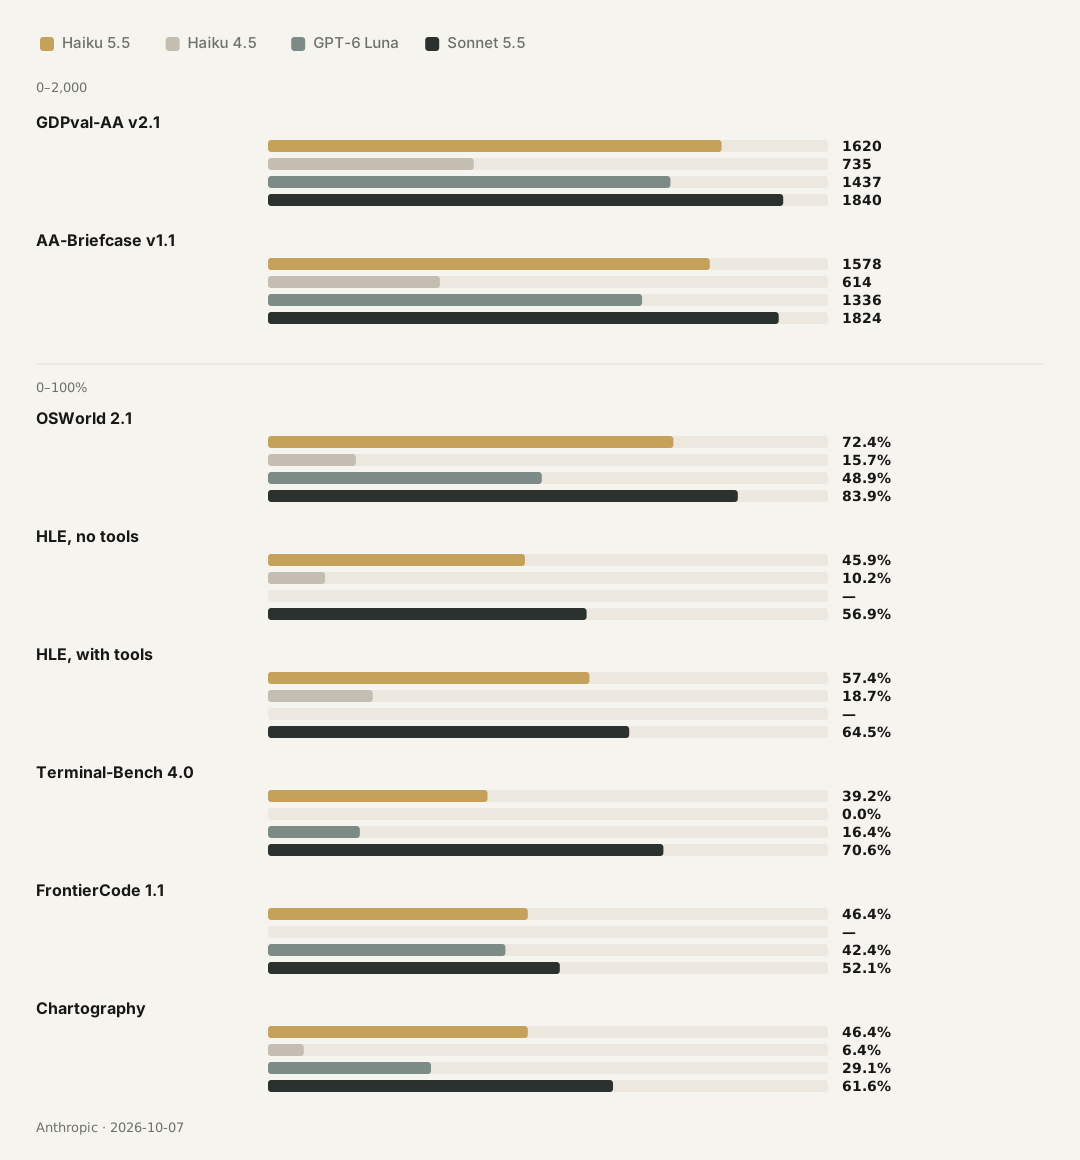
Những con số này không thể gói gọn thành “Haiku 5.5 xếp thứ hai”. Mỗi benchmark đo một năng lực khác nhau. Công việc tri thức quan tâm đến chất lượng sản phẩm bàn giao. OSWorld quan tâm đến việc mô hình có vận hành được một máy tính thật hay không. Terminal-Bench quan tâm đến việc nó có hoàn thành được công việc chuyên môn nhiều bước trong dòng lệnh hay không. Humanity's Last Exam thì nghiêng về kiến thức khó và suy luận.
Việc cùng một mô hình cho kết quả chênh lệch lớn giữa các tác vụ cũng là một phần của kết quả đánh giá.
Thay đổi thứ nhất: Haiku 5.5 bỏ xa thế hệ trước
Chỉ cần đặt Haiku 4.5 cạnh Haiku 5.5 là thấy rõ mức nâng cấp.
GDPval-AA v2.1 tăng từ 735 lên 1620, khoảng 2,2 lần thế hệ trước. AA-Briefcase tăng từ 614 lên 1578, khoảng 2,6 lần. OSWorld tăng từ 15,7% lên 72,4%. Terminal-Bench tăng từ 0,0% lên 39,2%.
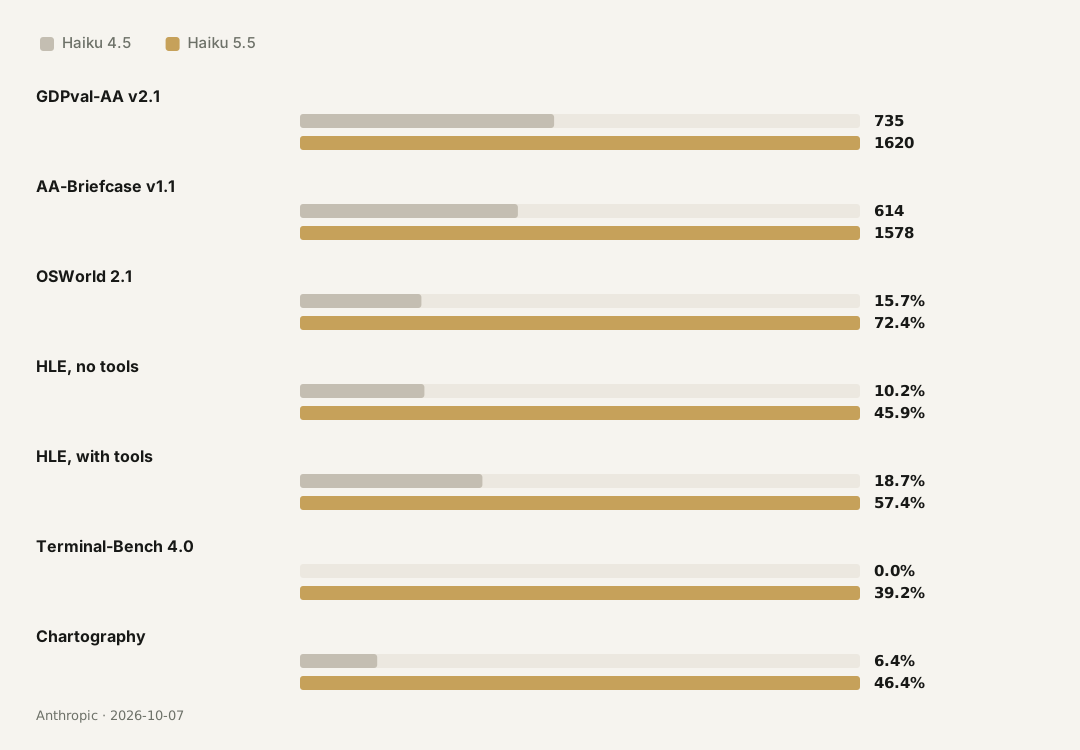
Đây không phải kiểu thay đổi “câu chữ trau chuốt hơn”. OSWorld và Terminal-Bench đều đòi hỏi chuỗi thao tác dài: mô hình phải hiểu nhiệm vụ, gọi công cụ, xử lý phản hồi và tiếp tục làm sau khi mắc lỗi giữa chừng. Mức tăng ở các bài kiểm tra này cho thấy Haiku 5.5 không còn chỉ là mô hình dành cho phân loại văn bản ngắn và tóm tắt.
OSWorld là ví dụ rõ nhất. Giữa 15,7% của Haiku 4.5 và 72,4% của Haiku 5.5 có một bước đứt gãy rõ ràng. Kể cả khi đã tính đến cách thiết lập benchmark, tập con ngoại tuyến và điều kiện kiểm tra của Anthropic, kết quả vẫn cho thấy năng lực thao tác máy tính đã thay đổi trọn một thế hệ.
Tuy vậy, mức tăng ở một hạng mục không có nghĩa là mọi tác vụ trong môi trường production đều cải thiện tương đương. Một benchmark đo một tập tác vụ cụ thể; sản phẩm thực tế còn phụ thuộc vào độ dài ngữ cảnh, cách định nghĩa công cụ, khả năng khôi phục lỗi, độ trễ mạng và chất lượng dữ liệu nghiệp vụ.
Thay đổi thứ hai: nó đã bước vào vùng cạnh tranh của GPT-6 Luna
Ở các hạng mục Anthropic công bố, Haiku 5.5 đạt điểm cao hơn GPT-6 Luna:
- GDPval-AA: 1620 so với 1437;
- AA-Briefcase: 1578 so với 1336;
- OSWorld: 72,4% so với 48,9%;
- Terminal-Bench: 39,2% so với 16,4%;
- Chartography: 46,4% so với 29,1%.
Bộ số liệu này đủ để đưa ra một nhận định thận trọng: Haiku 5.5 đã bước vào vùng cạnh tranh của các mô hình phổ biến có hiệu quả chi phí cao.
Nhưng nhận định đó phải luôn đi kèm hai giới hạn.
Thứ nhất, các con số đến từ trang công bố của Anthropic. Mỗi công ty có thể chạy benchmark, cấu hình mô hình, gắn công cụ và tính thống kê theo cách khác nhau. Bảng này phù hợp để xem nhà sản xuất định vị sản phẩm ở đâu, chứ không phải một bảng xếp hạng bên thứ ba hoàn toàn độc lập và hoàn toàn cân xứng.
Thứ hai, “cao hơn GPT-6 Luna” không có nghĩa là “tốt hơn GPT-6 Luna ở mọi tác vụ”. Bảng chính thức chỉ cho phép so sánh các hạng mục đã công bố, không cho phép suy rộng kết quả sang những tác vụ chưa được kiểm tra.
Một cách nói công bằng là:
Ở các hạng mục so sánh mà Anthropic công bố, Haiku 5.5 đạt điểm cao hơn GPT-6 Luna. Lựa chọn thực tế vẫn cần cân nhắc loại tác vụ, giá, tốc độ và cách gọi mô hình.
Thay đổi thứ ba: nó đã sát Sonnet, nhưng các tầng mô hình vẫn còn đó
Khoảng cách giữa Haiku 5.5 và Sonnet 5.5 cũng mang thông tin riêng.
Trên GDPval-AA v2.1, Haiku 5.5 đạt 1620, Sonnet 5.5 đạt 1840. Trên AA-Briefcase, hai điểm số lần lượt là 1578 và 1824. Trên OSWorld, Haiku 5.5 đạt 72,4%, Sonnet 5.5 đạt 83,9%. Với Humanity's Last Exam không dùng công cụ, điểm số là 45,9% và 56,9%; khi dùng công cụ là 57,4% và 64,5%.
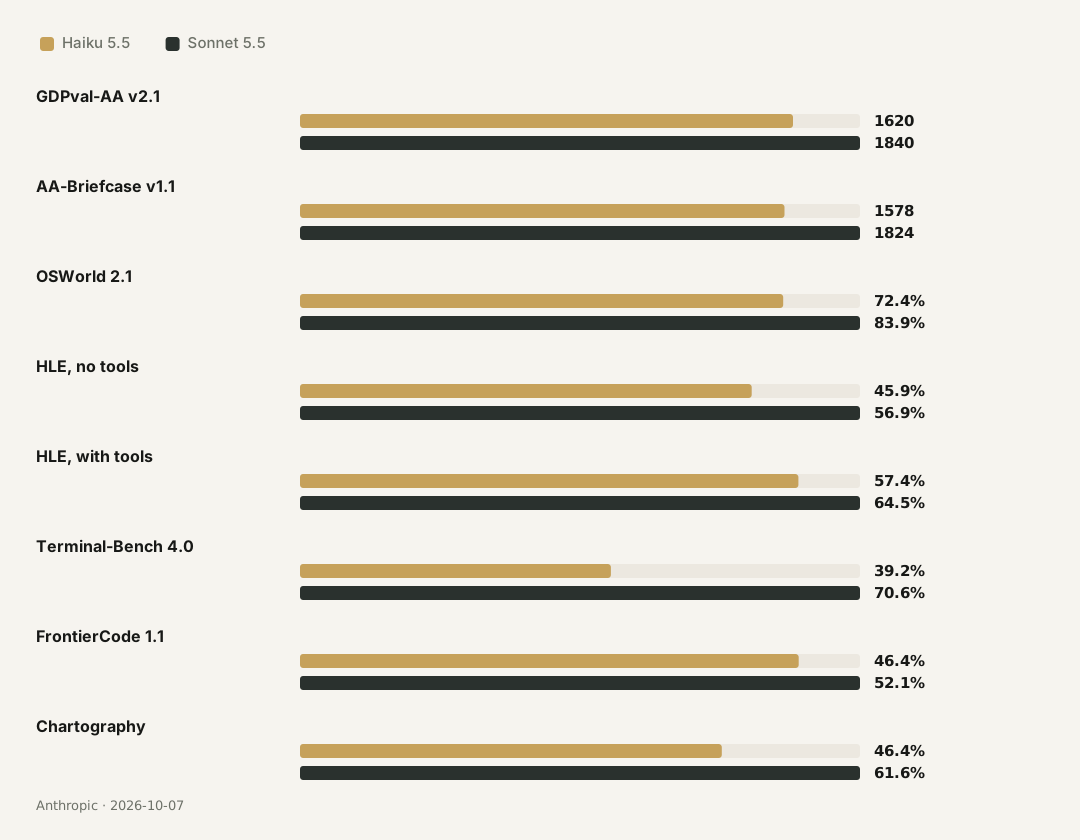
Những khoảng cách này cho thấy Haiku 5.5 đã xử lý được một phần đáng kể công việc tri thức và thao tác máy tính. Khi độ phức tạp tăng lên, Sonnet 5.5 vẫn giữ lợi thế ổn định.
Khoảng cách đáng chú ý nhất là Terminal-Bench: Haiku 5.5 đạt 39,2%, Sonnet 5.5 đạt 70,6%. Benchmark này yêu cầu mô hình hoàn thành các tác vụ chuyên môn phức tạp, nhiều bước trong môi trường dòng lệnh, gần với lập trình agent chạy dài. Ở đây Haiku 5.5 đã vượt xa Haiku 4.5, nhưng vẫn còn cách Sonnet 5.5 một quãng dài.
Điều đó vạch ra một ranh giới rõ ràng khi chọn mô hình:
- Với công việc cục bộ, lặp lại và kiểm chứng được, Haiku 5.5 rất hấp dẫn;
- Với tác vụ cần lập kế hoạch dài hạn, sửa đổi trên nhiều tệp và liên tục khôi phục sau lỗi, Sonnet 5.5 vẫn phù hợp hơn;
- Điểm số gần nhau ở một vài benchmark không phải lý do để coi hai mô hình là hai mức giá của cùng một mô hình.
Sau khi giảm giá, con số cần nhìn là chi phí cho mỗi tác vụ
Giá là trọng tâm còn lại của đợt phát hành này.
Với yêu cầu tối đa 100 nghìn token, Haiku 5.5 tính 0,10 USD cho mỗi triệu token đầu vào và 0,50 USD cho mỗi triệu token đầu ra. Trên 100 nghìn token, mức giá lần lượt thành 0,50 USD và 2,50 USD. Anthropic cho biết chi phí vận hành trung bình của Haiku 5.5 thấp hơn Haiku 4.5 khoảng 75%.
| Quy mô yêu cầu | Giá đầu vào | Giá đầu ra | Đọc cache |
|---|---|---|---|
| Tối đa 100 nghìn token | $0,10 / 1 triệu token | $0,50 / 1 triệu token | $0,01 / 1 triệu token |
| Trên 100 nghìn token | $0,50 / 1 triệu token | $2,50 / 1 triệu token | $0,05 / 1 triệu token |
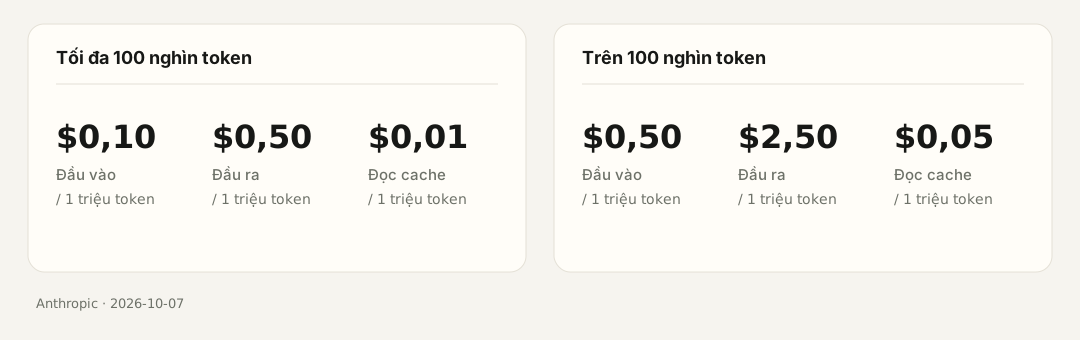
Nhìn bề ngoài, giá đầu vào trong phạm vi 100 nghìn token giảm từ 1 USD của Haiku 4.5 xuống 0,10 USD, còn giá đầu ra giảm từ 5 USD xuống 0,50 USD, tức đơn giá niêm yết giảm 90%. Nhưng Anthropic cũng cho biết Haiku 5.5 dùng tokenizer mới hơn, nên cùng một tác vụ có thể tiêu tốn nhiều token hơn một chút. Vì thế chi phí vận hành trung bình giảm khoảng 75%, chứ không phải tròn 90%.
Với một sản phẩm thực tế, vẫn phải trả lời thêm ba câu hỏi:
- Haiku 5.5 hoàn thành tác vụ ngay ở lần gọi đầu tiên với xác suất bao nhiêu?
- Khi thất bại thì cần thử lại mấy lần?
- Kết quả có còn cần Sonnet hoặc Opus rà soát và sửa lại không?
Thước đo hữu ích hơn là:
Chi phí mỗi tác vụ thành công
= tổng chi phí để hoàn thành công việc ÷ số tác vụ hoàn thành thành công
Giả sử một lần gọi Haiku 5.5 chỉ tốn một phần mười chi phí của Sonnet, nhưng tác vụ cần thử lại hai lần, hoặc 20% yêu cầu cuối cùng phải chuyển lên Sonnet. Khi đó mức tiết kiệm thực tế sẽ nhỏ hơn khoảng cách trên bảng giá.
Ngược lại, nếu một tác vụ có thể kiểm tra tự động và thất bại có thể thử lại với chi phí thấp, Haiku 5.5 có thể có lợi thế kinh tế rất lớn.
Vượt quá 100 nghìn token, ranh giới giá sẽ thay đổi kiến trúc sản phẩm
Trên bảng giá của Haiku 5.5, 100 nghìn token là một đường phân chia thực sự.
Với yêu cầu ngắn và trung bình, mức giá thấp dễ dàng phát huy tác dụng. Nhưng kho mã nguồn, hội thoại dài, cơ sở tri thức doanh nghiệp và các bộ tài liệu lớn thường xuyên tiến sát hoặc vượt 100 nghìn token. Nhồi tất cả vào một yêu cầu chưa chắc đã là thiết kế tốt nhất.
Một kiến trúc hợp lý hơn thường làm năm việc:
- Dùng Haiku 5.5 trước để phân loại tài liệu và lọc theo mức độ liên quan;
- Nén tài liệu gốc thành bản tóm tắt có cấu trúc;
- Chỉ gửi những đoạn liên quan đến câu hỏi hiện tại cho mô hình lớn hơn;
- Dùng cache cho ngữ cảnh lặp lại;
- Lưu hội thoại nhiều lượt dưới dạng trạng thái có thể truy xuất, thay vì gửi lại toàn bộ mỗi lần.
Đây cũng là chỗ Haiku 5.5 gắn chặt nhất với kiến trúc agent. Nó không chỉ là một mô hình rẻ để trả lời câu hỏi, mà còn có thể làm lớp nền cho việc nén ngữ cảnh, sắp xếp kết quả truy xuất và thực thi tác vụ con.
Thiết lập effort khiến bảng xếp hạng tĩnh kém hữu dụng hơn
Haiku 5.5 là mô hình Haiku đầu tiên có thiết lập effort (mức nỗ lực suy luận) điều chỉnh được. Với cùng một mô hình, hệ thống có thể chi nhiều hay ít cho suy luận tùy theo mức độ quan trọng của tác vụ, và cân đối giữa chất lượng, độ trễ và chi phí.
Điều này thay đổi cách đọc benchmark. Một điểm số đơn lẻ chỉ cho biết mô hình hoạt động thế nào trong một cấu hình. Một đường cong chi phí–chất lượng mới cho biết nó hoạt động ra sao với các mức ngân sách khác nhau.
Tác vụ đơn giản có thể dùng effort thấp hơn:
- Phân loại;
- Chuyển đổi định dạng;
- Trích xuất các trường cố định;
- Viết lại văn bản ngắn.
Tác vụ ở mức trung bình có thể nâng effort:
- Tóm tắt tài liệu dài;
- Tổng hợp thông tin qua nhiều đoạn;
- Thao tác nhiều bước trong trình duyệt;
- Tác vụ cần phán đoán trước rồi mới gọi công cụ.
Nâng effort cho tác vụ khó không tự động thay thế được Sonnet. Khoảng cách ở Terminal-Bench là lời nhắc: ngân sách suy luận lớn hơn có thể cải thiện kết quả, nhưng không xóa được khoảng cách về lập kế hoạch dài hạn, khôi phục lỗi và chuỗi công cụ phức tạp.
Chuyển các con số thành một bảng định tuyến thực tế
Tổng hợp điểm chính thức và định vị sản phẩm, có thể rút ra một bảng định tuyến ban đầu khá thận trọng:
| Tác vụ | Lựa chọn mặc định | Lý do |
|---|---|---|
| Phân loại, định tuyến, gắn nhãn | Haiku 5.5 | Khối lượng lớn, đầu ra có cấu trúc rõ, dễ kiểm tra |
| Trích xuất trường và làm sạch dữ liệu | Haiku 5.5 | Ranh giới tác vụ rõ ràng, phù hợp xử lý đồng thời cao |
| Tóm tắt và nén ngữ cảnh | Haiku 5.5 | Lợi thế lớn về giá và tốc độ |
| Thao tác trình duyệt một bước hoặc quy trình ngắn | Haiku 5.5 | Điểm OSWorld cho thấy năng lực thao tác máy tính tăng rõ |
| Giải thích mã thông thường và sửa lỗi nhỏ | Haiku 5.5 hoặc Sonnet 5.5 | Tùy vào việc có kiểm thử tự động hay không và cái giá của sai sót |
| Sửa đổi trên nhiều tệp | Sonnet 5.5 | Terminal-Bench vẫn cho thấy khoảng cách rõ rệt |
| Lập trình agent chạy dài | Sonnet 5.5 hoặc Opus 5.5 | Cần lập kế hoạch liên tục và khôi phục lỗi |
| Rà soát cuối cùng và phán đoán rủi ro cao | Sonnet 5.5 hoặc Opus 5.5 | Cần độ ổn định cao hơn và suy luận mạnh hơn |
Bảng này không phải định nghĩa vĩnh viễn về “giới hạn của Haiku 5.5”. Nó chỉ là bộ gợi ý đầu tiên khi đặt benchmark chính thức, giá và vai trò sản phẩm vào cùng một chỗ.
Khi triển khai thật, bạn vẫn phải kiểm tra trên chính tác vụ của mình:
- Đầu ra có đạt chuẩn nghiệp vụ không?
- Thất bại có được phát hiện tự động không?
- Thử lại sau thất bại có đáng tiền không?
- Độ trễ thấp hơn có thực sự cải thiện sản phẩm không?
- Giá rẻ có bị chi phí kiểm tra thủ công cao hơn ăn mất không?
Nên đọc benchmark chính thức như thế nào
Với benchmark của một mô hình mới, có hai sai lầm rất dễ mắc.
Sai lầm thứ nhất là gộp mọi hạng mục thành một thứ hạng tổng. Công việc tri thức, thao tác máy tính, suy luận mở và lập trình agent là những năng lực khác nhau; một tổng điểm không thể đại diện cho tất cả.
Sai lầm thứ hai là coi điểm chính thức như kết luận cho môi trường production. Benchmark chính thức có cấu hình kiểm tra cụ thể, còn sản phẩm thực tế chịu thêm ảnh hưởng từ prompt, công cụ, ngữ cảnh, mạng, dữ liệu và cơ chế khôi phục lỗi.
Một cách đọc đáng tin cậy hơn gồm ba bước.
Trước hết, xem bước nhảy năng lực
Haiku 5.5 có cải thiện ổn định so với Haiku 4.5 không? Theo bảng chính thức thì có, đặc biệt ở OSWorld, công việc tri thức và các hạng mục lập trình agent.
Tiếp theo, xem ranh giới tác vụ
Nó đã đuổi kịp mô hình lớn hơn chưa? Câu trả lời tùy tác vụ. Ở một số công việc tri thức và thao tác máy tính, nó đã tiến sát Sonnet; ở lập trình agent phức tạp, khoảng cách vẫn còn rõ.
Cuối cùng, xem chi phí đơn vị
Có đáng dùng hay không phụ thuộc đồng thời vào chất lượng, giá, độ trễ và khả năng khôi phục sau thất bại. Chỉ riêng điểm benchmark không thể trả lời việc một sản phẩm có nên chuyển mô hình hay không.
Nhận định cuối cùng: Haiku 5.5 mạnh vì có thể dùng ở quy mô lớn
Nếu câu hỏi chỉ là Haiku 5.5 có vượt Sonnet 5.5 hay không, câu trả lời rất đơn giản: không. Dữ liệu chính thức đã cho thấy Sonnet 5.5 vẫn dẫn trước ở công việc tri thức, thao tác máy tính, suy luận tổng quát và lập trình agent.
Nếu câu hỏi chỉ là Haiku 5.5 có mạnh hơn Haiku 4.5 hay không, câu trả lời cũng rõ ràng: có, và mức tăng rất lớn.
Câu hỏi đáng bàn là câu thứ ba: nó đã đủ mạnh để đảm nhận một lượng lớn công việc cục bộ trong các hệ thống production hay chưa?
Dựa trên điểm chính thức và mức giá, câu trả lời nhiều khả năng là có.
Giá trị của Haiku 5.5 nằm ở chỗ một loạt tác vụ trước đây cần mô hình cỡ trung, nhưng lại không đáng trả giá của mô hình cỡ trung, nay có thể đặt vào một lớp thực thi nhanh hơn và rẻ hơn. Phân loại, trích xuất, tóm tắt, nén ngữ cảnh, thao tác trình duyệt ngắn và tác vụ con của agent đều có thể trở thành sân khấu chính của nó.
Đây không phải bảng điểm của một “nhà vô địch bảng xếp hạng mô hình” mới, mà là bảng điểm về cách phân công công việc:
- Haiku 4.5 chứng minh rằng mô hình nhỏ có thể làm việc đơn giản với chi phí thấp;
- Haiku 5.5 bắt đầu chứng minh rằng mô hình nhỏ cũng có thể đảm nhận một phần công việc cần công cụ và nhiều bước;
- Sonnet 5.5 vẫn phụ trách việc lập kế hoạch, lập trình và công việc tri thức phức tạp hơn;
- Opus 5.5 tiếp tục xử lý các tác vụ chạy dài, độ khó cao và có cái giá của sai sót đắt đỏ.
Trọng tâm của việc đánh giá mô hình cũng đang dịch chuyển, từ “ai có điểm cao nhất” sang “ai đáng được gọi nhất cho tác vụ nào”.


