
Điều đáng chú ý ở Kimi K3.1 Pro là liệu nó có theo được một tác vụ dài đến cùng hay không: hiểu dự án, sửa code, gọi công cụ, rồi dựa vào phản hồi thất bại để tiếp tục sửa. Một màn hình đầu tiên đẹp mắt chỉ là một phần nhỏ trong đó. Với lập trình viên, câu hỏi giá trị hơn là: sau lần sửa thứ mười, các tính năng ban đầu có còn chạy không, và sản phẩm bàn giao có qua được nghiệm thu không?
Các mẫu chính thức được bàn trong bài là Kimi K3.1 Pro và biến thể tốc độ cao Kimi K3.1 Pro Highspeed. Tài liệu được đối chiếu đến ngày 23 tháng 10 năm 2026; các con số lấy từ tài liệu công khai chính thức. Trong đợt này, Folkbench không gọi mô hình, không chạy lại benchmark và cũng không đưa ra điểm đánh giá độc lập mới nào cho nó.
Trước hết, nhận diện đúng mô hình
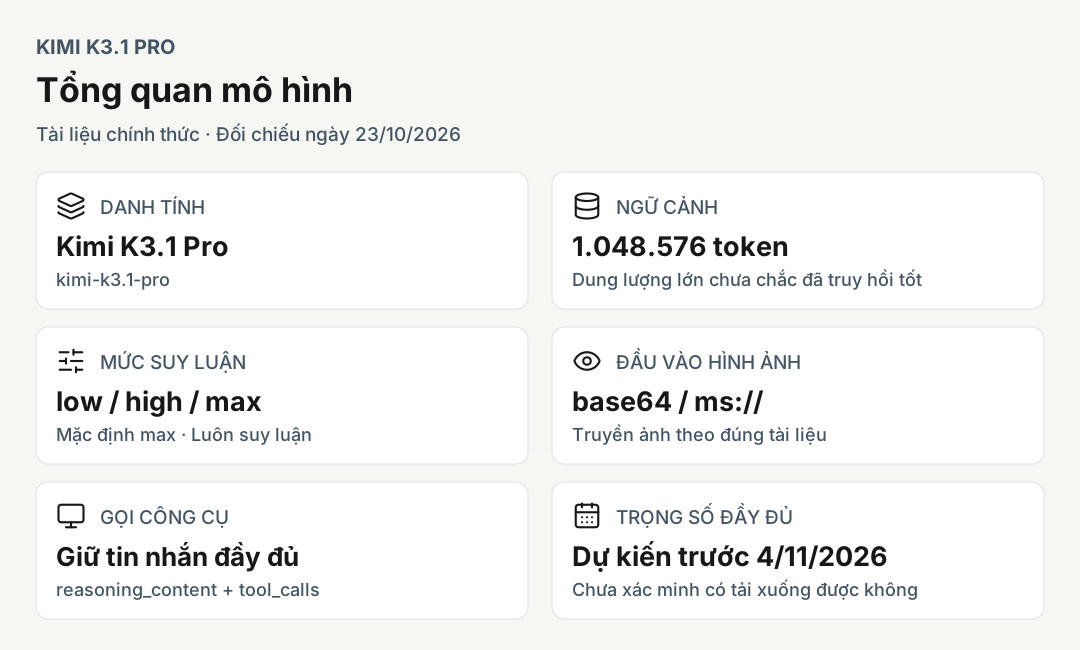
| Mục | Kết quả đối chiếu |
|---|---|
| ID API tiêu chuẩn | kimi-k3.1-pro |
| ID API tốc độ cao | kimi-k3.1-pro-highspeed |
| Định vị chính thức | Mô hình chủ lực cho lập trình, sáng tạo 3D và nghiên cứu tài chính |
| Mô tả quy mô | Cấp 3T; không thể từ đó suy ra mỗi yêu cầu kích hoạt bao nhiêu tham số |
| Cửa sổ ngữ cảnh | 1.048.576 token |
| Mức suy luận | low, high, max; mặc định max |
| Hình ảnh và công cụ | Đầu vào hình ảnh, gọi công cụ, đầu ra dạng luồng |
| Tình trạng trọng số | Blog kỹ thuật dự kiến công bố trọng số đầy đủ trước ngày 4 tháng 11 năm 2026; bài này chưa xác minh khả năng tải xuống |
Tên mẫu và định vị xem tại danh sách mô hình chính thức, con số ngữ cảnh chính xác xem tại tài liệu tính phí, năng lực giao diện API xem tại hướng dẫn tích hợp. Blog kỹ thuật chính thức mô tả đây là phiên bản hậu huấn luyện (post-training) của K3 và đưa ra kế hoạch công bố trọng số. Vì vậy, không nên chỉ dựa vào số phiên bản để suy ra rằng kiến trúc nền đã thay đổi, cũng không nên viết kế hoạch mở trọng số thành “đã có thể triển khai cục bộ”.
Hai benchmark, trả lời hai câu hỏi khác nhau
Bảng và hình dưới đây dùng cùng một bộ số liệu đối chiếu được đăng trên blog kỹ thuật của Kimi. Số liệu của các đối thủ cũng lấy từ trang đó, không phải kết quả Folkbench đo lại trong một môi trường thống nhất.
| Hạng mục | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% |
| BenchCAD, có dùng công cụ, Voxel IoU | 92,7% | 96,2% | 95,9% |
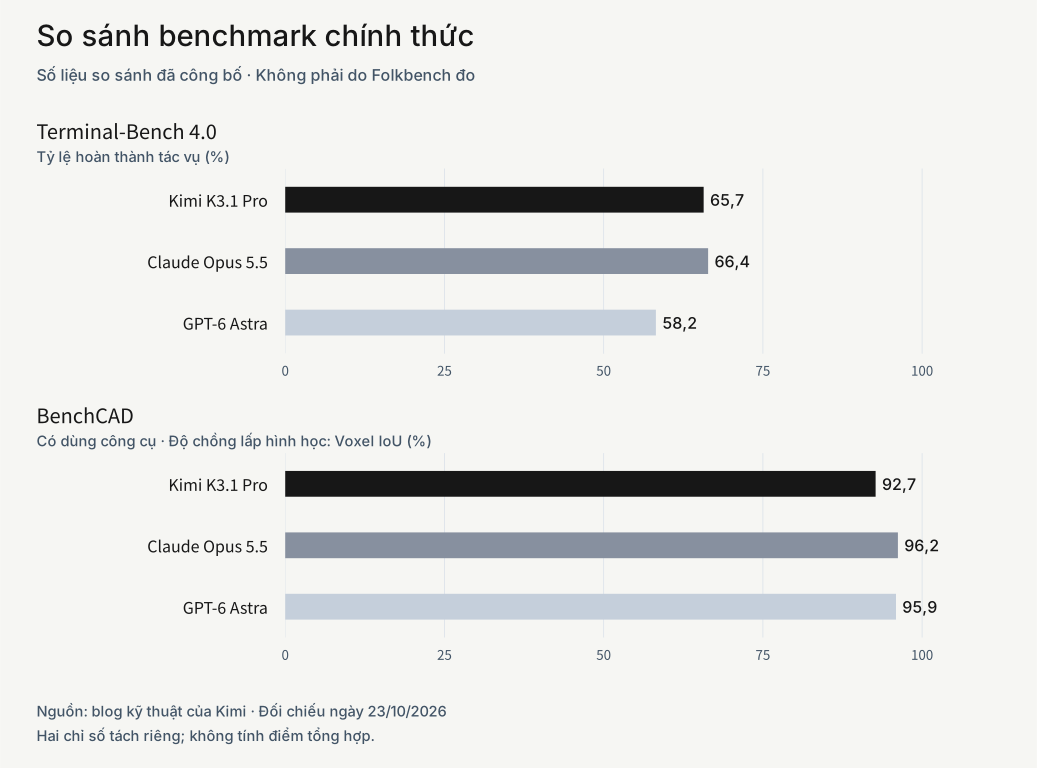
Chú thích chính thức mặc định dùng mức suy luận max; lượt chạy Terminal-Bench của Kimi dùng khung thực thi Claude Code, còn cột đối thủ được tổng hợp từ tài liệu phát hành hoặc bảng xếp hạng. BenchCAD kiểm tra các mô hình mở trên một tập con 1.000 mẫu, và chế độ dùng công cụ cũng chạy qua Claude Code. Những điều kiện này cần được giữ lại cùng với các con số.
Lập trình tác vụ dài: điểm số sát nhau vẫn chưa thay được nghiệm thu dự án
65,7% và 66,4% chênh nhau 0,7 điểm phần trăm. Điều đó cho thấy kết quả trong bảng chính thức này khá sát nhau, nhưng khi chưa có cùng ngân sách chạy, số lần lặp lại và khoảng bất định, không thể viết thành “năng lực ngang nhau”. Tương tự, cao hơn một mô hình khác ở một điểm số riêng lẻ cũng không đủ để suy ra mạnh hơn ở mọi tác vụ lập trình.
Với dự án thực tế, điều đáng quan sát hơn là khả năng phục hồi sau lỗi. Một tác vụ có thể đòi hỏi sửa giao diện API, cập nhật các nơi gọi, giữ hành vi tương thích, và không được làm hỏng tính năng sẵn có. Lần đầu mô hình sinh ra bao nhiêu code không trả lời được những câu hỏi này. Mô hình cần hiểu bài kiểm thử thất bại thực sự đang chỉ ra điều gì, thay vì xóa assertion, nới lỏng điều kiện hay bỏ qua tính năng để “ép” cho qua.
Nếu định đưa nó vào quy trình viết code, bạn có thể chọn một tác vụ cũ đã giải quyết xong, có tiêu chí nghiệm thu rõ ràng, rồi chạy lại: cố định phiên bản kho mã và yêu cầu, để từng mô hình ứng viên tự xử lý, sau đó đối chiếu kết quả kiểm thử, phạm vi thay đổi và khối lượng phải sửa tay. Bản ghi như vậy giúp quyết định có nên chuyển đổi hay không tốt hơn ấn tượng “trông có vẻ viết giỏi”. Đây là cách nghiệm thu được đề xuất, không phải thí nghiệm mà bài này đã thực hiện.
3D: hình học gần đúng chưa có nghĩa là sản phẩm đã bàn giao được
Dòng BenchCAD đo Voxel IoU. Không thể diễn giải 92,7% thành “92,7% tác vụ dựng hình thành công”, càng không thể coi đó là điểm chất lượng nghệ thuật. Tái tạo hình học với vật liệu, ánh sáng, hoạt ảnh, khả năng chỉnh sửa và dung sai chế tạo là những bài toán nghiệm thu khác nhau.
Nếu dùng cho cảnh Three.js trên web, việc nghiệm thu nên gồm: tương tác có hoạt động không, chạy có mượt trên thiết bị không, tài nguyên có tải được không. Nếu dùng cho chi tiết có thể chỉnh sửa, nên kiểm tra quan hệ kích thước, hình dạng sau khi đổi tham số và tệp xuất ra. Một góc render đẹp vẫn có thể che đi lỗ hổng ở mặt sau, các khối đâm xuyên nhau hay topology không dùng được.
Từ hai số liệu chính thức này, nhận định biên tập của Folkbench là: nó xứng đáng vào danh sách ứng viên cho các tác vụ lập trình dài và dựng hình bằng code. Còn có thay được giải pháp hiện tại hay không thì phải do kết quả bàn giao của dự án mục tiêu quyết định.
Ngữ cảnh một triệu token: dung lượng chỉ giải quyết chuyện có chứa vừa hay không
1.048.576 token chứa được bao nhiêu tệp thực tế còn tùy vào nội dung và cách tách token; đó không phải là một số chữ hay số dòng code cố định. Quan trọng hơn, dung lượng không tự động bảo đảm mô hình tìm đúng bằng chứng, nhớ được các ràng buộc trước đó, hay vẫn bám theo mục tiêu ban đầu sau hàng chục lượt gọi công cụ.
Với dự án lớn, nhét cả kho mã vào một yêu cầu có thể tiện, nhưng cũng kéo theo tệp sinh tự động, tài liệu lỗi thời và những chỉ dẫn mâu thuẫn nhau. Đầu vào tốt nên nêu rõ phiên bản hiện tại, tệp mục tiêu, những hành vi không được thay đổi và điểm vào nghiệm thu. Thứ mô hình cần là ngữ cảnh dùng được, không chỉ là nhiều ngữ cảnh hơn.
Tác vụ nhiều lượt còn có một khoản chi phí dễ bị bỏ qua. Tài liệu mô hình suy nghĩ chính thức yêu cầu giữ lại nội dung suy luận trong các tin nhắn assistant trước đó; phần này tiếp tục chiếm ngữ cảnh và bị tính phí. Một câu trả lời trông ngắn không có nghĩa là cả lượt chạy tiêu tốn ít token.
Tích hợp API: chỉ vài tham số cũng đủ thay đổi trải nghiệm
Tài liệu về mức độ suy luận cho biết K3.1 Pro luôn suy luận, với mức mặc định là max. low chỉ là giảm mức suy luận, không phải tắt suy nghĩ. Khi so sánh tốc độ, hãy căn chỉnh tham số này trước; nếu không, kết quả “chậm hơn” có thể chỉ là do dùng ngân sách khác nhau.
Khi chuyển đổi, có ba điểm đáng kiểm tra riêng:
- Dùng
reasoning_effortở cấp cao nhất, không chép nguyên cấu hìnhthinkingcủa K2. - Trong các lượt gọi công cụ nhiều vòng, giữ nguyên toàn bộ tin nhắn assistant, gồm cả
reasoning_contentvàtool_calls. Nếu chỉ giữ phần văn bản cuối cùng, bạn sẽ đánh mất phần lịch sử mà API yêu cầu. - Đầu vào hình ảnh dùng base64 hoặc tham chiếu tệp
ms://theo hướng dẫn tích hợp; đừng mặc định rằng URL ảnh công khai bất kỳ đều truyền thẳng vào được.
Nếu đi qua trạm trung chuyển, cần kiểm tra thêm: các trường trong yêu cầu có được giữ nguyên không, phản hồi có bị cắt không, tên mô hình có bị ánh xạ sang tên khác không, và trường usage có đầy đủ không. API mô hình trả lời bình thường không có nghĩa là vòng lặp công cụ của agent phía trên đã hoạt động đúng.
Chi phí: tính cho trọn một tác vụ trước, rồi mới bàn đến hiệu quả chi phí
Trang giá chính thức và bản Markdown của nó trong lần truy xuất này không trả về một dòng đơn giá đầy đủ, có thể đối chiếu cho K3.1 Pro. Vì vậy, bài này không ghi đơn giá bằng USD, cũng không mượn giá của K3 hay của trạm trung chuyển bên thứ ba. Kết quả kiểm chứng này không có nghĩa là phía chính thức chắc chắn chưa công bố giá; nó chỉ có nghĩa là bài này không đủ bằng chứng để đưa một con số nào đó vào bảng giá.
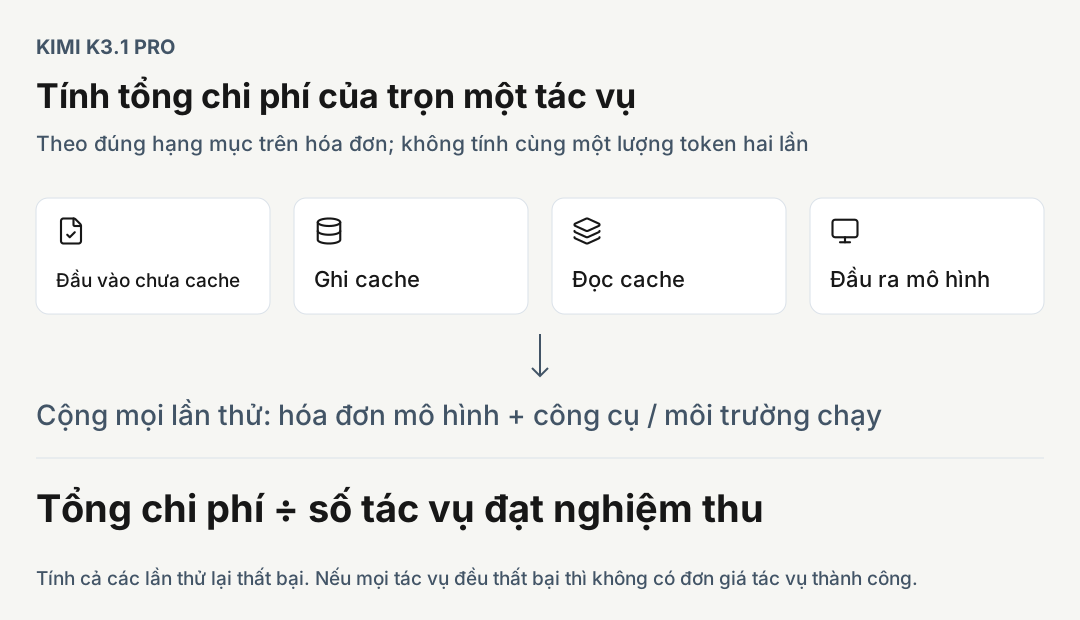
Điều có thể đối chiếu được là cấu trúc tính phí: API tính phí theo mức dùng, tách biệt với gói thành viên Kimi và Kimi Code; ghi cache phân theo TTL, còn đọc khi trúng cache và đầu vào chưa cache được tính riêng. Hướng dẫn tích hợp mô tả giá không chia bậc theo độ dài ngữ cảnh. Tài liệu cache là nơi để đối chiếu quy tắc tái sử dụng và thời hạn hiệu lực.
Điều đó có nghĩa là tác vụ ngữ cảnh dài cần được tách ra để xem: phần đầu vào nào không trúng cache, phần nào kích hoạt ghi cache, phần nào tính theo giá đọc cache, và cuối cùng sinh ra bao nhiêu đầu ra. Dịch vụ công cụ, môi trường chạy và các lần thử lại thất bại cũng có thể làm tăng tổng chi phí. Khi tính, hãy theo đúng hạng mục thực tế trên hóa đơn, tránh tính cùng một lượng token vào nhiều hạng mục.
Một chỉ số phù hợp cho thảo luận mua sắm và chuyển đổi là: tổng chi phí của loạt tác vụ ÷ số tác vụ đạt nghiệm thu. Các lần thử thất bại vẫn nằm trong tử số; nếu mọi tác vụ đều thất bại thì không có đơn giá tác vụ thành công nào để báo cáo. Đây là cách so sánh mà bài này đề xuất, không phải kết quả Folkbench đã đo.
Danh sách mô hình chính thức mô tả Highspeed là biến thể giữ nguyên năng lực, với tốc độ khoảng 2–3 lần. Đây là tuyên bố của nhà cung cấp, không thể quy đổi thẳng thành “cả quy trình nhanh gấp 2–3 lần”. Nếu phần sinh của mô hình chỉ chiếm một nửa tổng thời gian, thì dù nửa đó rút xuống còn một phần ba, tổng thời gian cũng chỉ giảm từ 1 xuống khoảng 0,67, tức nhanh hơn khoảng 1,5 lần. Đây là phép tính giả định để minh họa điểm nghẽn, không phải độ trễ đo thực tế của Kimi.
Những tác vụ nên thử trước
| Loại công việc | Năng lực đáng quan sát | Kết quả chỉ có ý nghĩa khi qua nghiệm thu |
|---|---|---|
| Sửa code trên nhiều tệp | Giữ ràng buộc, dùng công cụ, phục hồi sau lỗi | Kiểm thử đạt, tính năng cũ được giữ, khối lượng sửa tay chấp nhận được |
| 3D bằng code và tương tác web | Quan hệ không gian, sinh script, chỉnh sửa lặp | Tệp chỉnh sửa được, tương tác hoạt động, hiệu năng chạy đạt yêu cầu |
| Nghiên cứu nhiều tài liệu và phân tích bảng tính | Định vị bằng chứng, đối chiếu chéo giữa các tài liệu | Trích dẫn truy được nguồn, đơn vị nhất quán, phép tính kiểm tra lại được |
| Trích xuất đơn giản hoặc phân loại tần suất cao | Độ trễ và chi phí mỗi tác vụ | Cùng ngưỡng chất lượng mà ngân sách tốt hơn giải pháp hiện tại |
Ba loại đầu phù hợp với định vị chính thức của nó, nhưng định vị không phải là bảo đảm chất lượng. Đặc biệt với tác vụ nghiên cứu, văn phong trôi chảy hay số lượng trích dẫn đều không thay được việc kiểm tra từng mục: nguồn có thật sự ủng hộ kết luận không, năm và đơn vị có nhất quán không, công thức trong bảng tính có tính lại được không. Với phân loại đơn giản, một mô hình chủ lực mặc định chạy ở max chưa chắc là lựa chọn kinh tế nhất.
Nhận định của Folkbench
Tài liệu chính thức của Kimi K3.1 Pro đưa ra những tín hiệu năng lực đáng được kiểm chứng nghiêm túc: cả lập trình tác vụ dài lẫn dựng hình bằng code đều đã vào nhóm đối chiếu ở trình độ cao. Giá trị thực tế của nó phụ thuộc vào việc các năng lực này có ổn định chuyển hóa thành sản phẩm bàn giao đạt nghiệm thu với đầu vào, công cụ và ngân sách của bạn hay không.
Hiện bài này vẫn thiếu bản ghi gọi API của riêng mình, thí nghiệm lặp lại, phân bố lỗi và đơn giá có thể đối chiếu, nên ở đây không công bố điểm tổng hợp, cũng không đưa ra kết luận “hiệu quả chi phí tốt nhất”. Một số đoạn benchmark trong hướng dẫn tích hợp vẫn còn chỗ giữ chỗ (placeholder) và có cách diễn đạt khác phiên bản so với blog kỹ thuật; hai con số trong bài này chỉ lấy từ bảng đối chiếu trên cùng một trang blog kỹ thuật, không ghép số liệu của các phiên bản khác nhau.
Nếu bạn đang đánh giá quy trình viết code, có thể đọc tiếp [hướng dẫn đánh giá kỹ thuật phần mềm của Folkbench](/vi/blog/ai-api-relay-software-engineering-evaluation-guide). Để so sánh phạm vi tài liệu của các mô hình khác, có thể tham khảo [Claude Opus 5.5](/vi/blog/claude-opus-5-5-review-pricing) và [GPT-6.1 Sol](/vi/blog/gpt-6-1-sol-review-pricing); mô hình sau không phải GPT-6 Astra trong bảng trên, không được dùng lẫn tên mẫu và điểm số của hai mô hình.


