一次出包能證明模型犯過錯,卻無法單獨證明它比以前更容易出錯。
「這個模型是不是又變笨了?」一隻腳懸在踏板外的鵜鶘、一輛車架扭成麻花的腳踏車,再配上一張上週畫得相當漂亮的截圖,就足以讓人冒出這個疑問。
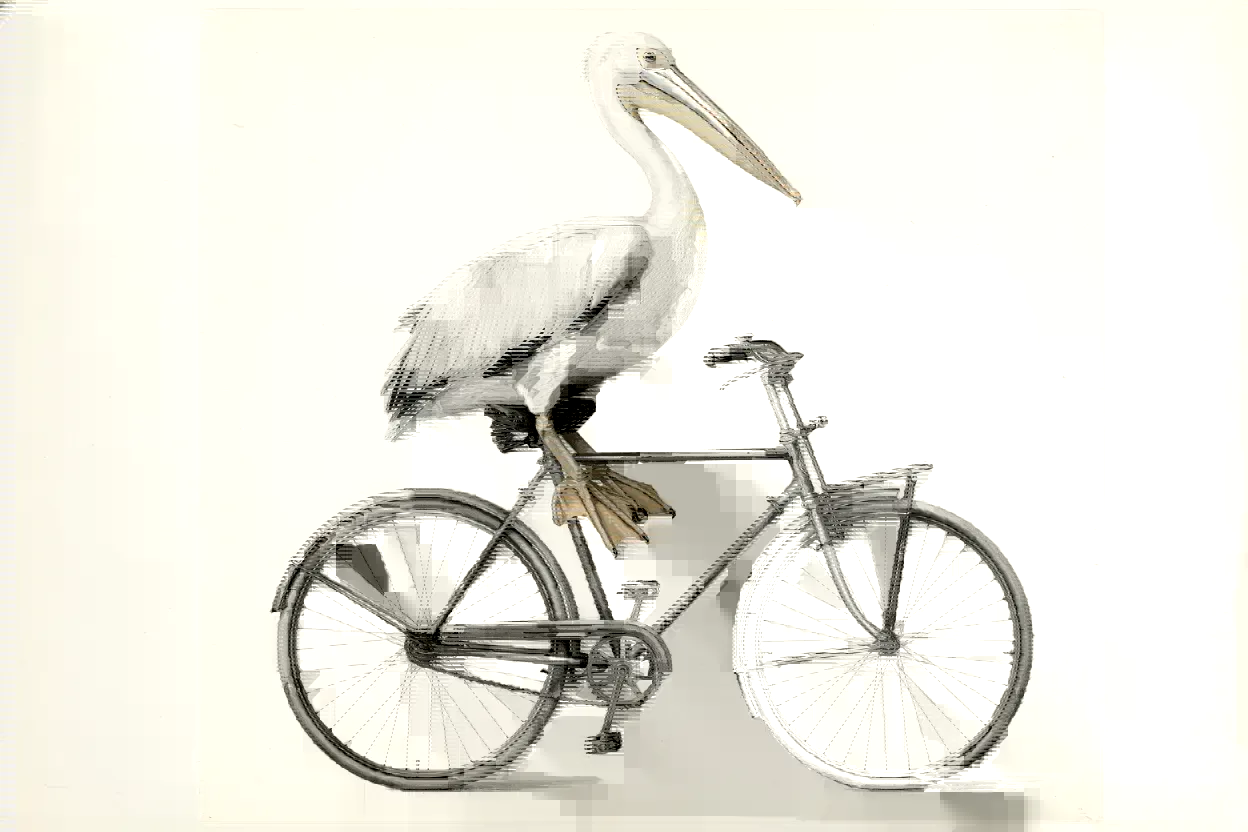
這種懷疑不該被一句「模型本來就有隨機性」打發掉。使用者付了錢,原本能完成的任務現在做不好,當然值得追問。但反過來說,兩張截圖也不足以證明模型被換掉、思考預算被砍,或者某個管道一定「摻了水」。
前陣子,我反覆跑了幾十次鵜鶘測試。這道題有意思的地方,在於它把很多錯誤直接畫了出來:程式碼能執行,不代表腳踏車的結構正確;鳥和車都畫齊了,也不代表腳真的踩在踏板上。比起一段看似流暢、卻可能藏著邏輯漏洞的回答,這些空間關係更容易用肉眼發現。但跑得越多,越會意識到另一件事:我們常常在用一件作品,評價一整套服務。
本文不打算替任何模型開脫,也不想教人憑幾個特徵揪出「假模型」。我更關心的是:當我們懷疑模型變差時,怎樣把這種感覺變成可以複查的證據?
說明:下文所有 A、B 管道及其測試數字都是教學範例,不對應任何真實服務,也不是 Folkbench 的實測排名。
一、先釐清:您說的「變笨」,究竟是哪一件事?
「變笨」這個說法很方便,卻把幾個不同的問題揉在了一起。最直接的一層是:這一次,答案確實錯了。鵜鶘多長了一條腿、腳沒有踩住踏板、腳踏車的輪子和車架分了家。這些都是具體、可檢查的失敗。一個樣本就足以證明「這種錯誤發生過」,甚至足以推翻「它絕不會犯這種錯」的承諾。第二層是:在相同或足夠接近的條件下,這個服務更容易失敗了。
這時就不能只看錯誤是否存在,還得看它出現的頻率。過去多半能完成,現在多半做不好,才是我們平常所說的「體驗變差」中最值得測量的部分。第三層則是:造成變化的原因,是模型本身或伺服器端設定發生了某種改變。這已經進入原因判斷。同樣的壞結果,可以對應不同的解釋:請求參數不同、上下文不同、輸出被截斷,或者底層模型與推論設定真的變了。只看到結果,通常還無法把這些解釋唯一地區分開來。
因此,「這次錯了」「這家服務比較不可靠」「這家偷偷換了模型」,需要的證據強度並不相同。承認這個區別,不是在提高使用者投訴的門檻。恰恰相反,把問題定位清楚,才能避免服務供應商用「隨機性」解釋所有故障,也避免評測者用「偷換模型」解釋所有差異。
二、您看到的是一件作品,還是一組輸出的分布?
在使用隨機取樣的生成設定下,同一個輸入可能產生不同的輸出。即使採用某些控制重現性的手段,也不應把「盡量一致」直接理解成「絕對一致」。例如,OpenAI 的一份歷史技術說明就明確寫過:在相同的 seed、參數和後端指紋下,輸出仍不保證完全相同。這說明重現性有其邊界,並不代表如今所有模型都支援相同的參數。1
對鵜鶘測試來說,我們真正想知道的,往往不是「它能不能偶爾畫出一張好圖」,而是「在指定條件下,再把任務交給它一次,有多大機會得到合格的結果」。用一個簡化的例子,就能看出單張截圖的問題。假設某個服務真實的單次合格率是 80%,每次生成彼此獨立,測試期間狀態不變。那麼連續測試 20 次,至少出現一次失敗的機率是: 1 − 0.8²⁰ ≈ 98.85% 也就是說,一個多數時候都能做好的服務,在 20 次測試裡留下出包素材,幾乎是必然的。
反過來,假設另一個服務真實的單次合格率只有 40%。同樣在獨立、穩定的前提下,跑 20 次,至少得到一次合格結果的機率是: 1 − 0.6²⁰ ≈ 99.996% 它也幾乎一定能交出一張拿得出手的作品。這兩行計算不是在說所有真實呼叫都彼此獨立,也不是說真實合格率恰好就是這些數字。它們只是揭示一個選擇問題:只展示最好的一次,很容易高估可靠性;只展示最差的一次,也很容易誇大退化的程度。
因此,同一個服務完全可能同時出現在「火力全開鐵證」和「變笨鐵證」的貼文裡。截圖都是真的,推論卻未必成立。這裡還有一個容易被忽略的區別:一次生成就成功,和生成十次再挑出一次成功,不是同一種能力指標。後者包含額外的呼叫、等待和挑選成本。若要比較兩種工作流程,就應讓雙方擁有相同的嘗試預算,而不是拿 A 的第一次,去和 B 的精選集比較。
三、跑到 20 次,差異就自動具有統計意義了嗎?
不會。20 次可以是一筆合理的實驗預算,但不是統計學上的通行證。還是看那個直觀的例子:A 管道跑了 20 次,16 次合格;B 管道跑了 20 次,8 次合格。雙方使用同一道固定題目、相同的評分標準,樣本全部保留。
| 管道 | 合格次數 / 總次數 | 樣本合格率 | 合格率的 95% Wilson 信賴區間 |
|---|---|---|---|
| A | 16 / 20 | 80% | 58.4%–91.9% |
| B | 8 / 20 | 40% | 21.9%–61.3% |
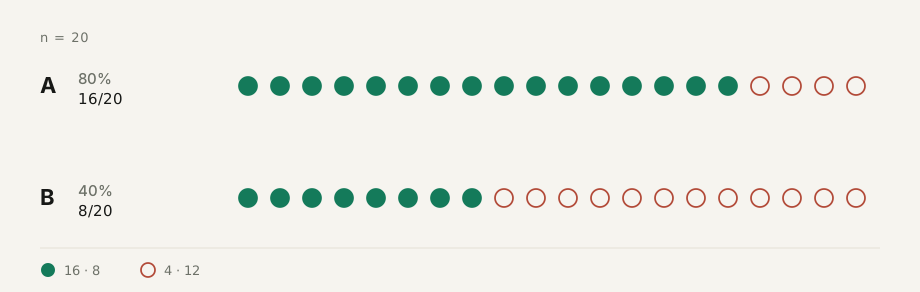
區間依二項比例的 Wilson 方法計算,用來表達合格率估計的不確定性,不是畫面品質的分數範圍。2 首先可以確定,樣本中的差異是 40 個百分點。其次也要看到,兩邊各只有 20 次,估計仍然不夠精細:不能把 80% 和 40% 當成已經測準、永遠不變的真實能力。
若進一步假定每次呼叫彼此獨立、每個管道在該時段內的合格機率穩定,而且這是事先決定的一次比較,對上面「合格/不合格」的次數做雙尾 Fisher 精確檢定,會得到 p ≈ 0.0225。以事先採用的 5% 顯著水準來看,這組範例支持「兩者在該條件下的合格率存在差異」。3 但這個數字不代表「B 有 97.75% 的機率摻水」,也不代表「A 有 97.75% 的機率永遠比較好」。p 值描述的是:在「無差異」假設及相應的檢定條件下,出現如此極端或更極端資料的機率,而不是某種幕後原因的機率。3
也不要用上表兩個區間是否重疊來代替差異檢定;它們分別估計兩個合格率,檢定的對象卻是兩者之間的差異。比起記住一種檢定方法,更重要的是記住三個邊界。差距大小和樣本數要一起看。 16 比 8,與 16 比 15,不該得出同樣強度的結論。需要多少樣本,取決於您希望辨識多小的差距,以及願意承擔多大的誤判風險。沒有一個適用於所有任務的「至少要跑幾次」。
沒有測出顯著差異,不等於證明兩者一樣。 資料也可能只是太少、太不穩定,還不足以下結論。要證明差異小到可以忽略,需要事先定義「多小才算可以忽略」,而不是把一個不顯著的結果當成等效的證明。統計上有差異,也不等於實際上值得換服務。 對使用者而言,還要考慮失敗的代價、呼叫價格、延遲和重工成本。一個可靠的差異,仍然可能小到不影響選擇。統計在這裡的作用,不是產出一個看起來很專業的 p 值,而是阻止我們把證據說得比它本身更強。
四、Baseline 不是一句「Prompt 一樣」,而是一份實驗契約
很多對照測試的問題,並不出在樣本不夠,而是樣本從一開始就無法比較。同樣輸入「畫一隻騎腳踏車的鵜鶘」,一邊是在全新的工作階段中呼叫 API,另一邊是在已經聊了幾十輪、還啟用了工具的聊天視窗裡生成;一邊允許較長的輸出,另一邊中途就碰到長度上限。這樣的結果即使重複一百次,也不能直接歸結為模型能力的差異。
OLMES 評測標準的研究指出,提示格式、上下文範例和任務表述等評測選擇,都會改變測得的表現;可重現的比較,需要把這些設定明確記錄下來。它研究的具體任務並不等同於鵜鶘 SVG,但對實驗設定的提醒同樣值得借鏡。4 我的建議是,把 baseline 理解為一份「這次究竟在測什麼」的契約。
比較的對象要具體到服務、群組或路由,以及實際能取得的模型版本。如果只有一個會隨時間變化的模型別名,就記錄別名;不知道底層快照,就寫「未知」。不要把 API 回傳的型號字串,當成底層身分已經獲得獨立驗證。輸入要盡量完整儲存:不只是最後一句 Prompt,還包括您能夠控制和觀察到的系統提示詞、歷史上下文、附件與工具設定。可見條件一致,不代表不可見條件也已被證明一致。
生成設定要記錄思考強度、輸出上限,以及 API 實際支援的取樣參數。不支援的欄位寫「不支援」,無法確認是否生效的欄位寫「未知」,不要悄悄當成一致。不同模型裡同名的「high」,也不應預設代表相同的運算預算。
評測環境則包括渲染方式和評分標準。同一份 SVG 要在相同的檢視區與渲染環境下檢查;動畫題要依約定的觀察時段檢查,不能一邊看完整動作,另一邊只挑一個影格。如果題目沒有要求動畫,也不應因為輸出是靜態圖而扣分。最後,重試規則必須在測試之前寫好。首次失敗後能不能重試、重試幾次、是否給予回饋,都屬於測試條件,而不是臨場發揮。
固定這些東西,並不是為了打造一個脫離現實的「實驗室模型」。您完全可以比較兩個聊天產品的預設體驗,但結論就應該是「兩個產品在預設設定下的交付差異」,而不是「我已經隔離出底層模型權重的優劣」。無法控制的條件可以保留為未知;不能把未知寫成已控制。
五、把測試安排好,往往比單純多跑幾次更重要
不要讓管道和時間綁在一起
上午連續跑完 A,深夜再連續跑完 B,會把「管道差異」和「時間差異」混在一起。即使確實觀察到差距,您也很難判斷它在多大程度上取決於那個時段。對於輕量的橫向對照,我會在預先規定的時段內,讓 A、B 交錯接收請求,並隨機安排順序。並行數也盡量一致,不要讓一方逐一生成,另一方卻承受一批突發請求。
進一步還可以把時段切成幾個小批次,每批都有 A 和 B。這樣除了整體結果,還能檢查差異是否只集中在某個批次。隨機順序有助於降低時間造成的混淆,但不會自動消除共用後端、短暫故障等因素可能帶來的相關性。
縱向的「是否比上週差」則不同:時間本來就是要研究的變數,不可能固定在同一時刻。這時應盡量保留相同的核心題目、設定和評分標準,並在每個觀察時段一起重跑參照服務,而不是永遠拿今天的結果去比上週最好的那一張。看縱向結果時,絕對合格率和相對差值都要保留。如果受測服務和參照服務同時下降,相對差值可能不變;但這不代表使用者體驗沒有下降。參照也不是永遠正確、永遠穩定的真值。
不要一邊看結果,一邊決定什麼時候收工
「先跑五次,A 贏了就發文;A 沒贏就繼續,直到出現顯著差異。」這種做法看似增加了樣本,實際上改變了統計規則。用一般的固定樣本檢定反覆查看資料、根據結果決定何時停止,會破壞原本的偽陽性控制;需要持續觀察的測試,應採用專門的序貫分析方法。5 一般人不必從序貫統計學學起。最容易執行的辦法,是預先寫下這一輪要跑幾次、用哪個主要指標、做哪些主要比較,然後保留全部結果。
先試幾次,確認 API 和評分流程沒有問題,當然可以。但這些屬於試跑。流程修改完成後,再另外開始正式測試,不要把調整題目階段的結果和正式結果混在一起。同理,一口氣試幾十道題,最後只公布最有利的一道;或者看見總分不佔優勢,就改用某個分項宣布勝利,也都不是同一個事先約定好的比較。
不要把同一道題跑一百遍,當成做過一百道題
重複生成能幫助我們了解「在這道題上有多可靠」,卻不能自動擴大結論的適用範圍。鵜鶘畫得再穩定,也不直接代表程式除錯、長文分析和複雜指令遵循同樣可靠。對一類任務做推論時,題目之間的差異和同一題多次生成的差異,是兩種不同的不確定性。相關的評測研究專門區分了重複取樣、題目層級的比較,以及成組相關樣本的處理。6
因此,我會先用同一條探針觀察重複性,再加入少量與實際用途相關的固定任務。兩邊都回答同一組題,先計算逐題表現和逐題差值,再做彙總,而不是只丟出一個總分。如果要對多題結果做正式統計,就要保留同題與同批次的對應關係。不能簡單把「10 道題,每題 10 次」當成「100 道彼此獨立的題」,套用前面單題範例的計算。
還有一個小陷阱:固定 seed 適合排查重現問題,但把同一個 seed 下幾乎不變的輸出複製二十次,不能當成對隨機輸出分布的二十次獨立觀察。測穩定性時,應預先約定取樣策略;支援 seed 的 API 可以使用預先產生的多個 seed,不支援的就記錄這項限制。題庫長期要怎麼更新,是另一個需要單獨展開的問題。至少在這一輪對照裡,別一邊換題,一邊把新舊分數連成「模型進步曲線」。
六、逾時、截斷和畫錯,不能混為一談
還有一種很常見的統計失真:只替「成功回傳的作品」評分,把逾時和報錯的請求直接刪掉。這樣得到的分數,回答的是「拿到完整輸出之後,它有多大機會合格」,而不是使用者更在乎的「送出一次請求,能不能拿到合格結果」。假設預先安排了 20 次請求,其中 4 次逾時;其餘 16 次回傳完整作品,其中 8 次合格。那麼完整作品中的合格率是 50%,但以這 20 次請求計算的首次交付成功率只有 40%。只公布前者,會漏掉那四次沒有交付的體驗。
因此,我會同時保留三類結果:技術層面的交付失敗、完整回傳但任務不合格,以及完整回傳且任務合格。逾時、API 錯誤、串流中斷、碰到長度上限等問題,再分別記錄原因。但「分開記錄」不代表替服務故障免責。對挑選服務的人來說,逾時和畫錯都會耗掉時間;只是在追查原因時,它們不應該全被描述成「模型智力下降」。本機網路或測試腳本的故障也要另外列出,是否排除應有事先約定的規則,不能看到哪邊輸了才臨時刪樣本。
這裡我比較傾向把首次請求就得到合格結果的比例設為主要指標,把完整輸出中的內容合格率、技術失敗率、耗時和成本放在旁邊輔助解釋。完整輸出的內容合格率也不是完全沒有偏誤的「純能力分數」:如果複雜請求比較容易逾時,留下來的作品可能本來就比較簡單。它能幫助定位問題,但不能取代完整請求層面的結果。
至於「修一次之後能不能成功」,可以另外開一項測試,給雙方相同的修正機會。不要對一邊耐心糾錯五輪,對另一邊卻一錯就判死刑。
七、一場一般人也能執行的最小對照實驗
不必為了測一隻鵜鶘,先打造一個評測平台。以下是一份起步方案。它適合排查某條固定探針上的明顯差異,不是保證能檢出小幅退化的樣本數設計。
| 項目 | 本輪約定 |
|---|---|
| 問題 | A、B 兩個服務在這道固定題目上,首次交付合格結果的比例是否不同? |
| 輸入與設定 | 儲存完整的可見請求;統一可控制的參數;記錄無法確認的差異 |
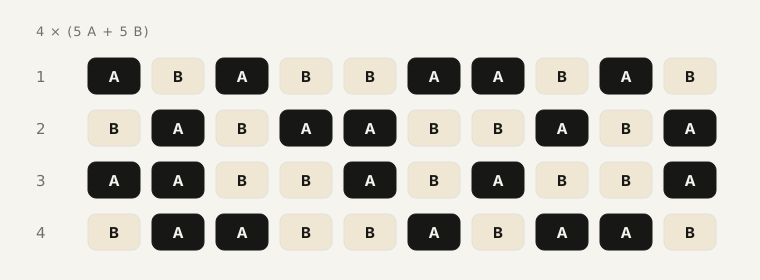
| 樣本 | 每邊預先安排 20 次正式請求;試跑結果不混入正式樣本 |
| 時間與順序 | 在預定時段內分成 4 批,每批 A、B 各 5 次;批內隨機交錯,維持相同的並行規則 |
| 重試 | 正式的首答測試不追加重試;需要評估修正能力時另開實驗 |
| 評分 | 開跑前訂好合格標準;渲染後隱藏管道名稱、打亂順序,再評分 |
| 輸出 | 儲存全部原始結果、每次的狀態、評分依據,以及逐批和整體統計 |
鵜鶘題的合格標準不妨先樸素一些:檔案能否在約定的環境中正常渲染,主體與腳踏車是否完整到可以辨認,關鍵結構是否明顯錯誤,腳與踏板等題目要求的接觸關係是否成立。美觀可以另外記錄,但不能用精緻的配色抵銷結構錯誤。
如果有人對邊界樣本拿不定主意,就先標記為爭議,依預定的複核規則處理,而不是看見管道名稱後才決定放不放行。小規模測試可以先由人工盲評;規模擴大之後,再討論自動評分與評審校準。那是下一層的問題,不必在第一輪就全部解決。記錄時,把「每輪一份」的設定與「每次呼叫一行」的日誌分開,會輕鬆很多。每輪設定記下原始請求範本、參數、題目版本、評分規則版本、時段,以及逾時與重試約定。每次呼叫則至少記錄下面這些欄位:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_path時間使用帶時區的格式。原始回應、擷取出的 SVG 和渲染圖透過 artifact_path 關聯;API 公開的 Token 用量、後端指紋等資訊也可以一併儲存,沒有提供就記為空白或未知。request_hash 用來檢查請求是否一致,但不能取代原始請求本身。儲存與分享日誌時,要移除 API 金鑰,並對私人上下文或其他敏感內容做去識別化處理。公開驗證需要的是實驗條件,不是把帳號憑證一起交出去。
統計時,先看整體差值和逐批結果。前文的二項區間與 Fisher 檢定,只適用於獨立性、穩定性等假設大致成立的情況;若結果明顯受到批次影響,或之後擴展為多題重複測試,就應採用與實驗設計相符的分析方法,而不是機械地沿用單題公式。如果初步差異值得追查,再到新的預定時段重測,並加入與您實際用途有關的任務。第一輪資料是異常線索;獨立的新一輪驗證,才有助於判斷它是否持續存在。
八、發現差異之後,結論該怎麼寫?
還是以前面的教學數字為例,一份克制但有用的結論可以這樣寫:
在本輪固定題目、相同可見設定和預定時段下,A、B 各測試 20 次,首次交付合格結果分別為 16 次和 8 次,樣本合格率相差 40 個百分點。在獨立取樣等假設下,雙尾 Fisher 精確檢定的 p 值約為 0.0225,支持本輪條件下存在差異。此結果仍需在其他時段和相關任務上驗證,無法單獨辨識底層模型或伺服器端設定變化的具體原因。
它沒有「火力全開鐵證」那麼聳動,卻把別人複查所需的關鍵條件交代清楚了。如果跨時段、跨相關任務的後續測試仍然得到方向一致的結果,我們就有更充分的理由說:這個服務在這些用途上不如參照可靠,或者相較於歷史基準確實退步了。但從「交付表現下降」跳到「偷偷換成了某個小模型」,仍然多走了一步。要確認具體機制,還需要能區分不同解釋的獨立證據,例如可核實的路由或設定記錄;不能只靠輸出風格猜型號。
這也不代表使用者必須等到原因查明,才有資格換服務。選擇服務,看的是它能否滿足您的需求;指控具體原因,需要的是關於那個原因的證據。 兩件事可以分開。
九、真正要省下的,是「把問題證明清楚」的成本
手動測試最累人的地方,往往不是按下執行鍵,而是之後的重複勞動:檔案存在哪裡、參數有沒有變、這張圖是第幾次生成的、有沒有重試過、截圖和原始回應還對不對得上。少了這些記錄,當時再確信「它真的變笨了」,過一週也可能只剩下幾張無法複查的截圖。
如果只是想先了解不同服務的表現,沒有必要每個人都從零開始重新整理。可以先到 Folkbench 查看公開排行榜及報告入口,確認您關心的模型、服務群組和指標是否已有結果。其公開頁面強調在同一個模型下比較不同服務,排行榜也提醒:某一列群組的資料,不代表這家中轉站所有群組的表現。7
不過,現成排行榜的意義應該是減少蒐集和整理的成本,而不是讓人放棄核對條件。包括 Folkbench 在內,任何排行榜都值得繼續追問:什麼時候測的、測了什麼、樣本有多少、失敗有沒有保留、結論適用於什麼範圍。沒有公開的資訊,就仍然是未知。回到最初的問題:「模型變笨」到底有多少是真的,有多少是單次抽樣的錯覺?
在沒有共同定義、完整樣本和可比較的條件之前,給出一個總比例,只會製造新的都市傳說。我們能做得更好的,是把每一次具體的懷疑,逐步變成可檢查的判斷。看到出包,先保留原始結果;懷疑退步,開始做對照;發現差異,再追查原因。別讓這幾個步驟在一張截圖裡同時完成。一張截圖可以提出一個好問題。要回答它,還得有一場像樣的實驗。
注釋與參考資料
- OpenAI,How to make your completions outputs consistent with the new seed parameter,歷史 Cookbook 範例,頁面已標記為封存。該說明把固定 seed 描述為盡力達成確定性,而非保證;本文只引用其重現性邊界,不把其中的舊型號和參數支援範圍當作目前的產品說明。原文↩
- NIST/SEMATECH,e-Handbook of Statistical Methods,第 7.2.4.1 節 Confidence intervals 中的 Wilson 比例區間方法。本文對 16/20、8/20 使用雙側 95% Wilson 區間,結果由作者依公式計算,四捨五入至百分比小數點後一位。這裡的信賴水準描述的是區間建構方法的長期涵蓋性質,Wilson 方法屬於近似方法。原文↩
- SciPy 官方文件,
scipy.stats.fisher_exact。本文以列聯表[[16, 4], [8, 12]],使用alternative="two-sided"計算,得到p = 0.0224774273717544。這是範例資料的計算結果,不是論文或平台報告中的實測結果。此範例針對獨立的二項結果比較;配對、多題叢集、時間相關或多重比較的情形,需要依相應的設計處理。原文↩ - Yuling Gu 等,OLMES: A Standard for Language Model Evaluations,Findings of NAACL 2025。論文討論提示格式、上下文範例選擇、任務表述等評測細節與可重現的比較。原文↩
- Ramesh Johari、Leo Pekelis、David J. Walsh,Always Valid Inference: Bringing Sequential Analysis to A/B Testing,arXiv:1512.04922,2019 年修訂版。論文討論持續查看結果並據此決定樣本數的問題,以及相應的序貫推論方法。原文↩
- Evan Miller,Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations,2024。關於題目層級的不確定性、重複取樣、配對比較與叢集樣本,請參見第 2、3、4 節;樣本數規劃請參見第 5 節。原文↩
- Folkbench 公開首頁及排行榜頁面,查閱日期:2026 年 10 月 5 日。本文僅依據公開頁面說明其入口、比較範圍和群組提示,不對具體排行榜資料作獨立背書,也不表示其已實作本文提出的全部實驗流程。首頁;排行榜↩