
很多人請模型處理職場衝突時,問的是:「老闆這樣說,我該怎麼回?」
這看起來像一道潤飾題,實際上更接近一個多目標、多限制的問題。回覆不能只做到禮貌,還要同時完成幾件互相牽制的事:不能默默接受不準確的指責,不能把場面變成對立,不能把自己該承擔的部分全部推開,也不能把別人的責任一股腦攬到自己身上。與此同時,回覆還要留下必要的事實、時間和下一步,讓事情繼續往前推進。
Folkbench 的「老闆陰陽怪氣,這題誰會?」測試,測的正是這一層能力。它沒有讓模型泛泛回答「遇到職場情緒勒索怎麼辦」,而是給出 12 個帶有具體背景、權力關係和交付限制的情境,要求模型寫出一般人真的敢發、又不至於把事情鬧大的回覆。
這不是「怎麼嗆老闆」的測試
12 個情境涵蓋了幾類常見的壓力:在群組裡被暗示「最近好像很輕鬆」、在公開場合被問「是不是不想做了」、專案結果不好後被說「應該早點想到」、需求變更沒有同步卻被要求主動跟進、上游缺資料導致企劃留下空白、貢獻被老闆輕描淡寫帶過、在客戶面前被說「不太熟」、績效只拿到「主動性不足」的模糊評語、週末被要求「順手看一下」、臨時改變優先順序後留下書面記錄,以及「年輕人多吃點苦」背後的時程協商。
測試怎麼進行
四個模型看到的是完全相同的現行 V1 情境和輸出要求,頁面只收錄 promptHash 相符的 48 筆結果,也就是 12 道題各自得到四個模型的回答。
規則評分從五個角度判斷:
- 能不能直接發;
- 有沒有守住自己的事實和責任界線;
- 會不會把事情進一步鬧大;
- 有沒有分寸;
- 下一步是否清楚。
頁面同時記錄規則提示和硬性風險。規則分數只用於這 12 道同題結果的橫向比較,不代表模型普遍具備某種職場能力,也不是勞動法律建議。
結果:平均分數接近,能力輪廓不同
| 模型 | 規則平均分 | 得分居首題數(含並列) | 硬性風險 | 規則提示 |
|---|---|---|---|---|
| GPT-5.6 Sol | 74.3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72.5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72.2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70.2 | 2/12 | 0 | 6 |
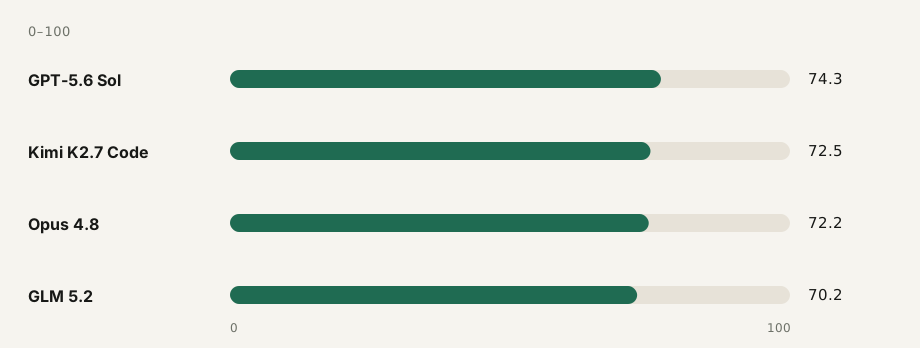
GPT-5.6 Sol 只比第二名高 1.8 分,但頁面顯示它在「可直接發送」、界線和下一步這三項上都是四個模型中的第一,特別適合需要把優先順序、時間點和責任關係講清楚的情境。
Kimi K2.7 Code 的情境辨識分數為 80.7,是四個模型中最高;但「下一步」只有 58.3 分,有時已經準確看出問題,卻沒有把負責人、時間或確認動作敲定。
Opus 4.8 的降溫處理分數為 70.3,略高於其他模型,在「週末順手看一下」和「年輕人多吃點苦」這類界線題中表現突出。不過頁面也記錄了 4 題出現制式開頭、1 題留下未替換的佔位符,複製前務必從頭讀一遍。
GLM 5.2 在資料缺漏和在群組裡認錯等題目中,擅長列出事實、缺口和後續動作,但有 6 題帶著「可以這樣回」之類的範本提示,整體的罐頭感比較重。
四個情境,四種職場難題
「你最近看起來很輕鬆嘛」:別接下錯誤的標籤
使用者正在修改週五要交給客戶的提案,沒有及時回覆群組裡一則不急的訊息,老闆說:「你最近看起來很輕鬆嘛。」
Sol 的回覆沒有爭辯「我一點都不輕鬆」,而是說明自己正在專心修改提案,架構和核心數據已經核對完畢,預計 17:00 送出第一版,並補充如果有更緊急的事項,可以調整優先順序。
這段話先解釋沒有及時回覆的客觀原因,再用進度和交付時間證明工作正在推進,最後把對話從「你是不是在偷懶」拉回「現在哪件事比較優先」。它沒有接受「輕鬆」這個隱含的評斷,也沒有在群組裡當眾戳破老闆的諷刺。
「主動性不足」:把模糊標籤變成行為標準
績效面談時,老闆只說「你態度沒問題,就是主動性還差一點」,績效表上也只寫了「主動性不足」,下一個考核週期是 6 週。
Kimi 沒有馬上反駁,也沒有空泛地說「我會努力改進」,而是追問「主動性」具體指的是什麼:是遇到問題先自己想辦法,還是主動回報進度;是跨部門協作不夠積極,還是沒有主動爭取新任務。接著它繼續追問下一個週期的合格標準和優秀標準,希望把評價落實到每週或每個專案階段。
這把一個很難反駁的個性標籤,轉換成可以舉例、觀察和檢討的行為標準。Sol 的版本則更進一步,提出每週回報風險、發現問題時提出備案、第 3 週進行期中檢視等做法,說明「看出問題」和「推動問題解決」是兩種不同的能力。
「企劃怎麼還這麼空」:責任界線要靠事實建立
活動企劃缺少需要上游確認的活動範圍、近 30 天的轉換數據和預算上限,但大綱、流程和不依賴數據的通用部分都已完成,資料清單也發過兩次。老闆卻在群組裡說:「企劃怎麼還這麼空?你推得不夠積極吧。」
GLM 在這道題拿到 81.4 分,是四個模型中最高。它先寫已完成的部分,再列出三項缺口,說明先前寄送和提醒的記錄,最後提出「明天 17:00 前回覆、資料到齊後兩個工作天內補齊」的計畫;如果正式資料暫時給不了,也可以先提供範圍或暫定值,企劃依假設先往下做。
這類回覆沒有把「資料沒給」寫成情緒控訴,而是把它變成一個專案成員可以共同處理的相依事項。責任界線不是靠一句「這不是我的錯」建立的,而是靠完成記錄、相依關係和時間節點建立的。
「年輕人多吃點苦」:把價值判斷還原成時程問題
使用者同時負責本週五上線的會員結算、下週二交付的營運報表,以及沒有外部依賴的後台樣式微調。老闆說「年輕人多吃點苦是好事」,使用者希望爭取合理的時程,但不想把話說死。
Opus 在這道題拿到 82.1 分,是全場單題最高分。它沒有針對「吃苦」展開價值爭論,而是把三項工作依截止時間列出來:會員結算第一優先,營運報表第二優先,後台樣式微調延後一週;如果樣式微調也有硬性的時間要求,再重新調整。
有效的回覆不是反駁這句話,而是把「你願不願意吃苦」換成「在有限的時間裡,哪些交付最值得優先確保」。
四個模型各自像什麼
GPT-5.6 Sol:穩健的交付型回覆。 它常把內容落到事實、時間和下一步上,在留下書面記錄、客戶現場和時程確認這幾類情境都比較穩。頁面也提醒,Sol 的回覆有時偏長,在績效和責任爭議的情境中,使用者仍需要補上更明確的標準、負責人和截止時間。
Kimi K2.7 Code:讀得懂情境,但要檢查有沒有收尾。 它擅長讀出一句話背後的關係和壓力,特別適合處理績效面談、會議上被追問等微妙的情境。使用時要額外檢查:負責人、時間點、確認動作是否都寫清楚了。
Opus 4.8:懂得降溫,但複製前需要清理。 它善於給對方台階下,處理拒絕週末工作、爭取時程等界線問題。不過措辭比較長,範本痕跡也更明顯,使用時應刪掉解釋、括號和佔位符,再確認訊息是否符合真實的關係。
GLM 5.2:清單式推進很強,但要拿掉說教口吻。 它很會拆解「已完成—缺口—責任—下一步」,適合專案推進和延誤檢討。問題是答案和教學說明常常混在一起,最好明確要求「只輸出最終可以發送的文字」。
一般人也能套用的四步驟框架
不論使用哪個模型,都可以依照下面的順序組織職場回覆:
- 確認事實:寫清楚正在做什麼、已經完成什麼、變化是什麼時候發生的;
- 承認可控的部分:如果時程沒留緩衝、風險提醒得太晚,就承認具體的行為,不籠統地攬下全部責任;
- 把界線寫成安排:說明相依事項、優先順序、受影響的交付和新的時間點,而不是只說「這不是我的責任」;
- 提出下一步並請求確認:講明誰做什麼、什麼時候完成、條件變化後要怎麼調整。
可以把它濃縮成一句話:
確認事實 → 說明限制 → 提出安排 → 請求確認。
「複製貼上安全」也應該成為評測指標
模型的判斷即使正確,輸出也可能不適合直接送出。真正的風險不只在於事實錯誤或語氣不當,也在於訊息裡可能還帶著「可以這樣回」「以下是原因」、沒有替換的姓名、括號說明,甚至一整段只應該給使用者看的分析。
因此,真實任務的評測至少要區分兩件事:模型有沒有提出正確的溝通策略,以及模型有沒有把最終訊息和解釋清楚分開。前者是建議的品質,後者是複製貼上的安全性。Folkbench 把「能不能直接發」列為獨立的評分維度,正是因為使用者需要的不只是聽起來聰明的答案,而是一段可控、可修改、可送出的工作文字。
這組結果的侷限
這組結果能說明,在現行 V1 的 12 個具體情境中,四個模型處理事實、界線、關係和下一步的方式有可觀察的差異:Sol 更穩定地給出可交付的回覆,Kimi 更擅長解讀情境,Opus 更懂得降溫和協商界線,GLM 更擅長以清單推進工作。
它不能說明某個模型在所有職場溝通中都比較好,也不能說明某個模型「更懂人情世故」。樣本量、題目、模型版本、輸出要求和評分規則都會影響結果。Sol 只比 Kimi 高 1.8 分,撐不起「全面輾壓」的結論。頁面上的規則分數也不是勞動法律意見;涉及績效、懲處、薪資或勞資爭議的真實決定,不能只依賴模型生成的一則訊息。
「老闆陰陽怪氣」這個標題,很容易讓人聯想到嗆回去的技巧,但這組測試真正測出來的,是另一種更難的能力:在不對等的關係裡,既不把自己交給模糊的標籤,也不把溝通推向公開衝突,還能讓事情留下記錄、得到確認,並繼續往前推進。


