
第一篇談「別輕信一張截圖」。這一篇繼續追問:為什麼連一個分數,也不能輕信?
假設現在有三隻騎單車的鵜鶘。第一隻畫得非常精緻:羽毛有層次,車輪有高光,背景甚至還有夕陽。但仔細一看,兩隻腳都懸在踏板上方。第二隻像寥寥幾筆的簡筆畫,沒有陰影,也沒有漂亮的配色;不過車架連接合理,身體坐在座墊上,腳也確實踩著踏板。第三隻的靜態截圖挑不出什麼毛病,一按播放,腳卻開始沿著自己的軌跡飄移,踏板轉踏板的,鵜鶘踩鵜鶘的。誰應該得最高分?
如果答案是「第一隻最漂亮」,我們是在評審美;如果答案是「第二隻最可靠」,我們是在評任務完成度;如果只看截圖,第三隻的錯誤可能根本不會被發現。
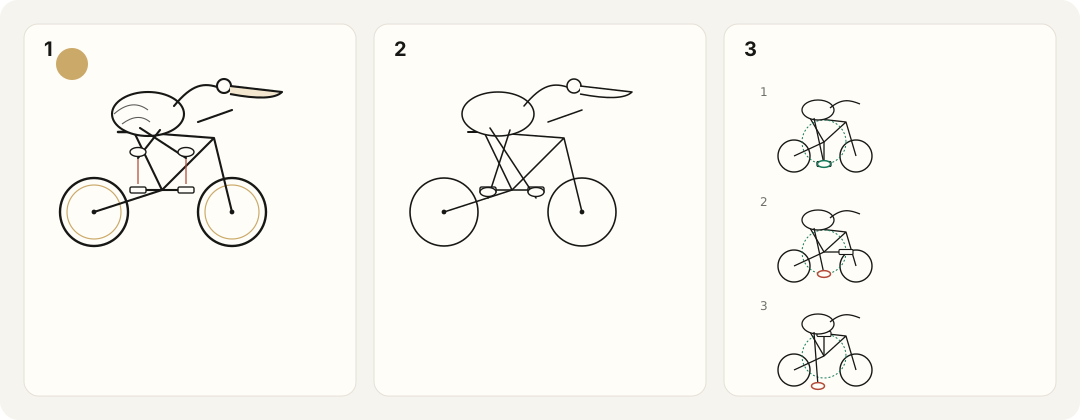
上一篇文章談到,要判斷模型是不是真的變差,不能只挑一次輸出,而要在可比較的條件下重複測試。但其中藏著一個尚未解決的前提:我們已經知道什麼叫合格。如果這個前提不成立,重複測試並不會自動讓結論變得可信,它可能只是讓一把有偏差的尺,量得越來越穩定。這篇文章就從這裡開始:怎樣把「這隻鵜鶘看起來還行」,變成一套有依據、能複查、也能逐步自動化的評測方法?
說明:文中的樣本、數字、評分方案和設定都是方法範例,不對應真實的模型排名,也不代表 Folkbench 已經實作這些流程。引用的研究用來說明相關方法與風險,不代表本文方案已經通過實驗驗證。
一、先把題目寫清楚,再討論怎麼評分
鵜鶘測試很有吸引力,因為它把錯誤直接畫在臉上:多出來的腿、接不起來的車架、踩不到的踏板,都不容易被漂亮的說詞掩蓋。但它究竟在測什麼,需要說得更具體。讓模型「用 SVG 畫一隻騎單車的鵜鶘」,直接觀察到的是:它能不能把文字要求轉成程式碼,並用這些程式碼產生符合要求的圖形。單憑這個結果,無法確定它內部採用了什麼空間表徵,也不能把「這題做得好」直接等同於「具備完整的空間理解能力」。
如果允許模型先渲染、看圖,再反覆修改,測到的就是帶有回饋的工作流程,而不只是一次程式碼生成。兩者都有價值,但不應該混在同一個首答排行榜裡。更實際的問題是:題目沒有寫出來的要求,不應該在評分時突然冒出來。原題只有一句「畫一隻騎單車的鵜鶘」,我們就不該事後要求它必須使用標準公路車、兩個車輪完全一樣大、兩隻翅膀都扶著把手,或所有零件都清楚露在外面。合理的透視、遮擋和卡通化,本來就是開放式繪畫的一部分。我的建議是把測試分成兩種。
一種保留開放題,觀察模型如何理解和表達「騎車」。評分只抓清楚、必要的要求,並承認邊界樣本有爭議空間。另一種是約束題,事先規定視角、可見關係、輸出格式,以及允許使用的技術。例如:畫面以側面為主,允許輕微錯位以呈現兩隻腳;每隻腳與各自踏板的接觸處必須可見;只交付自包含的 SVG;不使用外部圖片或腳本。
約束題會改變原題,但這不是缺點。只要明確標示題目版本,它就能讓我們更具體地排查:模型究竟是沒有滿足視角要求、沒有把接觸關係表達清楚,還是連單車結構都畫錯了。關鍵不在於哪一種更「正宗」,而在於:開放題照開放題評,約束題照約束題評,不能拿一個模糊的題目,配上一套事後發明的嚴格標準。
二、別急著給總分,先把「騎車」拆開
「整體不錯,給 8 分。」這是最方便的評分方式,也是最難複查的評分方式。8 分究竟是因為主體正確、結構合理,還是配色討喜?下次遇到同樣的錯誤,裁判會不會又給 9 分?我會先沿用四個維度,但不把它們當成四個憑感覺填寫的數字。
| 維度 | 主要檢查什麼 | 不應該混入什麼 |
|---|---|---|
| Pelican:主體 | 能否辨認為鵜鶘;身體與肢體是否有明顯異常;是否滿足題目明確要求的可見性 | 題目沒有要求的寫實程度、羽毛細節和個人畫風偏好 |
| Bicycle:單車 | 車輪、車架、曲柄、踏板等是否構成題目要求的合理結構 | 題目沒有要求的品牌、車款、裝飾,以及特定的 SVG 寫法 |
| Riding:騎乘關係 | 身體是否得到合理支撐;腳是否對應踏板;題目要求的操控關係是否成立 | 僅僅是「鳥在車旁邊」或「兩個物件都存在」 |
| Animation:時序關係 | 要求的動作是否發生;接觸和連接在動作中是否維持;是否出現不合理的突變或穿模 | 靜態題根本沒有要求的動畫;與任務無關的特效 |
物件存在,不等於關係成立。「有腳」和「有踏板」是兩個物件判斷;「腳踩在踏板上」是關係判斷。再進一步,「腳在踏板轉動時仍然踩著它」,則是跨越時間的關係判斷。這也是為什麼只檢查「鵜鶘、單車、兩個輪子是否齊全」還遠遠不夠。真正該拆出來的,是身體與座墊、腳與踏板、踏板與曲柄、車架與輪軸之間的連結。
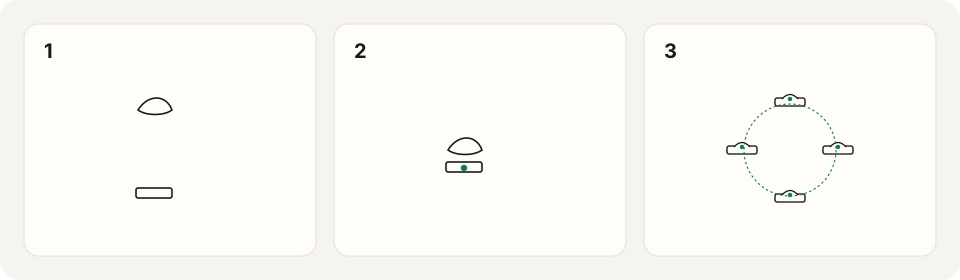
這類拆解有相關研究可以參考。TIFA 把文字中的要求轉成多個問題,再用視覺問答檢查生成的圖像是否滿足要求。它並不是一套現成的鵜鶘評分器,但指出了一個有用的方向:與其只給整體印象分,不如逐條檢查圖像與要求是否一致。1 具體到實作,我建議每條檢查先保留四種狀態:pass、fail、uncertain 和 not_applicable,分別代表通過、失敗、證據不足和不適用。
這裡最重要的是區分後兩種。靜態題沒有要求動畫,Animation 就是「不適用」;題目已經要求動畫,但材料不足以判斷是否穿模,那就是「證據不足」。前者不該扣分,後者不能自動算通過。接著再把條目分成必要條件和附加品質項目。必要條件決定是否合格,附加項目負責描述細節與美觀。只要有明確的必要條件失敗,就不能靠漂亮的羽毛、背景和漸層補回來。
一份起步報告完全可以只寫:主體檢查通過了幾項,單車結構在哪一項失敗,騎乘關係有沒有未決問題,動畫是否適用。它不一定需要一個精確到小數點後兩位的總分。如果確實需要綜合分數,就事先公布適用條目、權重和缺失值的處理方式,並把必要條件的失敗單獨列出。不同權重算出的排序是否穩健,本身也值得檢查。總分是壓縮後的摘要,不是取代原始證據的理由。
三、SVG DOM 能幫上忙,但它不是一張附帶答案的結構圖
看到 SVG,最容易冒出的工程直覺是:既然有原始碼,直接解析不就好了?於是規則很快就寫出來了:找到兩個 circle,代表有兩個車輪;找到一個叫 foot 的元素,代表有腳;看腳和踏板的邊界框是否相交,就代表踩上去了。問題是,這幾步都把「程式碼中的表達方式」,誤當成了「畫面中的語意事實」。
一個車輪可以用圓形元素畫,也可以用路徑畫;兩個車輪可以分別寫出來,也可以透過 use 重複使用;同一個視覺物件,還可能由多個群組和路徑組成。SVG 規範允許這些不同的表達方式,並不要求一個現實物件對應一個 DOM 節點。2 因此,數不到兩個 circle,不能證明少了車輪;數到兩個,也不能證明它們真的位在合理的位置。元素叫 foot,更只是生成者替它取的名字,不是獨立的驗證。
靜態規則最適合檢查可以確定的約束
例如:輸出能否依約定格式解析,是否包含題目禁止的外部參照,是否有不允許的腳本,能否在指定環境中渲染出非空白的內容。這些檢查有明確依據,也容易留下日誌。但它們回答的是「是否符合交付和技術約束」,而不是「這隻鳥有沒有騎對車」。同樣地,渲染成功也不能取代格式合規檢查。SVG 規範區分了不同的文件形態和處理模式;網頁內嵌的片段和獨立的 SVG 檔案,不應在沒有說明的情況下,套用同一種解析要求來驗收。3
幾何檢查得先釐清「量的究竟是什麼」
如果已經能可靠地辨識出腳和踏板對應的可見幾何區域,就可以計算距離、重疊範圍和軌跡關係。例如,把腳底與踏板接觸面之間的距離,除以同一畫面中約定的參考輪徑,得到一個相對距離。用這種方式討論「離開踏板有多遠」,比直接套用固定的像素門檻值更有解釋力。但接觸面怎麼定義、誤差容許多大,仍然需要在標註樣本上校準,不能憑空宣布「相差五個像素就一定是錯的」。
測量還要考慮座標變換、描邊、裁切和實際可見性。SVG 元素可能位於巢狀座標系中;規範中也有未實際渲染的元素仍然具有邊界框的情況。拿到一個邊界框,不代表已經拿到畫面上那個可見物件的邊界。4 更不用說,兩個邊界框相交,不等於腳底接觸到踏板;兩個平面區域重疊,也可能只是前後遮擋,並不代表合理的支撐。所以,在一般的 SVG 上,幾何規則比較適合當作經過驗證的輔助證據,而不是未經校準就一票否決的裁判。
如果為了自動化,要求模型必須輸出統一的零件 ID、關鍵點和群組結構,也不是不行。但那應該作為一個獨立的「結構化輸出」組別:檢查這些宣告是否對應真實畫面,而不是讓模型自己寫上「接觸正確」,評測程式就直接相信。DOM 給了我們更多可以檢查的資訊,卻沒有免費解決語意辨識。
四、視覺 Judge 上場之前,先給裁判出一份考卷
既然靜態規則不夠,那就讓看得懂圖的模型來評。這條路值得走,但不能把「模型能描述圖片」直接等同於「模型能穩定判定細微的空間錯誤」。2023 年關於 MT-Bench 與 Chatbot Arena 的研究,討論了 LLM 裁判的位置偏好、冗長偏好和自我偏好等問題,也指出強模型在特定的文字評測中,與人類偏好的一致性相當不錯。因此,合理的結論不是「模型裁判全都不可信」,而是「它的可信度取決於具體任務,需要驗證」。這些文字評測的結果,也不能直接當成視覺評分的準確率。5
視覺能力本身同樣需要檢驗。2024 年的 BlindTest 研究發現,當時受測的視覺語言模型,在圓是否重疊、線是否相交這類簡單的幾何任務上仍然會出錯。這不代表今天的模型都還停在當年的水準,但足以提醒我們:精細的接觸關係,不能只憑模型的名氣就預設它看得準。6 我的做法會是先建立一批人工參考樣本,而不是直接讓 Judge 接管排行榜。
樣本裡要有明顯正確和明顯錯誤的作品,也要有邊界情況:簡筆畫、細線條、合理遮擋、複雜路徑,以及靜止時正常、一動就出錯的作品。盡量安排至少兩位標註者先獨立盲評,再複核彼此的分歧。人工也不是天然的真值。如果兩個人看同一條規則,總是得出相反的結論,首先該修改的可能是題目或評分說明。無法釐清的樣本可以繼續保留爭議,而不是硬造一個「標準答案」。
Judge 應該回答具體問題,而不是發表審美感言
給它原始任務、凍結的評分規則和統一渲染的圖像;動畫題再提供帶有時間標記的影格或影片。不要同時提供服務商名稱、排行榜位置,或生成模型自己附上的「本圖完全符合要求」說明。讓 Judge 逐條判斷:「兩隻腳是否分別接觸各自的踏板?」「可見的車架是否與前後輪軸形成合理的連接?」「在這些時間點,腳和踏板之間的連結是否維持?」
每個判斷附上一條簡短、可定位的證據,例如「第 2.0 秒,靠近觀看者的那隻腳與踏板之間有明顯空隙」。證據不足時就回傳 uncertain,不要用一段流暢的說明掩蓋看不清楚的事實。圖像中的文字、SVG 註解和中繼資料,也只能當作受測內容,不能成為改變評分規則的指令。遮去檔名或隱藏管道標籤,不等於可以擅自修改作品;需要裁切或加上標註輔助圖時,應同時保留原圖和處理記錄。
校準不能只看一個「整體一致率」
假設一批參考樣本中,90 張合格,10 張有嚴重錯誤。一個永遠回答「通過」的裁判,也能拿到 90% 的整體準確率,卻會放過全部的嚴重錯誤。因此,我會分別檢查:有多少關鍵錯誤被漏掉,有多少正確作品被誤殺,在不同畫風上的表現是否一致,以及同一件作品重複評分時是否穩定。邊界樣本還要看它是否願意承認證據不足。
可以另外製作少量「只改一個因素」的樣本:原圖不動,只把一隻腳移離踏板;或者只換背景,不動結構。前一種改動應該影響相關評分,後一種則不該無故改變結構判斷。這些人工構造的樣本適合用來診斷,但不能完全取代真實的模型輸出。用來修改評分 Prompt 的樣本,與最後檢驗裁判的保留樣本,也要分開。不能一直對著同一批答案調到滿意,再把這批成績當成泛化能力的證明。
至於多裁判投票,可以作為發現分歧的辦法,卻不能因為用了三家的模型,就認定三份判斷彼此獨立,它們可能犯同一種錯。Judge 自稱「我有 95% 把握」,也不能在未經校準的情況下,當成 95% 的實際正確率。裁判需要證明的是它能辨識錯誤,而不只是能解釋自己的分數。
五、動畫不是多截幾張圖,而是檢查關係有沒有在時間中斷掉
靜態評分問的是「現在有沒有踩上」,動畫評分問的是「動起來之後,這種關係有沒有繼續成立」。一隻腳在第一個影格恰好碰到踏板,不代表它接下來會沿著踏板的軌跡移動。反過來說,把腳和踏板一起固定不動,也不算完成題目要求的踩踏動作。所以動畫至少有兩個不同的問題:該動的東西是否真的動了,以及運動過程中應該維持的連結是否維持住。
為此,要先約定動畫情境。原地騎行、向前行進、鏡頭跟拍,是不同的任務。題目沒有要求精確的機械模擬,就不該偷偷加上齒輪比之類的額外約束;但如果明確要求曲柄轉動、腳持續接觸踏板,這些就應該納入驗收。
評測環境也必須保留真實的動畫狀態。舉個很具體的工程陷阱:Playwright 的截圖參數 animations="disabled",會停止它所支援的相關動畫,其中有限動畫會被推進到結束,無限動畫則會被取消、回到初始狀態。它不是「精確擷取任意時刻」的同義詞。7 因此,不能隨手關掉動畫、截出一張漂亮的圖片,就把它當成動畫通過的證據。應該先用已知動作的測試檔案,驗證自己的時間控制和截圖方法,再拿來處理模型輸出;所支援的動畫機制也應該寫清楚。
假設題目要求一個 4 秒的循環,一種起步方案是觀察兩個完整循環,依預定頻率取樣,並額外檢查循環交界以及疑似出錯的時段。具體的觀察期間、取樣頻率和追加檢查規則,都應該在正式評測前固定,而不是看到哪裡出問題才臨時加嚴。但即使如此,有限的影格取樣仍可能漏掉影格之間的短暫異常。報告應該寫成「在約定的觀察期間與取樣條件下,未發現明顯錯誤」,而不是「數學上證明全程沒有穿模」。
還要小心二維畫面中的正常遮擋。腿經過車架後方時,輪廓交疊並不等於穿模;真正要檢查的,是前後關係、連接關係是否出現不合理的變化。局部放大有助於觀察,但不能丟掉整體的空間脈絡。如果自動裁判目前只能可靠處理靜態圖,就先公開靜態成績,把動畫留給人工複核。與其把沒有測到的能力塞進一個總分,不如承認這把尺暫時還量不到那裡。
六、評分系統也會出錯,還會製造「模型突然變差」的假象
有了靜態檢查、視覺 Judge 和人工複核,問題還沒結束,因為這套系統本身也可能改變。昨天的 Judge 對輕微懸空比較寬鬆,今天換了一個版本,開始嚴格扣分。模型生成的作品沒有任何變化,排行榜上的合格率卻下降了。如果只保存「模型名稱、日期、總分」,很容易把裁判的變化誤認成模型退化。因此,除了生成模型與請求參數,還需要記錄題目版本、評分規則版本、Judge 的模型與設定、渲染器版本,以及自動檢查程式的版本。任何一項改變,都可能影響分數的意義。
更換裁判或規則之前,我會讓新舊版本同時為同一批已保存的作品評分,看看差異集中在哪裡。必要時可以重評歷史作品,但應該標為「同一產出物的新版重新評分」,不能偽裝成模型剛剛重新作答。
另一類問題是評測沒有完成。服務逾時、SVG 本身損壞、截圖程式當掉、Judge 請求失敗,不能全部混為「模型畫錯」。作品本身不合規,可以依預定規則判為失敗;評測基礎設施出了故障,則應記錄為評測未決,並依固定流程補評。對一件作品來說,只要某個必要條件已經明確失敗,整體就可以判為不合格。反過來,如果還沒有明確的失敗,但仍有必要條件看不清楚,就不能直接放行。
假設 100 個預定請求中,有 72 個確認合格、18 個確認不合格,另有 10 個尚未判定。報告可以先把這三項寫清楚,而不是刪掉未決樣本,再宣布「合格率 80%」。在暫時把已確定的標籤視為正確的前提下,這批樣本最終的合格比例可能介於 72% 和 82% 之間:下界把未決項目全部算作失敗,上界把它們全部算作通過。這是未決標籤帶來的範圍,不是統計上的信賴區間,也沒有涵蓋裁判誤判以及推廣到其他樣本的不確定性。
人工複核也不能只看 Judge 標出的失敗和爭議。在自動通過的作品裡,應該依預定方式隨機抽查一部分,否則最危險的漏判可能一直藏在「通過」區。沒有哪一套自動評測,能靠「從來沒發現自己出錯」來證明自己沒有錯。它需要一套能主動找出自身失誤的稽核流程。
七、題目會過時,但每天換題也不等於更科學
一旦某道題爆紅,接下來就會出現範例、教學、修正建議,以及專門針對它的最佳化。這不代表看到模型把鵜鶘畫得好,就能斷言它作弊。公開題目的曝光、對題型的學習,以及測試樣本進入訓練資料,是不同層次的問題。某個模型是否接觸過某份測試材料,需要證據,不能靠「這題太紅了」就直接判定。
不過,測試材料進入訓練資料,確實是評測必須面對的風險。LiveBench 的做法包括使用較新的資訊來源、持續更新題目,以及依可驗證的答案自動評分。它提供的是降低相關風險的一種實踐,而不是「只要每個月換題,就絕對沒有汙染」的保證。8 對鵜鶘這類開放生成題,我比較傾向保留三種用途不同的題目:穩定的核心題,用來觀察長期變化;定期輪換的延伸題,用來觀察遷移;暫不公開的保留題,用來在流程凍結後進行檢驗,而不是不斷拿來調整規則。
核心題的價值在於可比較,不在於能免疫訓練汙染。延伸題的價值在於擴大涵蓋範圍,也不是題目越怪越好。
真正值得變化的,是約束,而不只是主角的名字
把鵜鶘換成鴨子,可以算是一種變化,但它並不會自動改變關係結構。更有診斷價值的變體,是有計畫地改變一個條件:朝向相反時,連接關係是否仍然正確;遮擋增加時,關鍵部位是否仍然完整;要求「站在車旁推車」時,模型會不會仍然套用騎乘姿勢;同樣的接觸關係放進動畫之後,會不會失效。
也可以換成不同的關係任務,例如手握杯柄、物體由托盤支撐、多個零件依指定順序連接。關鍵不是把所有罕見要求都堆進一張圖,而是清楚知道每個變體在檢驗什麼。用同一個範本機械式地替換一百種動物,當然能產生一百道題,卻不能因此宣稱得到了一百種獨立的能力證據。彙總時應保留任務類別和範本家族,避免某個範本只因變體特別多,就佔去總分的大半。
自動產生的新題目也需要驗收。題目可能含糊、自相矛盾,或者根本無法從最終圖像核驗。如果題目、答案和裁判規則全都由同一個模型提出,再由它自己確認正確,就更應該加上獨立檢查。
更新題庫時,別把難度變化畫成模型進步
這個月 80 分,下個月 90 分,不一定代表模型變強了,也可能只是新題比較簡單。因此,新舊題庫切換時,最好保留共同題,並在相近條件下讓一組參照系統同時跑舊題與新題,再分別報告各任務類別的變化。共同題和參照系統都不是永遠穩定的真值,它們有助於識別變化,卻不會自動完成嚴格的難度等化。證據不足時,最誠實的做法是分版本呈現成績,而不是把不同試卷的原始分數硬接成一條曲線。
題目退役後可以公開,幫助別人複查、學習和改進。只是公開之後,它的角色可能從「尚未見過的檢驗」,轉為「可重複的回歸測試」。題目不是只能用一次,也不能永遠擔任同一種測量工具。動態題庫的重點,不是永遠追逐新鮮,而是管理題目在不同階段能支撐什麼結論。
八、真正值得自動化的,是一條能回頭查帳的流程
討論到這裡,很容易把方案越做越大:多裁判、軌跡分析、動態題庫、自動仲裁,一個都不能少。但最小可用版本,不必從一座全自動工廠開始。先選一小組題目,寫清楚驗收條件,收集真實輸出,建立人工參考,再驗證哪些條目可以交給規則、哪些可以交給視覺 Judge。還無法可靠自動化的部分,就保留人工處理。
資料量小的時候,目標是找出規則的漏洞,而不是急著對外宣布「評分準確率已經達到某個水準」。正式驗證自動化能力,需要另外保留樣本,並報告不確定性。一條合理的流程可以是:
凍結題目與驗收規則 → 依計畫生成 → 保存完整的原始輸出
→ 受控解析與渲染 → 靜態檢查 / 視覺逐項評分
→ 依規則複核爭議,並抽查自動通過項目
→ 彙總首次交付結果、分項表現和未決狀態
每一步都應該能追溯到前一步。原始回應、擷取出的 SVG、實際渲染圖、動畫觀察記錄、Judge 的原始回傳和複核結論,都透過同一個執行識別碼關聯起來。擷取或正規化檔案時,保存處理前後的版本。如果某段 SVG 經過修復才渲染成功,應該記錄為修復流程的結果,不能悄悄覆蓋首答。評分規則升級時,也應該新增評測記錄,而不是把舊記錄抹掉。
還有一個不能省略的工程前提:把模型輸出當作不受信任的內容。SVG 的處理模式可能涉及腳本、事件和外部資源;「副檔名是圖片」並不代表可以放心在日常登入使用的瀏覽器裡執行。3
渲染環境應隔離帳號憑證、網路和主機檔案,限制資源用量,並採用適合不受信任內容的沙箱設定。如果使用 Playwright,也不能把「包進 Docker」當成安全問題已經解決;其官方文件明確提醒預設容器映像檔的用途限制,以及以 root 執行與 Chromium 沙箱之間的關係。9 具體的安全措施還需要依執行環境驗證。題目允許什麼功能,與執行環境允許什麼功能,也應該事先一致,不能先讓模型使用腳本,評分時再不加說明地全部停用。
真正需要省下的,不是「認真驗證」本身,而是每次驗證都要重新找檔案、核對參數、補上時間戳記的重複勞動。
九、一份值得看的排行榜,應該讓人能夠追問
看到一個分數時,我希望能繼續查到:它對應哪個模型服務、哪一份題庫、什麼時間範圍;樣本有多少,失敗與未決有沒有保留;誰在評分、怎麼校準、能否找到判定依據。這些資訊比一個看起來很精密的總分,更能說明評測有沒有認真看待自己的邊界。
不打算親自建立流程的人,可以先從 Folkbench 的公開排行榜、報告和評測說明入口開始,確認關心的模型與服務是否已有適用的已發布結果。其公開首頁將比較範圍描述為同一模型下的不同服務;具體的涵蓋情況、功能狀態和結論依據,仍應以當時公開的資訊為準。10
對 Folkbench 是如此,對其他排行榜也一樣:缺少的資訊繼續保留為未知,平台的介紹不能取代實際報告,本文提出的評測方案也不等於任何平台已經具備的能力。好的評測不是要求讀者「相信我這個分數」,而是讓讀者能順著分數,找到作品、條件、規則和分歧。回到那三隻鵜鶘。
我們不必爭論第一隻是不是最好看,也不用因為第三隻某一個影格很漂亮,就替它的整段動畫放行。只要先約定測什麼,再把證據記錄清楚,很多所謂的玄學,都會變成能夠逐項討論的問題。第一篇說,一張截圖可以提出一個好問題,但回答它需要一場像樣的實驗。這一篇想補上的是:一場像樣的實驗,還需要一把經過檢驗的尺。
附錄一:一份可以起步的約束題與驗收表
下面是本文設計的靜態題範例,不是業界標準,也不是任何平台的正式題目。使用前應經過試跑與標註校準;正式比較開始後,不要根據結果臨時改題。
範例 Prompt
請只輸出一份可獨立開啟、自包含的靜態 SVG 檔案內容,
viewBox 為 "0 0 800 600",不要附上 Markdown 程式碼區塊標記或說明。

畫一隻卡通鵜鶘騎在普通的雙輪單車上。
畫面以側面為主,允許零件輕微錯位,以清楚呈現騎乘關係。

必須滿足:
1. 鵜鶘和單車完整位於畫面內,不出現多餘的腿。
2. 前後兩個車輪、車架、座墊、把手、曲柄和兩個踏板都可以辨認,
   車架與前後輪軸連接合理,踏板與曲柄的關係合理。
3. 身體坐在座墊上;兩隻腳分別接觸各自的踏板,
   兩處接觸都必須清楚可見;至少一隻翅膀接觸把手。
4. 只使用 SVG 向量圖形與行內樣式,不使用嵌入的點陣圖、外部資源、
   腳本、foreignObject 或動畫。

不要求寫實、複雜背景、羽毛紋理或裝飾性特效。
範例驗收表
| 編號 | 檢查項目 | 性質 |
|---|---|---|
| F1 | 符合約定的獨立檔案格式、檢視區與資源限制 | 必要條件 |
| P1 | 主體可辨認為鵜鶘,畫面完整,沒有明確多出來的腿 | 必要條件 |
| B1 | 兩個車輪、車架、座墊、把手、曲柄和兩個踏板可以辨認 | 必要條件 |
| B2 | 車架與前後輪軸、踏板與曲柄的連接關係合理 | 必要條件 |
| R1 | 身體與座墊形成明確的騎坐支撐關係 | 必要條件 |
| R2 | 兩隻腳分別接觸各自的踏板,接觸處符合可見性要求 | 必要條件 |
| R3 | 至少一隻翅膀接觸把手 | 必要條件 |
| A | 本題為靜態題,未測試動畫能力 | 不適用 |
| Q1 | 配色、線條和細節表現 | 選擇性展示項目,不抵銷必要條件的失敗 |
這裡的「可辨認」「合理」「明確」,仍需要搭配正反例與邊界說明。表格只是規則的骨架,不代表光靠幾句文字就消除了主觀判斷。必要條件全部通過,才判為合格;有必要條件明確失敗,判為不合格;沒有明確失敗但存在未決的必要條件,就進入複核。R3 之所以需要檢查,是因為這份範例 Prompt 明確要求了它,不能在沒有說明的情況下,把它套用到所有鵜鶘題上。
附錄二:一份 Judge 輸出記錄的範例
下面的 JSON 是虛構的單項記錄,用來展示欄位之間的關係,不對應真實圖片。它不是完整報告,也不是某個函式庫可以直接執行的設定。
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "靠近觀看者的那隻腳與其對應的踏板之間,有清楚可見的空隙。"
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id 應能查到裁判的具體模型、Prompt、參數和版本記錄;render_profile_id 應能查到瀏覽器、檢視區及其他相關設定。動畫證據應填寫實際的時間點,不能只寫「中間有一格」。review_required 由評測系統依既定規則設定,不由 Judge 單方面決定。即使該欄位為 false,樣本仍可能進入隨機稽核。自動評分失敗、視覺材料不足和任務不合格,應分別記錄,不能共用一個模糊的「失敗」狀態。
註釋與參考資料
- Yushi Hu 等人,TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering,ICCV 2023。這篇論文將文字要求轉為問答檢查,用於評估圖文一致性。本文借用其分解思路,不將原論文的實驗成績套用到鵜鶘 SVG 或動畫任務上。論文↩
- W3C,Scalable Vector Graphics (SVG) 2,Document Structure 與 Paths 章節。參見群組、
use重複使用與路徑表達;「DOM 節點不天然對應現實中的語意物件」是本文據此做出的評測設計判斷。文件結構;路徑↩ - W3C,SVG 2 — Conformance Criteria,處理模式與文件符合性章節。規範區分了腳本執行、外部資源、宣告式動畫等能力,以及不同的文件形態。具體的瀏覽器支援與執行限制,仍須在實際環境中驗證。規範↩
- W3C,SVG 2 — Coordinate Systems, Transformations and Units,座標變換及 Bounding boxes 相關段落。本文關於接觸距離、門檻值和語意辨識的建議,是評測設計範例,不是 SVG 規範所定義的「騎乘正確性」演算法。規範↩
- Lianmin Zheng 等人,Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena,NeurIPS 2023 Datasets and Benchmarks Track,arXiv v4。本文僅據此說明特定文字評測中的裁判能力與偏差,不推定所有視覺裁判都有相同的偏差幅度或準確率。論文↩
- Pooyan Rahmanzadehgervi 等人,Vision language models are blind,2024。本文對應的是 2024 年的原始研究,固定引用 arXiv v1,以免與後續修訂版的模型、標題和結果混用;這項研究不能當作 2026 年模型的當前排名。論文版本↩
- Playwright 官方文件,
page.screenshot的animations選項,查閱日期:2026 年 10 月 5 日。文件說明了該選項對 CSS animations、CSS transitions 與 Web Animations 的處理方式;不能在未經驗證的情況下,把它推廣為所有 SVG 動畫機制的統一時間控制方案。文件↩ - Colin White 等人,LiveBench: A Challenging, Contamination-Limited LLM Benchmark,ICLR 2025,arXiv v2。初始版本的標題曾使用「Contamination-Free」,本文依據 2025 年修訂版中關於持續更新、可驗證評分與降低汙染風險的表述,不做絕對無汙染的承諾。論文↩
- Playwright 官方 Docker 文件,查閱日期:2026 年 10 月 5 日。文件提醒預設映像檔不建議用於造訪不受信任的網站,並說明預設以 root 執行會停用 Chromium 沙箱。本文沒有提供完整的安全部署方案;實際的隔離、網路和權限政策,仍須依執行環境落實並測試。文件↩
- Folkbench 公開首頁,查閱日期:2026 年 10 月 5 日。首頁提供排行榜、報告及相關說明的入口,並自述在同一模型下比較不同服務;其檢測入口同時標示「Beta 準備流程」和「真實探測尚未啟用,目前入口用於展示準備流程」。本文僅指向公開資訊的入口,不將展示入口等同於已完成的實測,不獨立背書具體排名,也不聲稱其已實作本文的四維評分、裁判校準或動態題庫方案。首頁↩


