当一张“骑自行车的鹈鹕”不再只是社交媒体的随手截图,而是被标准化为 507 款模型可检索、可校验、每日自动更新的参考基线,它就从一则行业趣闻,变成了检验大模型真实身份的工程基础设施。
今天,我们正式开源 Folkbench/pelican-database —— 这是目前全球规模最大、结构化最完善的「鹈鹕骑单车(Pelican Riding a Bicycle)」大模型 SVG/PNG 参考数据库之一。
过去两年里,从 2024 年 10 月 Simon Willison 提出那句著名的测试提示词 "Generate an SVG of a pelican riding a bicycle" 开始,全球开发者与研究社区累计测试了数百款闭源旗舰与开源权重模型。但这些极其珍贵的视觉证据长期散落在个人博客、X(Twitter)帖子、GitHub Gist、HTML 对比网格以及各类社区榜单中:命名混乱、同一模型存在数十种非规范别名、大量帖子只有低清截图而缺失原始 SVG 代码,很难被评测系统直接程序化调用。
Folkbench/pelican-database 做的事情很直接:把这些分散在全网的“野生鹈鹕”系统性地采集、清洗、归属纠偏、补全源码、统一渲染,最终沉淀为一套开箱即用、对齐 models.dev 命名规范、并由 GitHub Actions 每日自动增量维护的开放数据库,用于驱动 Folkbench 的模型真实性检测与视觉基线比对。
一、一组实打实的数字:为什么它是全球最大最完善的鹈鹕数据库之一
衡量一个参考数据库的价值,不能靠口号,要看覆盖广度、源码完整度、命名规范度与持续维护能力。截至首次公开发布快照(2026-11-22),Folkbench/pelican-database 的核心指标如下:
| 核心维度 | 实测统计 | 说明 |
|---|---|---|
| 汇聚候选样本总量 | 3,875 条 | 融合 UncleK/pelicanmap 社区归档 + Simon Willison 161 篇标签文章、静态对比网格与直链 SVG |
| 规范化后唯一模型数 | 507 款 | 将 799 种碎片化原始名称归并为唯一 provider/model_id |
| 覆盖模型提供商 | 68 家 | 涵盖全球主流闭源实验室、开源权重团队与前沿实验平台 |
原始 .svg 源码完整率 | 454 款(89.5%) | 经 XML/标签校验的可解析原始 SVG,不再只是二手截图 |
统一 .png 视觉基线 | 507 款(100%) | 全部由无头浏览器统一渲染(1024px 宽白底)或标准化转码,0 缺失 |
精确命中活跃 models.dev | 378 款(74.6%) | 其中 190 款精确匹配第一方原生 Provider;其余 129 款历史下线模型同样按规范对齐 |
| 含 Simon Willison 实测记录 | 177 款 | 标注 tested_by_simon,在原帖仅发截图时自动升级补齐真实 .svg |
| 时间跨度 | 2024-10-25 至 2026-11-21 | 完整记录逾两年两代以上大模型空间推理与 SVG 编码能力的跃迁 |
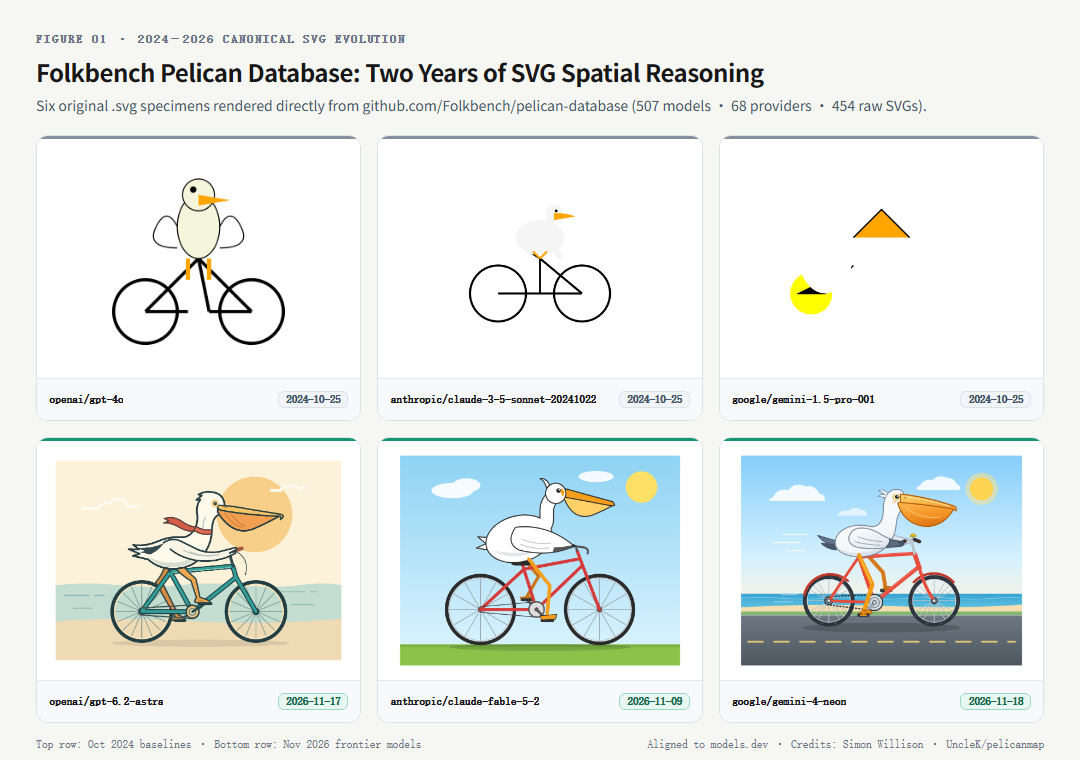
图 1:从 Folkbench/pelican-database 直接调取的 6 份原始 .svg 渲染对比。上排为 2024 年 10 月首批测试的 openai/gpt-4o、anthropic/claude-3-5-sonnet-20241022 与 google/gemini-1.5-pro-001;下排为 2026 年 11 月的 openai/gpt-6.2-astra、anthropic/claude-fable-5-2 与 google/gemini-4-neon。两年间从抽象几何拼接进化到结构完整的角色与机械构图,差距一目了然。
二、五大工程设计:如何把“社区收集”做成“生产级参考库”
图 2:Folkbench/pelican-database 自动化构建与每日增量同步架构。从多源归档与直采出发,经原生厂商归属纠偏与无头浏览器统一出图,最终沉淀为驱动 Folkbench 模型真实性检测的开放参考库。
社区里已经有不少优秀的鹈鹕展示站,但“给人浏览的画廊”与“给评测系统调用的数据库”之间,隔着五道硬工程门槛。我们在构建 Folkbench/pelican-database 时逐一补齐了这些短板:
1. 多源交叉补全,把“截图”升级回“真实 SVG 源码”
许多早期或高频发布的模型,在社交媒体上只流传过压缩截图,但在作者博客的静态 HTML 对比表或直链目录里其实藏着完整的原始 SVG。我们的采集管线不仅同步了 UncleK/pelicanmap 的每日归档[^unclek-pelicanmap],还直接抓取了 Simon Willison 的全部 161 篇标签文章[^simon-pelican-tag]:
- 自动解析
static.simonwillison.net上历次对比网格 HTML 中的data:image/svg+xml;base64嵌入数据,直接还原出 180 份无损原生 SVG; - 自动提取并校验博客中直链托管的原始
.svg文件(例如claude-3-7-sonnet、deepseek-r1、gemini-2.0-pro-exp-02-05、phi-4、glm-5.2等); - 在去重筛选阶段,严格执行 「真实
.svg源码 > Simon Willison 原测 > 标准 classic 提示词 > 默认/高推理档位」 的确定性优先级,同时过滤掉非鹈鹕衍生题(如比格犬、负鼠、浣熊)与多模型拼图,确保每个模型条目干净、可比。
对于全网确实从未公开过 SVG 源码的 53 款模型,我们并未粗暴丢弃,而是显式标注 has_svg: false 并保留标准化 .png,让时间线与覆盖度保持完整。
2. 全面对齐 models.dev,根治模型命名碎片化
做跨平台模型检索与中转站对账,最大的痛点是同一个模型在不同平台有七八种写法。比如 Qwen/Qwen3.6-27B、Qwen3.6-27B (Q4_K_M)、unsloth/Qwen3.6-27B-GGUF:Q4_K_M 实际上指向同一款权重;而某些第三方路由商或云平台还会转售其他实验室的模型(例如把 GLM、DeepSeek 或 MiniMax 挂在自家 Provider 前缀下)。
为此,我们在对齐阶段引入了基于 models.dev/api.json[^models-dev] 的原生厂商归属纠偏规则:
- 统一
provider/model_id主键:如openai/gpt-6.2-astra、anthropic/claude-fable-5-2、google/gemini-4-neon、alibaba/qwen3.6-27b、deepseek/deepseek-v4-pro、zai/glm-5.2、moonshotai/kimi-k3.1-pro; - 覆盖 68 家厂商全谱系:OpenAI(72 款)、Google(64 款)、Alibaba/Qwen(63 款)、Anthropic(30 款)、Meta(21 款)、Mistral(21 款)、DeepSeek(19 款)、Z.AI/GLM(19 款)、xAI(16 款)、Bailing(11 款)、Moonshot AI/Kimi(11 款)、Amazon Bedrock(9 款)、MiniMax(9 款)、Volcengine/Doubao(9 款)、NVIDIA(9 款)等均按原生目录归位;
- 完整保留反查别名表:全部 799 条原始别称都写入了
model_aliases表与raw_model_aliases字段,无论上游传过来的是非正式简称还是带量化后缀的 Hugging Face 路径,都能一键映射回标准 ID。
3. 浏览器级统一渲染与零损校验
LLM 手写的 SVG 经常出现缺失 xmlns、省略 viewBox、未转义 & 符号、或混合使用渐变、滤镜与 <clipPath> 的情况,传统纯脚本矢量库(如 CairoSVG)极易出现文字错位、渐变丢失甚至渲染空白。
我们编写了跨平台的无头浏览器 CDP 渲染管线(兼容 Windows Edge 与 Linux Chromium/Chrome),在隔离的 <img> 沙箱上下文中以统一 1024px 宽度、自适应比例、纯白底与标准留白 将全部 454 份 .svg 渲染为高清 .png,并在建库阶段逐一校验 PNG 文件头、像素宽高与字节数,最终达成 507/507 零错误、零空白。
4. JSON + SQLite 双交付,开箱即用
无论你是做前端展示、视觉模型微调、还是后端探测脚本,都不需要自己重新解析目录:
models/<provider>/<model_id>.{svg,png}:直观的扁平分级文件目录;catalog.json:完整结构化索引,附带models.dev元数据(家族、发布日期、推理能力、是否开源权重)、图片分辨率、字节数、来源链接与完整别名;pelicans.sqlite:规范化的关系型数据库,内置providers、models、model_aliases、model_sources四张表以及v_simon_models、v_svg_models两个视图,一条 SQL 就能完成筛选与统计。
5. GitHub Actions 每日全自动增量同步
大模型几乎每周都在发新版本,静态打包的数据集不出一个月就会过时。Folkbench/pelican-database 内置了完整的 scripts/sync.py 与 .github/workflows/auto-sync.yml:
- 每天
09:00 UTC自动拉取最新models.dev/api.json、UncleK/pelicanmap与 Simon Willison 标签页新文章; - 基于源文件的 SHA-256 哈希比对 执行增量渲染,未变动的样本自动复用缓存,只重新渲染新增或从截图升级为真 SVG 的模型;
- 仅在模型列表或样本内容发生实质变化时自动更新
catalog.json、pelicans.sqlite与中英文 README 统计表并提交,避免无意义的空提交噪音。
三、为什么 Folkbench 要建这座鹈鹕库:驱动模型真实性检测
在之前的文章[《如何给一只骑车的鹈鹕打分?》](/blog/how-to-score-a-cycling-pelican/)与[《发布 Folkbench 降智检测》](/blog/how-folkbench-detects-model-degradation/)中,我们讨论过 AI API 中转站最隐蔽的三类风险:静默偷换小模型、后台压低推理档位(Reasoning Effort)、以及裁剪上下文。
传统的连通率监控只能看见 HTTP 200,直接问模型“你是谁”又很容易被 System Prompt 伪造。而“画一只骑自行车的鹈鹕”恰恰是一道极难伪装的视觉与代码联合指纹题:
- 跨代际区分度极强:把一款宣称是
gpt-6.2-astra或claude-fable-5-2的中转线路实时生成的 SVG,与数据库中该模型同model_id的规范基线,以及同厂商更早期或更轻量型号(如gpt-4o、gpt-5-mini、旧代开源小模型)的基线并排比对,结构完整度、语义对齐和构图复杂度上的断层往往一眼就能看穿。 - 补齐“视觉行为指纹”维度:在 Folkbench 的评测体系里,
Folkbench/pelican-database并不是用来“单凭一张图就给中转站定罪”的草率工具,而是作为公开、可复核的跨代际参考基线库,与降智监控(Integrity Monitor)[^folkbench-arena] 中的动态时事探针、Token 消耗体征、接口指纹及独立官方直连基线相互配合,让模型真实性核验拥有更直观、可公开复查的对照坐标系。 - 服务整个开源评测社区:除了驱动 Folkbench 自身的真实性检测,这份数据库也可以直接用于校准多模态视觉裁判(VLM-as-a-Judge)、研究大模型代码空间推理的代际演化、或构建自动化 SVG 评测集。
四、5 分钟上手使用
你可以直接克隆仓库,或在 Python / SQLite 中秒级查询任意模型的鹈鹕基线:
git clone --depth 1 https://github.com/Folkbench/pelican-database.git
cd pelican-database
SQLite 快速查询
-- 查询所有含 Simon Willison 实测记录且带真实 SVG 源码的模型
SELECT model_id, models_dev_id, svg_path, png_path, date
FROM models
WHERE tested_by_simon = 1 AND has_svg = 1
ORDER BY provider, model_id;

-- 通过非规范别名反查标准 models.dev ID
SELECT a.raw_model, m.model_id, m.svg_path, m.png_path
FROM model_aliases a
JOIN models m ON m.model_id = a.model_id
WHERE a.raw_model LIKE '%Claude 3.7%';

-- 查看覆盖模型数最多的前 10 家 Provider
SELECT provider, model_count, svg_count, simon_tested_count
FROM providers
ORDER BY model_count DESC
LIMIT 10;
Python 快速读取
import json
from pathlib import Path

catalog = json.loads(Path("catalog.json").read_text(encoding="utf-8"))
by_id = {m["model_id"]: m for m in catalog["models"]}

sample = by_id["google/gemini-4-neon"]
print(sample["svg_path"], sample["png_path"], sample["source_url"])
五、开源边界与诚挚致谢(Credits & Acknowledgements)
Folkbench/pelican-database 能够以如此高的完整度快速成型,完全建立在开源社区长期积累的肩膀之上。在此我们向以下先驱、归档维护者与社区项目致以最诚挚的感谢:
- Simon Willison:创立了“用 SVG 画一只骑自行车的鹈鹕”这一影响深远的大模型基准测试,并长期公开记录了 161 篇标签评测文章[^simon-pelican-tag] 与 simonw/pelican-bicycle[^simon-pelican-repo] 原始实验代码。
- UncleK / Pelican Map:以惊人的毅力每日持续维护全球最全的多语言鹈鹕归档库[^unclek-pelicanmap],严谨保存了每一份样本的来源链接、发布日期与原始媒体。
- models.dev:提供开放、标准化的 AI 模型与 Provider 注册表[^models-dev],让数百个来源不一的模型得以统一映射到同一套机器可读坐标系下。
- 所有社区评测站点与测试者:感谢 Tihu(
tihu.app)、Pelican Zoo(pelicanzoo.ai)、Museum of Models(museumofmodels.com)、Pelicans.wtf、Pelican Benchmark 以及活跃在 X、GitHub、Reddit 与 Hugging Face 上的每一位研究者和贡献者。数据库中的每一条记录都完整保留了原始作者、测试日期与出处链接。
关于授权边界:本仓库的采集、对齐、渲染脚本、数据库 Schema 与原创文档采用 MIT License 开源;收录的第三方模型 SVG/PNG 作品及上游元数据仍归原作者与原来源所有,不因归档而改变其原有权利(详见仓库内的 NOTICE.md)。
欢迎访问 github.com/Folkbench/pelican-database[^folkbench-pelican-db] 点亮 Star、提交新模型 PR 或反馈别名修正,一起把这座属于整个 AI 社区的鹈鹕参考库越建越完善。