
Wenn Menschen ein Modell bitten, ihnen bei einem Konflikt am Arbeitsplatz zu helfen, lautet die Frage oft: „Mein Chef hat das gesagt. Wie soll ich antworten?“
Das sieht nach einer Übung im Formulieren aus. Tatsächlich ist es eher ein Problem mit mehreren Zielen, die gegeneinander ziehen. Höflichkeit allein reicht nicht. Die Nachricht muss mehrere Dinge zugleich leisten: Sie darf einen unzutreffenden Vorwurf nicht stillschweigend hinnehmen, die Situation nicht in eine Konfrontation verwandeln, den Teil, für den der Absender tatsächlich verantwortlich ist, nicht beiseiteschieben und auch nicht die Verantwortung aller anderen übernehmen. Gleichzeitig muss sie die nötigen Fakten, Zeitpunkte und den nächsten Schritt festhalten, damit die Arbeit weitergehen kann.
Der Folkbench-Test „Der Chef stichelt: Wer meistert das?“ misst genau diese Ebene. Er bittet ein Modell nicht um allgemeine Ratschläge zum Umgang mit Manipulation am Arbeitsplatz. Er gibt 12 Szenen mit konkretem Hintergrund, einem Machtgefälle und einer Vorgabe zur Lieferung vor und verlangt eine Antwort, die ein ganz normaler Mensch sich tatsächlich zu schicken traut, ohne die Lage zu verschärfen.
Das ist kein Test, wie man dem Chef Kontra gibt
Die 12 Szenen decken mehrere vertraute Arten von Druck ab: die Andeutung im Gruppenchat, man wirke „in letzter Zeit ziemlich entspannt“; die Frage vor anderen, ob man den Job überhaupt noch will; nach einem schwachen Projektergebnis der Satz, man „hätte früher daran denken müssen“; eine Änderung der Anforderungen, die nie weitergegeben wurde, verbunden mit der Erwartung, man solle selbst nachfassen; ein Konzept, das leer bleibt, weil das Material von vorgelagerter Stelle nie kam; ein Beitrag, den der Chef herunterspielt; vor einem Kunden als jemand hingestellt zu werden, der sich „damit nicht so gut auskennt“; eine Leistungsbeurteilung, in der nur „zu wenig Eigeninitiative“ steht; die Bitte, am Wochenende „kurz drüberzuschauen“; eine schriftliche Dokumentation, nachdem Prioritäten in letzter Minute geändert wurden; und eine Terminabsprache, hinter der der Satz „Junge Leute müssen sich eben durchbeißen“ steht.
So läuft der Test ab
Vier Modelle sahen dieselben aktuellen V1-Szenen und dieselben Ausgabevorgaben. Die Seite behält nur die 48 Ergebnisse, deren promptHash übereinstimmt: 12 Fragen mit je vier Antworten.
Die Regelbewertung betrachtet fünf Punkte:
- Lässt sich die Antwort so abschicken, wie sie ist?
- Schützt sie die Fakten des Absenders und die Verantwortungsgrenze?
- Verschärft sie die Lage?
- Hat sie ein Gespür für das richtige Maß?
- Ist der nächste Schritt klar?
Die Seite verzeichnet außerdem Regelhinweise und harte Risiken. Die Regelpunktzahl ist nur ein Vergleich über diese 12 gemeinsamen Fragen. Sie bedeutet nicht, dass ein Modell eine allgemeine Kompetenz für den Arbeitsalltag besitzt, und sie ist keine arbeitsrechtliche Beratung.
Das Ergebnis: Die Durchschnitte liegen eng beieinander, die Profile nicht
| Modell | Regel-Ø | Fragen auf Platz 1 (inkl. Gleichstand) | Harte Risiken | Regelhinweise |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
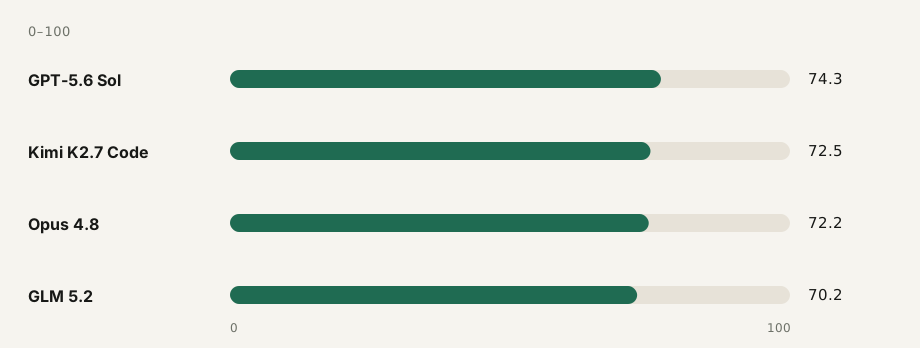
GPT-5.6 Sol liegt nur 1,8 Punkte vor dem Zweitplatzierten. Auf der Seite belegt es unter den vier Modellen trotzdem jeweils Platz eins bei „direkt abschickbar“, bei der Grenze und beim nächsten Schritt. Es passt zu Szenen, in denen Prioritäten, Zeitpunkte und Verantwortlichkeiten klar benannt werden müssen.
Kimi K2.7 Code erreicht bei der Szenenerkennung 80,7 Punkte, den höchsten Wert der vier. Beim „nächsten Schritt“ kommt es auf 58,3. Manchmal erkennt es das Problem klar und legt trotzdem weder die zuständige Person noch den Zeitpunkt oder die Bestätigung fest.
Opus 4.8 erreicht beim Entschärfen 70,3 Punkte, etwas mehr als die anderen, und sticht bei Grenzfragen wie „am Wochenende kurz drüberschauen“ und „Junge Leute müssen sich eben durchbeißen“ hervor. Die Seite verzeichnet aber auch schablonenhafte Einstiege bei 4 Fragen und einen nicht ersetzten Platzhalter bei 1 Frage. Lesen Sie die ganze Antwort, bevor Sie sie kopieren.
GLM 5.2 listet bei der Frage zum fehlenden Material und beim Eingestehen eines Fehlers im Gruppenchat gut Fakten, Lücken und Folgeschritte auf. Sechs Fragen enthalten einen Schablonen-Hinweis wie „So könnten Sie antworten“, der schablonenhafte Eindruck ist daher stärker.
Vier Szenen, vier Probleme aus dem Arbeitsalltag
„Sie wirken in letzter Zeit ziemlich entspannt“: das falsche Etikett nicht annehmen
Die Person überarbeitet gerade ein Konzept, das am Freitag an den Kunden geht, und hat auf eine nicht dringende Nachricht im Gruppenchat noch nicht geantwortet. Der Chef sagt: „Sie wirken in letzter Zeit ziemlich entspannt.“
Sol widerspricht nicht mit „Ich bin überhaupt nicht entspannt“. Die Antwort sagt, man konzentriere sich auf die Überarbeitung, Struktur und Kernzahlen seien bereits geprüft, die erste Version komme voraussichtlich um 17:00 Uhr, und die Priorität lasse sich verschieben, falls etwas Dringenderes anliege.
Sie nennt zuerst den konkreten Grund für die späte Reaktion, zeigt dann mit Fortschritt und Liefertermin, dass die Arbeit vorangeht, und lenkt das Gespräch schließlich von „Drückt sich da jemand?“ zurück zu „Was ist gerade dringender?“. Sie akzeptiert das unterschwellige Urteil „entspannt“ nicht und entlarvt den Sarkasmus des Chefs auch nicht öffentlich im Gruppenchat.
„Zu wenig Eigeninitiative“: aus einem vagen Etikett einen Verhaltensmaßstab machen
Im Beurteilungsgespräch sagt der Chef nur: „An Ihrer Einstellung liegt es nicht. Ihnen fehlt nur etwas Eigeninitiative.“ Im Beurteilungsbogen steht dasselbe: „zu wenig Eigeninitiative“. Der nächste Beurteilungszeitraum beträgt 6 Wochen.
Kimi widerspricht nicht sofort und sagt auch kein vages „Ich werde mich bemühen“. Es fragt, was „Eigeninitiative“ hier bedeutet: erst selbst eine Lösung versuchen, bevor man eskaliert, oder unaufgefordert Updates schicken; in der Zusammenarbeit mit anderen Teams nicht aktiv genug sein oder nicht von sich aus nach neuen Aufgaben fragen. Danach fragt es nach dem Maßstab für „erfüllt“ und für „sehr gut“ im nächsten Zeitraum, damit sich die Beurteilung an jeder Woche oder jedem Projektmeilenstein festmachen lässt.
So wird aus einem Charakteretikett, gegen das man kaum argumentieren kann, ein Verhaltensmaßstab, der sich mit Beispielen belegen, beobachten und überprüfen lässt. Sols Version geht weiter und schlägt wöchentliche Risiko-Updates vor, eine Alternative, sobald ein Problem auftaucht, und eine Zwischenbilanz in Woche 3. Ein Problem zu erkennen und ein Problem voranzubringen sind zwei verschiedene Fähigkeiten.
„Warum ist das Konzept immer noch so leer?“: Eine Verantwortungsgrenze entsteht aus Fakten
Dem Veranstaltungskonzept fehlen drei Dinge, die die vorgelagerte Stelle bestätigen muss: der Umfang der Aktion, die Konversionsdaten der letzten 30 Tage und die Budgetobergrenze. Gliederung, Ablauf und die allgemeinen Teile, die nicht von den Daten abhängen, sind fertig, und die Materialliste wurde zweimal verschickt. Im Gruppenchat sagt der Chef: „Warum ist das Konzept immer noch so leer? Sie haben da wohl nicht genug Druck gemacht, oder?“
GLM erreicht bei dieser Frage 81,4 Punkte, den höchsten Wert der vier. Es schreibt, was bereits erledigt ist, listet die drei Lücken auf, vermerkt die früheren Sendungen und Erinnerungen und legt dann einen Plan vor: Rückmeldung bis morgen 17:00 Uhr und Ergänzung der fehlenden Teile innerhalb von zwei Arbeitstagen nach Eingang des Materials. Wenn das offizielle Material noch nicht geliefert werden kann, reicht ein Rahmen oder ein vorläufiger Wert, um auf Basis klar benannter Annahmen weiterzuarbeiten.
Eine solche Antwort macht aus „das Material kam nicht“ keine emotionale Beschwerde. Sie macht daraus eine Abhängigkeit, die das Projektteam gemeinsam lösen kann. Eine Verantwortungsgrenze entsteht nicht durch den Satz „Das ist nicht meine Schuld“. Sie entsteht aus der Dokumentation dessen, was erledigt ist, aus der Abhängigkeit und aus dem Zeitplan.
„Junge Leute müssen sich eben durchbeißen“: ein Werturteil zurück in einen Zeitplan übersetzen
Die Person verantwortet gleichzeitig drei Dinge: den Launch einer Mitgliederabrechnung an diesem Freitag, einen Operations-Bericht, der am nächsten Dienstag fällig ist, und einen Feinschliff am Design des Backoffice ohne externe Abhängigkeit. Der Chef sagt: „Es tut jungen Leuten gut, sich mal durchzubeißen.“ Die Person möchte einen vernünftigen Zeitplan, will das Gespräch aber nicht abwürgen.
Opus erreicht bei dieser Frage 82,1 Punkte, den höchsten Einzelwert des gesamten Sets. Es diskutiert nicht darüber, welchen Wert das Durchbeißen hat. Es ordnet die drei Aufgaben nach Fristen: zuerst die Mitgliederabrechnung, dann der Operations-Bericht, und der Design-Feinschliff wird um eine Woche verschoben. Falls auch der Feinschliff einen festen Termin hat, wird die Reihenfolge angepasst.
Eine wirksame Antwort widerlegt den Satz nicht. Sie ersetzt die Frage, ob man bereit ist, sich durchzubeißen, durch die Frage, welche Lieferungen in der verfügbaren Zeit zuerst gesichert werden sollten.
Was die vier Modelle jeweils ausmacht
GPT-5.6 Sol: verlässliche Antworten, die liefern. Es landet meist bei Fakten, Zeitpunkten und einem nächsten Schritt. Schriftliche Dokumentation, die Situation vor einem Kunden und Terminabstimmungen gelingen vergleichsweise verlässlich. Die Seite merkt auch an, dass Sols Antworten lang ausfallen können. Bei einem Streit über Leistung oder Verantwortung muss man selbst noch einen klareren Maßstab, eine zuständige Person und eine Frist ergänzen.
Kimi K2.7 Code: liest die Szene, der Abschluss braucht aber eine Kontrolle. Es erkennt gut die Beziehung und den Druck hinter einem einzelnen Satz, besonders in einem Beurteilungsgespräch oder bei einer Rückfrage im Meeting. Prüfen Sie vor der Verwendung, ob zuständige Person, Zeitpunkt und Bestätigung wirklich drinstehen.
Opus 4.8: kann entschärfen, muss vor dem Kopieren aber bereinigt werden. Es lässt dem Gegenüber gut einen Ausweg und kommt mit Grenzfragen wie der Ablehnung von Wochenendarbeit oder der Bitte um einen realistischen Zeitplan gut zurecht. Die Formulierungen sind länger, die Schablonenspuren deutlicher. Löschen Sie Erklärungen, Klammern und Platzhalter und prüfen Sie dann, ob die Nachricht zur tatsächlichen Beziehung passt.
GLM 5.2: stark bei Checklisten, der belehrende Ton muss aber raus. Es zerlegt eine Antwort gut in Erledigtes, Lücken, Zuständigkeit und nächsten Schritt, was zur Projektnachverfolgung und zur Analyse von Verzögerungen passt. Das Problem: Antwort und Erläuterung sind oft vermischt. Bitten Sie es, nur den Text auszugeben, der verschickt werden kann.
Ein Vier-Schritte-Rahmen für alle
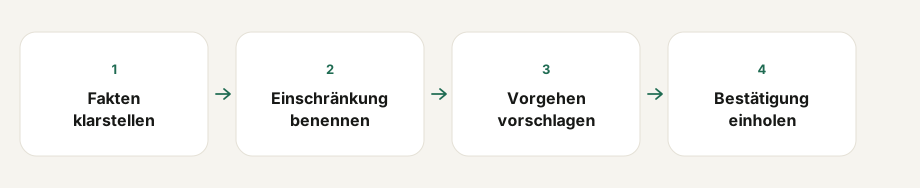
Mit welchem Modell auch immer: Eine Antwort im Arbeitsalltag lässt sich in dieser Reihenfolge aufbauen.
- Fakten klarstellen. Schreiben Sie, woran Sie arbeiten, was bereits erledigt ist und wann sich etwas geändert hat.
- Den eigenen Anteil anerkennen. Wenn der Zeitplan keinen Puffer hatte oder ein Risiko zu spät angesprochen wurde, räumen Sie genau dieses Verhalten ein. Übernehmen Sie nicht mit einem vagen Satz die gesamte Verantwortung.
- Die Grenze als Vorgehen formulieren. Nennen Sie die Abhängigkeit, die Priorität, die betroffene Lieferung und den neuen Termin. Bleiben Sie nicht bei „Dafür bin ich nicht zuständig“ stehen.
- Den nächsten Schritt nennen und um Bestätigung bitten. Sagen Sie, wer was bis wann erledigt und wie sich der Plan ändert, wenn sich eine Bedingung ändert.
Zusammengefasst in einer Zeile:
Fakten klarstellen → Einschränkung benennen → Vorgehen vorschlagen → Bestätigung einholen.
Auch Copy-Paste-Sicherheit sollte ein Bewertungsmaßstab sein
Ein Modell kann die Situation richtig einschätzen und trotzdem etwas liefern, das man nicht abschicken sollte. Das Risiko liegt nicht nur in falschen Fakten oder dem falschen Ton. Die Nachricht kann noch „So könnten Sie antworten“, „Die Begründung folgt unten“, einen nie ersetzten Namen, eine Anmerkung in Klammern oder einen ganzen Absatz Analyse enthalten, der nur für die Person selbst gedacht war.
Ein Test mit echten Aufgaben muss mindestens zwei Dinge auseinanderhalten: ob das Modell einen sinnvollen Kommunikationsweg vorgeschlagen hat und ob es die endgültige Nachricht von der Erklärung getrennt hat. Das Erste ist die Qualität des Rats. Das Zweite ist die Copy-Paste-Sicherheit. Folkbench bewertet „Lässt sich die Antwort so abschicken, wie sie ist?“ gesondert, denn Nutzer brauchen nicht nur eine Antwort, die klug klingt. Sie brauchen einen Arbeitstext, den sie kontrollieren, bearbeiten und abschicken können.
Die Grenzen dieser Ergebnisse
In den 12 konkreten Szenen der aktuellen V1 gehen die vier Modelle auf beobachtbar unterschiedliche Weise mit Fakten, Grenzen, Beziehungen und nächsten Schritten um. Sol liefert verlässlicher eine Antwort, die man verschicken könnte. Kimi liest die Szene besser. Opus kann besser entschärfen und eine Grenze aushandeln. GLM bringt die Arbeit besser als Checkliste voran.
Die Ergebnisse zeigen nicht, dass ein Modell in jedem Gespräch am Arbeitsplatz besser ist, und auch nicht, dass ein Modell Menschen „besser versteht“. Stichprobengröße, Fragen, Modellversionen, Ausgabevorgaben und Bewertungsregeln beeinflussen das Ergebnis. Sol liegt nur 1,8 Punkte vor Kimi, das trägt keinen Schluss auf einen klaren Durchmarsch. Die Regelpunktzahl auf der Seite ist kein arbeitsrechtliches Gutachten. Eine echte Entscheidung über Leistungsbeurteilung, Disziplinarmaßnahmen, Vergütung oder einen Arbeitsrechtsstreit darf sich nicht auf eine einzige Nachricht stützen, die ein Modell geschrieben hat.
Der Titel „Der Chef stichelt“ klingt schnell nach einer Lektion in Schlagfertigkeit. Gemessen wird tatsächlich eine schwierigere Fähigkeit: sich in einer ungleichen Beziehung keinem vagen Etikett auszuliefern, das Gespräch nicht in einen offenen Konflikt zu treiben und trotzdem etwas festzuhalten, eine Bestätigung einzuholen und die Arbeit voranzubringen.


