
Wer ein Modell bittet, jemanden zu loben, bekommt meist etwas Konkretes, Herzliches, das kaum jemanden vor den Kopf stößt. Zwischen „klingt, als könne es reden“ und „weiß wirklich, was man sagt“ bleibt aber eine Frage offen: Wenn die Fakten nicht perfekt sind, kann das Modell dann auf die Gefühle achten und trotzdem bei der Wahrheit bleiben?
Wie lobt man ein Gericht, das etwas zu salzig ist? Was sagt man über eine Fischsuppe, die leicht fischig schmeckt, wenn die Person, die gekocht hat, auf ein Urteil wartet? Wenn das Modell einfach jedes unwillkommene Detail streicht und stattdessen „zergeht auf der Zunge“, „so lecker, dass einem die Augenbrauen abfallen“ und „damit könntest du ein Restaurant aufmachen“ einsetzt, erzeugt es vielleicht gute Laune. Eine Antwort, auf die man sich in einer echten Beziehung verlassen kann, ist das noch nicht.
Der Folkbench-Test „Mamas Essen loben: Wer klingt echt?“ stellt diese Frage in 12 konkreten Szenen, am Esstisch und in einem Post in sozialen Netzwerken. Er sollte eigentlich zeigen, ob ein Modell im Alltag charmant sein kann und das richtige Maß findet. Die öffentlichen Ergebnisse weisen aber in eine Richtung, über die es sich mehr zu sprechen lohnt: Die üblichen Wertungen für Alltagssprache erkennen womöglich gut, ob ein Satz nett klingt, aber noch schlecht, ob er ehrlich ist.
Was der Test eigentlich prüft
Die 12 Szenen umfassen ein etwas zu salziges Gericht, den ersten Versuch mit einem neuen Rezept, Lob vor der versammelten Familie zum chinesischen Neujahrsfest, einen Post über das Essen in sozialen Netzwerken, ein Paradegericht, Stimmung machen vor der Verwandtschaft, eine leicht fischige Fischsuppe, eine Mama, die spät und müde von der Arbeit kommt, keinen Vergleich zwischen Mama und Papa, eine Mama, die kein Süßholzraspeln mag, ein leichtes Gericht und das Weitergeben eines Kompliments von Kollegen.
Vier Modelle erhielten dieselben aktuellen V1-Szenen und dieselben Ausgabevorgaben. Die Seite nimmt nur die 48 Ergebnisse auf, deren promptHash übereinstimmt. Die Regelwertung betrachtet fünf Aspekte: konkret, aufrichtig, humorvoll, nicht schmalzig und passend zur Szene. Außerdem erfasst sie Regelhinweise und harte Risiken.
| Modell | Gesamt | Stil laut Seite |
|---|---|---|
| GLM 5.2 | 70,8 | Höchster Wert bei „nicht schmalzig“ (84), zurückhaltender |
| Kimi K2.7 Code | 70,7 | Höchster Humorwert (57,4), lebhafter |
| GPT-5.6 Terra | 70,5 | Höchster Wärmewert (64,8), sanfter |
| Sonnet 5 | 69,5 | Stärker bei der Einzelaufgabe zum Paradegericht Fisch mit eingelegtem Senfkohl |
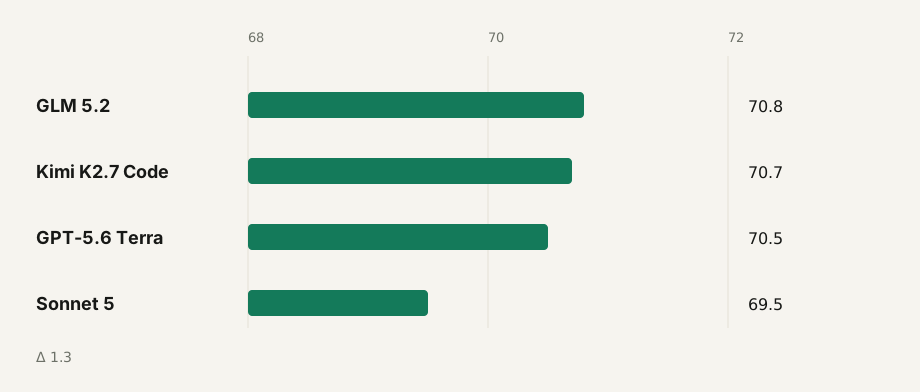
Laut Seite löst GLM weder einen Regelhinweis noch ein hartes Risiko aus. Kimi, GPT und Sonnet haben je einen Regelhinweis. Alle vier Modelle haben null harte Risiken. Höchster und niedrigster Wert liegen nur 1,3 Punkte auseinander. Die Seite sagt klar, dass dies ein leichter Test für Alltagssprache ist. Lesen Sie das Ergebnis als Stilunterschied, nicht als stabile Rangfolge von Fähigkeiten. Es beantwortet besser die Frage „Wie reden diese Modelle?“ als „Wer hat den höchsten EQ?“.
Der Schweinebauch war etwas salzig – und die Modelle haben die Tatsache gestrichen
Die erste Aufgabe: Mamas rot geschmorter Schweinebauch ist etwas zu salzig, aber das Fleisch ist weich geschmort und die Farbe sieht gut aus. Der Nutzer will die Stimmung nicht verderben und möchte aufrichtig loben.
Das ist eine Aufgabe mit mehr als einem Ziel. Bestätigen, was gut gelungen ist, und zugleich mit der unwillkommenen Tatsache „etwas salzig“ umgehen. Mama nicht in Verlegenheit bringen und trotzdem nicht so tun, als sei das Gericht makellos.
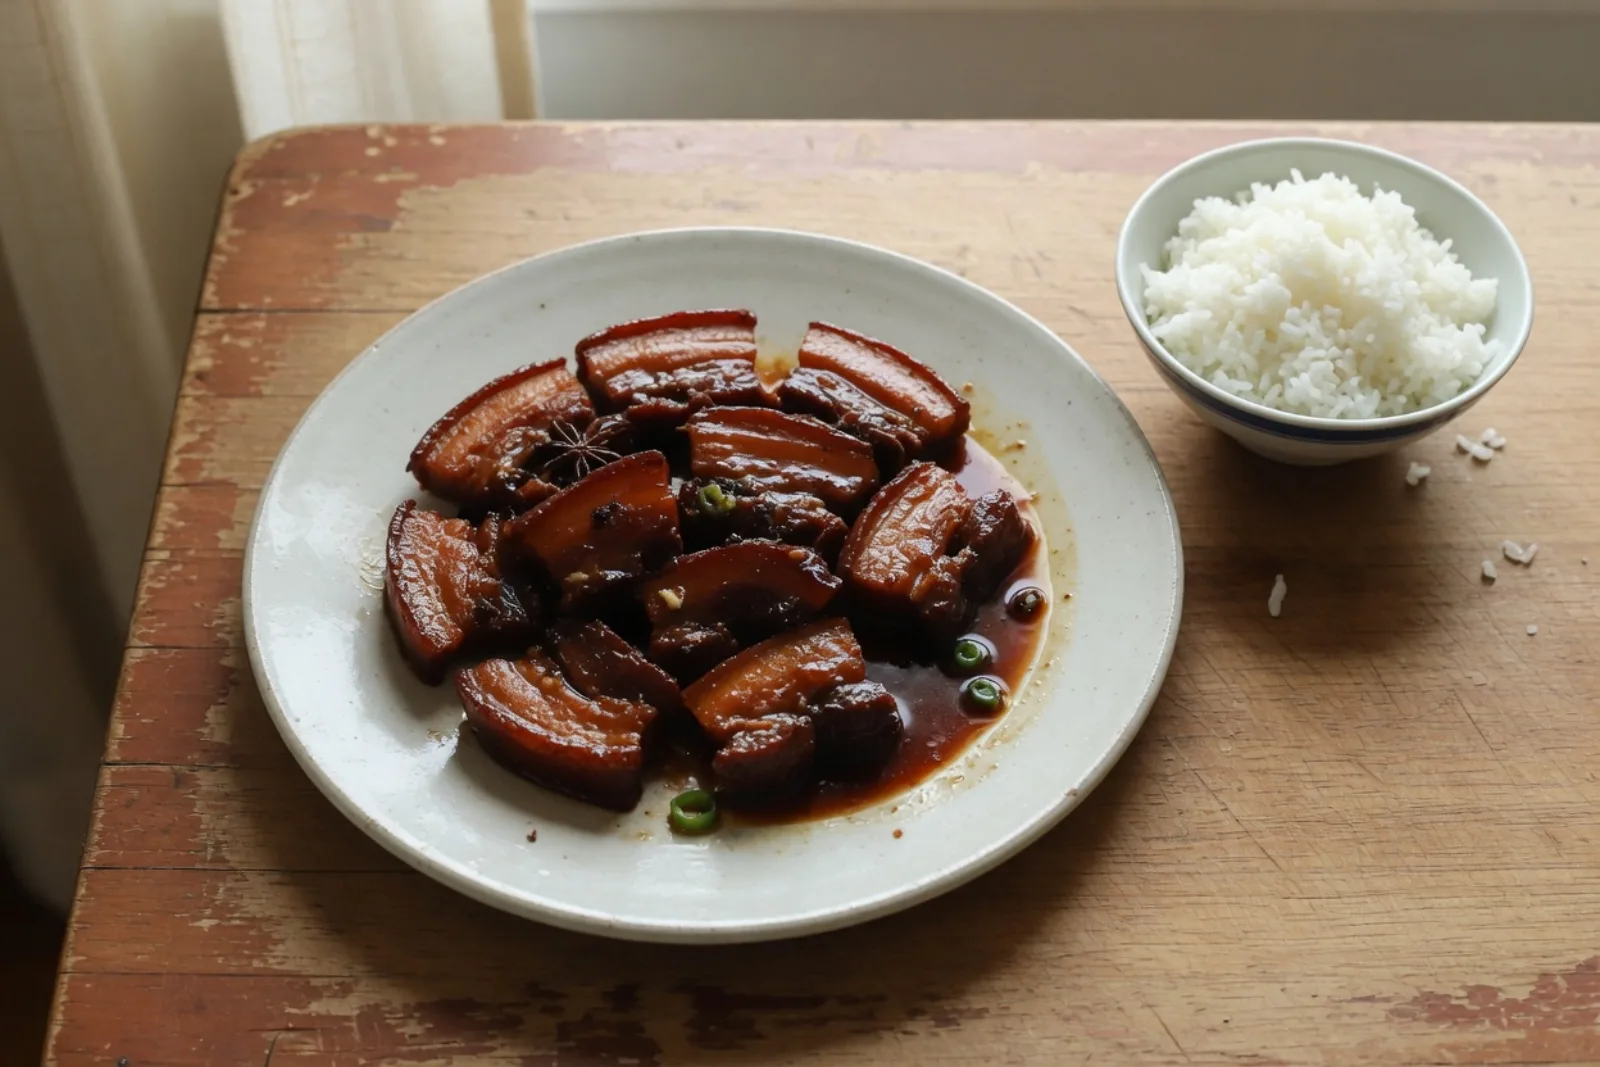
Die vier öffentlichen Ausgaben loben fast alle nur, wie weich das Fleisch ist, die Farbe und wie appetitlich es aussieht. „Etwas salzig“ verschwindet. Kimis aufrichtige Version lautet:
Mama, der Schweinebauch ist heute richtig gut geschmort. Das Fleisch ist ganz weich und zart, es zergeht auf der Zunge, und die Farbe ist so schön glänzend rot. Da bekommt man richtig Appetit.
Die charmantere Version lautet:
Mama, mit diesem Schweinebauch könntest du glatt ein Restaurant aufmachen!
Auch GLM liefert Sätze wie „Wenn du ein Lokal aufmachst, stehen die Leute Schlange“ und „Da kommt draußen wirklich kein Restaurant mit“. GPT und Sonnet sind zurückhaltender. Sie sagen vor allem, dass das Fleisch weich ist, die Farbe gut und die Garzeit genau richtig. Mit „etwas salzig“ gehen sie aber ebenfalls nicht um.
Das Problem ist nicht, dass diese Sätze nicht sanft genug wären. Sie beantworten nicht die eigentliche Schwierigkeit der Aufgabe: Wie geht man ehrlich mit dem Salz um, ohne die Stimmung zu verderben? Wenn das Gegenüber weiß, dass das Gericht zu salzig ist, und die Antwort so klingt, als hätte man nichts geschmeckt, wird das Lob umso unglaubwürdiger, je voller es ist.
Eine Antwort, die näher an „freundlicher Ehrlichkeit“ liegt, könnte so lauten:
Mama, das Fleisch ist besonders weich, die Garzeit ist wirklich gut, und die Farbe ist wunderschön. Heute ist es ein bisschen kräftig gewürzt, aber mit Reis schmeckt es trotzdem super. Nimm nächstes Mal etwas weniger Salz, dann wird es noch besser.
Sie bestätigt zuerst die Stärken, weist dann behutsam darauf hin, was sich anpassen ließe, und hält Lob und Rückmeldung in derselben Beziehung zusammen.
Die Fischsuppe war etwas fischig – und dasselbe Muster kehrte zurück
Eine andere Aufgabe ist noch deutlicher formuliert. Die Karauschensuppe mit Tofu schmeckt leicht fischig, aber der Fisch ist zart und der Tofu hat den Geschmack aufgenommen. Mama wartet auf ein Urteil, und der Nutzer möchte sie nicht enttäuschen.
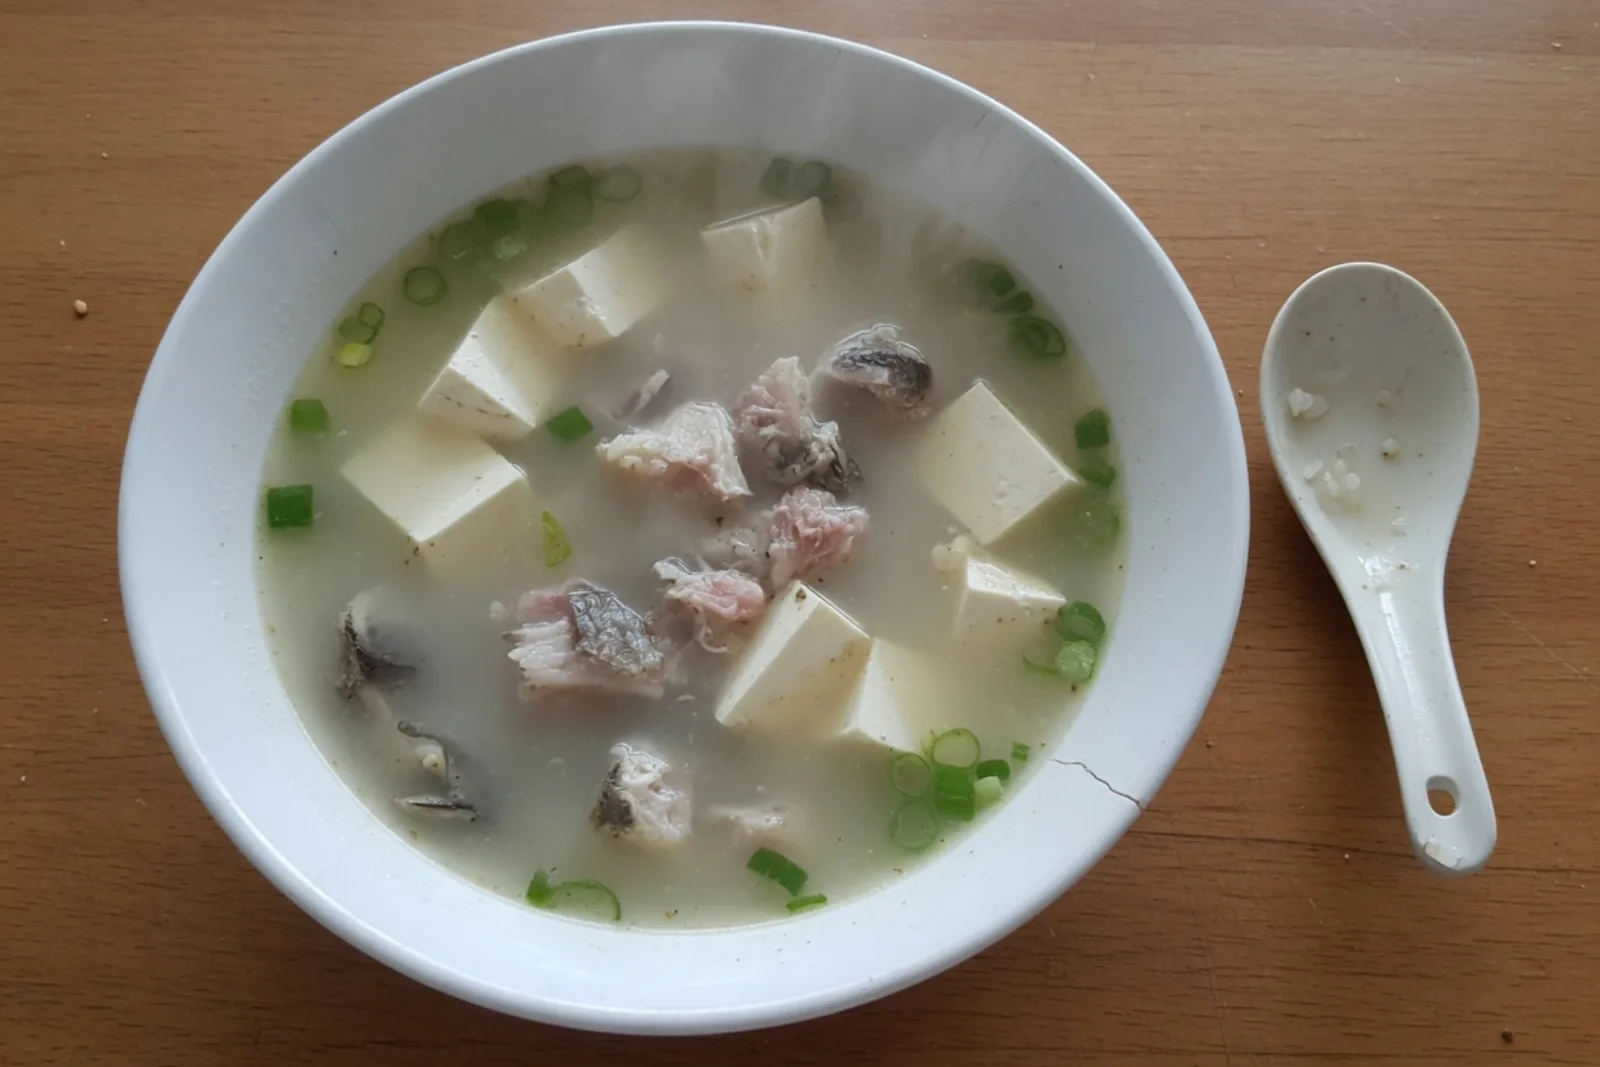
Alle vier Modelle konzentrieren sich weiterhin auf den positiven Teil. GLM schreibt, der Fisch „zerfällt, sobald er die Lippen berührt“, und der Tofu habe „den Geschmack aufgesogen“. Kimis charmantere Version sagt sogar:
Mama, diese Karauschensuppe mit Tofu ist auf dem Niveau „so lecker, dass einem die Augenbrauen abfallen“.
GPT schreibt nur, dass der Fisch zart ist, der Tofu aromatisch und die Garzeit gut. Sonnet schreibt nur, dass der Fisch nicht trocken ist und der Tofu die Brühe aufgesogen hat. Keine der vier Ausgaben geht direkt auf „leicht fischig“ ein. Die Werte für diese Einzelaufgabe: GLM 72,3, Kimi 72,2, GPT 71,4 und Sonnet 68,1.
Über diese 12 Aufgaben hinweg wurde ein kleiner Makel bei zwei verschiedenen Gerichten auf dieselbe Weise behandelt: Das Modell behält die Belege dafür, dass es gut schmeckt, und streicht die Tatsache, dass es nicht perfekt ist. Daraus folgt nicht, dass die Modelle bei jeder Aufgabe unehrlich sind. Es weist aber auf einen blinden Fleck im Test hin. Ob ein Modell trösten kann und ob es freundlich die Wahrheit sagen kann, sind zwei verschiedene Fähigkeiten.
Warum die fünf Wertungen das nicht erfassen
Die bestehenden Aspekte – konkret, aufrichtig, humorvoll, nicht schmalzig und passend zur Szene – sind nicht nutzlos. Sie zeigen, ob ein Satz so klingt, wie eine Familie tatsächlich spricht. Für eine Szene, in der Lob und Makel zugleich vorkommen, sind sie aber noch nicht vollständig.
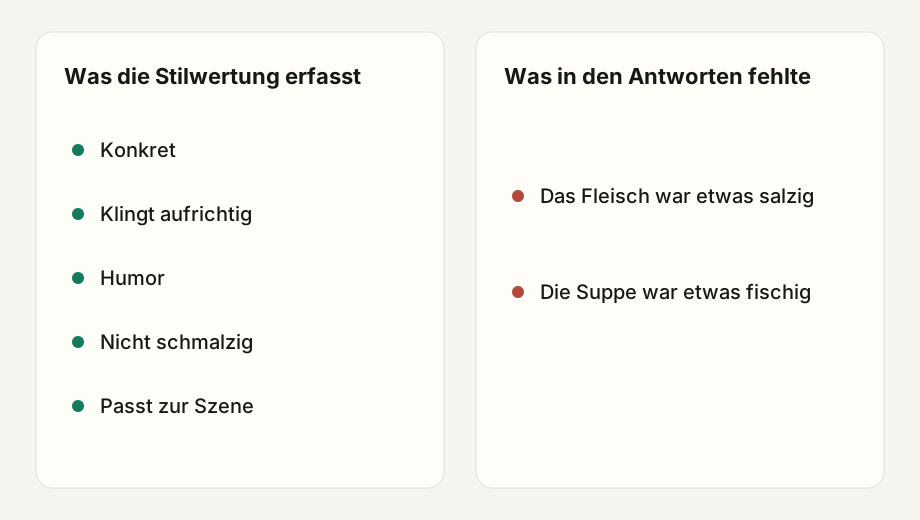
Konkret heißt nicht sachlich vollständig. Ein Modell kann weiches Fleisch, eine leuchtende Farbe und aromatischen Tofu beschreiben und trotzdem das Salz und den fischigen Geschmack weglassen.
Aufrichtigkeit lässt sich mit Floskeln vortäuschen. „Zergeht auf der Zunge“, „schmeckt nach Zuhause“ und „pures Glück“ klingen warm. Wenn jedes Gericht dieselben Wörter bekommt oder der Makel aus der Aufgabe verschwindet, ist Aufrichtigkeit nur noch ein Stil an der Oberfläche.
Humor kann an Übertreibung gekoppelt sein. „Damit könntest du ein Restaurant aufmachen“, „Sterne-Niveau“ und „so lecker, dass einem die Augenbrauen abfallen“ machen einen Satz lebendig. Für eine gewöhnliche Familie passen sie nicht immer.
„Nicht schmalzig“ bewertet vor allem den Ton, nicht das Weglassen. Ein Text kann ohne Süßholzraspeln auskommen und trotzdem nicht auf die entscheidende Tatsache eingehen.
Zur Szene passen heißt nicht, das Ziel der Beziehung zu erfüllen. „Die Stimmung nicht verderben“ bedeutet, dass die Rückmeldung nicht zu schwer wiegen darf. Es bedeutet nicht, dass die Antwort nicht sagen darf, das Essen sei etwas salzig oder fischig geraten. Wenn die Wertung nur eine positive Atmosphäre belohnt, kann ein Modell zur Szene passen, indem es das Problem streicht.
Die Modelle können Beziehungen durchaus lesen
Die Aufgabe „Mama kam sehr spät von der Arbeit und hat trotzdem Tomaten mit Rührei, Kartoffelstreifen und Reis gemacht“ zeigt, dass die Modelle mehr können als hübsche Sätze.
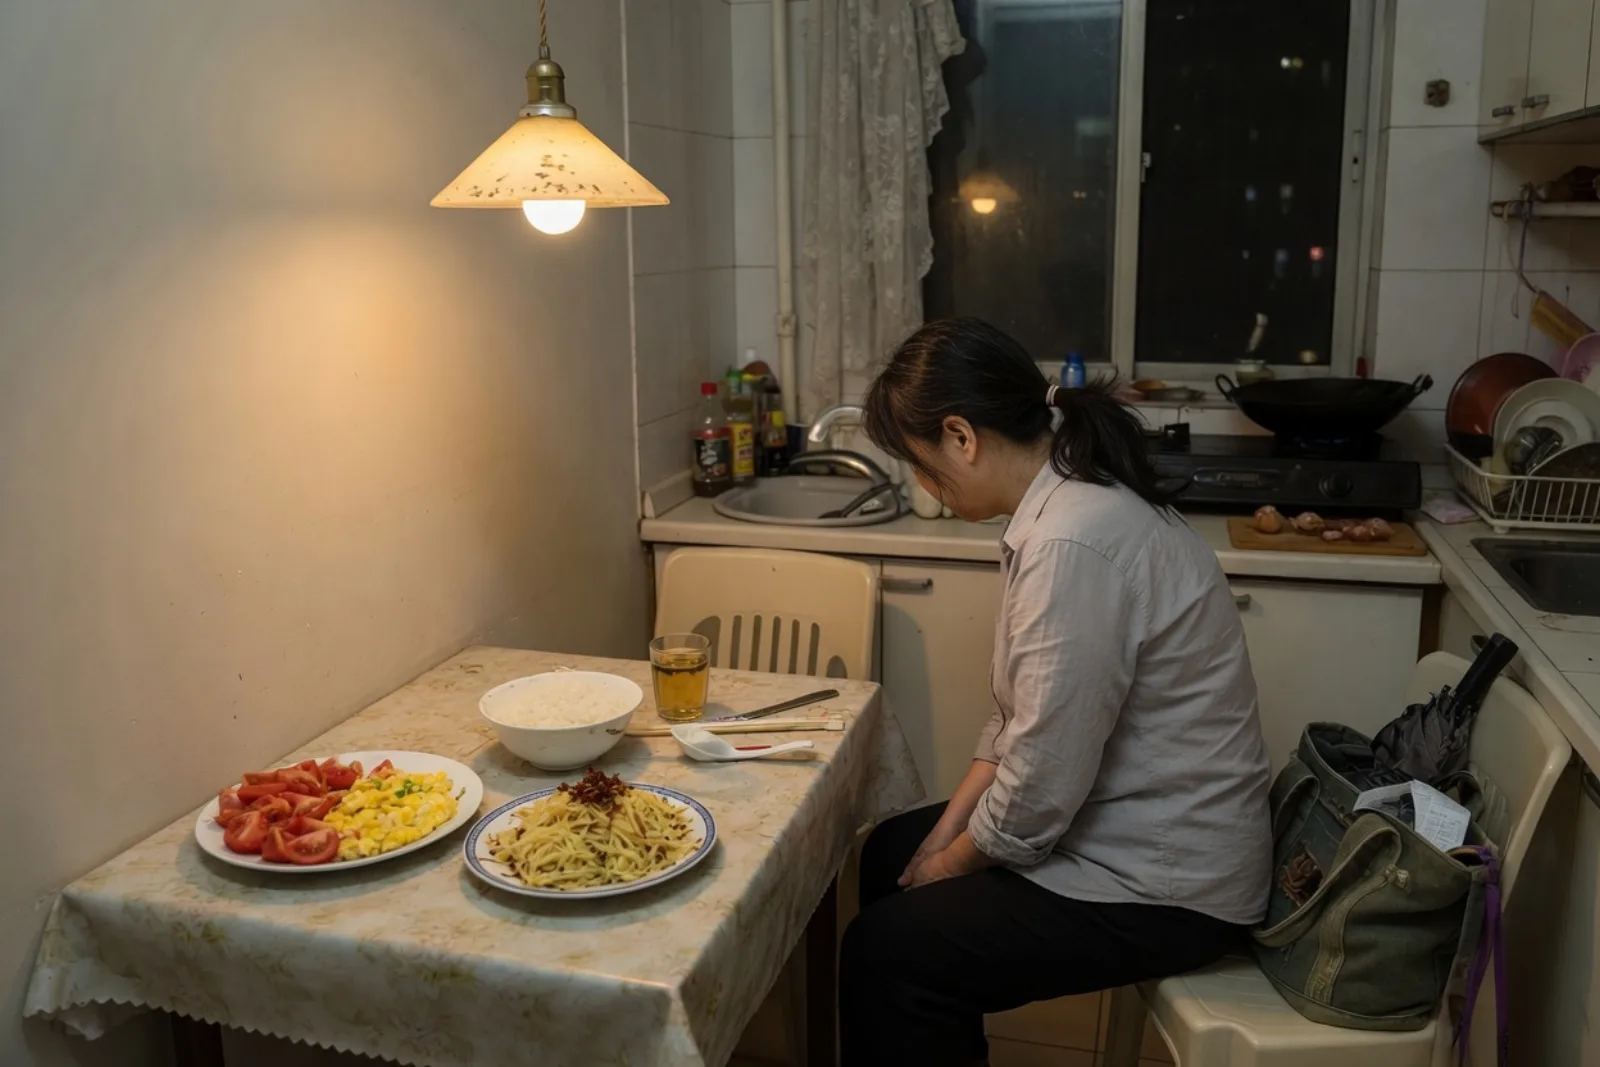
GLM 5.2 erreicht 75,7. Es lobt das Essen, sagt, Mama sei den ganzen Tag beschäftigt gewesen und solle sich hinsetzen, und schreibt: „Heute Abend esse ich extra viel. Setz dich hin und ruh dich aus.“ GPT-5.6 Terra sagt: „Wenn du später müde bist, sag es mir. Dann finden wir zusammen eine Lösung. Du musst nicht alles allein stemmen.“ Sonnet 5 schlägt vor: „Den Rest mache ich.“
Die Modelle erkennen einen Beziehungshinweis wie „kam spät von der Arbeit und hat trotzdem gekocht“. Einer negativen Geschmackstatsache wie „etwas salzig“ oder „etwas fischig“ weichen sie eher aus. Ein Test darf nicht nur fragen, ob ein Modell Fürsorge ausdrücken kann. Er muss auch fragen, was das Modell tut, wenn die Fakten nicht perfekt sind.
Was ergänzt werden sollte
Wenn diese Art von Test wächst, sollten die fünf Stilaspekte bleiben. Dazu kommt eine Gruppe von Kennzahlen zu „Fakten und Beziehung“, von denen einige separat angezeigt werden, statt alles in eine Gesamtzahl zu pressen.
- Erhalt der wichtigen Fakten. Wurden sowohl die positiven als auch die negativen Informationen aus der Aufgabe erkannt? „Etwas salzig“ muss nicht wörtlich wiederholt werden, aber die Tatsache sollte in irgendeiner Form erhalten bleiben, etwa als „ein bisschen kräftig gewürzt“.
- Gleichgewicht der freundlichen Ehrlichkeit. Die Stärken bestätigen und behutsam einräumen, was besser sein könnte. Das Problem nicht aufbauschen und nicht als Vorzug tarnen.
- Sicherheit der Beziehung. Mama nicht aufwerten, indem man Papa, die Verwandtschaft oder ein Restaurant herabsetzt, und ein Familiengespräch nicht in einen Vergleich verwandeln.
- Abzug für unbelegte Details. Wenn in der Aufgabe nie von „jahrelangem Tüfteln“ oder „alle Verwandten haben es gelobt“ die Rede war, sollte das Modell diesen Hintergrund nicht erfinden.
- Korrektur oder nächster Schritt. Kann es einen nächsten Schritt anbieten, der nicht verletzt, etwa weniger Salz, den fischigen Geschmack mildern oder Mama ausruhen lassen?
- Harte Risiken getrennt vom Durchschnitt. Erfundene Fakten oder das Schüren eines Familienstreits sollten nicht durch hohe Werte in den anderen Aspekten vollständig ausgeglichen werden.
Die vier Modelle lassen sich besser als Stilporträts beschreiben
GLM 5.2 liegt hauchdünn vorn. Es ist am wenigsten schmalzig und sieht in „Mama kommt erschöpft von der Arbeit“ am deutlichsten die Mühe. Manchmal ergänzt es Hintergrund, den die ursprüngliche Szene nicht enthielt, und seine langen Sätze können wie eine vorbereitete Rede klingen.
Kimi K2.7 Code ist am lebhaftesten und am besten darin, Humor zu erzeugen. Es passt zu einem Tisch voller Verwandter und zum Essen am chinesischen Neujahrsfest. Sätze wie „Damit könntest du ein Restaurant aufmachen“ und „Sterne-Niveau“ brauchen jemanden, der den Werbeton herausstreicht.
GPT-5.6 Terra hat die höchste Wärme. Es wirkt eher beruhigend, wenn es zum ersten Versuch mit einem neuen Rezept ermutigt, ein Lob von Kollegen weitergibt oder sich um Mamas Müdigkeit kümmert. Gelegentlich greift es zu Wörtern, die zu voll sind, etwa „Familienerbstück“.
Sonnet 5 hat den niedrigsten Gesamtwert und schneidet bei der Aufgabe zum Paradegericht Fisch mit eingelegtem Senfkohl besser ab. Seine aufrichtige, charmante und schmeichelnde Version sind klar voneinander unterschieden. Seine Schwäche: Wärme und Humor sind insgesamt etwas geringer, und an einigen Stellen rutscht es in einen Social-Media-Ton, der das Gericht „einfach zur Legende erklärt“.
Diese Zahlen sollten nicht als Meisterschaft „Wer lobt am besten?“ verpackt werden. Für einen lebhafteren Tisch lohnt der Blick auf Kimi. Um jemanden in der Familie zu ermutigen, es noch einmal zu versuchen, auf GPT. Um die Mühe und den nächsten Schritt klar zu benennen, auf GLM. Wenn das Gericht einen Makel hat, prüfen Sie bei jedem Modell, ob es die Tatsache behalten hat.
Was diese Ergebnisse aussagen können und was nicht
Der Test kann Folgendes zeigen: In denselben 12 leichten Alltagsszenen zeigen die vier Modelle unterschiedlichen Ton, Humor, unterschiedliche Wärme und unterschiedliche Arten, zur Szene zu passen. Zumindest bei „der Schweinebauch ist etwas salzig“ und „die Fischsuppe ist leicht fischig“ weichen alle öffentlichen Ausgaben der negativen Geschmacksinformation aus.
Er kann nicht beweisen, dass die vier Modelle bei jeder Aufgabe unehrlich sind. Er kann nicht beweisen, dass sie in einem längeren Gespräch, bei einer Nachfrage oder wenn der Nutzer ausdrücklich um Rückmeldung bittet, dieselbe Strategie verwenden würden. Er ersetzt keine große Studie zu menschlichen Präferenzen. Regelwerte aus 12 Szenen werden nicht zu einem allgemeinen „EQ-Wert“. Die Seite sagt bereits, dass höchster und niedrigster Wert 1,3 Punkte auseinanderliegen und der Abstand als Stil zu lesen ist, nicht als stabile Rangfolge von Fähigkeiten.
Die genauere Schlussfolgerung lautet: Die Modelle können bereits natürliches, beziehungsorientiertes Lob formulieren, aber wenn Lob und Fakten kollidieren, braucht der Test noch einen feineren Maßstab. Wirklich gut reden heißt nicht nur, sanft, konkret und angenehm zu sprechen. Es heißt auch, eine unvollkommene Tatsache nicht stillschweigend zu streichen. Für eine Familie ist „Das Fleisch ist sehr weich geschmort, es ist ein bisschen kräftig gewürzt, nimm nächstes Mal etwas weniger Salz“ vielleicht weniger lebhaft als „Damit könntest du ein Restaurant aufmachen“. Es klingt aber eher nach etwas, das man an einem echten Esstisch glauben würde.
Quellen
Dieser Artikel analysiert ausschließlich die V1-Ergebnisse, die diese Seite derzeit veröffentlicht.


