
Im ersten Artikel ging es darum, einem einzelnen Screenshot nicht blind zu glauben. Dieser fragt weiter: Warum sollte man nicht einmal einer Punktzahl blind glauben?
Angenommen, es gibt drei Pelikane, die Fahrrad fahren. Der erste ist mit großer Sorgfalt gezeichnet: geschichtetes Gefieder, Glanzlichter auf den Rädern, im Hintergrund sogar ein Sonnenuntergang. Bei genauerem Hinsehen schweben jedoch beide Füße über den Pedalen. Der zweite wirkt wie eine Skizze aus wenigen Strichen. Es gibt keinen Schatten und keine schöne Farbpalette. Doch der Rahmen ist stimmig verbunden, der Körper sitzt auf dem Sattel, und die Füße stehen tatsächlich auf den Pedalen. Der dritte sieht im Standbild einwandfrei aus. Sobald man auf Abspielen drückt, driftet ein Fuß jedoch auf seiner eigenen Bahn davon: Das Pedal dreht sich für sich, und der Pelikan tritt für sich. Welcher sollte die höchste Punktzahl bekommen?
Lautet die Antwort „der erste ist der schönste“, bewerten wir Ästhetik. Lautet sie „der zweite ist der zuverlässigste“, bewerten wir, ob die Aufgabe erfüllt wurde. Und wenn wir nur einen Screenshot ansehen, wird der Fehler des dritten womöglich nie entdeckt.
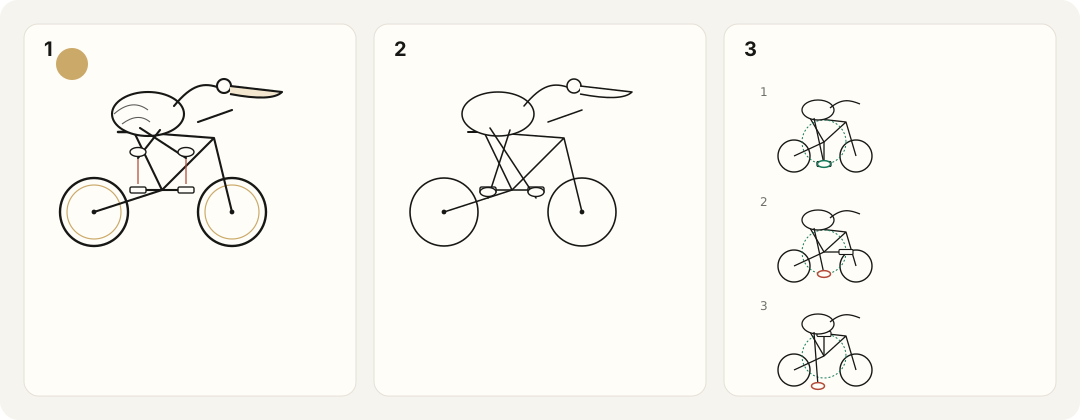
Der vorige Artikel hat argumentiert: Ob ein Modell wirklich schlechter geworden ist, lässt sich nicht an einer ausgewählten Ausgabe ablesen, sondern nur durch wiederholte Tests unter vergleichbaren Bedingungen. In diesem Argument steckt jedoch eine Voraussetzung, die noch nicht geklärt ist: Wir wissen bereits, was als bestanden gilt. Trifft diese Voraussetzung nicht zu, macht Wiederholung die Schlussfolgerung nicht automatisch glaubwürdig. Sie sorgt womöglich nur dafür, dass ein schiefer Maßstab immer stabiler misst. Genau hier setzt dieser Artikel an: Wie wird aus „dieser Pelikan sieht ganz okay aus“ eine Bewertungsmethode, die eine Grundlage hat, sich nachprüfen lässt und Schritt für Schritt automatisiert werden kann?
Hinweis: Die Beispiele, Zahlen, Bewertungsschemata und Konfigurationen in diesem Artikel dienen der Veranschaulichung der Methode. Sie entsprechen keiner echten Modellrangliste und bedeuten nicht, dass Folkbench diese Verfahren bereits umgesetzt hat. Die zitierte Forschung soll verwandte Methoden und Risiken erläutern. Sie bedeutet nicht, dass der Vorschlag in diesem Artikel experimentell validiert wurde.
1. Erst die Aufgabe aufschreiben, dann über die Bewertung reden
Der Pelikan-Test ist reizvoll, weil er den Fehler sichtbar an die Oberfläche bringt. Ein zusätzliches Bein, ein Rahmen, der nicht zusammenpasst, ein Fuß, der das Pedal verfehlt – das lässt sich mit einem flüssigen Satz kaum überdecken. Was er eigentlich misst, muss trotzdem genauer benannt werden. Wer ein Modell bittet, „einen Pelikan, der Fahrrad fährt, in SVG zu zeichnen“, beobachtet unmittelbar, ob es eine schriftliche Anforderung in Code übersetzen kann und ob dieser Code ein Bild erzeugt, das der Anforderung entspricht. Dieses Ergebnis allein sagt nicht, welche räumliche Repräsentation das Modell intern verwendet hat. Ebenso wenig darf „hat diese Aufgabe gut gelöst“ für „verfügt über ein vollständiges räumliches Verständnis“ stehen.
Darf das Modell rendern, sich das Bild ansehen und wiederholt nachbessern, misst man einen Arbeitsablauf mit Feedback und nicht mehr eine einzelne Codegenerierung. Beides ist es wert, gemessen zu werden. Es sollte aber nicht in dieselbe Rangliste für Erstantworten einfließen. Praktisch wichtiger ist etwas anderes: Eine Anforderung, die nicht in der Aufgabe stand, darf bei der Bewertung nicht plötzlich auftauchen. Lautet die ursprüngliche Aufgabe nur „Zeichne einen Pelikan, der Fahrrad fährt“, sollten wir nachträglich weder ein Standard-Rennrad verlangen noch zwei exakt gleich große Räder, beide Flügel am Lenker oder dass jedes Teil deutlich sichtbar ist. Plausible Perspektive, Verdeckung und Cartoon-Stil gehören zum offenen Zeichnen dazu. Ich würde den Test in zwei Arten aufteilen.
Die eine behält die offene Aufgabe bei und beobachtet, wie das Modell „Fahrradfahren“ versteht und darstellt. Die Bewertung erfasst nur die Anforderungen, die klar und notwendig sind, und akzeptiert, dass Grenzfälle umstritten sein können. Die andere ist eine Aufgabe mit Vorgaben. Sie legt vorab Blickwinkel, sichtbare Beziehungen, Ausgabeformat und erlaubte Techniken fest. Zum Beispiel: Die Ansicht ist überwiegend seitlich; ein leichter Versatz ist erlaubt, damit beide Füße zu sehen sind; der Kontakt zwischen jedem Fuß und seinem Pedal muss sichtbar sein; geliefert wird eine einzige eigenständige SVG-Datei; externe Bilder oder Skripte sind nicht erlaubt.
Eine Aufgabe mit Vorgaben verändert die ursprüngliche Aufgabe. Das ist kein Mangel. Ist die Aufgabenversion gekennzeichnet, können wir gezielter fragen: Hat das Modell den Blickwinkel verfehlt, den Kontakt nicht deutlich gemacht oder schon die Fahrradstruktur falsch gezeichnet? Es geht nicht darum, welche Version „authentischer“ ist. Offene Aufgaben werden als offene Aufgaben bewertet, Aufgaben mit Vorgaben als Aufgaben mit Vorgaben. Eine vage Aufgabe darf nicht mit einem strengen Maßstab kombiniert werden, der erst hinterher erfunden wurde.
2. Keine voreilige Gesamtnote: erst „Fahrradfahren“ zerlegen
„Insgesamt ziemlich gut. Acht Punkte.“ Das ist die bequemste Art zu bewerten und die am schwersten nachprüfbare. Kam die 8 von einer korrekten Hauptfigur, einer stimmigen Struktur oder einer gefälligen Farbpalette? Wird beim nächsten Auftreten desselben Fehlers dann eine 9 vergeben? Ich würde mit vier Dimensionen beginnen, sie aber nicht als vier Zahlen behandeln, die man nach Gefühl einträgt.
| Dimension | Was vor allem geprüft wird | Was nicht hineingehört |
|---|---|---|
| Pelican: die Hauptfigur | Ob sie als Pelikan erkennbar ist; ob Körper oder Gliedmaßen deutlich abnorm sind; ob die Sichtbarkeit erfüllt ist, die die Aufgabe ausdrücklich verlangt | Realismus, Federdetails oder persönliche Stilvorlieben, die die Aufgabe nicht verlangt hat |
| Bicycle: das Fahrrad | Ob Räder, Rahmen, Kurbel, Pedale usw. die plausible Struktur bilden, die die Aufgabe verlangt | Marke, Modell, Dekoration oder eine bestimmte SVG-Schreibweise, die die Aufgabe nicht verlangt hat |
| Riding: Beziehung zum Rad | Ob der Körper plausibel abgestützt ist; ob die Füße den Pedalen zugeordnet sind; ob eine von der Aufgabe verlangte Steuerbeziehung besteht | Bloß „der Vogel steht neben dem Fahrrad“ oder „beide Objekte sind vorhanden“ |
| Animation: Beziehungen über die Zeit | Ob eine verlangte Bewegung stattfindet; ob Kontakt und Verbindung während der Bewegung erhalten bleiben; ob es unplausible Sprünge oder Durchdringungen gibt | Animation, die eine statische Aufgabe nie verlangt hat; Effekte ohne Bezug zur Aufgabe |
Dass ein Objekt vorhanden ist, heißt noch nicht, dass eine Beziehung besteht. „Da ist ein Fuß“ und „da ist ein Pedal“ sind zwei Objekturteile. „Der Fuß steht auf dem Pedal“ ist ein Beziehungsurteil. Noch einen Schritt weiter ist „der Fuß bleibt auf dem Pedal, während sich das Pedal dreht“ ein Beziehungsurteil über die Zeit. Deshalb reicht es bei Weitem nicht, nur zu prüfen, „ob Pelikan, Fahrrad und zwei Räder vorhanden sind“. Herausgearbeitet werden sollten die Verbindungen zwischen Körper und Sattel, Fuß und Pedal, Pedal und Kurbel sowie Rahmen und Radachse.
Für solche Zerlegungen gibt es verwandte Forschung, an der man sich orientieren kann. TIFA wandelt die Anforderungen eines Textes in mehrere Fragen um und prüft dann per Visual Question Answering, ob ein generiertes Bild sie erfüllt. Ein fertiger Pelikan-Bewerter ist das nicht. Es zeigt aber eine nützliche Richtung: das Bild Punkt für Punkt mit den Anforderungen abgleichen, statt nur einen Gesamteindruck zu benoten. 1 Für die Umsetzung würde ich für jede Prüfung vier Zustände vorsehen: pass, fail, uncertain und not_applicable. Sie bedeuten bestanden, nicht bestanden, unzureichende Nachweise und nicht anwendbar.
Entscheidend ist die Unterscheidung zwischen den letzten beiden. Verlangt eine statische Aufgabe keine Animation, ist Animation „nicht anwendbar“. Wurde Animation verlangt, reicht das Material aber nicht aus, um eine Durchdringung zu beurteilen, liegen „unzureichende Nachweise“ vor. Das Erste sollte keine Punkte kosten. Das Zweite darf nicht automatisch als bestanden zählen. Anschließend werden die Kriterien in Pflichtkriterien und zusätzliche Qualitätsmerkmale aufgeteilt. Pflichtkriterien entscheiden, ob das Ergebnis besteht. Zusätzliche Merkmale beschreiben Details und Erscheinungsbild. Ein eindeutiges Scheitern bei einem Pflichtkriterium lässt sich nicht durch schönes Gefieder, einen Hintergrund oder einen Farbverlauf wettmachen.
Ein erster Bericht kann sich darauf beschränken, wie viele Prüfungen zur Hauptfigur bestanden wurden, an welchem Punkt die Fahrradstruktur gescheitert ist, ob bei der Beziehung zum Rad eine Frage offen ist und ob Animation anwendbar ist. Eine Gesamtnote mit zwei Nachkommastellen braucht er nicht. Wird tatsächlich eine Gesamtpunktzahl benötigt, sollten die anwendbaren Kriterien, die Gewichte und der Umgang mit fehlenden Werten vorab veröffentlicht und nicht erfüllte Pflichtkriterien getrennt ausgewiesen werden. Auch ob die Rangfolgen, die sich aus unterschiedlichen Gewichtungen ergeben, robust sind, verdient eine Prüfung. Eine Gesamtnote ist eine komprimierte Zusammenfassung. Sie ist kein Grund, die ursprünglichen Nachweise zu ersetzen.
3. Das SVG-DOM kann helfen, ist aber kein Strukturdiagramm mit eingebauter Lösung
Beim Anblick von SVG liegt der Ingenieursinstinkt nahe: Es gibt ja Quellcode, warum ihn also nicht direkt parsen? Schon sind die Regeln geschrieben. Zwei circle-Elemente gefunden, also gibt es zwei Räder. Ein Element namens foot gefunden, also gibt es einen Fuß. Überschneiden sich die Bounding Boxes von Fuß und Pedal, steht der Fuß auf dem Pedal. Das Problem: Jeder dieser Schritte verwechselt „eine Ausdrucksweise im Code“ mit „einer semantischen Tatsache im Bild“.
Ein Rad kann ein Kreiselement oder ein Pfad sein. Zwei Räder können getrennt geschrieben oder über use wiederverwendet werden. Ein einzelnes visuelles Objekt kann zudem aus mehreren Gruppen und Pfaden bestehen. Die SVG-Spezifikation erlaubt diese unterschiedlichen Ausdrucksformen. Sie verlangt nicht, dass einem realen Objekt genau ein DOM-Knoten entspricht. 2 Wer also keine zwei circle-Elemente zählt, hat damit nicht bewiesen, dass ein Rad fehlt, und wer zwei zählt, hat nicht bewiesen, dass sie an einer plausiblen Stelle sitzen. Ein Element namens foot trägt lediglich einen Namen, den der Generator vergeben hat; eine unabhängige Überprüfung ist das nicht.
Statische Regeln eignen sich am besten für Vorgaben, die sich eindeutig klären lassen
Zum Beispiel: ob sich die Ausgabe im vereinbarten Format parsen lässt, ob sie eine externe Referenz enthält, die die Aufgabe verbietet, ob sie ein nicht erlaubtes Skript enthält und ob sie in der vorgegebenen Umgebung einen nicht leeren Inhalt rendert. Diese Prüfungen haben eine klare Grundlage und lassen sich leicht protokollieren. Sie beantworten aber die Frage, „ob die Liefer- und technischen Vorgaben erfüllt sind“, nicht die Frage, „ob dieser Vogel richtig Fahrrad fährt“. Ebenso ersetzt ein erfolgreiches Rendering keine Formatprüfung. Die SVG-Spezifikation unterscheidet Dokumentformen und Verarbeitungsmodi. Ein eingebettetes Fragment in einer Webseite und eine eigenständige SVG-Datei sollten nicht ohne ausdrückliche Festlegung nach denselben Parsing-Anforderungen abgenommen werden. 3
Eine geometrische Prüfung muss zuerst klären, was eigentlich gemessen wird
Sind die sichtbaren geometrischen Bereiche, die Fuß und Pedal entsprechen, zuverlässig identifiziert, lassen sich Abstand, Überlappung und Bewegungsbahn berechnen. Man kann etwa den Abstand zwischen Fußsohle und Kontaktfläche des Pedals durch einen vereinbarten Referenz-Raddurchmesser im selben Bild teilen. So erhält man einen relativen Abstand. In dieser Form darüber zu sprechen, „wie weit der Fuß vom Pedal entfernt ist“, ist besser interpretierbar als ein fester Pixel-Schwellenwert. Wie die Kontaktfläche definiert wird und wie viel Abweichung toleriert wird, muss trotzdem an annotierten Beispielen kalibriert werden. Man kann nicht aus dem Nichts verkünden, dass „fünf Pixel Unterschied mit Sicherheit falsch sind“.
Die Messung muss außerdem Koordinatentransformationen, Konturen, Beschneidung und die tatsächliche Sichtbarkeit berücksichtigen. Ein SVG-Element kann in einem verschachtelten Koordinatensystem liegen. Die Spezifikation kennt auch Fälle, in denen ein Element, das gar nicht gerendert wird, dennoch eine Bounding Box hat. Eine Bounding Box zu haben ist nicht dasselbe, wie die Umrisse des sichtbaren Objekts im Bild zu haben. 4 Zwei sich überschneidende Bounding Boxes bedeuten nicht, dass die Sohle das Pedal berührt. Zwei sich überlappende flache Bereiche können auch bloß eine Verdeckung in der Tiefe sein und keine plausible Abstützung. Bei allgemeinem SVG eignen sich geometrische Regeln daher eher als ergänzende Nachweise, nachdem sie validiert wurden, und nicht als unkalibrierter Schiedsrichter mit Vetorecht.
Um die Automatisierung zu erleichtern, kann man durchaus ein einheitliches Schema für Teile-IDs, Keypoints und Gruppenstruktur verlangen. Das sollte dann aber eine eigene Wertungskategorie für „strukturierte Ausgaben“ sein: Dort wird geprüft, ob diese Angaben dem tatsächlichen Bild entsprechen. Das Modell darf nicht „Kontakt korrekt“ hineinschreiben, und das Testprogramm glaubt es einfach. Das DOM liefert uns mehr prüfbare Informationen. Die semantische Erkennung löst es nicht gratis mit.
4. Bevor ein visueller Judge die Arbeit übernimmt, muss er selbst eine Prüfung ablegen
Reichen statische Regeln nicht aus, soll eben ein Modell bewerten, das Bilder sehen kann. Dieser Weg lohnt sich. Aber „das Modell kann ein Bild beschreiben“ ist nicht gleichbedeutend mit „das Modell kann einen subtilen räumlichen Fehler zuverlässig beurteilen“. Die Arbeit von 2023 zu MT-Bench und Chatbot Arena erörtert Positions-Bias, Ausführlichkeits-Bias und Selbstbevorzugung bei LLM-Judges und berichtet zugleich, dass starke Modelle bei bestimmten Textbewertungen recht gut mit menschlichen Präferenzen übereinstimmten. Die vernünftige Schlussfolgerung lautet also nicht „Modell-Judges sind allesamt unzuverlässig“, sondern „ihre Glaubwürdigkeit hängt von der Aufgabe ab und muss geprüft werden“. Diese Ergebnisse aus Textbewertungen lassen sich auch nicht direkt als Genauigkeit für visuelle Bewertungen übernehmen. 5
Auch die visuelle Fähigkeit selbst muss geprüft werden. Die BlindTest-Studie von 2024 stellte fest, dass die damals getesteten Vision-Language-Modelle bei einfacher Geometrie noch Fehler machten, etwa bei der Frage, ob sich Kreise überlappen oder Linien schneiden. Das heißt nicht, dass jedes heutige Modell auf dem damaligen Stand stehen geblieben ist. Es reicht aber als Erinnerung daran, dass man eine feine Kontaktbeziehung nicht allein deshalb für korrekt halten sollte, weil das Modell bekannt ist. 6 Ich würde zuerst einen Satz menschlicher Referenzbeispiele aufbauen, statt die Rangliste sofort einem Judge zu überlassen.
Der Satz braucht eindeutige Erfolge und eindeutige Fehlschläge, aber auch Grenzfälle: Skizzen, dünne Linien, plausible Verdeckung, komplexe Pfade und Arbeiten, die im Standbild stimmen, in Bewegung aber nicht. Mindestens zwei Personen sollten unabhängig und blind annotieren; anschließend werden die Abweichungen überprüft. Auch Menschen sind keine natürliche Ground Truth. Kommen zwei Personen bei derselben Regel immer wieder zu gegensätzlichen Ergebnissen, sollte womöglich zuerst die Aufgabe oder die Bewertungsanleitung überarbeitet werden. Ein Beispiel, das sich nicht klären lässt, darf umstritten bleiben. Es braucht keine erfundene „Musterlösung“.
Der Judge soll konkrete Fragen beantworten, keine Geschmacksurteile abgeben
Er erhält die ursprüngliche Aufgabe, die eingefrorenen Bewertungsregeln und ein einheitlich gerendertes Bild. Bei einer Animationsaufgabe kommen Frames mit Zeitmarken oder ein Video hinzu. Er erhält nicht zusätzlich den Namen des Dienstes, eine Ranglistenposition oder die Aussage des generierenden Modells, „dieses Bild erfüllt alle Anforderungen“. Der Judge wird Punkt für Punkt gefragt: „Berührt jeder Fuß sein eigenes Pedal?“ „Ist der sichtbare Rahmen plausibel mit Vorder- und Hinterachse verbunden?“ „Bleibt die Verbindung zwischen Fuß und Pedal zu diesen Zeitpunkten erhalten?“
Jedem Urteil wird ein kurzer, lokalisierbarer Nachweis beigefügt, zum Beispiel „bei 2,0 Sekunden hat der dem Betrachter nähere Fuß einen deutlichen Abstand zum Pedal“. Reichen die Nachweise nicht aus, lautet die Antwort uncertain. Ein unklarer Befund sollte nicht mit einem flüssigen Absatz überdeckt werden. Text im Bild, SVG-Kommentare und Metadaten sind ausschließlich Prüfgegenstand. Sie dürfen nicht als Anweisungen wirken, die die Bewertungsregeln ändern. Einen Dateinamen oder ein Kanal-Label auszublenden, berechtigt nicht dazu, die Arbeit zu verändern. Wird ein Ausschnitt oder eine annotierte Hilfsgrafik benötigt, sollten sowohl das Original als auch ein Protokoll der Bearbeitung aufbewahrt werden.
Kalibrierung darf sich nicht auf eine einzige „Gesamtübereinstimmung“ stützen
Angenommen, ein Referenzsatz enthält 90 Bilder, die bestehen, und 10 Bilder mit einem schweren Fehler. Ein Judge, der immer „bestanden“ antwortet, erreicht trotzdem 90 % Gesamtgenauigkeit – und übersieht jeden schweren Fehler. Ich würde deshalb getrennt prüfen, wie viele kritische Fehler übersehen wurden, wie viele korrekte Arbeiten fälschlich abgelehnt wurden, ob die Leistung über verschiedene Stile hinweg konsistent ist und ob wiederholte Bewertungen derselben Arbeit stabil sind. Bei Grenzfällen ist außerdem zu beobachten, ob der Judge bereit ist, unzureichende Nachweise einzugestehen.
Nützlich sind einige Beispiele, bei denen „nur ein Faktor geändert“ wird: das Original beibehalten und einen Fuß vom Pedal wegschieben oder nur den Hintergrund ändern und die Struktur unangetastet lassen. Die erste Änderung sollte die betreffende Bewertung beeinflussen. Die zweite sollte ein Struktururteil nicht grundlos verändern. Solche konstruierten Beispiele eignen sich gut zur Diagnose. Echte Modellausgaben können sie nicht vollständig ersetzen. Beispiele, mit denen der Bewertungs-Prompt überarbeitet wird, und zurückgehaltene Beispiele für die abschließende Prüfung des Judges müssen getrennt bleiben. Man darf nicht so lange an denselben Antworten nachjustieren, bis das Ergebnis zufriedenstellend aussieht, und diese Punktzahl dann als Beleg für Generalisierung ausgeben.
Eine Abstimmung zwischen mehreren Judges kann Uneinigkeit sichtbar machen. Drei Modelle zu verwenden, macht die drei Urteile aber nicht unabhängig. Sie können denselben Fehler teilen. Die eigene Angabe eines Judges, „ich bin mir zu 95 % sicher“, darf ohne Kalibrierung nicht als tatsächliche Genauigkeit von 95 % gelten. Ein Judge muss beweisen, dass er einen Fehler erkennen kann, nicht nur, dass er seine Punktzahl erklären kann.
5. Animation heißt nicht, ein paar Screenshots mehr zu machen. Sie prüft, ob eine Beziehung mit der Zeit zerbricht
Eine statische Bewertung fragt: „Steht der Fuß jetzt auf dem Pedal?“ Eine Animationsbewertung fragt: „Bleibt diese Beziehung bestehen, sobald die Bewegung beginnt?“ Ein Fuß, der im ersten Frame zufällig das Pedal berührt, folgt deshalb nicht zwangsläufig auch danach der Bahn des Pedals. Umgekehrt ist die von der Aufgabe verlangte Tretbewegung nicht erfüllt, wenn Fuß und Pedal einfach gemeinsam stillstehen. Animation stellt daher mindestens zwei verschiedene Fragen: ob sich das, was sich bewegen soll, tatsächlich bewegt, und ob die Verbindung, die während der Bewegung bestehen soll, erhalten bleibt.
Zuerst muss die Animationsszene vereinbart werden. Fahren auf der Stelle, Vorwärtsfahren und eine mitgeführte Kamera sind unterschiedliche Aufgaben. Verlangt die Aufgabe keine präzise mechanische Simulation, sollte nicht stillschweigend eine zusätzliche Vorgabe wie das Übersetzungsverhältnis hinzukommen. Verlangt sie ausdrücklich, dass sich die Kurbel dreht und der Fuß in Kontakt mit dem Pedal bleibt, gehören diese Anforderungen in die Abnahme.
Auch die Testumgebung muss den echten Animationszustand bewahren. Hier eine konkrete technische Falle: Die Screenshot-Option animations="disabled" von Playwright stoppt die von ihr unterstützten Animationen; endliche Animationen werden bis zum Ende vorgespult, unendliche auf ihren Anfangszustand zurückgesetzt. Das ist kein Synonym für „einen beliebigen Zeitpunkt exakt erfassen“. 7 Eine Animation darf also nicht als bestanden gelten, weil jemand die Animation abgeschaltet und ein schönes Bild aufgenommen hat. Zuerst sollten Timing und Screenshot-Methode an einer Testdatei mit bekannter Bewegung überprüft werden, erst dann an Modellausgaben. Auch welche Animationsmechanismen unterstützt werden, sollte schriftlich festgehalten werden.
Angenommen, die Aufgabe verlangt eine 4-Sekunden-Schleife. Ein möglicher Ausgangsplan: zwei vollständige Durchläufe beobachten, mit einer vorab festgelegten Rate abtasten und zusätzlich den Übergang zwischen den Durchläufen sowie jeden verdächtig wirkenden Zeitabschnitt prüfen. Beobachtungszeitraum, Abtastrate und die Regeln für zusätzliche Prüfungen sollten alle vor der formalen Bewertung feststehen und nicht erst verschärft werden, wenn man sieht, wo ein Problem auftritt. Selbst dann kann eine endliche Menge von Frames einen kurzen Fehler zwischen zwei Frames übersehen. Der Bericht sollte lauten: „Unter dem vereinbarten Beobachtungszeitraum und den vereinbarten Abtastbedingungen wurde kein eindeutiger Fehler gefunden“, nicht: „Es ist mathematisch bewiesen, dass es zu keinem Zeitpunkt eine Durchdringung gab.“
Auch normale Verdeckung in einem flachen Bild erfordert Sorgfalt. Wenn ein Bein hinter dem Rahmen vorbeiläuft, bedeuten sich überlappende Umrisse nicht automatisch eine Durchdringung. Zu prüfen ist, ob sich die Tiefenreihenfolge oder die Verbindung unplausibel verändert. Eine Ausschnittvergrößerung hilft beim Beobachten, darf aber den räumlichen Gesamtzusammenhang nicht verloren gehen lassen. Kann ein automatischer Judge derzeit nur Standbilder zuverlässig verarbeiten, sollten die statischen Ergebnisse veröffentlicht und die Animation der menschlichen Prüfung überlassen werden. Besser ist es, einzugestehen, dass dieser Maßstab dort noch nicht hinreicht, als eine ungemessene Fähigkeit in eine Gesamtnote zu packen.
6. Auch das Bewertungssystem kann sich irren – und den Eindruck erwecken, ein Modell sei plötzlich schlechter geworden
Statische Prüfungen, ein visueller Judge und menschliche Prüfung beenden das Problem nicht. Das System selbst kann sich verändern. Der Judge von gestern war bei einem leichten Abstand nachsichtig. Heute zieht eine neue Version streng Punkte ab. An der generierten Arbeit hat sich nichts geändert, doch die Bestehensquote in der Rangliste sinkt. Wer nur „Modellname, Datum, Gesamtnote“ speichert, hält eine Änderung am Judge leicht für eine Verschlechterung des Modells. Neben dem generierenden Modell und den Anfrageparametern sollten daher die Aufgabenversion, die Version des Bewertungsschemas, Modell und Konfiguration des Judges, die Renderer-Version und die Version des automatischen Prüfprogramms protokolliert werden. Ändert sich einer dieser Punkte, kann sich auch die Bedeutung einer Punktzahl ändern.
Bevor ich einen Judge oder eine Regel austausche, würde ich alte und neue Version dieselben gespeicherten Arbeiten bewerten lassen und schauen, wo sich die Unterschiede häufen. Historische Arbeiten können bei Bedarf neu bewertet werden. Das sollte dann aber als „neue Bewertung desselben Artefakts“ gekennzeichnet werden und nicht so aussehen, als hätte das Modell gerade neu geantwortet.
Eine weitere Problemklasse ist eine Bewertung, die nicht abgeschlossen wurde. Ein Timeout des Dienstes, ein defektes SVG, ein abgestürztes Screenshot-Programm oder eine fehlgeschlagene Judge-Anfrage sollten nicht alle unter „das Modell hat falsch gezeichnet“ zusammengefasst werden. Verstößt die Arbeit selbst gegen die Regeln, kann sie nach der vorab festgelegten Regel als nicht bestanden gewertet werden. Ist die Testinfrastruktur ausgefallen, wird die Bewertung als offen protokolliert und nach einem festen Verfahren nachgeholt. Für eine einzelne Arbeit genügt ein eindeutig nicht erfülltes Pflichtkriterium, um das Gesamtergebnis als nicht bestanden zu werten. Umgekehrt gilt: Ist nichts eindeutig gescheitert, bleibt aber ein Pflichtkriterium unklar, darf die Arbeit nicht einfach durchgewunken werden.
Angenommen, von 100 geplanten Anfragen sind 72 bestätigt bestanden, 18 bestätigt nicht bestanden und 10 noch nicht entschieden. Der Bericht kann zunächst diese drei Zahlen nennen, statt die offenen Fälle zu löschen und eine „Bestehensquote von 80 %“ zu verkünden. Behandelt man die bereits entschiedenen Labels vorläufig als korrekt, kann der endgültige Anteil bestandener Arbeiten in diesem Durchgang zwischen 72 % und 82 % liegen: Die Untergrenze zählt jeden offenen Fall als nicht bestanden, die Obergrenze jeden als bestanden. Diese Spanne ergibt sich aus den offenen Labels. Sie ist kein statistisches Konfidenzintervall und enthält weder Fehlurteile des Judges noch die Unsicherheit bei der Verallgemeinerung auf andere Stichproben.
Auch die menschliche Prüfung darf sich nicht auf die Fehlschläge und Streitfälle beschränken, die der Judge markiert hat. Aus den Arbeiten, die automatisch bestanden haben, sollte nach einem vorab festgelegten Verfahren eine Zufallsstichprobe geprüft werden. Andernfalls können sich die gefährlichsten Fehlurteile dauerhaft im Bereich „bestanden“ verstecken. Keine automatische Bewertung kann ihre Fehlerfreiheit damit beweisen, dass sie nie einen eigenen Fehler gefunden hat. Sie braucht ein Audit-Verfahren, das ihre eigenen Fehler aktiv aufspüren kann.
7. Aufgaben veralten, aber täglich neue Aufgaben sind nicht wissenschaftlicher
Sobald eine Aufgabe viral geht, folgen Beispiele, Tutorials, Verbesserungstipps und gezielt darauf ausgerichtete Optimierung. Dass ein Modell einen guten Pelikan zeichnet, rechtfertigt für sich genommen nicht den Vorwurf, es habe geschummelt. Die Bekanntheit einer öffentlichen Aufgabe, das Erlernen eines Aufgabentyps und Testmaterial, das in Trainingsdaten gelangt, sind Probleme auf unterschiedlichen Ebenen. Ob ein bestimmtes Modell ein bestimmtes Testmaterial gesehen hat, erfordert Nachweise. „Diese Aufgabe ist zu bekannt“ ist kein solcher Nachweis.
Dass Testmaterial in Trainingsdaten gelangt, bleibt dennoch ein Risiko, dem sich jede Bewertung stellen muss. Zur Praxis von LiveBench gehören neuere Informationsquellen, laufend aktualisierte Aufgaben und eine automatische Bewertung anhand überprüfbarer Antworten. Das ist ein praktischer Ansatz, um das betreffende Risiko zu verringern. Es ist keine Garantie dafür, dass „monatlich neue Aufgaben jede Kontamination ausschließen“. 8 Für eine offene Generierungsaufgabe wie den Pelikan würde ich lieber drei Arten von Aufgaben mit unterschiedlichem Zweck vorhalten: stabile Kernaufgaben, um langfristige Veränderungen zu beobachten; rotierende Erweiterungsaufgaben, um den Transfer zu beobachten; zurückgehaltene, noch nicht veröffentlichte Aufgaben für eine Prüfung, nachdem das Verfahren eingefroren wurde – und nicht, um endlos an den Regeln nachzujustieren.
Der Wert einer Kernaufgabe liegt in der Vergleichbarkeit, nicht in einer Immunität gegen Trainingskontamination. Der Wert einer Erweiterungsaufgabe liegt in einer breiteren Abdeckung, nicht in einer möglichst ausgefallenen Aufgabenstellung.
Was sich zu ändern lohnt, ist die Vorgabe, nicht nur der Name der Hauptfigur
Den Pelikan durch eine Ente zu ersetzen, ist eine Änderung. Die Beziehungsstruktur ändert sich dadurch nicht automatisch. Eine aussagekräftigere Variante ändert gezielt eine Bedingung. Bleibt die Verbindung korrekt, wenn die Blickrichtung umgekehrt wird? Bleiben die Schlüsselteile vollständig, wenn die Verdeckung zunimmt? Wendet das Modell weiterhin eine Fahrhaltung an, wenn die Aufgabe lautet: „neben dem Fahrrad stehen und es schieben“? Versagt dieselbe Kontaktbeziehung, sobald sie in eine Animation übertragen wird?
Die Aufgabe kann auch zu einer anderen Beziehung wechseln: eine Hand, die einen Tassenhenkel hält, ein Gegenstand, der von einem Tablett getragen wird, oder mehrere Teile, die in einer vorgegebenen Reihenfolge verbunden sind. Es geht nicht darum, jede seltene Anforderung in einem einzigen Bild zu stapeln, sondern darum, zu wissen, was jede Variante prüft. Wer in eine Vorlage mechanisch hundert Tiere einsetzt, erhält natürlich hundert Aufgaben. Das sind aber nicht hundert unabhängige Nachweise einer Fähigkeit. Bei der Aggregation sollten Aufgabenkategorie und Vorlagenfamilie erhalten bleiben, damit eine Vorlage nicht nur deshalb den Großteil der Gesamtnote ausmacht, weil sie besonders viele Varianten hat.
Auch automatisch generierte neue Aufgaben brauchen eine Abnahme. Eine Aufgabe kann vage, widersprüchlich oder anhand des fertigen Bildes gar nicht überprüfbar sein. Werden Aufgabe, Antwort und Bewertungsregeln alle vom selben Modell vorgeschlagen und anschließend von genau diesem Modell bestätigt, ist eine unabhängige Prüfung umso notwendiger.
Wenn sich der Aufgabenpool ändert, darf eine Änderung der Schwierigkeit nicht als Modellfortschritt erscheinen
Achtzig Punkte in diesem Monat und neunzig im nächsten bedeuten nicht unbedingt, dass das Modell stärker geworden ist. Die neuen Aufgaben könnten schlicht leichter sein. Wird ein alter Aufgabenpool durch einen neuen ersetzt, sollte man besser gemeinsame Aufgaben beibehalten und eine Gruppe von Referenzsystemen beide Pools unter ähnlichen Bedingungen bearbeiten lassen. Die Veränderung wird für jede Aufgabenkategorie getrennt berichtet. Gemeinsame Aufgaben und Referenzsysteme sind keine Ground Truth, die für immer stimmt. Sie helfen, Veränderungen zu erkennen. Eine strenge Angleichung der Schwierigkeit leisten sie nicht automatisch. Reichen die Nachweise nicht aus, ist es am ehrlichsten, die Ergebnisse getrennt nach Version zu zeigen, statt Rohwerte aus unterschiedlichen Prüfungsbögen zu einer einzigen Kurve zusammenzustückeln.
Eine Aufgabe kann nach ihrer Ausmusterung veröffentlicht werden, damit andere sie nachprüfen, daraus lernen und sie verbessern können. Sobald sie öffentlich ist, kann sich ihre Rolle von „einer noch ungesehenen Prüfung“ zu „einem wiederholbaren Regressionstest“ verschieben. Eine Aufgabe ist nicht auf eine einzige Verwendung beschränkt, kann aber auch nicht für immer als dasselbe Messinstrument dienen. Bei einem dynamischen Aufgabenpool geht es nicht darum, ewig dem Neuen hinterherzujagen, sondern darum zu steuern, welche Schlussfolgerung eine Aufgabe in welcher Phase stützen kann.
8. Was sich wirklich zu automatisieren lohnt, ist ein Verfahren, das sich im Nachhinein prüfen lässt
An diesem Punkt liegt es nahe, den Plan immer größer zu machen: mehrere Judges, Bahnanalyse, ein dynamischer Aufgabenpool, automatische Schlichtung – und nichts davon optional. Eine minimal brauchbare Version muss aber nicht als vollautomatische Fabrik beginnen. Zuerst wählt man eine kleine Gruppe von Aufgaben, schreibt die Abnahmekriterien auf, sammelt echte Ausgaben und baut eine menschliche Referenz auf. Danach wird geprüft, welche Kriterien sich Regeln und welche sich einem visuellen Judge überlassen lassen. Was noch nicht zuverlässig automatisiert ist, bleibt in menschlicher Hand.
Solange die Datenmenge klein ist, besteht das Ziel darin, Lücken in den Regeln zu finden, nicht darin, zu verkünden, dass „die Bewertungsgenauigkeit ein bestimmtes Niveau erreicht hat“. Eine formale Prüfung der automatisierten Fähigkeit braucht einen eigenen, zurückgehaltenen Satz von Beispielen und einen Bericht über die Unsicherheit. Ein sinnvolles Verfahren könnte so aussehen:
Aufgabe und Abnahmeregeln einfrieren → planmäßig generieren → vollständige Rohausgabe speichern
→ kontrolliert parsen und rendern → statische Prüfungen / visuelle Bewertung Punkt für Punkt
→ Streitfälle nach Regeln prüfen und automatisch bestandene Fälle stichprobenartig kontrollieren
→ Ergebnisse der Erstabgabe, Leistung je Kriterium und offene Fälle zusammenfassen
Jeder Schritt sollte sich zum vorherigen zurückverfolgen lassen. Rohantwort, extrahiertes SVG, tatsächliches Rendering, Beobachtungsprotokoll der Animation, Rohrückgabe des Judges und Prüfergebnis werden über eine gemeinsame Lauf-ID verknüpft. Wird eine Datei extrahiert oder normalisiert, werden die Versionen vor und nach der Bearbeitung gespeichert. Musste ein SVG-Abschnitt repariert werden, bevor er sich rendern ließ, wird das als Ergebnis eines Reparaturverfahrens protokolliert. Die Erstantwort darf nicht stillschweigend überschrieben werden. Werden die Bewertungsregeln aktualisiert, kommt ein neuer Bewertungsdatensatz hinzu, statt den alten zu löschen.
Eine technische Voraussetzung lässt sich nicht überspringen: Modellausgaben sind als nicht vertrauenswürdige Inhalte zu behandeln. SVG-Verarbeitungsmodi können Skripte, Ereignisse und externe Ressourcen umfassen. „Die Dateiendung sagt, es sei ein Bild“ heißt nicht, dass man es gefahrlos in einem Browser ausführen kann, in dem man im Alltag angemeldet ist. 3
Die Rendering-Umgebung sollte Kontozugangsdaten, Netzwerk und Host-Dateien isolieren, die Ressourcennutzung begrenzen und eine Sandbox-Konfiguration verwenden, die für nicht vertrauenswürdige Inhalte geeignet ist. Mit Playwright ist das Problem nicht schon dadurch gelöst, dass der Browser „in Docker gesteckt“ wurde. Die Dokumentation warnt ausdrücklich vor den Grenzen des Standard-Container-Images und erläutert den Zusammenhang zwischen dem Betrieb als root und der Chromium-Sandbox. 9 Die konkreten Sicherheitsmaßnahmen müssen trotzdem in der Umgebung geprüft werden, in der sie laufen. Was die Aufgabe erlaubt und was die Ausführungsumgebung erlaubt, sollte vorab abgestimmt sein. Man darf dem Modell nicht erst Skripte erlauben und sie dann bei der Bewertung kommentarlos alle deaktivieren.
Einsparen sollte man nicht die „sorgfältige Prüfung“ selbst, sondern die wiederkehrende Mühe, bei jeder Prüfung die Datei erneut zu suchen, die Parameter abzugleichen und den Zeitstempel nachzutragen.
9. Eine lesenswerte Rangliste sollte es erlauben, ihr weitere Fragen zu stellen
Wenn ich eine Punktzahl sehe, möchte ich weiter nachschlagen können: zu welchem Modelldienst sie gehört, zu welchem Aufgabenpool und welchem Zeitraum; wie viele Stichproben es gab und ob Fehlschläge und offene Fälle erhalten geblieben sind; wer bewertet hat, wie kalibriert wurde und ob sich die Grundlage eines Urteils finden lässt. Diese Informationen sagen mehr darüber aus, ob eine Bewertung ihre eigenen Grenzen ernst nimmt, als eine Gesamtnote, die sehr präzise aussieht.
Wer das Verfahren nicht selbst aufbauen möchte, kann mit der öffentlichen Rangliste, den Berichten und den Erläuterungen zur Testmethodik auf Folkbench beginnen und prüfen, ob für das Modell und den Dienst, die einen interessieren, bereits ein passendes veröffentlichtes Ergebnis vorliegt. Die öffentliche Startseite beschreibt den Vergleich als einen Vergleich verschiedener Dienste für dasselbe Modell. Abdeckung, Funktionsstand und die Grundlage einer Schlussfolgerung richten sich trotzdem nach den jeweils öffentlich verfügbaren Informationen. 10
Das gilt für Folkbench ebenso wie für andere Ranglisten. Fehlende Informationen bleiben unbekannt. Die Selbstdarstellung einer Plattform ersetzt nicht den eigentlichen Bericht. Der Bewertungsvorschlag in diesem Artikel ist nicht dasselbe wie eine Fähigkeit, die irgendeine Plattform bereits besitzt. Eine gute Bewertung verlangt nicht, dass man „meiner Punktzahl einfach vertraut“. Sie erlaubt es, der Punktzahl bis zur Arbeit, zu den Bedingungen, den Regeln und den Meinungsverschiedenheiten zu folgen. Zurück zu den drei Pelikanen.
Wir müssen nicht darüber streiten, ob der erste am schönsten ist, und wir müssen die gesamte Animation des dritten nicht durchwinken, nur weil ein Frame schön aussieht. Ist erst vereinbart, was gemessen wird, und sind die Nachweise sauber protokolliert, wird aus vielem, was als Kaffeesatzleserei gilt, eine Frage, die sich Punkt für Punkt diskutieren lässt. Der erste Artikel sagte, ein Screenshot könne eine gute Frage aufwerfen, ihre Beantwortung erfordere aber ein ordentliches Experiment. Dieser Artikel möchte ergänzen: Ein ordentliches Experiment braucht auch einen Maßstab, der selbst geprüft wurde.
Anhang A. Eine Aufgabe mit Vorgaben und eine Abnahmetabelle als Ausgangspunkt
Die folgende statische Aufgabe ist ein für diesen Artikel entworfenes Beispiel. Sie ist weder ein Branchenstandard noch die offizielle Aufgabe einer Plattform. Vor dem Einsatz sollte sie erprobt und anhand von Annotationen kalibriert werden. Hat ein formaler Vergleich begonnen, darf die Aufgabe nicht wegen der Ergebnisse geändert werden.
Beispiel-Prompt
Ausschließlich den Inhalt einer einzigen eigenständigen, statischen SVG-Datei ausgeben, die sich für sich allein öffnen lässt.
viewBox "0 0 800 600" verwenden. Keinen Markdown-Codeblock und keine Erklärung hinzufügen.

Einen Cartoon-Pelikan zeichnen, der auf einem gewöhnlichen zweirädrigen Fahrrad fährt.
Überwiegend seitliche Ansicht. Ein leichter Versatz der Teile ist erlaubt, damit die Beziehung zum Rad klar erkennbar bleibt.

Die Zeichnung muss alle folgenden Punkte erfüllen:
1. Pelikan und Fahrrad liegen vollständig im Bild, ohne zusätzliche Beine.
2. Vorder- und Hinterrad, Rahmen, Sattel, Lenker, Kurbel und beide Pedale sind erkennbar.
   Der Rahmen ist plausibel mit beiden Radachsen verbunden, und die Pedale stehen in plausibler Beziehung zur Kurbel.
3. Der Körper sitzt auf dem Sattel. Jeder der beiden Füße berührt sein eigenes Pedal,
   und beide Kontaktstellen müssen deutlich sichtbar sein. Mindestens ein Flügel berührt den Lenker.
4. Nur SVG-Vektorgrafik und Inline-Styles verwenden. Keine eingebetteten Bitmaps, externen Ressourcen,
   Skripte, foreignObject oder Animation verwenden.

Nicht erforderlich sind Realismus, ein komplexer Hintergrund, Federstruktur oder dekorative Effekte.
Beispiel-Abnahmetabelle
| ID | Prüfpunkt | Art |
|---|---|---|
| F1 | Erfüllt das vereinbarte eigenständige Dateiformat, den Viewport und die Ressourcenbeschränkungen | Pflichtkriterium |
| P1 | Die Hauptfigur ist als Pelikan erkennbar, das Bild ist vollständig, und es gibt kein eindeutig überzähliges Bein | Pflichtkriterium |
| B1 | Zwei Räder, Rahmen, Sattel, Lenker, Kurbel und zwei Pedale sind erkennbar | Pflichtkriterium |
| B2 | Der Rahmen ist plausibel mit beiden Achsen verbunden, und die Pedale stehen in plausibler Beziehung zur Kurbel | Pflichtkriterium |
| R1 | Körper und Sattel bilden eine eindeutige Sitzabstützung | Pflichtkriterium |
| R2 | Jeder Fuß berührt sein eigenes Pedal, und die Kontaktstellen erfüllen die Sichtbarkeitsanforderung | Pflichtkriterium |
| R3 | Mindestens ein Flügel berührt den Lenker | Pflichtkriterium |
| A | Dies ist eine statische Aufgabe. Animation wurde nicht getestet | Nicht anwendbar |
| Q1 | Farbe, Linienführung und Details | Optionales Darstellungsmerkmal. Gleicht kein nicht erfülltes Pflichtkriterium aus |
„Erkennbar“, „plausibel“ und „eindeutig“ brauchen weiterhin zugehörige Positiv- und Negativbeispiele sowie eine Erläuterung der Grenzfälle. Die Tabelle ist ein Gerüst für die Regeln. Ein paar Sätze beseitigen den Ermessensspielraum nicht von selbst. Bestanden ist das Ergebnis nur, wenn alle Pflichtkriterien erfüllt sind. Ein eindeutig nicht erfülltes Pflichtkriterium führt zu „nicht bestanden“. Ist nichts eindeutig gescheitert, aber ein Pflichtkriterium noch offen, geht das Ergebnis in die Prüfung. R3 wird geprüft, weil dieser Beispiel-Prompt es ausdrücklich verlangt. Es sollte nicht stillschweigend auf jede Pelikan-Aufgabe übertragen werden.
Anhang B. Beispiel für einen einzelnen Ausgabedatensatz eines Judges
Das folgende JSON ist ein fiktiver Datensatz für ein einzelnes Kriterium. Er zeigt, wie die Felder zusammenhängen, und entspricht keinem echten Bild. Er ist weder ein vollständiger Bericht noch eine Konfiguration, die eine Bibliothek direkt ausführen könnte.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "Der dem Betrachter nähere Fuß hat einen deutlich sichtbaren Abstand zu seinem zugehörigen Pedal."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id sollte auf das konkrete Modell, den Prompt, die Parameter und die Versionsdokumentation des Judges verweisen. render_profile_id sollte auf Browser, Viewport und weitere relevante Einstellungen verweisen. Bei Animationsnachweisen ist der tatsächliche Zeitpunkt einzutragen, nicht nur „irgendwo in der Mitte gibt es einen Frame“. review_required wird vom Bewertungssystem nach einer festgelegten Regel gesetzt. Der Judge entscheidet darüber nicht allein. Selbst wenn das Feld false ist, kann die Stichprobe dennoch in ein zufälliges Audit gelangen. Eine fehlgeschlagene automatische Bewertung, unzureichendes visuelles Material und eine nicht bestandene Aufgabe sollten getrennt protokolliert werden. Sie sollten sich keinen vagen gemeinsamen Status „fehlgeschlagen“ teilen.
Anmerkungen und Quellen
- Yushi Hu u. a., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. Die Arbeit wandelt textliche Anforderungen in Frage-Antwort-Prüfungen um, um die Übereinstimmung zwischen Bild und Text zu bewerten. Dieser Artikel übernimmt die Idee der Zerlegung. Er überträgt die experimentellen Ergebnisse der Originalarbeit nicht auf Pelikan-SVG- oder Animationsaufgaben. Paper↩
- W3C, Scalable Vector Graphics (SVG) 2, Kapitel zu Dokumentstruktur und Pfaden. Siehe Gruppierung, Wiederverwendung über
useund Pfadausdrücke. Die Einschätzung, dass ein DOM-Knoten nicht von Natur aus einem realen semantischen Objekt entspricht, ist eine darauf gestützte Designentscheidung dieses Artikels für die Bewertung. Dokumentstruktur; Pfade↩ - W3C, SVG 2 — Conformance Criteria, Abschnitte zu Verarbeitungsmodi und Dokumentkonformität. Die Spezifikation unterscheidet Fähigkeiten wie Skriptausführung, externe Ressourcen und deklarative Animation sowie verschiedene Dokumentformen. Browserunterstützung und Ausführungsbeschränkungen müssen trotzdem in der tatsächlichen Umgebung geprüft werden. Spezifikation↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, Passagen zu Koordinatentransformationen und Bounding Boxes. Die Vorschläge in diesem Artikel zu Kontaktabstand, Schwellenwerten und semantischer Erkennung sind Beispiele für Bewertungsdesign. Sie sind kein von der SVG-Spezifikation definierter Algorithmus für „korrektes Fahren“. Spezifikation↩
- Lianmin Zheng u. a., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Dieser Artikel stützt sich darauf nur für die Aussagen zu Fähigkeiten und Verzerrungen von Judges bei bestimmten Textbewertungen. Er schließt daraus nicht, dass jeder visuelle Judge Verzerrungen derselben Größenordnung oder dieselbe Genauigkeit aufweist. Paper↩
- Pooyan Rahmanzadehgervi u. a., Vision language models are blind, 2024. Dieser Artikel bezieht sich auf die ursprüngliche Studie von 2024 und zitiert gezielt arXiv v1, damit spätere Überarbeitungen von Modellen, Titel und Ergebnissen nicht vermischt werden. Die Studie kann nicht als aktuelle Rangliste der Modelle von 2026 dienen. Paper-Version↩
- Playwright-Dokumentation zur Option
animationsvonpage.screenshot, abgerufen am 5. Oktober 2026. Die Dokumentation beschreibt, wie diese Option CSS-Animationen, CSS-Transitions und Web Animations behandelt. Sie sollte nicht ohne Prüfung zu einer einheitlichen Zeitsteuerung für alle SVG-Animationsmechanismen verallgemeinert werden. Dokumentation↩ - Colin White u. a., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. Ein früherer Titel verwendete „Contamination-Free“. Dieser Artikel folgt der Formulierung der Überarbeitung von 2025 zu laufenden Aktualisierungen, überprüfbarer Bewertung und verringertem Kontaminationsrisiko. Er verspricht nicht, dass Kontamination völlig ausgeschlossen ist. Paper↩
- Docker-Dokumentation von Playwright, abgerufen am 5. Oktober 2026. Die Dokumentation rät davon ab, das Standard-Image für den Besuch nicht vertrauenswürdiger Websites zu verwenden, und erklärt, dass der standardmäßige Betrieb als root die Chromium-Sandbox deaktiviert. Dieser Artikel bietet kein vollständiges sicheres Deployment. Isolation, Netzwerk- und Berechtigungsrichtlinien müssen für die jeweilige Laufzeitumgebung umgesetzt und getestet werden. Dokumentation↩
- Öffentliche Startseite von Folkbench, abgerufen am 5. Oktober 2026. Die Startseite bietet Einstiege zur Rangliste, zu Berichten und zugehörigen Erläuterungen und beschreibt den Vergleich als einen Vergleich verschiedener Dienste für dasselbe Modell. Ihr Einstieg zur Messung ist zudem als „Beta-Vorbereitungsablauf“ gekennzeichnet, mit dem Hinweis „Echte Messungen sind noch nicht aktiviert; der aktuelle Einstieg zeigt den Vorbereitungsablauf“. Dieser Artikel verweist nur auf die öffentlichen Informationen. Er behandelt einen Vorschau-Einstieg nicht als abgeschlossene Messung, befürwortet keine bestimmte Rangfolge unabhängig und behauptet nicht, dass Folkbench die hier vorgeschlagene Bewertung in vier Dimensionen, die Kalibrierung des Judges oder den dynamischen Aufgabenpool umgesetzt hat. Startseite↩


