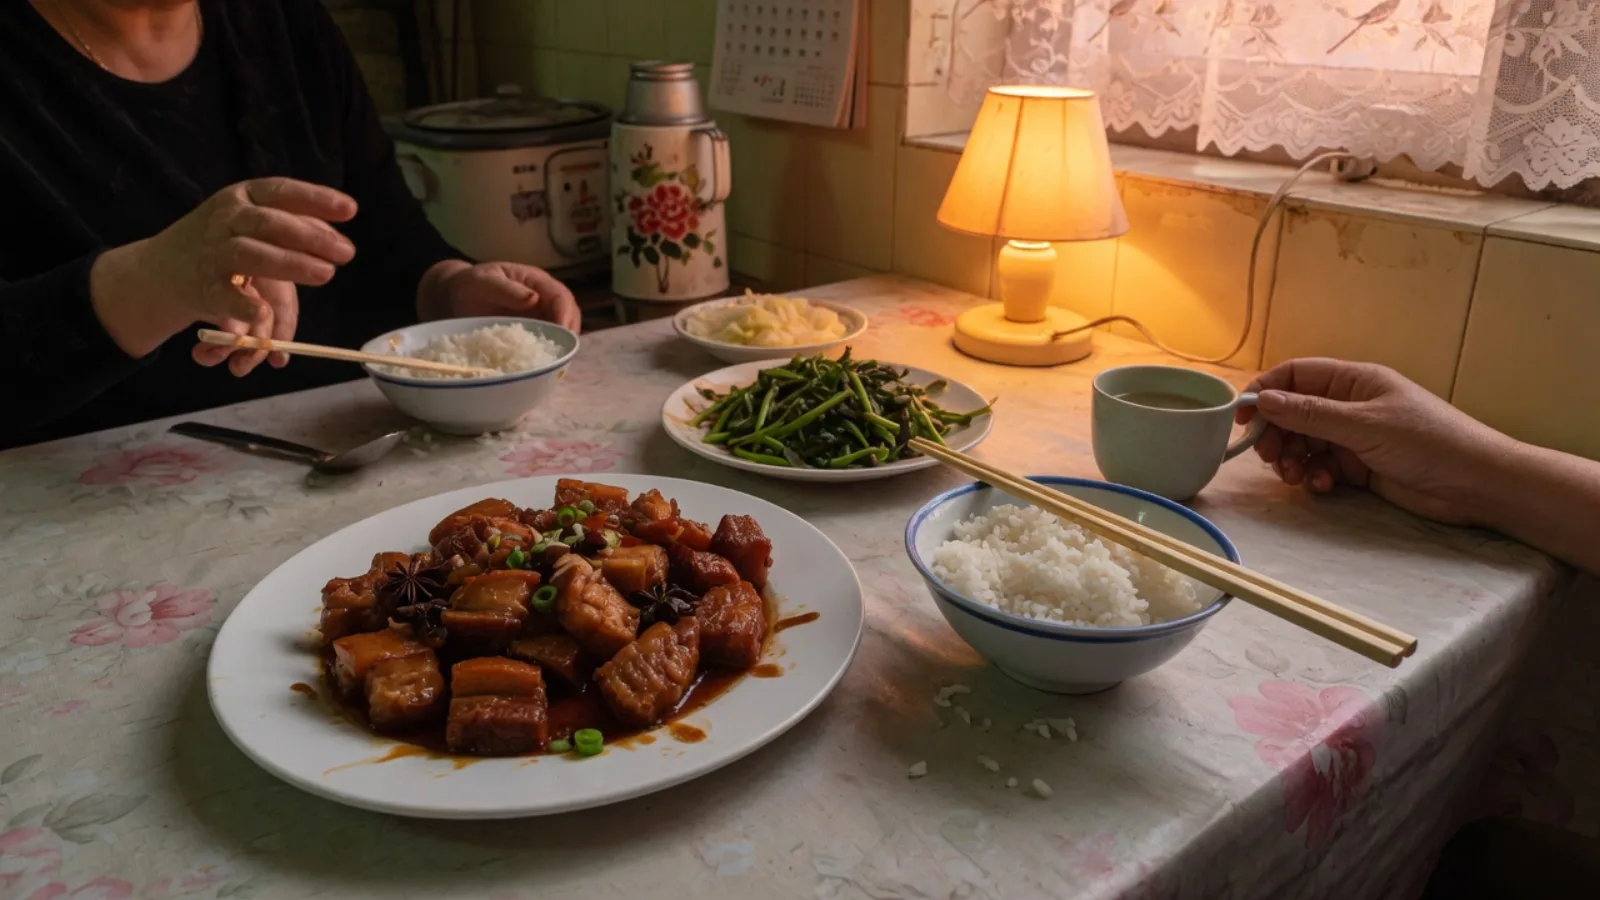
几乎打平
GLM 5.2 只领先 Kimi K2.7 Code 0.1 分
四个模型从 70.8 到 69.5 只差 1.3 分,不足以宣布一个稳定赢家。
提交后,这次的结果会显示在这里。
本轮结果
几乎打平
四个模型从 70.8 到 69.5 只差 1.3 分,不足以宣布一个稳定赢家。
按语气选
想在亲戚面前说得热闹可先看 Kimi K2.7 Code;想鼓励妈妈继续做新菜,GPT-5.6 Terra 更自然。
4/12 题得分居首(含并列);未触发规则提示或硬性风险
5/12 题得分居首(含并列);硬性风险 0 项,规则提示 1 项
4/12 题得分居首(含并列);硬性风险 0 项,规则提示 1 项
2/12 题得分居首(含并列);硬性风险 0 项,规则提示 1 项
阅读回答
我妈今天做的红烧肉有点咸,但肉炖得挺软,颜色也好看。我不想扫兴,想夸得真诚一点。
4 个回答
妈,今天这红烧肉炖得真到位,肉软软糯糯的,入口就化,颜色也红亮红亮的,看着就特别有食欲。你手艺真是越来越好了,我都能多吃一碗饭。
妈,你这红烧肉简直可以开店了!肉质那么软烂,色泽还这么诱人,一口下去满嘴香,我太幸福了,天天能吃到你做的菜。
今天我妈的红烧肉C位出道!软烂入味、色泽诱人,家常饭桌直接吃出仪式感。有这样的妈妈,谁还想去外面下馆子。
| 模型 | 这轮最突出的地方 | 说出口之前要注意 |
|---|---|---|
| GLM 5.2 | 以 70.8 分微弱领先,不油腻 84 分为全场最高;“妈妈下班很累还做饭”一题最会看见辛苦。 | 有时会自行补充亲戚称呼、多年研究配方等原场景没有的细节,长句也容易像准备好的发言。 |
| Kimi K2.7 Code | 幽默 57.4 分为全场最高,过年饭桌和亲戚场景更热闹,同时会点到具体菜品。 | 在酸菜鱼题里出现“米其林级别”的广告腔;家里不吃这套时,要删掉开店、排队、封神类夸张词。 |
| GPT-5.6 Terra | 温度 64.8 分为全场最高,第一次做番茄牛腩和带饭被同事夸两题表现最好。 | 个别版本会用“传家宝”等偏满的词;气氛稍克制的家庭建议优先选它的真诚版。 |
| Sonnet 5 | 拿手酸菜鱼一题得分最高,真诚、嘴甜和撒娇三种版本区分得比较清楚。 | 整体只比第一名低 1.3 分,但温度和幽默分都略低;番茄牛腩题出现“直接封神”,朋友圈腔稍重。 |
GLM 5.2、Kimi K2.7 Code、GPT-5.6 Terra 和 Sonnet 5 分别是 70.8、70.7、70.5 和 69.5 分。这组题没有出现踩低其他家人的硬性风险,真正的区别主要在语气:GLM 5.2 更克制,Kimi K2.7 Code 幽默感更强,GPT-5.6 Terra 更会给安心感,Sonnet 5 在拿手菜场景有不错的单题表现。
这组测试看的是模型有没有生活里的嘴甜和分寸感,而不是会不会写广告文案。我们拆成 12 个场景,覆盖菜有小问题、第一次做新菜、过年饭桌、朋友圈、拿手菜、亲戚热场、看见妈妈辛苦、避开家庭比较、低调短句、清淡菜和转述同事夸奖,再从夸得具不具体、有没有真心味、好不好笑、油不油腻、像不像那个场景 5 个角度判断。
所有模型收到完全相同的当前 V1 场景和输出要求,本报告只收录 promptHash 匹配的 48 条结果。
规则评分检查 夸得具不具体、有没有真心味、好不好笑、油不油腻、像不像那个场景,同时记录每题的规则提示和硬性风险。
当前排序直接由数据集评分规则生成,报告同时展示规则提示和硬性风险。
这是一组轻量生活表达评测。四个模型最高与最低只差 1.3 分,应理解为风格差异,不应解读为稳定能力排名。