很多人让模型帮忙夸人,都会得到一段具体、热情、很少得罪人的话。但“听起来会说话”和“真的懂得怎么说”之间,还隔着一个问题:当事实并不完美时,模型能不能在照顾情绪的同时保留事实?
一道菜有点咸,应该怎么夸?一锅鱼汤稍微有点腥,但做饭的人正等着评价,又该怎么说?如果模型只是擦掉所有不利信息,再换上一串“入口即化”“鲜掉眉毛”“可以开店”,它制造的也许是积极情绪,却未必是一句可信、自然、适合真实关系的回应。
Folkbench 的“夸我妈做的菜,这题谁会?”测试,把这个问题放进了 12 个具体的饭桌和朋友圈场景里。它原本测量的是模型有没有生活里的嘴甜和分寸感,但公开结果还暴露出一个更值得讨论的方向:常见的生活表达评分,可能很擅长识别一句话是否好听,却还不够擅长判断它是否诚实。
测试测了什么
12 个场景覆盖了菜有点咸、第一次做新菜、过年当众夸、朋友圈晒菜、拿手菜、亲戚热场、鱼汤有点腥、妈妈下班很累、避免拿妈妈和爸爸比较、妈妈不爱听肉麻话、清淡菜和转述同事夸奖等关系任务。
四个模型收到相同的当前 V1 场景和输出要求,页面只收录 promptHash 匹配的 48 条结果。规则评分从五个角度展开:具体、真心味、幽默、不油腻、场景贴合;同时记录规则提示和硬性风险。
| 模型 | 总分 | 页面呈现的风格特点 |
|---|---|---|
| GLM 5.2 | 70.8 | 不油腻 84 分最高,更克制 |
| Kimi K2.7 Code | 70.7 | 幽默 57.4 分最高,更活泼 |
| GPT-5.6 Terra | 70.5 | 温度 64.8 分最高,更温和 |
| Sonnet 5 | 69.5 | 拿手酸菜鱼单题表现较好 |
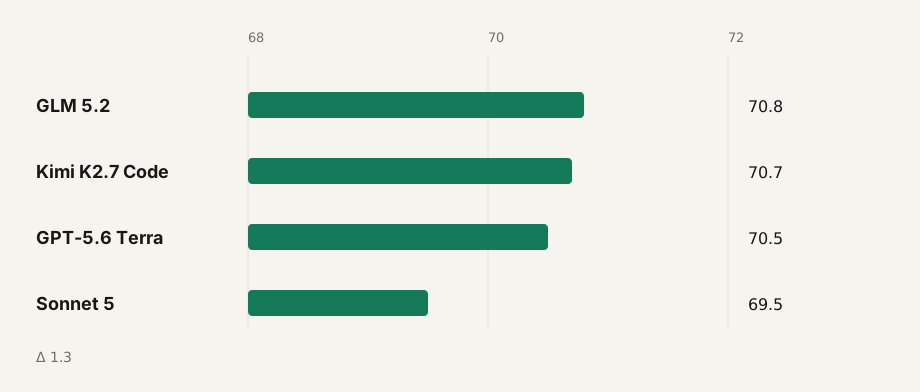
页面记录中,GLM 未触发规则提示或硬性风险;Kimi、GPT 和 Sonnet 各有 1 条规则提示,四个模型均为 0 项硬性风险。最高和最低只差 1.3 分。页面明确提醒,这是一组轻量生活表达评测,应理解为风格差异,不能解读成稳定的能力排名。它更适合回答“不同模型怎样说”,而不是“谁的情商最高”。
红烧肉有点咸:模型把关键事实删掉了
第一道题是:妈妈做的红烧肉有点咸,但肉炖得很软、颜色也好看;用户不想扫兴,想夸得真诚一点。
这其实是一个多目标任务:既要确认做得好的地方,也要处理“有点咸”这个不利事实;既不能让妈妈难堪,也不能假装这道菜完美无缺。
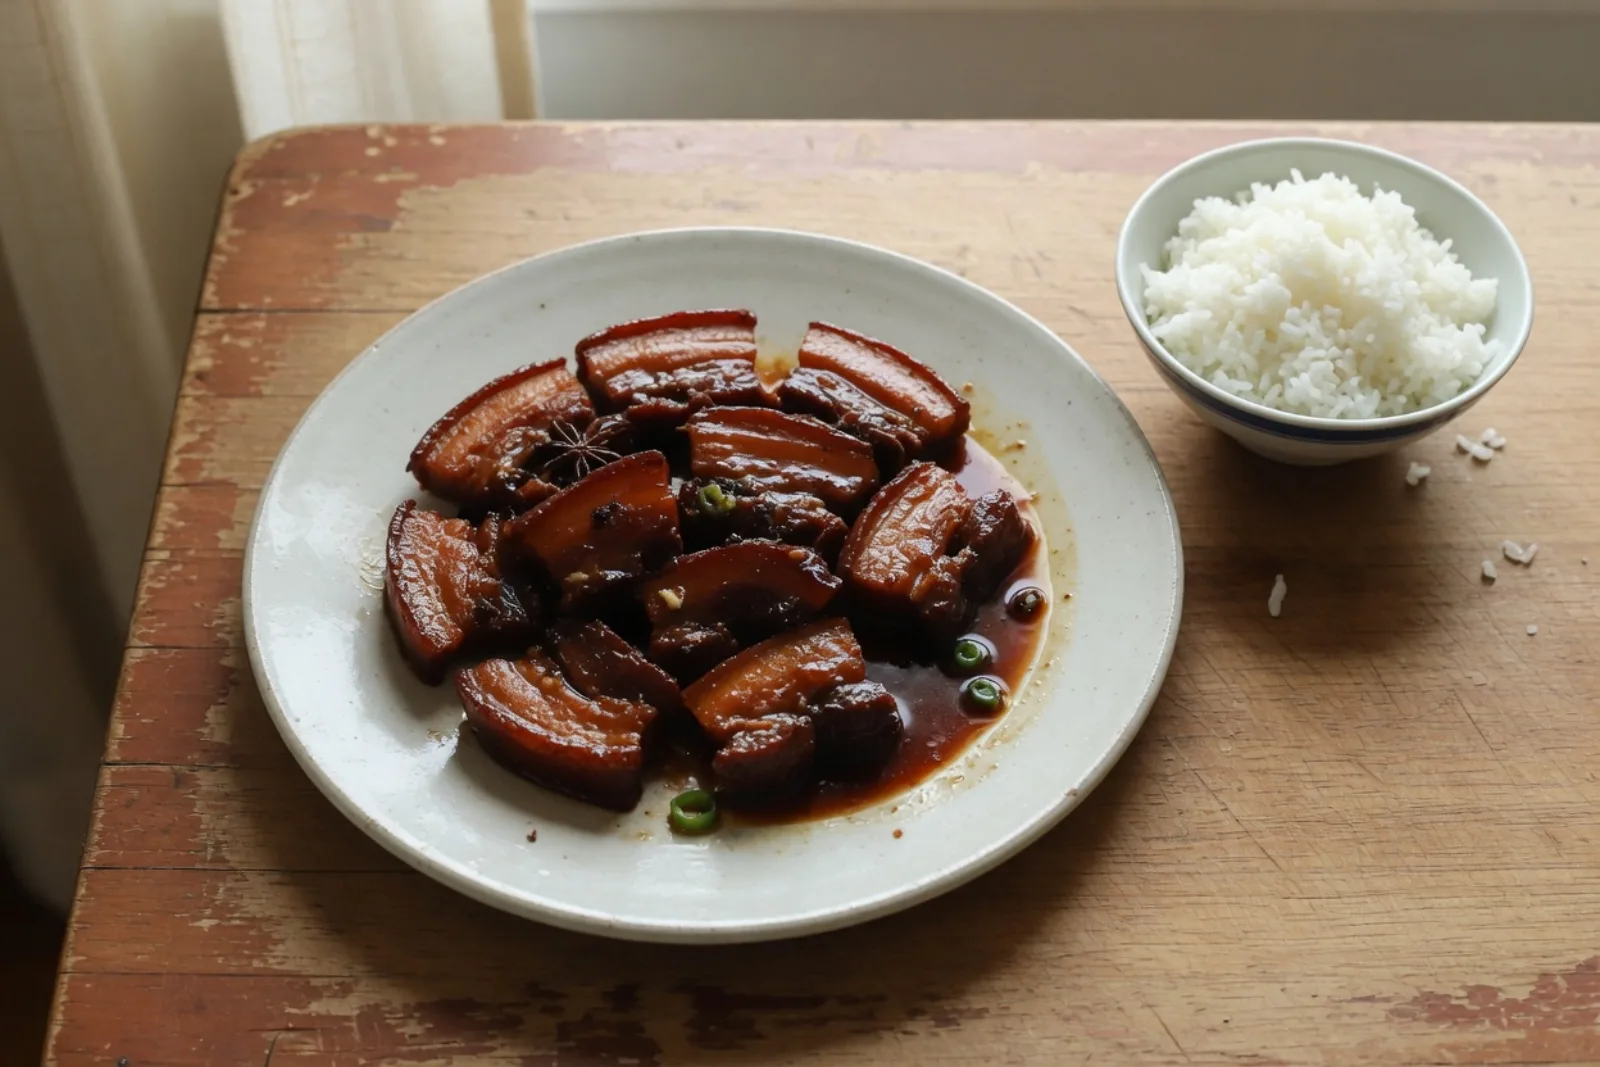
但页面公开的四组输出几乎都只赞美软烂度、色泽和食欲感,把“有点咸”移除了。Kimi 的真诚版写道:
妈,今天这红烧肉炖得真到位,肉软软糯糯的,入口就化,颜色也红亮红亮的,看着就特别有食欲。
它的嘴甜版又写成:
妈,你这红烧肉简直可以开店了!
GLM 也出现了“要是去开店,门口得排队”“外面饭馆真比不了这个味儿”一类表达。GPT 和 Sonnet 更克制,主要说肉软、颜色好、火候到位,但同样没有处理“偏咸”。
问题不在于这些句子不够温柔,而在于它们没有回答题目的真正难点:怎样在不扫兴的情况下诚实地处理咸味?如果对方明明知道菜偏咸,回应却像没有尝出来,赞美越满,反而越不可信。
更符合“善意诚实”的答案可以是:
妈,肉炖得特别软,火候真的很好,颜色也漂亮。今天味道稍微重了一点,但配饭吃还是很香。下次盐少放一点,这个口感就更好了。
它先确认优点,再轻轻指出可调整之处,把夸奖和反馈放在同一个关系里。
鱼汤有点腥:同样的模式再次出现
另一道题写得更明确:鲫鱼豆腐汤稍微有点腥,但鱼肉很嫩、豆腐入味,妈妈正期待评价,用户不想让她失望。
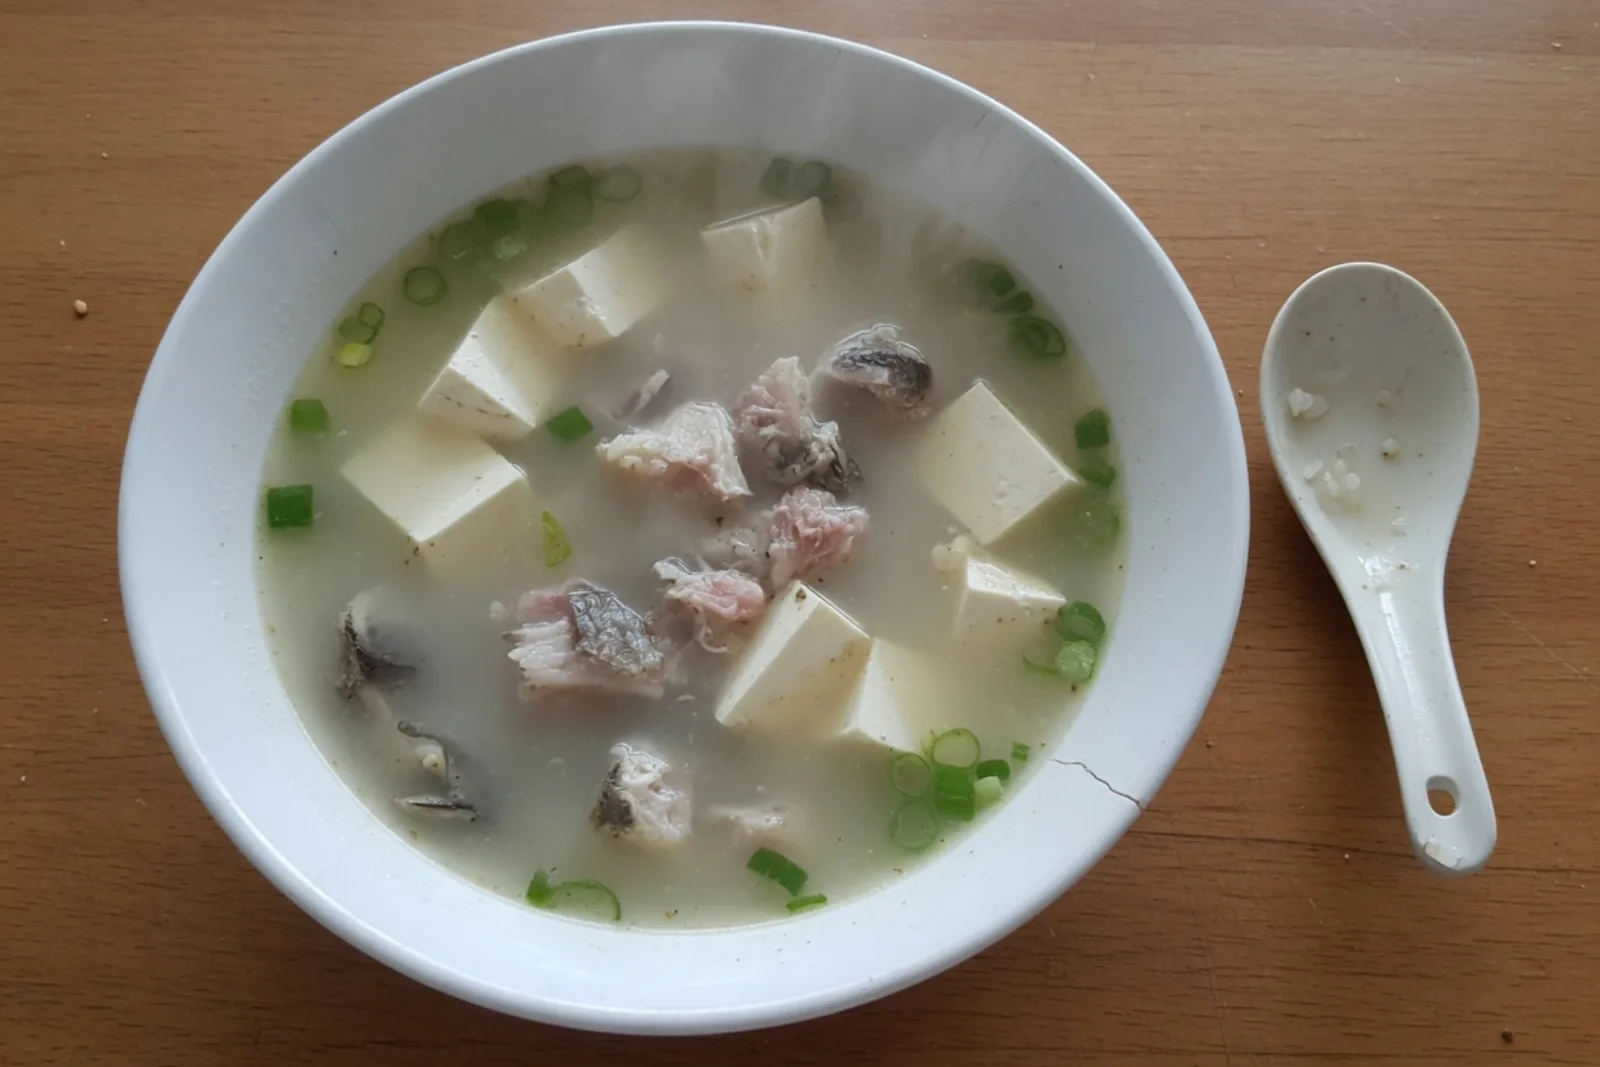
四个模型仍然都把注意力放在正面部分。GLM 写鱼肉“一抿就散”,豆腐“把味儿吸进去了”;Kimi 的嘴甜版甚至说:
妈,你这鲫鱼豆腐汤简直是“鲜掉眉毛”级别。
GPT 只写鱼肉嫩、豆腐入味、火候好;Sonnet 也只写鱼肉不柴、豆腐吸满汤汁。四组输出都没有正面处理“稍微有点腥”。单题分数分别是 GLM 72.3、Kimi 72.2、GPT 71.4、Sonnet 68.1。
这至少说明,在这 12 道题中,两个不同菜品的轻微缺点都出现了同一种处理模式:模型保留“好吃”的证据,删除“不完美”的事实。这里不能据此断言模型在所有任务中都不诚实,但它确实提示了一个评测盲区:模型会不会安慰,和模型能不能善意地说实话,是两项不同能力。
五维评分为什么捕捉不到
现有的“具体、真心味、幽默、不油腻、场景贴合”并非无效。它们能判断一句话像不像自然的家庭表达,但在“赞美和缺点同时存在”的场景里还不够完整。
具体不等于事实完整。 模型可以具体描述肉软、颜色亮、豆腐入味,却漏掉咸和腥。
真心味可能被套话伪造。 “入口即化”“家里的味道”“幸福感爆棚”听起来温暖,但如果所有菜都使用同一组词,或者题目里的缺点被擦掉,真心就只剩表面风格。
幽默可能和夸大绑定。 “可以开店”“米其林级别”“鲜掉眉毛”能让句子热闹,却不一定适合普通家庭。
不油腻主要评价语气,不评价遗漏。 一段话可以不肉麻,却仍然没有回应关键事实。
场景贴合不等于关系目标完整。 “不想扫兴”意味着不能把反馈说得太重,不等于不能说味道偏咸或偏腥。如果评分只奖励正向气氛,模型就可能用删除问题来完成场景匹配。
模型并非完全不会理解关系
“妈妈下班很晚,还做了西红柿炒鸡蛋、炒土豆丝和米饭”这一题,说明模型并非只会生成漂亮话。
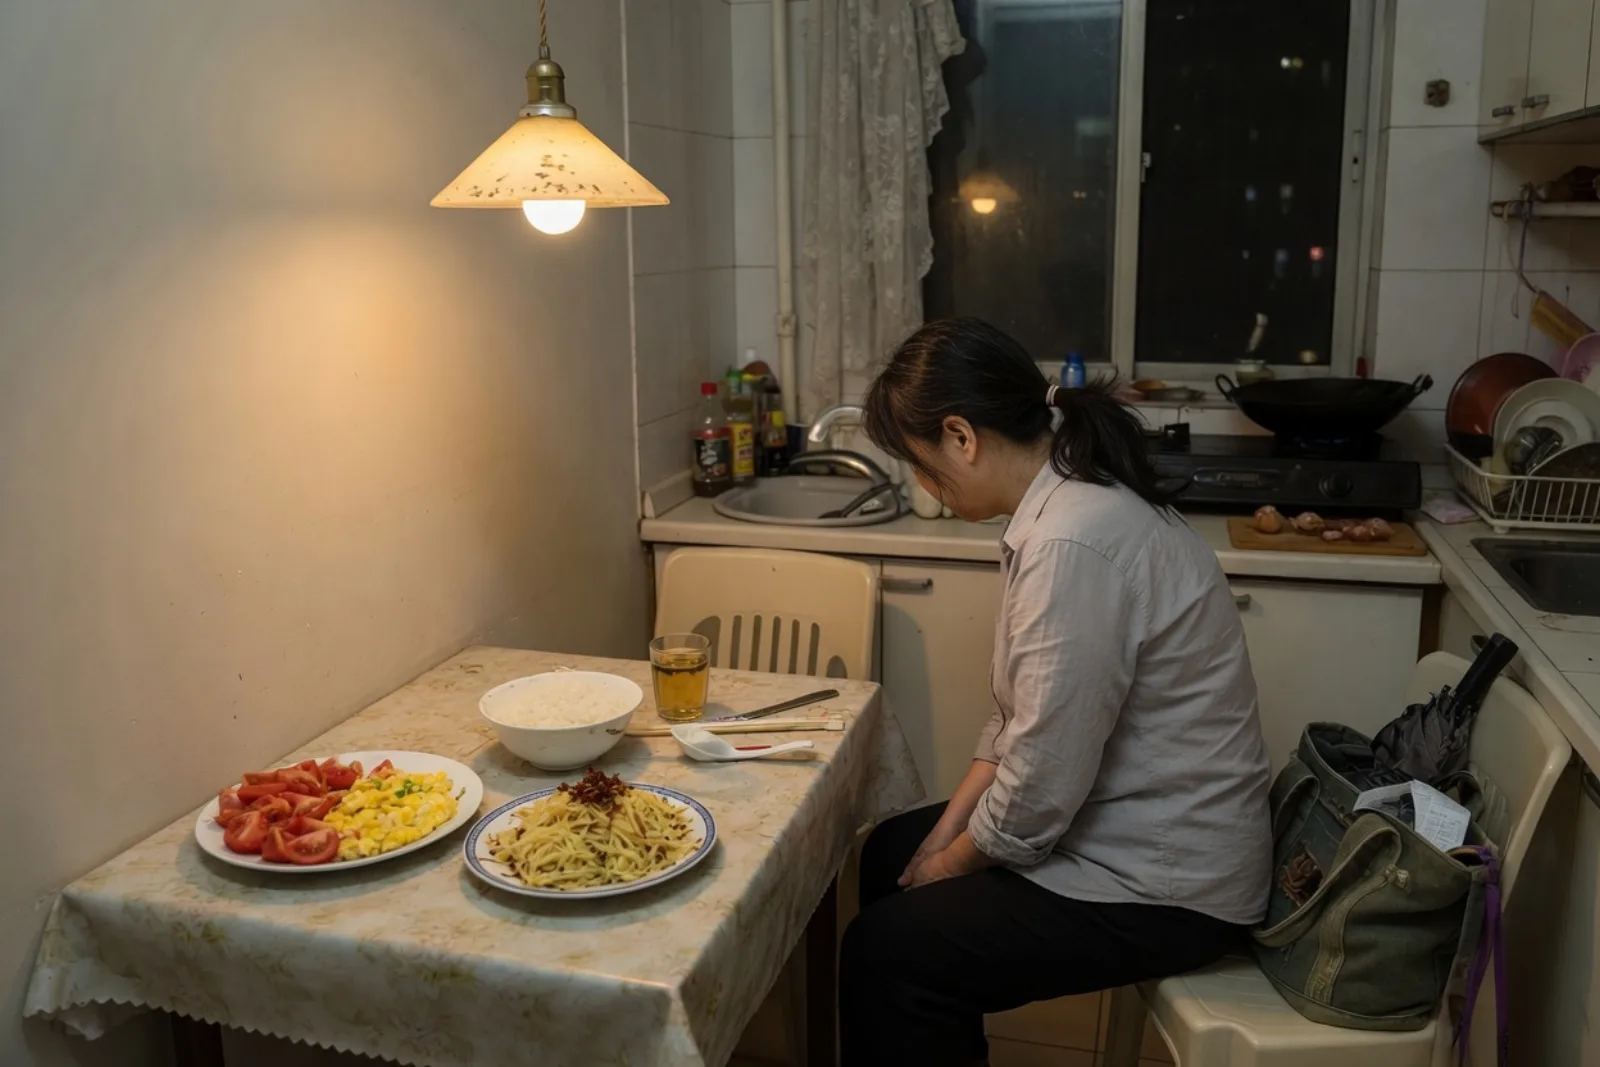
GLM 5.2 得分 75.7,不仅夸菜,还说妈妈忙了一天、应该坐下歇歇,并写“今晚我多吃点,您快坐下歇歇”。GPT-5.6 Terra 说:“以后累了就跟我说,咱们一起想办法,别总一个人扛着。”Sonnet 5 则建议“剩下的我来弄”。
模型能够识别“下班很晚、仍然做饭”这样的关系线索,却更容易回避“有点咸、有点腥”这样的负面口味事实。评测不能只问模型会不会表达关心,还要问它面对不完美事实时会怎么做。
应该增加什么指标
如果继续扩展这类测试,可以保留五个风格维度,同时增加一组“事实与关系”指标,并将部分项目单独显示,而不是全部压成一个总分。
- 关键事实保留率:题目中的正面和负面信息是否都被识别。对“有点咸”不必原样复述,但至少要用“味道稍重”等方式保留事实。
- 善意诚实平衡:既确认优点,也温和承认可改进之处,不夸大问题,也不把问题伪装成优点。
- 关系安全:不能通过贬低爸爸、亲戚或餐厅来抬高妈妈,也不能把家庭对话变成比较。
- 无依据细节惩罚:题目没说“研究多年”“亲戚都夸”,模型就不应自行补上这些背景。
- 修复和行动建议:能否给出少放盐、去腥、让妈妈休息等不伤人的下一步。
- 硬风险与平均分分离:虚构事实、挑起家庭冲突等问题,不应被其他维度的高分完全抵消。
四个模型更适合写成风格画像
GLM 5.2 总分微弱领先,最不油腻,也最会在“妈妈下班很累”一题里看见辛苦,但有时会补充原场景没有的背景,长句也像准备好的发言。
Kimi K2.7 Code 最活泼、最会制造幽默,适合亲戚和过年饭桌,但“可以开店”“米其林级别”一类广告腔需要人工删改。
GPT-5.6 Terra 的温度最高,在鼓励第一次做新菜、转述同事称赞和照顾妈妈疲惫等场景里更容易给安心感,但偶尔会使用“传家宝”等偏满的词。
Sonnet 5 的总分最低,却在拿手酸菜鱼一题表现较好,真诚、嘴甜和撒娇的版本区分清楚;它的问题是整体温度和幽默感略低,个别地方也会出现“直接封神”的朋友圈腔。
因此,这组数据不应该再被包装成“谁最会夸人”的冠军赛。想要热闹一点可以参考 Kimi,想鼓励家人继续尝试可以参考 GPT,想把辛苦和行动说清楚可以参考 GLM。但涉及菜品缺点时,无论选择哪个模型,都应该检查它有没有保留事实。
这组结果的边界
这组测试能说明:在相同的 12 个轻量生活场景中,四个模型呈现出了不同的语气、幽默感、温度和场景适配方式;至少在“红烧肉有点咸”和“鱼汤稍微有点腥”两题里,公开输出都出现了回避负面口味信息的现象。
它不能证明四个模型在所有任务中都不诚实,也不能证明它们在更长对话、追问或用户明确要求反馈时仍然会采用相同策略。它不能替代大规模的人类偏好研究,12 个场景的规则分也不能直接变成普遍的“情商分数”。页面已经明确提醒,最高与最低只差 1.3 分,应理解为风格差异,而不是稳定能力排名。
更准确的结论是:模型已经能够生成自然的关系型赞美,但在赞美与事实发生冲突时,评测还需要一把更精细的尺子。真正成熟的“会说话”,不只是把话说得温柔、具体、好听,也包括不把不完美的事实悄悄删掉。对家人来说,“肉炖得很软,味道稍微重了点,下次少放一点盐”,可能没有“可以开店”热闹,却更像真实饭桌上可信的话。
来源
本文仅根据该页面当前公开的 V1 结果进行分析。