Satu kegagalan dapat membuktikan bahwa model pernah keliru. Kegagalan itu saja tidak dapat membuktikan bahwa model kini lebih sering gagal daripada dulu.
“Apakah model ini jadi lebih bodoh lagi?” Seekor pelikan dengan satu kaki menggantung di luar pedal, sepeda dengan rangka yang terpelintir seperti simpul, lalu disandingkan dengan tangkapan layar minggu lalu yang tampak cukup bagus: itu sudah cukup untuk memunculkan pertanyaan tersebut.
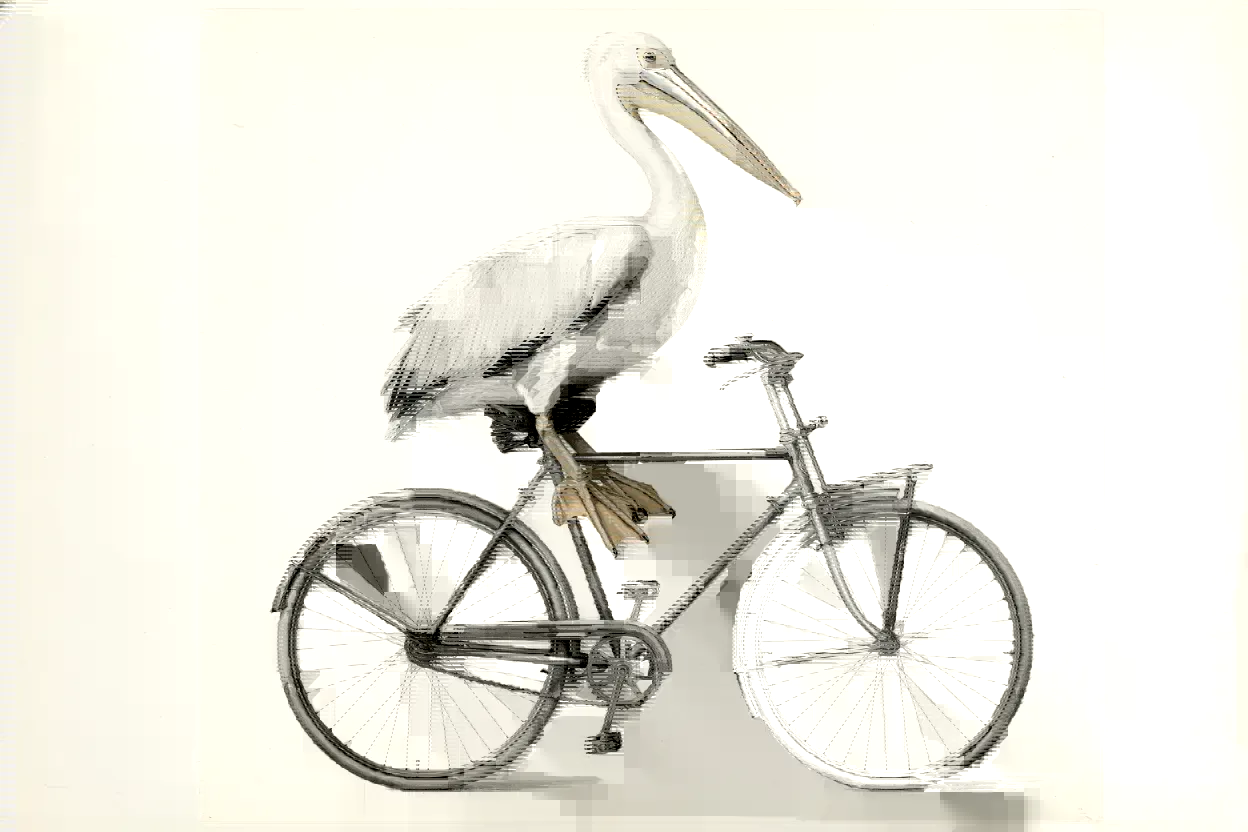
Kecurigaan seperti itu tidak sepatutnya ditepis dengan “model memang acak”. Seseorang membayar untuk tugas yang dulu bisa diselesaikan layanan itu, dan sekarang tidak lagi. Hal itu layak dipertanyakan. Meski begitu, dua tangkapan layar belum cukup untuk menunjukkan bahwa modelnya ditukar, anggaran penalarannya dipangkas, atau layanan tertentu telah diencerkan.
Beberapa waktu lalu saya menjalankan Uji Pelikan puluhan kali. Yang membuat tugas ini berguna adalah banyak kesalahannya tergambar langsung di tempat yang bisa dilihat. Kode yang berjalan tidak berarti struktur sepedanya benar. Burung dan sepeda yang sama-sama ada tidak berarti kakinya benar-benar berada di pedal. Hubungan spasial seperti itu lebih mudah ditangkap mata daripada jawaban yang lancar tetapi mungkin masih menyembunyikan celah logika. Makin banyak hasil yang saya simpan, makin jelas satu hal lain: kita sering menilai sebuah layanan secara keseluruhan dari satu karya saja.
Artikel ini tidak dimaksudkan untuk membela model mana pun, dan tidak mengajari siapa pun mengenali “model palsu” dari beberapa ciri permukaan. Pertanyaan yang saya pedulikan lebih sempit. Ketika kita menduga sebuah model memburuk, bagaimana kita mengubah perasaan itu menjadi bukti yang dapat diperiksa ulang oleh orang lain?
Catatan: layanan A dan B di bawah, beserta semua angka uji yang menyertainya, adalah contoh untuk keperluan penjelasan. Keduanya tidak merujuk ke layanan nyata mana pun, dan bukan hasil pengukuran atau peringkat Folkbench.
1. Pisahkan dulu pertanyaannya: apa yang Anda maksud dengan “lebih bodoh”?
“Jadi lebih bodoh” adalah ungkapan yang praktis, dan ungkapan itu melipat beberapa pertanyaan berbeda menjadi satu. Lapisan paling langsung adalah: jawaban yang satu ini salah. Pelikannya tumbuh kaki tambahan, kakinya meleset dari pedal, atau rodanya terlepas dari rangka. Masing-masing adalah kegagalan konkret yang bisa Anda periksa. Satu sampel sudah cukup untuk membuktikan bahwa “kesalahan semacam ini pernah terjadi”, dan cukup untuk mematahkan janji bahwa “model ini tidak akan pernah membuat kesalahan semacam ini”. Lapisan kedua adalah: dalam kondisi yang sama, atau cukup mirip, layanan ini lebih sering gagal.
Ini bukan lagi soal ada atau tidaknya kesalahan, melainkan seberapa sering kesalahan itu muncul. Bagian dari “pengalaman makin buruk” yang paling layak diukur adalah pergeseran dari “biasanya berhasil” menjadi “biasanya tidak”. Lapisan ketiga adalah: perubahan itu disebabkan oleh perubahan pada model itu sendiri, atau pada konfigurasi di sisi server. Ini sudah merupakan klaim tentang penyebab. Hasil buruk yang sama dapat berasal dari penjelasan yang berbeda-beda: parameter permintaan yang berbeda, konteks yang berbeda, output yang terpotong, atau perubahan nyata pada model dasar dan pengaturan inferensinya. Melihat hasilnya saja biasanya tidak cukup untuk menunjuk satu penjelasan di antaranya.
Jadi, “yang ini salah”, “layanan ini kurang andal”, dan “layanan ini diam-diam menukar modelnya” tidak menuntut bukti dengan kekuatan yang sama. Menyadari perbedaan itu tidak menaikkan standar bagi keluhan pengguna. Justru sebaliknya. Merumuskan pertanyaan dengan jelas mencegah penyedia menjelaskan setiap kegagalan sebagai “keacakan”, dan mencegah evaluator menjelaskan setiap perbedaan sebagai “modelnya ditukar”.
2. Apakah Anda melihat satu karya, atau sebaran output?
Dengan pengaturan generasi yang mengambil sampel secara acak, input yang sama dapat menghasilkan output yang berbeda. Bahkan ketika Anda memakai kontrol tertentu untuk meningkatkan reprodusibilitas, “sekonsisten yang bisa kami usahakan” tidak boleh dibaca sebagai “identik setiap kali”. Sebuah catatan teknis lama dari OpenAI menyatakannya secara eksplisit: dengan seed yang sama, parameter yang sama, dan sidik jari backend yang sama, output tetap tidak dijamin identik. Itu adalah batas reprodusibilitas. Itu tidak berarti setiap model saat ini menerima parameter yang sama.1
Untuk Uji Pelikan, yang biasanya ingin kita ketahui bukan “apakah model ini sesekali bisa menggambar satu gambar yang bagus?”, melainkan “dalam kondisi yang saya tentukan, jika saya memberikan tugas ini sekali lagi, seberapa besar peluang hasilnya lolos?” Contoh yang disederhanakan berikut menunjukkan masalah satu tangkapan layar. Misalkan tingkat lolos sekali coba yang sebenarnya dari sebuah layanan adalah 80%, setiap generasi independen, dan keadaannya tidak berubah selama pengujian. Peluang setidaknya satu kegagalan dalam 20 percobaan berturut-turut adalah: 1 − 0.8²⁰ ≈ 98.85% Layanan yang biasanya mengerjakan tugasnya dengan baik hampir pasti meninggalkan satu kegagalan yang bisa ditangkap layar, di suatu titik dalam 20 percobaan itu.
Balikkan sudut pandangnya. Misalkan tingkat lolos sekali coba yang sebenarnya dari layanan lain hanya 40%. Dengan asumsi independensi dan stabilitas yang sama, peluang setidaknya satu hasil lolos dalam 20 percobaan adalah: 1 − 0.6²⁰ ≈ 99.996% Layanan ini pun hampir pasti menghasilkan satu karya yang bisa dipamerkan. Kedua perhitungan ini tidak mengatakan bahwa setiap panggilan nyata itu independen, dan tidak mengatakan bahwa tingkat lolos yang sebenarnya persis sebesar angka-angka ini. Keduanya menunjuk pada sebuah pilihan: hanya menampilkan percobaan terbaik membuat keandalan mudah dilebih-lebihkan, dan hanya menampilkan percobaan terburuk membuat penurunan mudah dibesar-besarkan.
Karena itu, layanan yang sama bisa muncul dalam satu unggahan yang menjadikan satu gambar sebagai bukti bahwa layanan itu masih bertenaga penuh, dan dalam unggahan lain yang menjadikan satu gambar sebagai bukti bahwa layanan itu jadi lebih bodoh. Kedua tangkapan layar itu bisa sama-sama asli. Kesimpulan yang ditarik darinya belum tentu benar. Ada satu perbedaan lagi yang mudah terlewat. Berhasil pada generasi pertama, dan menghasilkan sepuluh kali lalu memilih yang berhasil, bukanlah kemampuan yang sama. Yang kedua mencakup panggilan tambahan, waktu tunggu, dan biaya memilih. Jika Anda membandingkan dua alur kerja, beri keduanya anggaran percobaan yang sama. Jangan membandingkan percobaan pertama A dengan hasil pilihan terbaik B.
3. Apakah 20 kali percobaan otomatis membuat perbedaan bermakna secara statistik?
Tidak. Dua puluh kali percobaan bisa menjadi anggaran eksperimen yang wajar, tetapi itu bukan izin statistik. Ambil contoh konkret yang sama. Kanal A dijalankan 20 kali dan lolos 16 kali. Kanal B dijalankan 20 kali dan lolos 8 kali. Keduanya memakai satu tugas tetap dan aturan penilaian yang sama, dan setiap sampel disimpan.
| Kanal | Lolos / total | Tingkat sampel | Interval Wilson 95% untuk tingkat lolos |
|---|---|---|---|
| A | 16 / 20 | 80% | 58,4%–91,9% |
| B | 8 / 20 | 40% | 21,9%–61,3% |
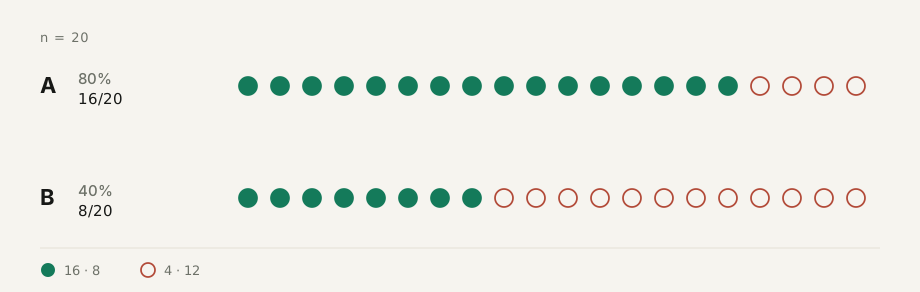
Interval tersebut adalah interval Wilson 95% dua sisi untuk proporsi binomial. Interval ini menyatakan ketidakpastian dalam estimasi tingkat lolos, bukan rentang skor untuk kualitas gambar.2 Selisih dalam sampel adalah 40 poin persentase. Dengan hanya 20 percobaan di masing-masing sisi, estimasinya masih kasar. Angka 80% dan 40% tidak boleh diperlakukan sebagai kemampuan sebenarnya yang sudah terukur tepat dan tidak akan pernah bergeser.
Jika kita juga mengasumsikan bahwa panggilan-panggilan itu independen, bahwa peluang lolos setiap kanal stabil di dalam jendela pengamatan, dan bahwa perbandingan ini dipilih sebelumnya, uji eksak Fisher dua sisi pada hitungan lolos / tidak lolos menghasilkan p ≈ 0.0225. Pada taraf signifikansi 5% yang dipilih sebelumnya, contoh ini mendukung kesimpulan bahwa “tingkat lolos keduanya berbeda dalam kondisi ini”.3 Angka itu bukan “peluang 97,75% bahwa B telah diencerkan”, dan bukan pula “peluang 97,75% bahwa A selamanya lebih baik”. Nilai p adalah peluang munculnya data seekstrem ini, atau lebih ekstrem, di bawah hipotesis tanpa perbedaan dan kondisi pengujian tersebut. Nilai p bukan peluang adanya penyebab tersembunyi.3
Jangan mengganti uji perbedaan dengan sekadar melihat apakah kedua interval tumpang tindih. Setiap interval mengestimasi satu tingkat, sedangkan uji tersebut menyangkut selisih di antara keduanya. Ada tiga batasan yang lebih penting daripada menghafal satu jenis uji. Lihat besarnya selisih dan ukuran sampel secara bersamaan. 16 lawan 8 tidak semestinya mendukung kesimpulan sekuat 16 lawan 15. Berapa banyak sampel yang Anda perlukan bergantung pada seberapa kecil selisih yang ingin Anda deteksi, dan seberapa besar risiko salah putusan yang bersedia Anda terima. Tidak ada aturan “jalankan minimal sekian kali” yang cocok untuk semua tugas.
Tidak menemukan perbedaan yang signifikan tidak membuktikan bahwa keduanya sama. Datanya mungkin saja terlalu sedikit, atau terlalu tidak stabil, untuk mendukung kesimpulan. Untuk menunjukkan bahwa sebuah perbedaan cukup kecil sehingga bisa diabaikan, tetapkan terlebih dahulu apa arti “cukup kecil”. Hasil yang tidak signifikan bukan bukti kesetaraan. Perbedaan statistik saja bukan alasan untuk berganti layanan. Pengguna tetap harus menimbang biaya sebuah kegagalan, harga panggilan, latensi, dan biaya mengulang pekerjaan. Sebuah perbedaan bisa nyata, tetapi tetap terlalu kecil untuk mengubah pilihan. Tugas statistik di sini bukan menghasilkan nilai p yang terlihat profesional, melainkan mencegah kita mengklaim lebih dari yang sanggup dipikul oleh bukti.
4. Baseline adalah kontrak eksperimen, bukan kalimat “prompt-nya sama”
Banyak perbandingan gagal sebelum ukuran sampel menjadi persoalan, karena sampelnya memang tidak sebanding sejak awal. Kedua pihak diminta “menggambar pelikan yang mengendarai sepeda”. Satu panggilan adalah permintaan API dalam sesi baru. Yang lain berasal dari jendela obrolan yang sudah berjalan puluhan giliran, dengan alat-alat yang diaktifkan. Satu pihak mungkin menulis output panjang, sementara pihak lain mencapai batas panjang di tengah jalan. Mengulanginya seratus kali pun tetap tidak memungkinkan Anda mengaitkan hasilnya dengan perbedaan kemampuan model.
Penelitian tentang standar evaluasi OLMES menunjukkan bahwa pilihan evaluasi seperti format prompt, contoh dalam konteks, dan susunan kata tugas mengubah performa yang Anda ukur. Perbandingan yang dapat direproduksi harus mencatat pengaturan tersebut. Tugas dalam penelitian itu bukan SVG pelikan, tetapi peringatannya tentang konfigurasi eksperimen layak diperhatikan.4 Saya akan memperlakukan baseline sebagai kontrak tentang “apa yang sebenarnya diukur dalam putaran ini”.
Objek yang dibandingkan harus spesifik: layanannya, grup atau rutenya, dan versi model yang benar-benar dapat Anda peroleh. Jika yang Anda punya hanya alias model yang bisa berubah dari waktu ke waktu, catat aliasnya. Jika Anda tidak mengetahui snapshot yang mendasarinya, tulis “tidak diketahui”. Jangan menganggap string model yang dikembalikan oleh antarmuka sebagai verifikasi independen atas identitas yang mendasarinya. Simpan input selengkap mungkin. Artinya bukan hanya prompt terakhir, tetapi juga prompt sistem, riwayat, lampiran, dan pengaturan alat yang dapat Anda kendalikan dan amati. Menyamakan kondisi yang terlihat tidak membuktikan bahwa kondisi yang tidak terlihat juga sama.
Untuk pengaturan generasi, catat tingkat upaya penalaran, batas output, dan parameter sampling yang benar-benar didukung antarmuka. Tulis “tidak didukung” untuk kolom yang tidak disediakan antarmuka, dan “tidak diketahui” untuk kolom yang tidak dapat Anda pastikan berlaku. Jangan diam-diam memperlakukannya sebagai setara. Pengaturan bernama “high” tidak boleh diasumsikan berarti anggaran komputasi yang sama pada dua model yang berbeda.
Lingkungan evaluasi mencakup cara Anda me-render dan cara Anda menilai. Periksa SVG yang sama di viewport dan renderer yang sama. Untuk tugas animasi, gunakan jendela pengamatan yang telah disepakati. Jangan menonton gerakan lengkap di satu sisi lalu hanya memilih satu frame di sisi lain. Jika tugasnya tidak meminta animasi, jangan mengurangi poin karena output-nya berupa gambar diam. Terakhir, tulis aturan pengulangan sebelum pengujian dimulai. Apakah kegagalan pertama boleh diulang, berapa kali, dan apakah umpan balik diperbolehkan, semuanya bagian dari kondisi pengujian. Semua itu bukan hal yang boleh diimprovisasi setelah hasil keluar.
Menetapkan hal-hal ini bukan upaya membangun “model laboratorium” yang terlepas dari dunia nyata. Anda tentu boleh membandingkan pengalaman bawaan dua produk obrolan. Kesimpulannya kemudian adalah “kedua produk ini berbeda dalam apa yang mereka hasilkan dengan pengaturan bawaan”, bukan “saya telah mengisolasi bobot model dasar mana yang lebih baik”. Kondisi yang tidak dapat Anda kendalikan boleh tetap berstatus tidak diketahui. Kondisi yang tidak diketahui tidak boleh dicatat sebagai terkendali.
5. Cara Anda menyusun pengujian sering kali lebih penting daripada sekadar menjalankannya lebih banyak
Jangan ikat kanal dengan waktu
Menjalankan semua percobaan A pada pagi hari, lalu semua percobaan B larut malam, mencampuradukkan “perbedaan antarkanal” dengan “perbedaan antarwaktu”. Kalaupun Anda melihat selisih, sulit mengatakan seberapa besar selisih itu bergantung pada jendela waktu tersebut. Untuk perbandingan berdampingan yang ringan, saya akan menyelang-nyeling A dan B di dalam jendela yang dipilih sebelumnya, dan mengacak urutannya. Usahakan tingkat konkurensi semirip mungkin. Jangan biarkan satu pihak menghasilkan satu per satu sementara pihak lain menampung lonjakan permintaan sekaligus.
Anda bisa melangkah lebih jauh dengan membagi jendela menjadi beberapa batch kecil, dengan A dan B di setiap batch. Selain hasil keseluruhan, Anda kemudian bisa melihat apakah perbedaan itu terpusat di satu batch saja. Urutan acak membantu mengurangi pengaruh pengganggu dari waktu, tetapi tidak otomatis menghilangkan korelasi akibat backend bersama, gangguan singkat, atau hal serupa.
Pertanyaan longitudinal, “apakah lebih buruk daripada minggu lalu?”, berbeda. Waktu justru variabel yang Anda teliti, sehingga Anda tidak bisa mengunci kedua sisi pada saat yang sama. Pertahankan sejauh mungkin tugas inti, konfigurasi, dan aturan penilaian yang sama, lalu jalankan ulang sebuah layanan pembanding di setiap jendela pengamatan. Jangan terus-menerus membandingkan hasil hari ini dengan satu gambar terbaik minggu lalu. Saat membaca hasil longitudinal, simpan tingkat lolos absolut sekaligus selisih relatifnya. Jika layanan yang diuji dan layanan pembanding sama-sama turun, selisih di antara keduanya bisa tetap sama. Itu tidak berarti pengalaman pengguna tidak memburuk. Pembanding bukanlah kebenaran yang selalu tepat dan selalu stabil.
Jangan memutuskan kapan berhenti sambil melihat hasil
“Jalankan lima kali. Jika A menang, unggah. Jika A tidak menang, lanjutkan sampai perbedaannya signifikan.” Cara itu tampak seperti menambah sampel, padahal mengubah aturan statistiknya. Mengintip uji dengan sampel tetap berulang kali, lalu berhenti karena apa yang Anda lihat, merusak pengendalian positif palsu yang menjadi dasar rancangan uji tersebut. Pengujian yang perlu memantau data secara terus-menerus sebaiknya memakai metode yang dirancang untuk analisis sekuensial.5 Kebanyakan orang tidak perlu memulai dari statistik sekuensial. Praktik yang paling mudah adalah menuliskan, sebelum putaran dimulai, berapa kali Anda akan menjalankan pengujian, metrik utama mana yang akan Anda gunakan, dan perbandingan utama mana yang akan Anda lakukan. Lalu simpan setiap hasil.
Mencoba beberapa panggilan lebih dulu, untuk memastikan antarmuka dan proses penilaian berfungsi, tidak masalah. Itu adalah uji coba awal. Setelah Anda selesai mengubah prosedur, mulailah pengujian formal secara terpisah. Jangan mencampur hasil dari tahap menyetel tugas dengan hasil formal. Prinsip yang sama berlaku untuk dua kebiasaan lain. Mencoba puluhan tugas lalu hanya memublikasikan satu yang tampak terbaik, atau melihat skor total tertinggal lalu menyatakan menang di satu subskala, bukanlah perbandingan yang Anda sepakati sebelumnya.
Jangan anggap seratus pengulangan satu tugas sebagai seratus tugas
Generasi berulang memberi tahu Anda seberapa andal layanan itu pada tugas ini, tetapi tidak otomatis memperluas klaim. Pelikan yang keluar dengan stabil tidak dengan sendirinya berarti debugging kode, analisis panjang, dan kepatuhan pada instruksi yang kompleks sama andalnya. Ketika Anda menarik kesimpulan tentang suatu kelas tugas, variasi antartugas dan variasi antarpengulangan dalam satu tugas adalah dua jenis ketidakpastian yang berbeda. Penelitian evaluasi membedakan pengambilan sampel berulang, perbandingan di tingkat tugas, dan penanganan sampel yang berkelompok dan saling bergantung.6
Jadi, saya akan lebih dulu memakai satu probe untuk mengamati keterulangan, lalu menambahkan sekumpulan kecil tugas tetap yang terkait dengan penggunaan sebenarnya. Kedua pihak menjawab kumpulan yang sama. Hitung hasil pada setiap tugas, dan selisih pada setiap tugas, sebelum Anda menggabungkannya. Jangan hanya melemparkan satu skor total. Jika Anda menjalankan analisis formal pada beberapa tugas, pertahankan pasangan tugas yang sama dan batch yang sama. Anda tidak bisa memperlakukan “10 tugas, masing-masing 10 kali” sebagai “100 tugas independen” lalu memakai ulang perhitungan satu tugas tadi.
Ada jebakan yang lebih kecil. Seed tetap berguna ketika Anda sedang melacak masalah reproduksi. Menyalin output yang hampir tidak berubah dari seed yang sama dua puluh kali bukanlah dua puluh pengamatan independen atas sebaran output acak. Saat mengukur stabilitas, sepakati strategi pengambilan sampel sebelumnya. Antarmuka yang mendukung seed dapat memakai beberapa seed yang dibuat sebelumnya. Untuk antarmuka yang tidak mendukungnya, catat keterbatasan itu. Bagaimana sebuah kumpulan tugas sebaiknya diperbarui dalam jangka panjang adalah pertanyaan tersendiri. Setidaknya di dalam satu perbandingan ini, jangan mengganti tugas lalu menyambungkan skor lama dan baru menjadi kurva “modelnya makin baik”.
6. Timeout, output terpotong, dan gambar yang salah tidak boleh dicampur jadi satu
Distorsi statistik yang umum adalah hanya menilai karya yang berhasil dikembalikan, lalu menghapus timeout dan error. Skor yang Anda dapat menjawab “setelah output lengkap ada di tangan, seberapa sering hasilnya lolos?” Skor itu tidak menjawab pertanyaan yang lebih dipedulikan pengguna: “jika saya mengirim satu permintaan, apakah saya mendapat hasil yang lolos?” Misalkan 20 permintaan disiapkan sebelumnya, dan 4 di antaranya mengalami timeout. Sebanyak 16 sisanya mengembalikan karya lengkap, dan 8 di antaranya lolos. Tingkat lolos di antara output lengkap adalah 50%. Tingkat penyerahan pertama yang lolos, dihitung dari seluruh 20 permintaan, adalah 40%. Hanya memublikasikan angka pertama berarti menghilangkan empat kali pengguna tidak menerima apa pun.
Saya akan menyimpan tiga jenis hasil sekaligus: kegagalan teknis untuk menyerahkan hasil, pengembalian lengkap yang gagal memenuhi tugas, dan pengembalian lengkap yang lolos. Timeout, error antarmuka, stream terputus, dan tercapainya batas panjang masing-masing harus menyimpan alasannya sendiri. Mencatatnya secara terpisah tidak membebaskan layanan dari tanggung jawab atas kegagalan. Bagi orang yang memilih layanan, timeout dan gambar yang salah sama-sama menghabiskan waktu. Namun, ketika Anda menelusuri penyebab, semuanya tidak boleh digambarkan sebagai “kecerdasan model menurun”. Gangguan pada jaringan lokal atau skrip pengujian harus dicatat tersendiri. Apakah gangguan itu dikecualikan memerlukan aturan yang ditulis sebelumnya. Anda tidak boleh menghapus sampel setelah melihat pihak mana yang kalah.
Saya lebih memilih menjadikan proporsi permintaan pertama yang mengembalikan hasil lolos sebagai metrik utama, dan menempatkan tingkat lolos konten di antara output lengkap, tingkat kegagalan teknis, latensi, serta biaya di sampingnya sebagai penjelasan. Tingkat lolos konten pada output lengkap juga bukan skor “kemampuan murni” yang tidak bias. Jika permintaan yang kompleks lebih mungkin mengalami timeout, karya yang tersisa mungkin memang lebih mudah sejak awal. Tingkat itu dapat membantu menemukan letak masalah, tetapi tidak dapat menggantikan hasil yang dihitung dari setiap permintaan.
“Apakah bisa berhasil setelah satu kali perbaikan?” bisa menjadi pengujian terpisah, dengan kesempatan memperbaiki yang sama bagi kedua pihak. Jangan membimbing satu pihak melalui lima putaran koreksi, lalu memvonis pihak lain pada kesalahan pertama.
7. Perbandingan minimal yang benar-benar bisa dijalankan orang biasa
Anda tidak perlu membangun platform evaluasi sebelum menguji satu pelikan. Berikut rencana awalnya. Rencana ini untuk memeriksa perbedaan yang jelas pada satu probe tetap, bukan desain ukuran sampel yang menjamin Anda akan mendeteksi penurunan kecil.
| Butir | Kesepakatan untuk putaran ini |
|---|---|
| Pertanyaan | Pada tugas tetap ini, apakah layanan A dan B berbeda dalam proporsi penyerahan pertama yang lolos? |
| Input dan pengaturan | Simpan permintaan lengkap yang terlihat. Samakan parameter yang dapat Anda kendalikan. Catat perbedaan yang tidak dapat Anda pastikan. |
| Sampel | Siapkan 20 permintaan formal di setiap sisi sebelumnya. Jangan masukkan uji coba awal ke dalam sampel formal. |
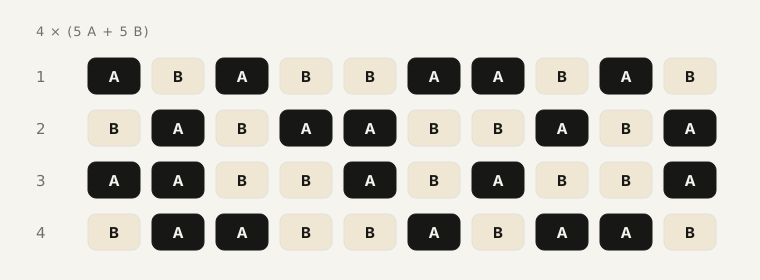
| Waktu dan urutan | Bagi jendela yang ditetapkan sebelumnya menjadi 4 batch, masing-masing berisi 5 panggilan untuk A dan 5 untuk B. Selang-selingkan secara acak di dalam batch, dengan aturan konkurensi yang sama. |
| Pengulangan | Uji jawaban pertama yang formal tidak menambahkan pengulangan. Buka eksperimen terpisah jika Anda ingin mengukur perbaikan. |
| Penilaian | Tetapkan aturan lolos sebelum percobaan pertama. Setelah di-render, sembunyikan nama kanal, acak urutannya, lalu beri nilai. |
| Output | Simpan setiap hasil mentah, status setiap panggilan, alasan setiap skor, serta statistik per batch dan keseluruhan. |
Aturan lolos yang sederhana adalah titik awal yang baik untuk tugas pelikan. Apakah file ter-render di lingkungan yang disepakati? Apakah subjek dan sepedanya cukup lengkap untuk dikenali? Apakah ada struktur kunci yang jelas salah? Apakah kontak yang diminta tugas, seperti kaki dan pedal, benar-benar terjadi? Anda bisa mencatat keindahan secara terpisah. Pilihan warna yang cermat tidak bisa menutupi kesalahan struktur.
Jika seseorang ragu tentang sampel di wilayah batas, tandai sampel itu sebagai disengketakan dan ikuti aturan peninjauan yang Anda tetapkan sebelumnya. Jangan memutuskan lolos atau tidaknya setelah Anda melihat nama kanalnya. Pengujian kecil bisa dinilai secara manual dan buta. Begitu skalanya membesar, penilaian otomatis dan kalibrasi juri menjadi pertanyaan berikutnya. Semuanya tidak harus diselesaikan pada putaran pertama. Pencatatan jauh lebih mudah jika Anda memisahkan konfigurasi milik putaran dari log yang berisi satu baris per panggilan. Konfigurasi putaran menyimpan templat permintaan mentah, parameter, versi tugas, versi aturan penilaian, jendela waktu, serta kesepakatan timeout dan pengulangan. Setiap panggilan setidaknya harus mencatat kolom-kolom berikut:
run_id,block_id,service,service_group,requested_model,returned_model,started_at,request_hash,status,finish_reason,latency_ms,qualified,failure_reason,artifact_pathTulis waktu beserta zona waktunya. Hubungkan respons mentah, SVG yang diekstrak, dan gambar hasil render melalui artifact_path. Jumlah token, sidik jari backend, dan apa pun yang diekspos antarmuka dapat disimpan di sampingnya. Jika tidak tersedia, catat sebagai kosong atau tidak diketahui. request_hash adalah pemeriksaan bahwa permintaannya tetap sama, bukan pengganti permintaan mentah. Saat Anda menyimpan atau membagikan log, hapus kunci API, dan samarkan konteks pribadi atau konten sensitif lainnya. Yang dibutuhkan pemeriksaan publik adalah kondisi eksperimennya, bukan kredensial akun yang ikut diserahkan.
Saat merangkum, lihat dulu selisih keseluruhan dan hasil setiap batch. Interval binomial dan uji eksak Fisher dari bagian sebelumnya berlaku ketika asumsinya, termasuk independensi dan stabilitas, kurang lebih terpenuhi. Jika hasilnya jelas dipengaruhi oleh batch, atau jika kemudian Anda memperluasnya ke pengujian berulang pada beberapa tugas, analisis data itu dengan metode yang sesuai dengan desainnya. Jangan memakai ulang rumus satu tugas secara mekanis. Jika perbedaan awal layak ditelusuri, uji ulang di jendela baru yang ditetapkan sebelumnya, dan tambahkan tugas yang berkaitan dengan penggunaan Anda yang sebenarnya. Putaran pertama adalah petunjuk adanya anomali. Putaran baru yang terpisahlah yang membantu Anda menilai apakah anomali itu masih ada.
8. Setelah menemukan perbedaan, bagaimana kesimpulannya ditulis?
Dengan angka contoh yang sama, kesimpulan yang menahan diri tetapi tetap berguna dapat berbunyi seperti ini:
Dengan tugas tetap putaran ini, pengaturan terlihat yang disamakan, dan jendela waktu yang ditetapkan sebelumnya, A dan B masing-masing diuji 20 kali. Penyerahan pertama yang lolos berjumlah 16 dan 8. Tingkat lolos sampel berbeda 40 poin persentase. Dengan asumsi yang mencakup pengambilan sampel independen, uji eksak Fisher dua sisi menghasilkan nilai p sekitar 0,0225, yang mendukung adanya perbedaan dalam kondisi putaran ini. Hasil ini masih perlu diperiksa di jendela lain dan pada tugas terkait. Hasil ini saja tidak dapat mengidentifikasi penyebab spesifik perubahan pada model dasar atau konfigurasi server.
Kesimpulan ini kurang seru dibanding “bukti masih bertenaga penuh”. Namun, kesimpulan ini menyerahkan kondisi yang dibutuhkan orang berikutnya untuk memeriksanya ulang. Jika pengujian berikutnya, lintas waktu dan lintas tugas terkait, terus menunjuk ke arah yang sama, kita punya alasan yang lebih kuat untuk mengatakan bahwa layanan ini kurang andal dibanding pembanding untuk penggunaan tersebut, atau bahwa layanan ini benar-benar tertinggal dari baseline historisnya sendiri. Melompat dari “hasil yang diserahkan memburuk” ke “mereka diam-diam menukarnya dengan model yang lebih kecil” tetap merupakan satu langkah tambahan. Memastikan mekanisme tertentu memerlukan bukti independen yang dapat membedakan penjelasan-penjelasan itu, seperti catatan rute atau konfigurasi yang dapat Anda verifikasi. Gaya output tidak cukup untuk menebak modelnya.
Itu juga tidak berarti pengguna harus menunggu sampai penyebabnya diketahui sebelum boleh berganti layanan. Memilih layanan bergantung pada apakah layanan itu memenuhi kebutuhan Anda. Menuduh penyebab tertentu bergantung pada bukti tentang penyebab itu. Keduanya bisa dipisahkan.
9. Yang benar-benar layak dihemat adalah biaya untuk membuktikan pertanyaannya dengan jelas
Bagian yang melelahkan dari pengujian manual biasanya bukan menekan tombol jalankan, melainkan pekerjaan berulang sesudahnya. Di mana filenya? Apakah parameternya berubah? Gambar ini hasil generasi ke berapa? Apakah ini hasil pengulangan? Apakah tangkapan layarnya masih bisa dicocokkan dengan respons mentahnya? Tanpa catatan itu, keyakinan bahwa “model ini benar-benar jadi lebih bodoh” bisa saja, seminggu kemudian, hanya tinggal beberapa tangkapan layar yang tidak bisa diperiksa ulang siapa pun.
Jika Anda hanya ingin melihat sekilas bagaimana berbagai layanan berperilaku, tidak semua orang harus menyusunnya dari nol. Anda bisa mulai dari Folkbench, melihat peringkat publik dan jalan masuk ke laporannya, lalu memeriksa apakah model, grup layanan, dan metrik yang Anda pedulikan sudah memiliki hasil. Halaman publiknya menekankan perbandingan layanan untuk model yang sama, dan peringkatnya juga menyebutkan bahwa angka pada grup di satu baris tidak mewakili semua grup di relay tersebut.7
Peringkat yang sudah dipublikasikan semestinya mengurangi biaya mengumpulkan dan menyusun data, bukan menjadi alasan untuk berhenti memeriksa kondisinya. Termasuk Folkbench, setiap peringkat layak ditanyai lebih jauh: kapan diukur, apa yang diukur, seberapa besar sampelnya, apakah kegagalannya disimpan, dan sejauh mana cakupan kesimpulannya? Informasi yang tidak dipublikasikan tetaplah tidak diketahui. Kembali ke pertanyaan pembuka. Seberapa banyak dari “model jadi lebih bodoh” yang nyata, dan seberapa banyak yang hanya ilusi dari satu kali undian?
Sebelum ada definisi bersama, sampel yang lengkap, dan kondisi yang sebanding, memublikasikan satu persentase keseluruhan hanya akan melahirkan mitos baru. Yang bisa kita lakukan dengan lebih baik adalah mengambil setiap kecurigaan konkret dan mengubahnya, langkah demi langkah, menjadi penilaian yang dapat diperiksa. Saat melihat kegagalan, simpan hasil mentahnya. Saat menduga ada penurunan, mulailah perbandingan. Saat menemukan perbedaan, barulah telusuri penyebabnya. Jangan mencoba menuntaskan semua langkah itu di dalam satu tangkapan layar. Tangkapan layar dapat mengajukan pertanyaan yang bagus. Untuk menjawabnya, tetap dibutuhkan eksperimen yang layak.
Catatan dan sumber
- OpenAI, How to make your completions outputs consistent with the new seed parameter, contoh Cookbook yang telah diarsipkan. Catatan itu menggambarkan seed tetap sebagai upaya terbaik menuju determinisme, bukan jaminan. Artikel ini hanya mengutip batas reprodusibilitas tersebut, dan tidak memperlakukan nama model lama atau dukungan parameter di halaman itu sebagai deskripsi produk saat ini. Sumber↩
- NIST/SEMATECH, e-Handbook of Statistical Methods, bagian 7.2.4.1, Confidence intervals, interval skor Wilson untuk proporsi. Artikel ini memakai interval Wilson 95% dua sisi untuk 16/20 dan 8/20. Penulis menghitungnya dari rumus dan membulatkannya ke satu angka desimal dalam persen. Tingkat kepercayaan menggambarkan cakupan jangka panjang dari metode interval tersebut. Metode Wilson adalah metode aproksimasi. Sumber↩
- Dokumentasi SciPy,
scipy.stats.fisher_exact. Artikel ini memakai tabel kontingensi[[16, 4], [8, 12]]denganalternative="two-sided"dan memperolehp = 0.0224774273717544. Itu adalah perhitungan atas data contoh, bukan hasil pengukuran dari makalah atau laporan platform. Contoh ini membandingkan hasil binomial yang independen. Data berpasangan, pengelompokan antartugas, ketergantungan waktu, atau perbandingan berganda memerlukan analisis yang sesuai dengan desainnya. Sumber↩ - Yuling Gu dkk., OLMES: A Standard for Language Model Evaluations, Findings of NAACL 2025. Makalah ini membahas detail evaluasi seperti format prompt, pemilihan contoh dalam konteks, dan susunan kata tugas, serta apa yang dibutuhkan perbandingan yang dapat direproduksi. Sumber↩
- Ramesh Johari, Leo Pekelis, dan David J. Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing, arXiv:1512.04922, revisi 2019. Makalah ini membahas masalah memantau hasil secara terus-menerus dan membiarkannya menentukan ukuran sampel, serta metode inferensi sekuensial yang mengatasinya. Sumber↩
- Evan Miller, Adding Error Bars to Evals: A Statistical Approach to Language Model Evaluations, 2024. Tentang ketidakpastian di tingkat tugas, pengambilan sampel berulang, perbandingan berpasangan, dan sampel berkelompok, lihat bagian 2, 3, dan 4. Tentang perencanaan ukuran sampel, lihat bagian 5. Sumber↩
- Halaman beranda dan peringkat publik Folkbench, dicek pada 5 Oktober 2026. Artikel ini menggunakan halaman publik tersebut hanya untuk menjelaskan jalan masuk, cakupan perbandingan, dan pemberitahuan di tingkat grup. Artikel ini tidak secara independen mendukung angka peringkat tertentu, dan tidak menyatakan bahwa Folkbench sudah menerapkan setiap prosedur eksperimen yang diusulkan di sini. Beranda; Peringkat↩