
Artikel pertama mengingatkan agar tidak memercayai satu tangkapan layar begitu saja. Artikel ini bertanya: mengapa sebuah skor pun tidak boleh dipercaya begitu saja?
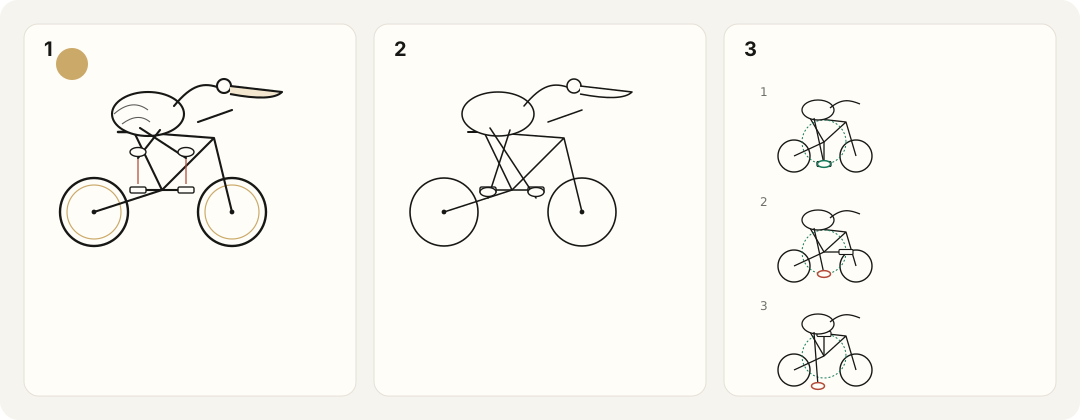
Bayangkan ada tiga pelikan yang sedang bersepeda. Pelikan pertama digambar dengan sangat teliti: bulunya berlapis, rodanya berkilau, bahkan ada matahari terbenam di latar belakang. Namun, kalau diperhatikan baik-baik, kedua kakinya menggantung di atas pedal. Pelikan kedua tampak seperti sketsa beberapa goresan saja. Tidak ada bayangan, tidak ada palet warna yang menarik. Meski begitu, rangkanya tersambung dengan wajar, tubuhnya duduk di sadel, dan kakinya benar-benar menginjak pedal. Pelikan ketiga terlihat baik-baik saja dalam gambar diam. Begitu animasinya diputar, satu kakinya mulai melayang mengikuti lintasannya sendiri: pedalnya berputar sendiri, pelikannya mengayuh sendiri. Mana yang seharusnya mendapat skor tertinggi?
Jika jawabannya “yang pertama paling indah”, berarti kita sedang menilai selera. Jika jawabannya “yang kedua paling andal”, berarti kita menilai apakah tugasnya terselesaikan. Jika kita hanya melihat tangkapan layar, kesalahan pelikan ketiga mungkin tidak akan pernah ketahuan.
Artikel sebelumnya berpendapat bahwa untuk menilai apakah sebuah model benar-benar memburuk, dibutuhkan pengujian berulang dalam kondisi yang sebanding, bukan satu output pilihan. Di balik argumen itu tersembunyi satu premis yang belum terjawab: kita sudah tahu apa yang dianggap lulus. Jika premis itu keliru, pengujian berulang tidak otomatis membuat kesimpulan lebih tepercaya. Bisa jadi, pengujian itu hanya membuat penggaris yang bias mengukur dengan makin konsisten. Artikel ini dimulai dari situ. Bagaimana kita mengubah “pelikan ini kelihatannya lumayan” menjadi metode evaluasi yang berdasar, dapat diperiksa ulang, dan dapat diotomatisasi selangkah demi selangkah?
Catatan: sampel, angka, skema penilaian, dan konfigurasi dalam artikel ini adalah contoh metodologis. Semuanya tidak mencerminkan peringkat model yang sebenarnya, dan tidak berarti Folkbench telah menerapkan prosedur ini. Penelitian yang dikutip dipakai untuk menjelaskan metode dan risiko terkait, bukan bukti bahwa usulan dalam artikel ini telah divalidasi secara eksperimental.
1. Tuliskan soalnya dulu, baru bahas cara menilainya
Uji Pelikan menarik karena kesalahannya tergambar jelas di permukaan. Kaki tambahan, rangka yang tidak tersambung, dan kaki yang meleset dari pedal sulit ditutupi dengan kalimat yang lancar. Meski begitu, apa yang sebenarnya diukur tetap perlu dijelaskan lebih spesifik. Meminta model “menggambar pelikan yang mengendarai sepeda dalam SVG” secara langsung mengamati apakah model dapat mengubah permintaan tertulis menjadi kode, dan apakah kode itu menghasilkan gambar yang sesuai dengan permintaan. Hasil itu saja tidak dapat memastikan representasi spasial apa yang dipakai model secara internal. Hasil itu juga tidak bisa membuat “berhasil di soal ini” langsung disamakan dengan “memiliki kemampuan pemahaman spasial yang utuh”.
Jika model boleh merender, melihat gambarnya, lalu merevisi berulang kali, yang diukur adalah alur kerja dengan umpan balik, bukan satu kali pembuatan kode. Keduanya layak diukur, tetapi tidak boleh dicampur dalam papan peringkat jawaban pertama yang sama. Poin yang lebih praktis adalah: persyaratan yang tidak tertulis dalam soal tidak boleh tiba-tiba muncul saat penilaian. Jika soal aslinya hanya “gambarlah pelikan yang mengendarai sepeda”, kita tidak boleh belakangan menuntut sepeda balap standar, dua roda yang ukurannya persis sama, kedua sayap memegang setang, atau setiap bagian terlihat jelas. Perspektif yang wajar, bagian yang tertutup objek lain, dan gaya kartun adalah bagian dari menggambar bebas. Saya akan membagi pengujiannya menjadi dua jenis.
Jenis pertama mempertahankan soal terbuka dan mengamati bagaimana model memahami serta mengekspresikan “mengendarai”. Penilaian hanya menangkap persyaratan yang jelas dan memang perlu, serta mengakui bahwa sampel di wilayah batas bisa diperdebatkan. Jenis kedua adalah soal berkendala. Soal ini menetapkan sudut pandang, hubungan yang harus terlihat, format output, dan teknik yang diizinkan sebelum siapa pun menjalankannya. Misalnya: sudut pandang terutama dari samping; pergeseran kecil diizinkan agar kedua kaki terlihat; titik kontak antara setiap kaki dan pedalnya harus terlihat; yang diserahkan adalah satu file SVG mandiri; tidak menggunakan gambar atau skrip eksternal.
Soal berkendala memang mengubah soal aslinya. Itu bukan kekurangan. Asalkan versi soal diberi label, soal ini memungkinkan kita mengajukan pertanyaan yang lebih spesifik: apakah model gagal memenuhi sudut pandang, gagal memperjelas kontak, atau salah menggambar struktur sepeda? Intinya bukan versi mana yang lebih “asli”. Nilailah soal terbuka sebagai soal terbuka, dan soal berkendala sebagai soal berkendala. Jangan memasangkan soal yang kabur dengan standar ketat yang dikarang belakangan.
2. Jangan buru-buru membuat skor total. Uraikan dulu “mengendarai”
“Secara keseluruhan bagus. Delapan poin.” Itulah cara menilai yang paling praktis, sekaligus yang paling sulit diperiksa ulang. Apakah angka 8 itu datang dari subjek yang benar, struktur yang wajar, atau palet warna yang enak dilihat? Lain kali kesalahan yang sama muncul, apakah juri akan memberi 9? Saya akan memulai dengan empat dimensi, tanpa menganggapnya sebagai empat angka yang diisi berdasarkan perasaan.
| Dimensi | Yang terutama diperiksa | Yang tidak boleh dicampurkan |
|---|---|---|
| Pelican: subjek | Apakah dapat dikenali sebagai pelikan; apakah tubuh atau anggota tubuhnya jelas tidak normal; apakah memenuhi visibilitas yang secara eksplisit diminta soal | Tingkat realisme, detail bulu, atau selera gaya pribadi yang tidak diminta soal |
| Bicycle: sepeda | Apakah roda, rangka, engkol, pedal, dan sebagainya membentuk struktur wajar yang diminta soal | Merek, model, dekorasi, atau cara penulisan SVG tertentu yang tidak diminta soal |
| Riding: hubungan berkendara | Apakah tubuh ditopang dengan wajar; apakah kaki berpasangan dengan pedal; apakah hubungan kendali yang diminta soal terpenuhi | Sekadar “burungnya ada di samping sepeda” atau “kedua objek ada” |
| Animation: hubungan sepanjang waktu | Apakah gerakan yang diminta terjadi; apakah kontak dan sambungan bertahan selama gerakan; apakah ada lompatan atau bagian yang saling tembus secara tidak wajar | Animasi yang sama sekali tidak diminta soal statis; efek yang tidak berkaitan dengan tugas |
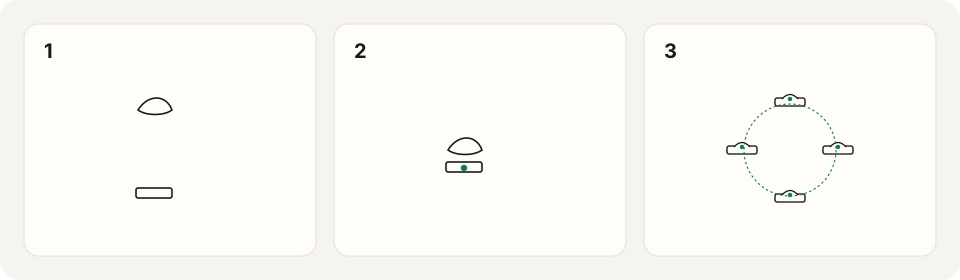
Keberadaan objek tidak sama dengan terpenuhinya hubungan. “Ada kaki” dan “ada pedal” adalah dua penilaian objek. “Kaki menginjak pedal” adalah penilaian hubungan. Selangkah lebih jauh, “kaki tetap menginjak pedal saat pedal berputar” adalah penilaian hubungan lintas waktu. Itulah sebabnya memeriksa hanya “apakah pelikan, sepeda, dan dua roda semuanya ada” masih jauh dari cukup. Yang perlu dipisahkan adalah kaitan antara tubuh dan sadel, kaki dan pedal, pedal dan engkol, serta rangka dan as roda.
Ada penelitian terkait yang bisa dijadikan acuan. TIFA mengubah persyaratan dalam teks menjadi beberapa pertanyaan, lalu memakai visual question answering untuk memeriksa apakah gambar yang dihasilkan memenuhinya. TIFA bukan alat penilai pelikan yang siap pakai, tetapi menunjukkan arah yang berguna: periksa gambar terhadap persyaratan butir demi butir, alih-alih hanya memberi kesan keseluruhan. 1 Untuk implementasinya, saya akan menyimpan empat status pada setiap pengecekan: pass, fail, uncertain, dan not_applicable. Artinya lulus, gagal, bukti tidak cukup, dan tidak berlaku.
Pembedaan yang penting ada pada dua status terakhir. Jika soal statis tidak meminta animasi, Animation berstatus “tidak berlaku”. Jika animasi diminta, tetapi materinya tidak cukup untuk menilai apakah ada bagian yang saling tembus, statusnya “bukti tidak cukup”. Yang pertama tidak boleh mengurangi nilai. Yang kedua tidak boleh otomatis dihitung lulus. Kemudian, bagi butir-butirnya menjadi syarat wajib dan butir kualitas tambahan. Syarat wajib menentukan lulus atau tidaknya hasil. Butir tambahan menggambarkan detail dan tampilan. Kegagalan yang jelas pada syarat wajib tidak bisa ditebus dengan bulu yang indah, latar belakang, atau gradien.
Laporan awal cukup menyebutkan berapa pengecekan subjek yang lulus, butir struktur sepeda mana yang gagal, apakah hubungan berkendara masih menyisakan pertanyaan yang belum terjawab, dan apakah animasi berlaku. Laporan itu tidak memerlukan skor total yang presisi hingga dua angka di belakang koma. Jika skor gabungan memang diperlukan, umumkan sejak awal butir yang berlaku, bobotnya, dan cara menangani nilai yang hilang, lalu tampilkan kegagalan syarat wajib secara terpisah. Peringkat yang dihasilkan dari bobot yang berbeda juga layak diuji ketangguhannya. Skor total adalah ringkasan yang dipadatkan, bukan alasan untuk menggantikan bukti aslinya.
3. SVG DOM bisa membantu, tetapi bukan diagram struktur yang datang bersama jawabannya
Naluri rekayasa saat melihat SVG mudah ditebak: ada kode sumbernya, jadi mengapa tidak langsung diurai saja? Aturannya pun cepat ditulis. Temukan dua elemen circle, berarti ada dua roda. Temukan elemen bernama foot, berarti ada kaki. Jika kotak pembatas (bounding box) kaki dan pedal beririsan, berarti kaki menginjak pedal. Masalahnya, setiap langkah itu keliru menganggap “cara mengekspresikan sesuatu dalam kode” sebagai “fakta semantik dalam gambar”.
Roda bisa berupa elemen lingkaran atau path. Dua roda bisa ditulis terpisah, atau dipakai ulang melalui use. Satu objek visual juga bisa tersusun dari beberapa grup dan path. Spesifikasi SVG mengizinkan berbagai cara ekspresi ini, dan tidak mengharuskan satu objek dunia nyata berpadanan dengan satu node DOM. 2 Jadi, tidak menemukan dua elemen circle tidak membuktikan ada roda yang hilang, dan menemukan dua elemen itu tidak membuktikan posisinya wajar. Elemen bernama foot hanyalah nama yang diberikan oleh pembuatnya, bukan verifikasi independen.
Aturan statis paling cocok untuk memeriksa batasan yang bisa dipastikan
Misalnya: apakah output dapat diurai dalam format yang disepakati, apakah berisi referensi eksternal yang dilarang soal, apakah berisi skrip yang tidak diizinkan, dan apakah merender konten yang tidak kosong di lingkungan yang ditentukan. Pengecekan seperti itu punya dasar yang jelas dan mudah dicatat dalam log. Pengecekan itu menjawab “apakah memenuhi batasan penyerahan dan teknis”, bukan “apakah burung ini mengendarai sepeda dengan benar”. Render yang berhasil juga tidak menggantikan pengecekan format. Spesifikasi SVG membedakan bentuk dokumen dan mode pemrosesan. Fragmen yang disisipkan di halaman web dan file SVG mandiri tidak boleh diterima dengan persyaratan penguraian yang sama, kecuali pilihan itu dinyatakan. 3
Pengecekan geometris harus lebih dulu memastikan apa yang diukur
Setelah wilayah geometris terlihat yang berpadanan dengan kaki dan pedal berhasil diidentifikasi secara andal, jarak, tumpang tindih, dan lintasan bisa dihitung. Misalnya, bagi jarak antara telapak kaki dan permukaan kontak pedal dengan diameter roda acuan yang disepakati dalam gambar yang sama. Hasilnya adalah jarak relatif. Membahas “seberapa jauh kaki lepas dari pedal” dalam bentuk itu lebih mudah ditafsirkan daripada langsung memakai ambang piksel yang tetap. Cara mendefinisikan permukaan kontak, dan seberapa besar toleransi kesalahannya, tetap harus dikalibrasi pada sampel berlabel. Tidak bisa begitu saja diumumkan bahwa “selisih lima piksel pasti salah”.
Pengukuran juga harus memperhitungkan transformasi koordinat, stroke, clipping, dan visibilitas yang sebenarnya. Elemen SVG bisa berada dalam sistem koordinat bertingkat. Spesifikasinya juga mencakup kasus ketika elemen yang sebenarnya tidak dirender tetap memiliki kotak pembatas. Memegang kotak pembatas tidak sama dengan memegang batas objek yang terlihat di gambar. 4 Dua kotak pembatas yang beririsan tidak berarti telapak kaki menyentuh pedal. Dua wilayah datar yang tumpang tindih mungkin hanya saling menutupi karena letak depan-belakang, bukan topangan yang wajar. Pada SVG umum, aturan geometris lebih baik dipakai sebagai bukti pendukung setelah divalidasi, bukan sebagai juri tanpa kalibrasi yang memegang hak veto.
Demi otomatisasi, boleh saja mewajibkan seperangkat ID bagian, titik kunci, dan struktur grup yang seragam. Namun, itu sebaiknya menjadi jalur “output terstruktur” tersendiri: periksa apakah deklarasi tersebut berpadanan dengan gambar yang sebenarnya. Jangan biarkan model menulis “kontak sudah benar” lalu program evaluasi langsung memercayainya. DOM memberi kita lebih banyak informasi yang bisa diperiksa, tetapi tidak menyelesaikan pengenalan semantik secara cuma-cuma.
4. Sebelum juri visual mulai bertugas, beri juri itu ujian
Jika aturan statis tidak cukup, biarkan model yang bisa melihat gambar memberi nilai. Jalan itu layak ditempuh. Namun, “model bisa mendeskripsikan gambar” tidak boleh dianggap sama dengan “model bisa menilai kesalahan spasial yang halus secara konsisten”. Penelitian tahun 2023 tentang MT-Bench dan Chatbot Arena membahas bias posisi, bias kepanjangan jawaban, dan preferensi terhadap diri sendiri pada juri LLM, sekaligus melaporkan bahwa model yang kuat cukup selaras dengan preferensi manusia pada evaluasi teks tertentu. Kesimpulan yang wajar bukan “semua juri model tidak bisa dipercaya”, melainkan “kredibilitasnya bergantung pada tugas dan harus diuji”. Hasil evaluasi teks itu juga tidak bisa langsung dipakai sebagai tingkat akurasi penilaian visual. 5
Kemampuan visual itu sendiri juga perlu diperiksa. Studi BlindTest tahun 2024 menemukan bahwa model vision-language yang diujinya masih keliru pada geometri sederhana, misalnya apakah lingkaran saling tumpang tindih atau garis saling berpotongan. Itu tidak berarti semua model saat ini masih berada di level tahun tersebut. Namun, temuan itu cukup untuk mengingatkan bahwa hubungan kontak yang halus tidak boleh diasumsikan benar hanya karena modelnya terkenal. 6 Saya akan lebih dulu membangun seperangkat sampel acuan manusia, alih-alih langsung menyerahkan papan peringkat kepada juri.
Kumpulan sampel itu perlu berisi keberhasilan yang jelas dan kegagalan yang jelas, juga kasus batas: sketsa, garis tipis, bagian tertutup yang wajar, path yang rumit, dan karya yang benar saat diam tetapi salah saat bergerak. Atur agar setidaknya dua anotator menilai secara independen dan buta (tanpa mengetahui sumbernya), lalu tinjau perbedaan pendapatnya. Manusia juga bukan kebenaran dasar yang alami. Jika dua orang yang membaca aturan yang sama terus sampai pada kesimpulan yang berlawanan, yang pertama kali perlu direvisi mungkin justru soal atau instruksi penilaiannya. Sampel yang tidak bisa diperjelas boleh tetap diperdebatkan. Tidak perlu mengarang “jawaban baku” untuknya.
Juri harus menjawab pertanyaan konkret, bukan memberi komentar soal selera
Berikan soal aslinya, aturan penilaian yang sudah dibekukan, dan gambar yang dirender secara seragam. Untuk butir animasi, berikan juga frame bertanda waktu atau video. Jangan sekaligus memberikan nama penyedia layanan, posisi di papan peringkat, atau pernyataan model pembuat sendiri bahwa “gambar ini sepenuhnya memenuhi persyaratan”. Tanyakan kepada juri butir demi butir: “Apakah setiap kaki menyentuh pedalnya masing-masing?” “Apakah rangka yang terlihat tersambung dengan wajar ke as roda depan dan belakang?” “Pada momen-momen ini, apakah kaitan antara kaki dan pedal tetap bertahan?”
Lampirkan satu bukti singkat yang dapat ditunjuk lokasinya pada setiap penilaian, misalnya “pada detik ke-2,0, kaki yang lebih dekat ke pengamat memiliki celah yang jelas dari pedal”. Jika buktinya tidak cukup, kembalikan uncertain. Jangan menutupi pandangan yang tidak jelas dengan paragraf yang lancar. Teks dalam gambar, komentar SVG, dan metadata hanya boleh diperlakukan sebagai konten yang diuji. Semuanya tidak boleh menjadi instruksi yang mengubah aturan penilaian. Menyembunyikan nama file atau label kanal tidak memberi izin untuk mengubah karya. Jika diperlukan potongan gambar atau gambar bantu beranotasi, simpan baik gambar aslinya maupun catatan pemrosesannya.
Kalibrasi tidak boleh bertumpu pada satu “tingkat kesesuaian keseluruhan”
Misalkan sebuah set acuan berisi 90 gambar yang lulus dan 10 gambar dengan kesalahan serius. Juri yang selalu menjawab “lulus” tetap mendapat akurasi keseluruhan 90%, padahal ia meloloskan semua kesalahan serius. Karena itu, saya akan memeriksa secara terpisah berapa banyak kesalahan kritis yang terlewat, berapa banyak karya yang benar justru ditolak, apakah kinerjanya konsisten di berbagai gaya gambar, dan apakah penilaian berulang terhadap karya yang sama stabil. Pada sampel batas, perhatikan juga apakah juri bersedia mengakui bahwa buktinya tidak cukup.
Beberapa sampel yang “hanya mengubah satu faktor” juga berguna: pertahankan gambar aslinya lalu geser satu kaki dari pedal, atau ubah latar belakangnya saja tanpa menyentuh strukturnya. Perubahan pertama seharusnya memengaruhi skor yang relevan. Perubahan kedua tidak boleh mengubah penilaian struktur tanpa alasan. Sampel buatan ini bagus untuk diagnosis, tetapi tidak bisa sepenuhnya menggantikan output model yang sebenarnya. Sampel yang dipakai untuk merevisi prompt penilaian dan sampel held-out yang dipakai untuk pemeriksaan akhir juri harus tetap terpisah. Jangan terus menyetel berdasarkan jawaban yang sama sampai hasilnya terlihat memuaskan, lalu menganggap skor itu sebagai bukti kemampuan generalisasi.
Pemungutan suara di antara beberapa juri dapat memunculkan perbedaan pendapat. Namun, memakai tiga model tidak membuat ketiga penilaian itu independen; ketiganya bisa saja membuat kesalahan yang sama. Klaim juri sendiri bahwa “saya 95% yakin” tidak boleh, tanpa kalibrasi, dianggap sebagai akurasi aktual 95%. Yang harus dibuktikan juri adalah bahwa ia bisa mengenali kesalahan, bukan hanya bahwa ia bisa menjelaskan skornya.
5. Animasi bukan sekadar beberapa tangkapan layar tambahan, melainkan pemeriksaan apakah sebuah hubungan putus seiring waktu
Skor statis bertanya “apakah kaki menginjak pedal sekarang?” Skor animasi bertanya “setelah mulai bergerak, apakah hubungan itu tetap bertahan?” Kaki yang kebetulan menyentuh pedal di frame pertama tidak berarti setelahnya bergerak mengikuti lintasan pedal. Sebaliknya, membuat kaki dan pedal sama-sama diam tidak berarti gerakan mengayuh yang diminta soal sudah terpenuhi. Karena itu, animasi setidaknya memuat dua pertanyaan yang berbeda: apakah yang seharusnya bergerak benar-benar bergerak, dan apakah sambungan yang seharusnya bertahan selama gerakan tetap bertahan.
Sepakati dulu skenario animasinya. Mengayuh di tempat, bergerak maju, dan kamera yang mengikuti adalah tugas yang berbeda. Jika soal tidak meminta simulasi mekanis yang presisi, batasan tambahan seperti rasio gigi tidak boleh ditambahkan diam-diam. Jika soal secara eksplisit meminta engkol berputar dan kaki tetap bersentuhan dengan pedal, persyaratan itu termasuk dalam penerimaan.
Lingkungan evaluasi juga harus mempertahankan keadaan animasi yang sebenarnya. Ini satu jebakan rekayasa yang konkret. Opsi tangkapan layar Playwright animations="disabled" menghentikan animasi terkait yang didukungnya: animasi berdurasi terbatas dimajukan sampai akhir, sedangkan animasi tak terbatas dibatalkan kembali ke keadaan awalnya. Opsi ini bukan sinonim untuk “menangkap momen sembarang secara tepat”. 7 Jadi, animasi tidak boleh ditandai lulus hanya karena seseorang mematikan animasi lalu menangkap satu gambar yang bagus. Gunakan dulu file uji dengan gerakan yang sudah diketahui untuk memeriksa pengaturan waktu dan metode tangkapan layar, baru kemudian gunakan pada output model. Mekanisme animasi yang didukung juga harus dituliskan.
Misalkan soal meminta loop 4 detik. Salah satu rencana awal adalah mengamati dua loop lengkap, mengambil sampel pada laju yang sudah ditentukan, lalu memeriksa tambahan batas loop serta setiap interval yang tampak salah. Jendela pengamatan, laju pengambilan sampel, dan aturan pemeriksaan tambahan harus ditetapkan sebelum evaluasi resmi, bukan diperketat setelah terlihat sisi mana yang bermasalah. Meski begitu, sekumpulan frame yang terbatas tetap bisa melewatkan kegagalan singkat di antara frame. Laporan harus menyatakan “tidak ditemukan kesalahan yang jelas dalam jendela dan kondisi pengambilan sampel yang disepakati”, bukan “terbukti secara matematis tidak ada bagian yang saling tembus kapan pun”.
Bagian yang wajar tertutup dalam gambar datar juga perlu dicermati. Saat kaki melintas di belakang rangka, garis luar yang tumpang tindih tidak otomatis berarti saling tembus. Yang harus diperiksa adalah apakah urutan depan-belakang atau sambungannya berubah secara tidak wajar. Perbesaran lokal membantu pengamatan, tetapi tidak boleh menghilangkan konteks ruang secara keseluruhan. Jika saat ini juri otomatis hanya dapat menangani gambar diam secara andal, publikasikan hasil statisnya dan serahkan animasi kepada tinjauan manusia. Lebih baik mengakui bahwa penggaris ini belum bisa menjangkau sejauh itu daripada memasukkan kemampuan yang belum terukur ke dalam skor total.
6. Sistem penilaian bisa salah, dan bisa menciptakan ilusi bahwa model tiba-tiba memburuk
Pengecekan statis, juri visual, dan tinjauan manusia tidak mengakhiri masalah. Sistem itu sendiri bisa berubah. Kemarin juri bersikap longgar terhadap celah kecil. Hari ini, versi baru memotong nilai dengan ketat. Karya yang dihasilkan sama sekali tidak berubah, tetapi tingkat kelulusan di papan peringkat turun. Jika yang disimpan hanya “nama model, tanggal, skor total”, perubahan pada juri mudah disalahartikan sebagai degradasi model. Selain model pembuat dan parameter permintaan, catat versi soal, versi rubrik, model dan konfigurasi juri, versi renderer, dan versi pemeriksa otomatis. Perubahan pada salah satunya bisa mengubah makna skor.
Sebelum mengganti juri atau aturan, saya akan meminta versi lama dan baru menilai karya tersimpan yang sama, lalu melihat di mana perbedaannya terkonsentrasi. Karya historis boleh dinilai ulang bila perlu, tetapi harus diberi label “penilaian baru atas artefak yang sama”, bukan disamarkan seolah-olah model baru saja menjawab ulang.
Masalah lain adalah evaluasi yang tidak selesai. Timeout layanan, SVG yang rusak, program tangkapan layar yang macet, atau permintaan juri yang gagal tidak boleh semuanya dilebur menjadi “model salah menggambar”. Jika karyanya sendiri melanggar aturan, karya itu bisa dinyatakan gagal berdasarkan aturan yang sudah ditetapkan. Jika infrastruktur evaluasi yang gagal, catat evaluasinya sebagai belum diputuskan dan lengkapi melalui prosedur yang tetap. Untuk satu karya, satu syarat wajib yang jelas gagal sudah cukup untuk menyatakan seluruh hasilnya tidak lulus. Sebaliknya, jika tidak ada yang jelas gagal tetapi masih ada syarat wajib yang belum jelas, karya itu tidak boleh langsung diloloskan.
Misalkan dari 100 permintaan terjadwal, 72 dipastikan lulus, 18 dipastikan tidak lulus, dan 10 belum diputuskan. Laporan bisa lebih dulu menyebutkan ketiga angka itu, alih-alih menghapus sampel yang belum diputuskan lalu mengumumkan “tingkat kelulusan 80%”. Jika label yang sudah diputuskan untuk sementara dianggap benar, proporsi kelulusan akhir batch ini bisa berada di antara 72% dan 82%: batas bawah menghitung setiap butir yang belum diputuskan sebagai gagal, dan batas atas menghitung semuanya sebagai lulus. Rentang itu berasal dari label yang belum diputuskan. Rentang itu bukan interval kepercayaan statistik, dan tidak mencakup kesalahan juri atau ketidakpastian dalam menggeneralisasi ke sampel lain.
Tinjauan manusia juga tidak boleh hanya melihat kegagalan dan perselisihan yang ditandai juri. Sampel acak yang ditentukan sebelumnya dari karya yang lulus secara otomatis juga harus diperiksa. Jika tidak, kelolosan yang paling berbahaya bisa tetap tersembunyi di wilayah “lulus”. Tidak ada evaluasi otomatis yang bisa membuktikan dirinya bebas kesalahan dengan mengatakan bahwa ia tidak pernah menemukan kesalahannya sendiri. Evaluasi seperti itu membutuhkan prosedur audit yang secara aktif dapat menemukan kekeliruannya sendiri.
7. Soal bisa basi, tetapi mengganti soal setiap hari tidak lantas lebih ilmiah
Begitu sebuah soal menjadi viral, contoh, tutorial, saran perbaikan, dan optimasi yang khusus menyasar soal itu pun bermunculan. Melihat model menggambar pelikan dengan baik saja tidak cukup untuk menuduhnya curang. Terpaparnya soal publik, mempelajari jenis tugas, dan masuknya sampel uji ke data pelatihan adalah masalah pada tingkat yang berbeda. Apakah model tertentu pernah melihat materi uji tertentu memerlukan bukti. “Soal ini terlalu terkenal” bukanlah bukti semacam itu.
Masuknya materi uji ke data pelatihan tetaplah risiko yang harus dihadapi evaluasi. Praktik LiveBench mencakup penggunaan sumber informasi yang lebih baru, pembaruan soal secara berkelanjutan, dan penilaian otomatis berdasarkan jawaban yang dapat diverifikasi. Itu adalah salah satu praktik untuk menekan risiko terkait, bukan jaminan bahwa “mengganti soal setiap bulan berarti sama sekali tidak ada kontaminasi”. 8 Untuk soal generatif terbuka seperti pelikan, saya lebih memilih mempertahankan tiga kegunaan soal. Soal inti yang stabil, untuk mengamati perubahan jangka panjang. Soal perluasan yang dirotasi, untuk mengamati transfer kemampuan. Soal held-out yang belum dipublikasikan, untuk pemeriksaan setelah prosedurnya dibekukan, bukan untuk menyetel aturan tanpa henti.
Nilai soal inti terletak pada keterbandingannya, bukan kekebalannya terhadap kontaminasi data pelatihan. Nilai soal perluasan terletak pada cakupan yang lebih luas, bukan prompt yang makin aneh.
Yang layak diubah adalah batasannya, bukan hanya nama tokoh utamanya
Mengganti pelikan dengan bebek memang sebuah perubahan, tetapi tidak otomatis mengubah struktur hubungannya. Varian yang lebih diagnostik sengaja mengubah satu kondisi. Ketika arah hadap dibalik, apakah sambungannya tetap benar? Ketika bagian yang tertutup bertambah, apakah bagian kunci tetap lengkap? Ketika soal berbunyi “berdiri di samping sepeda dan mendorongnya”, apakah model tetap memakai pose berkendara? Setelah hubungan kontak yang sama masuk ke animasi, apakah hubungan itu gagal?
Soal juga bisa beralih ke hubungan yang berbeda: tangan memegang gagang cangkir, benda yang ditopang nampan, atau beberapa bagian yang tersambung dalam urutan tertentu. Intinya bukan menumpuk setiap persyaratan langka ke dalam satu gambar, melainkan mengetahui apa yang diuji oleh setiap varian. Mengganti seratus hewan secara mekanis ke dalam satu templat tentu bisa menghasilkan seratus soal. Namun, hasil itu tidak bisa disebut seratus bukti kemampuan yang independen. Agregasi harus mempertahankan kategori tugas dan keluarga templat, agar satu templat tidak menguasai sebagian besar skor total hanya karena variannya banyak.
Soal baru yang dibuat secara otomatis juga memerlukan penerimaan. Soal bisa saja kabur, kontradiktif, atau mustahil diperiksa dari gambar akhirnya. Jika soal, jawaban, dan aturan juri semuanya diusulkan oleh model yang sama, lalu dikonfirmasi oleh model yang sama pula, pemeriksaan independen makin diperlukan.
Saat bank soal berubah, jangan gambarkan perubahan tingkat kesulitan sebagai kemajuan model
Delapan puluh poin bulan ini dan sembilan puluh poin bulan depan tidak selalu berarti modelnya makin kuat. Bisa jadi soal-soal barunya hanya lebih mudah. Saat bank soal lama diganti dengan yang baru, lebih baik pertahankan soal bersama, dan minta seperangkat sistem acuan menjalankan kedua bank soal dalam kondisi yang serupa. Laporkan perubahan di setiap kategori tugas secara terpisah. Soal bersama dan sistem acuan bukan kebenaran dasar yang selamanya benar. Keduanya membantu mengenali perubahan, tetapi tidak otomatis menghasilkan penyetaraan tingkat kesulitan yang ketat. Jika buktinya tidak cukup, praktik yang jujur adalah menampilkan hasil per versi, alih-alih menyambung skor mentah dari lembar soal yang berbeda menjadi satu kurva.
Soal bisa dipublikasikan setelah dipensiunkan, agar orang lain dapat memeriksa ulang, belajar, dan memperbaikinya. Setelah dipublikasikan, perannya mungkin bergeser dari “pemeriksaan yang belum pernah dilihat” menjadi “uji regresi yang dapat diulang”. Soal tidak terbatas pada satu kali pakai, tetapi juga tidak bisa selamanya berfungsi sebagai alat ukur yang sama. Inti bank soal dinamis bukan mengejar hal baru tanpa henti, melainkan mengelola kesimpulan apa yang dapat didukung sebuah soal di setiap tahapnya.
8. Yang benar-benar layak diotomatisasi adalah prosedur yang bisa diaudit kemudian
Sampai di sini, rencananya mudah sekali membengkak: beberapa juri, analisis lintasan, bank soal dinamis, arbitrase otomatis, dan tidak satu pun boleh ketinggalan. Versi minimum yang dapat dipakai tidak harus dimulai sebagai pabrik yang sepenuhnya otomatis. Pilih sekumpulan kecil soal, tuliskan syarat penerimaannya, kumpulkan output nyata, bangun acuan manusia, lalu periksa butir mana yang bisa diserahkan ke aturan dan mana yang bisa diserahkan ke juri visual. Pertahankan penanganan manual untuk bagian yang belum terotomatisasi secara andal.
Selama datanya masih sedikit, tujuannya adalah menemukan celah dalam aturan, bukan mengumumkan bahwa “akurasi penilaian sudah mencapai tingkat tertentu”. Pemeriksaan resmi atas kemampuan otomatisasi memerlukan set sampel held-out tersendiri, dan perlu melaporkan ketidakpastiannya. Salah satu prosedur yang masuk akal adalah:
Bekukan soal dan aturan penerimaan → hasilkan sesuai jadwal yang direncanakan → simpan output mentah lengkap
→ urai dan render secara terkendali → pengecekan statis / penilaian visual butir demi butir
→ tinjau perselisihan sesuai aturan, dan ambil sampel dari butir yang lulus otomatis
→ rangkum hasil penyerahan pertama, kinerja per butir, dan status yang belum diputuskan
Setiap langkah harus dapat ditelusuri ke langkah sebelumnya. Respons mentah, SVG yang diekstrak, hasil render yang sebenarnya, catatan pengamatan animasi, keluaran mentah juri, dan kesimpulan tinjauan dihubungkan oleh satu pengenal run. Saat file diekstrak atau dinormalisasi, simpan versi sebelum dan sesudahnya. Jika sepotong SVG harus diperbaiki agar bisa dirender, catat itu sebagai hasil prosedur perbaikan. Jangan diam-diam menimpa jawaban pertama. Saat aturan penilaian ditingkatkan, tambahkan catatan evaluasi baru alih-alih menghapus yang lama.
Ada satu premis rekayasa yang tidak boleh dilewati: perlakukan output model sebagai konten yang tidak tepercaya. Mode pemrosesan SVG bisa melibatkan skrip, event, dan sumber daya eksternal. “Ekstensinya menyatakan ini gambar” tidak berarti aman dijalankan di browser yang dipakai sehari-hari dengan akun yang sedang masuk. 3
Lingkungan render harus mengisolasi kredensial akun, jaringan, dan file host, membatasi penggunaan sumber daya, serta memakai konfigurasi sandbox yang cocok untuk konten tidak tepercaya. Memakai Playwright tidak membuat masalah selesai hanya karena browsernya “dimasukkan ke Docker”. Dokumentasinya secara eksplisit memperingatkan keterbatasan image kontainer default, serta hubungan antara menjalankan sebagai root dan sandbox Chromium. 9 Langkah keamanan yang konkret tetap harus diperiksa di lingkungan tempatnya berjalan. Apa yang diizinkan soal dan apa yang diizinkan lingkungan eksekusi harus disepakati sejak awal. Jangan izinkan model memakai skrip, lalu diam-diam menonaktifkan semua skrip saat penilaian.
Yang sebenarnya perlu dihemat bukanlah “pemeriksaan yang cermat” itu sendiri, melainkan kerja berulang untuk mencari file lagi, membandingkan parameter, dan mengisi stempel waktu pada setiap pemeriksaan.
9. Papan peringkat yang layak dibaca harus membiarkan orang terus bertanya
Saat melihat sebuah skor, saya ingin bisa terus menelusuri: skor itu milik layanan model yang mana, bank soal yang mana, dan jendela waktu yang mana; berapa banyak sampelnya, dan apakah kegagalan serta kasus yang belum diputuskan tetap disimpan; siapa yang menilai, bagaimana mereka dikalibrasi, dan apakah dasar penilaiannya bisa ditemukan. Informasi itu lebih banyak bercerita tentang apakah sebuah evaluasi sungguh-sungguh memperhatikan batasannya sendiri, dibandingkan skor total yang tampak sangat presisi.
Orang yang tidak berencana membangun prosedurnya sendiri dapat mulai dari peringkat publik, laporan, dan catatan evaluasi di Folkbench, lalu memeriksa apakah model dan layanan yang mereka pedulikan sudah memiliki hasil terbit yang berlaku. Beranda publiknya menggambarkan perbandingan tersebut sebagai perbandingan berbagai layanan untuk model yang sama. Cakupan, status fitur, dan dasar kesimpulan tetap harus mengikuti informasi yang dipublikasikan pada saat itu. 10
Hal yang sama berlaku untuk Folkbench maupun papan peringkat lain. Informasi yang tidak tersedia tetap dianggap tidak diketahui. Pengantar dari sebuah platform tidak menggantikan laporan yang sebenarnya. Usulan evaluasi dalam artikel ini tidak sama dengan kemampuan yang sudah dimiliki platform mana pun. Evaluasi yang baik tidak meminta pembaca untuk “memercayai skor saya ini”. Evaluasi yang baik membiarkan pembaca menelusuri skor sampai ke karya, kondisi, aturan, dan perbedaan pendapatnya. Kembali ke tiga pelikan tadi.
Kita tidak perlu berdebat apakah yang pertama paling bagus, dan kita tidak perlu meloloskan seluruh animasi pelikan ketiga hanya karena satu frame-nya bagus. Begitu apa yang diukur sudah disepakati dan buktinya tercatat dengan jelas, banyak hal yang selama ini dianggap misteri akan menjadi pertanyaan yang bisa dibahas butir demi butir. Artikel pertama mengatakan bahwa sebuah tangkapan layar bisa memunculkan pertanyaan yang bagus, tetapi menjawabnya membutuhkan eksperimen yang layak. Yang ingin ditambahkan artikel ini: eksperimen yang layak juga membutuhkan penggaris yang sudah diuji.
Lampiran A. Soal berkendala dan tabel penerimaan sebagai titik awal
Butir statis di bawah ini adalah contoh yang dirancang untuk artikel ini. Butir ini bukan standar industri, dan bukan soal resmi platform mana pun. Sebelum dipakai, butir ini harus diujicobakan dan dikalibrasi melalui anotasi. Setelah perbandingan resmi dimulai, jangan mengubah soal karena melihat hasilnya.
Contoh prompt
Keluarkan hanya isi satu file SVG statis mandiri yang dapat dibuka sendiri.
Gunakan viewBox "0 0 800 600". Jangan menambahkan code fence Markdown atau penjelasan.

Gambarlah seekor pelikan kartun yang mengendarai sepeda roda dua biasa.
Gunakan sudut pandang terutama dari samping. Pergeseran kecil pada bagian-bagiannya diizinkan agar hubungan berkendara tetap jelas.

Gambar harus memenuhi semua ketentuan berikut:
1. Pelikan dan sepeda sepenuhnya berada di dalam bingkai, tanpa kaki tambahan.
2. Roda depan dan belakang, rangka, sadel, setang, engkol, dan dua pedal dapat dikenali.
   Rangka tersambung dengan wajar ke kedua as roda, dan pedal berhubungan dengan wajar dengan engkol.
3. Tubuh duduk di sadel. Kedua kaki masing-masing menyentuh pedalnya sendiri,
   dan kedua titik kontak harus terlihat jelas. Setidaknya satu sayap menyentuh setang.
4. Gunakan hanya grafik vektor SVG dan gaya inline. Jangan gunakan bitmap tertanam, sumber daya eksternal,
   skrip, foreignObject, atau animasi.

Realisme, latar belakang yang rumit, tekstur bulu, dan efek dekoratif tidak diperlukan.
Contoh tabel penerimaan
| ID | Pengecekan | Jenis |
|---|---|---|
| F1 | Memenuhi format file mandiri, viewport, dan batasan sumber daya yang disepakati | Syarat wajib |
| P1 | Subjek dapat dikenali sebagai pelikan, gambarnya lengkap, dan tidak ada kaki tambahan yang jelas | Syarat wajib |
| B1 | Dua roda, rangka, sadel, setang, engkol, dan dua pedal dapat dikenali | Syarat wajib |
| B2 | Rangka tersambung dengan wajar ke kedua as roda, dan pedal berhubungan dengan wajar dengan engkol | Syarat wajib |
| R1 | Tubuh dan sadel membentuk topangan duduk yang jelas | Syarat wajib |
| R2 | Setiap kaki menyentuh pedalnya sendiri, dan titik kontaknya memenuhi persyaratan visibilitas | Syarat wajib |
| R3 | Setidaknya satu sayap menyentuh setang | Syarat wajib |
| A | Ini butir statis. Animasi tidak diuji | Tidak berlaku |
| Q1 | Warna, garis, dan detail | Butir tampilan opsional. Tidak membatalkan syarat wajib yang gagal |
“Dapat dikenali”, “wajar”, dan “jelas” tetap memerlukan pasangan contoh positif dan negatif serta catatan tentang batasnya. Tabel ini adalah kerangka aturan. Beberapa kalimat saja tidak dengan sendirinya menghilangkan penilaian subjektif. Hasil dinyatakan lulus hanya jika semua syarat wajib lulus. Kegagalan yang jelas pada satu syarat wajib membuatnya tidak lulus. Jika tidak ada yang jelas gagal, tetapi ada syarat wajib yang belum diputuskan, hasilnya masuk tinjauan. R3 diperiksa karena contoh prompt ini secara eksplisit memintanya. Butir itu tidak boleh diterapkan ke setiap soal pelikan tanpa dinyatakan.
Lampiran B. Contoh satu catatan output juri
JSON di bawah ini adalah catatan fiktif untuk satu butir. Catatan ini menunjukkan hubungan antarfield dan tidak berpadanan dengan gambar nyata. Catatan ini bukan laporan lengkap, dan bukan konfigurasi yang bisa langsung dijalankan oleh pustaka tertentu.
{
  "run_id": "example-run-001",
  "task_version": "pelican-static-example-v1",
  "rubric_version": "pelican-static-example-v1",
  "judge_profile_id": "example-judge-profile-v1",
  "render_profile_id": "example-render-profile-v1",
  "criterion_id": "R2",
  "status": "fail",
  "evidence": {
    "artifact_ref": "example-render.png",
    "time_s": null,
    "description": "Kaki yang lebih dekat ke pengamat memiliki celah yang terlihat jelas dari pedal pasangannya."
  },
  "review_required": false,
  "review_reason": null
}
judge_profile_id harus dapat menunjukkan model, prompt, parameter, dan catatan versi juri yang spesifik. render_profile_id harus dapat menunjukkan browser, viewport, dan pengaturan terkait lainnya. Bukti animasi harus mencatat waktu yang sebenarnya, bukan hanya menyebut “ada satu frame di tengah-tengah”. review_required ditetapkan oleh sistem evaluasi berdasarkan aturan yang sudah ditentukan, bukan diputuskan sendiri oleh juri. Bahkan ketika nilai field ini false, sampel tetap bisa masuk audit acak. Penilaian otomatis yang gagal, materi visual yang tidak cukup, dan tugas yang tidak lulus harus dicatat secara terpisah, bukan berbagi satu status “gagal” yang kabur.
Catatan dan sumber
- Yushi Hu dkk., TIFA: Accurate and Interpretable Text-to-Image Faithfulness Evaluation with Question Answering, ICCV 2023. Makalah ini mengubah persyaratan tekstual menjadi pengecekan tanya-jawab untuk menilai konsistensi antara gambar dan teks. Artikel ini meminjam gagasan dekomposisinya, tetapi tidak memindahkan skor eksperimen makalah aslinya ke tugas SVG pelikan atau animasi. Makalah↩
- W3C, Scalable Vector Graphics (SVG) 2, bab tentang struktur dokumen dan path. Lihat pengelompokan, penggunaan ulang melalui
use, dan ekspresi path. Penilaian bahwa node DOM tidak secara alami berpadanan dengan objek semantik dunia nyata adalah penilaian desain evaluasi yang dibuat di sini berdasarkan hal tersebut. Struktur dokumen; Path↩ - W3C, SVG 2 — Conformance Criteria, bagian tentang mode pemrosesan dan kesesuaian dokumen. Spesifikasi ini membedakan kemampuan seperti eksekusi skrip, sumber daya eksternal, dan animasi deklaratif, serta membedakan bentuk dokumen. Dukungan browser dan batasan eksekusi tetap harus diperiksa di lingkungan yang sebenarnya. Spesifikasi↩
- W3C, SVG 2 — Coordinate Systems, Transformations and Units, bagian tentang transformasi koordinat dan kotak pembatas. Saran di sini tentang jarak kontak, ambang, dan pengenalan semantik adalah contoh desain evaluasi, bukan algoritma “berkendara yang benar” yang didefinisikan oleh spesifikasi SVG. Spesifikasi↩
- Lianmin Zheng dkk., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, NeurIPS 2023 Datasets and Benchmarks Track, arXiv v4. Artikel ini memakainya hanya untuk apa yang dikatakannya tentang kemampuan dan bias juri pada evaluasi teks tertentu. Artikel ini tidak menyimpulkan bahwa setiap juri visual memiliki besaran bias atau akurasi yang sama. Makalah↩
- Pooyan Rahmanzadehgervi dkk., Vision language models are blind, 2024. Artikel ini merujuk pada studi asli tahun 2024 dan secara khusus mengutip arXiv v1, agar revisi model, judul, dan hasil yang muncul belakangan tidak tercampur. Studi tersebut tidak dapat dijadikan peringkat terkini model tahun 2026. Versi makalah↩
- Dokumentasi Playwright untuk opsi
animationspadapage.screenshot, diakses pada 5 Oktober 2026. Dokumentasi tersebut menjelaskan bagaimana opsi itu memperlakukan CSS animations, CSS transitions, dan Web Animations. Opsi itu tidak boleh diperluas, tanpa pemeriksaan, menjadi satu kendali waktu untuk setiap mekanisme animasi SVG. Dokumentasi↩ - Colin White dkk., LiveBench: A Challenging, Contamination-Limited LLM Benchmark, ICLR 2025, arXiv v2. Judul versi sebelumnya memakai “Contamination-Free”. Artikel ini mengikuti rumusan revisi 2025 tentang pembaruan berkelanjutan, penilaian yang dapat diverifikasi, dan pengurangan risiko kontaminasi. Artikel ini tidak menjanjikan bahwa kontaminasi sama sekali tidak ada. Makalah↩
- Dokumentasi Docker Playwright, diakses pada 5 Oktober 2026. Dokumentasi tersebut memperingatkan bahwa image default tidak disarankan untuk mengunjungi situs web yang tidak tepercaya, dan menjelaskan bahwa menjalankan sebagai root secara default akan menonaktifkan sandbox Chromium. Artikel ini tidak menyediakan penerapan aman yang lengkap. Kebijakan isolasi, jaringan, dan izin tetap harus diterapkan dan diuji untuk lingkungan tempatnya berjalan. Dokumentasi↩
- Beranda publik Folkbench, diakses pada 5 Oktober 2026. Beranda tersebut menyediakan pintu masuk ke peringkat, laporan, dan catatan terkait, serta menggambarkan perbandingannya sebagai perbandingan berbagai layanan untuk model yang sama. Pintu masuk pengecekannya juga ditandai sebagai alur persiapan beta dan sebagai probe sungguhan yang belum diaktifkan; pintu masuk saat ini berfungsi untuk menampilkan alur persiapan. Artikel ini hanya merujuk pada informasi publik. Artikel ini tidak menganggap pintu masuk tampilan sebagai pengukuran yang sudah selesai, tidak secara independen mendukung peringkat tertentu, dan tidak mengklaim bahwa Folkbench telah menerapkan skor empat dimensi, kalibrasi juri, atau bank soal dinamis yang diusulkan di sini. Beranda↩


