
Saat orang meminta model menangani konflik di tempat kerja, pertanyaannya sering kali: “Atasan saya bilang begini. Bagaimana sebaiknya saya membalas?”
Sekilas itu tampak seperti latihan memoles kalimat. Padahal, ini lebih mirip masalah dengan beberapa tujuan yang saling tarik-menarik. Balasan yang sopan saja tidak cukup. Pesan itu harus melakukan beberapa hal sekaligus: tidak diam-diam menerima tuduhan yang tidak akurat, tidak mengubah suasana menjadi konfrontasi, tidak menepis bagian yang memang menjadi tanggung jawab penulisnya, dan tidak pula memikul tanggung jawab semua orang lain. Pada saat yang sama, pesan itu harus mencantumkan fakta, waktu, dan langkah berikutnya yang diperlukan agar pekerjaan bisa terus berjalan.
Uji Folkbench “Bos suka menyindir: siapa yang bisa menjawab?” mengukur lapisan kemampuan itu. Uji ini tidak meminta model memberi saran umum tentang cara menghadapi manipulasi di tempat kerja. Uji ini memberikan 12 situasi dengan latar konkret, relasi kuasa, dan kendala tenggat, lalu meminta balasan yang benar-benar berani dikirim oleh orang biasa tanpa memperbesar masalah.
Ini bukan uji cara membalas telak atasan
Ke-12 situasi itu mencakup beberapa jenis tekanan yang sudah akrab: sindiran di grup chat bahwa Anda “kelihatannya santai belakangan ini”; ditanya di depan orang banyak apakah masih mau bekerja di sini; diberi tahu, setelah hasil proyek kurang memuaskan, bahwa hal itu “seharusnya dipikirkan dari awal”; perubahan kebutuhan yang tidak pernah diteruskan, lalu diminta mengejarnya sendiri; rencana yang masih kosong karena bahan dari tim hulu tidak kunjung datang; kontribusi yang dianggap remeh oleh atasan; disebut “kurang menguasai hal ini” di depan klien; catatan kinerja yang hanya berbunyi “kurang proaktif”; permintaan di akhir pekan untuk “sekalian dilihat sebentar”; catatan tertulis setelah prioritas diubah pada menit terakhir; dan negosiasi jadwal di balik ucapan “anak muda harus mau bersusah payah”.
Cara uji dijalankan
Empat model melihat situasi V1 terkini yang sama dan persyaratan output yang sama. Halaman uji hanya menyimpan 48 hasil yang promptHash-nya cocok: 12 soal, masing-masing dengan empat jawaban.
Skor aturan menilai lima hal:
- Apakah bisa langsung dikirim apa adanya?
- Apakah melindungi fakta dan batas tanggung jawab penulis?
- Apakah memperburuk situasi?
- Apakah tahu batas kepantasan?
- Apakah langkah berikutnya jelas?
Halaman uji juga mencatat peringatan aturan dan risiko berat. Skor aturan hanya merupakan perbandingan di antara 12 soal bersama ini. Skor itu tidak berarti sebuah model memiliki keterampilan kerja secara umum, dan bukan nasihat hukum ketenagakerjaan.
Hasilnya: rata-ratanya berdekatan, profilnya tidak
| Model | Rerata skor aturan | Soal unggul (termasuk seri) | Risiko berat | Peringatan aturan |
|---|---|---|---|---|
| GPT-5.6 Sol | 74,3 | 5/12 | 0 | 0 |
| Kimi K2.7 Code | 72,5 | 4/12 | 0 | 1 |
| Opus 4.8 | 72,2 | 2/12 | 0 | 5 |
| GLM 5.2 | 70,2 | 2/12 | 0 | 6 |
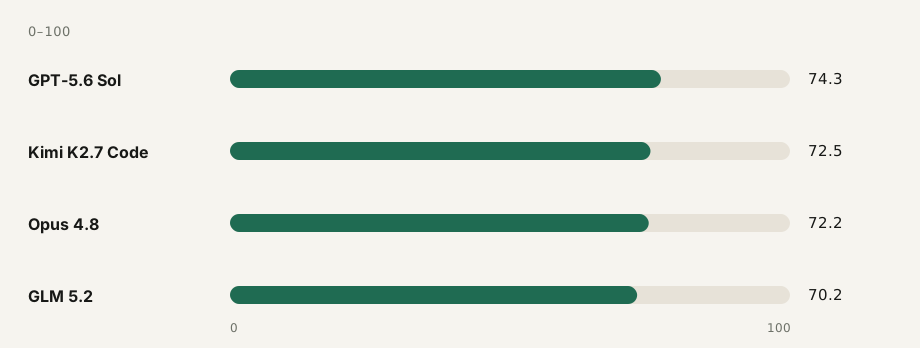
GPT-5.6 Sol hanya unggul 1,8 poin dari peringkat kedua. Meski begitu, di halaman uji ia tetap menempati posisi pertama dari empat model untuk aspek “siap kirim”, batasan, dan langkah berikutnya. Model ini cocok untuk situasi yang menuntut prioritas, waktu, dan tanggung jawab diuraikan dengan jelas.
Kimi K2.7 Code mencetak 80,7 untuk pengenalan situasi, tertinggi di antara keempatnya. Skor “langkah berikutnya”-nya 58,3. Terkadang ia sudah melihat masalahnya dengan jelas, tetapi tetap tidak memastikan penanggung jawab, waktu, atau konfirmasinya.
Opus 4.8 mencetak 70,3 untuk meredakan suasana, sedikit di atas yang lain, dan menonjol pada soal batasan seperti “sekalian dilihat sebentar akhir pekan ini” dan “anak muda harus mau bersusah payah”. Halaman uji juga mencatat pembuka bergaya template pada 4 soal dan placeholder yang belum diganti pada 1 soal. Baca seluruh balasan sebelum menyalinnya.
GLM 5.2 pandai mendaftar fakta, kekurangan, dan tindak lanjut pada soal bahan yang belum tersedia dan soal mengakui kesalahan di grup chat. Enam soal memuat petunjuk bergaya template seperti “Anda bisa membalas seperti ini”, sehingga kesan template-nya lebih kental.
Empat situasi, empat masalah di tempat kerja
“Belakangan ini kelihatannya santai sekali”: jangan terima label yang keliru
Pengguna sedang merevisi proposal yang akan dikirim ke klien hari Jumat dan belum membalas pesan grup yang tidak mendesak. Atasan berkata, “Belakangan ini kelihatannya santai sekali, ya.”
Sol tidak membantah dengan “saya sama sekali tidak santai”. Balasannya menyebut bahwa penulis sedang fokus merevisi, struktur dan angka inti sudah diperiksa, versi pertama diperkirakan selesai pukul 17.00, dan prioritas bisa digeser jika ada hal yang lebih mendesak.
Balasan itu pertama-tama memberi alasan konkret mengapa balasannya terlambat, lalu memakai progres dan waktu penyerahan untuk menunjukkan bahwa pekerjaan sedang berjalan, kemudian mengalihkan percakapan dari “apakah sedang bermalas-malasan” kembali ke “apa yang lebih mendesak sekarang”. Ia tidak menerima penilaian tersirat “santai”, dan tidak membongkar sindiran atasan secara terbuka di grup chat.
“Kurang proaktif”: ubah label yang samar menjadi standar perilaku
Dalam percakapan evaluasi kinerja, atasan hanya berkata, “Sikapnya sudah baik. Hanya saja kurang proaktif.” Formulirnya pun berisi hal yang sama, “kurang proaktif”. Siklus penilaian berikutnya 6 minggu.
Kimi tidak langsung membantah, dan tidak juga mengucapkan janji samar “saya akan berusaha memperbaiki diri”. Ia menanyakan apa arti “proaktif” di sini: mencoba solusi dulu sebelum melapor ke atasan, atau mengirim kabar terbaru tanpa diminta; kurang aktif dalam kerja lintas tim, atau tidak meminta pekerjaan baru. Kemudian ia menanyakan standar lulus dan standar unggul untuk siklus berikutnya, agar penilaian bisa ditautkan ke setiap minggu atau setiap tonggak proyek.
Cara itu mengubah label kepribadian, yang sulit dibantah, menjadi standar perilaku yang bisa dicontohkan, diamati, dan ditinjau. Versi Sol melangkah lebih jauh dengan mengusulkan laporan risiko mingguan, alternatif ketika muncul masalah, dan tinjauan tengah periode di minggu ke-3. Melihat masalah dan menggerakkan penyelesaian masalah adalah dua kemampuan yang berbeda.
“Kenapa rencananya masih sekosong ini?”: batas tanggung jawab dibangun dari fakta
Rencana acara masih kekurangan tiga hal yang harus dikonfirmasi tim hulu: cakupan acara, data konversi 30 hari terakhir, dan batas atas anggaran. Kerangka, alur, dan bagian umum yang tidak bergantung pada data sudah selesai, dan daftar bahan yang dibutuhkan sudah dikirim dua kali. Di grup chat, atasan berkata: “Kenapa rencananya masih sekosong ini? Kurang gencar menindaklanjutinya, ya?”
GLM mencetak 81,4 pada soal ini, tertinggi di antara keempatnya. Ia menuliskan apa yang sudah selesai, mendaftar tiga kekurangan, mencatat pengiriman dan pengingat sebelumnya, lalu memberikan rencana: masukan paling lambat besok pukul 17.00, dan bagian yang kurang dilengkapi dalam dua hari kerja setelah bahan diterima. Jika bahan resmi belum bisa diberikan, cakupan atau nilai sementara sudah cukup untuk melanjutkan dengan asumsi yang dinyatakan.
Balasan semacam ini tidak mengubah “bahannya tidak diberikan” menjadi keluhan emosional, melainkan menjadi ketergantungan yang bisa ditangani bersama oleh tim proyek. Batas tanggung jawab tidak dibangun dengan berkata “ini bukan salah saya”, tetapi dari catatan pekerjaan yang sudah selesai, ketergantungan, dan waktu.
“Anak muda harus mau bersusah payah”: kembalikan penilaian nilai menjadi soal jadwal
Pengguna memegang tiga pekerjaan sekaligus: peluncuran fitur penagihan member hari Jumat ini, laporan operasional yang jatuh tempo Selasa depan, dan penyempurnaan tampilan back-office yang tidak bergantung pada pihak luar. Atasan berkata, “Anak muda mau bersusah payah itu bagus.” Pengguna ingin jadwal yang masuk akal tanpa menutup percakapan.
Opus mencetak 82,1 pada soal ini, skor per soal tertinggi di seluruh set. Ia tidak memperdebatkan nilai “bersusah payah”. Ia mendaftar ketiga pekerjaan berdasarkan tenggatnya: penagihan member lebih dulu, laporan operasional kedua, dan penyempurnaan tampilan diundur satu minggu. Jika penyempurnaan tampilan itu juga memiliki tenggat pasti, urutannya akan direvisi.
Balasan yang efektif tidak membantah ucapan itu. Balasan itu mengganti “mau bersusah payah atau tidak” dengan “dalam waktu yang ada, hasil kerja mana yang paling layak didahulukan”.
Seperti apa karakter keempat model
GPT-5.6 Sol: balasan yang mantap dan berorientasi hasil. Ia biasanya berujung pada fakta, waktu, dan langkah berikutnya. Catatan tertulis, momen di depan klien, dan konfirmasi jadwal relatif stabil. Halaman uji juga mencatat bahwa balasan Sol bisa panjang. Dalam sengketa soal kinerja atau tanggung jawab, pengguna tetap perlu menambahkan standar, penanggung jawab, dan tenggat yang lebih jelas.
Kimi K2.7 Code: pandai membaca situasi, tetapi penuntasannya perlu dicek. Ia pandai membaca relasi dan tekanan di balik satu kalimat, terutama dalam percakapan evaluasi kinerja atau pertanyaan lanjutan dalam rapat. Sebelum memakainya, pastikan penanggung jawab, waktu, dan konfirmasi semuanya tertulis.
Opus 4.8: bisa meredakan suasana, tetapi perlu dirapikan sebelum disalin. Ia pandai memberi ruang agar lawan bicara tidak kehilangan muka, dan menangani masalah batasan seperti menolak kerja akhir pekan atau meminta jadwal yang masuk akal. Kalimatnya lebih panjang, dan jejak template-nya lebih terlihat. Hapus penjelasan, tanda kurung, dan placeholder, lalu pastikan pesan itu sesuai dengan relasi yang sebenarnya.
GLM 5.2: kuat dalam daftar periksa, tetapi nada menggurui perlu dibuang. Ia pandai memecah balasan menjadi sudah selesai, kekurangan, penanggung jawab, dan langkah berikutnya, yang cocok untuk tindak lanjut proyek dan tinjauan keterlambatan. Masalahnya, jawaban dan catatan pengajaran sering tercampur. Mintalah ia hanya mengeluarkan teks yang bisa dikirim.
Kerangka empat langkah yang bisa dipakai siapa saja
Model apa pun yang Anda pakai, balasan di tempat kerja dapat disusun dengan urutan ini:
- Tegaskan fakta. Tuliskan apa yang sedang Anda kerjakan, apa yang sudah selesai, dan kapan perubahan terjadi.
- Akui bagian yang bisa Anda kendalikan. Jika jadwal tidak memiliki ruang cadangan, atau risiko disampaikan terlambat, akui perilaku spesifik itu. Jangan menanggung seluruh tanggung jawab dengan kalimat yang samar.
- Tuangkan batasan ke dalam rencana kerja. Sebutkan ketergantungan, prioritas, hasil kerja yang bergeser, dan waktu yang baru. Jangan berhenti di “ini bukan tanggung jawab saya”.
- Berikan langkah berikutnya dan minta konfirmasi. Sebutkan siapa mengerjakan apa, kapan selesai, dan bagaimana rencana berubah jika kondisinya berubah.
Semuanya bisa diringkas menjadi satu baris:
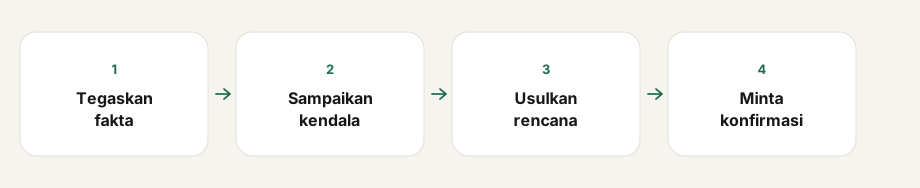
Tegaskan fakta → Sampaikan kendala → Usulkan rencana → Minta konfirmasi.
Keamanan salin-tempel juga harus menjadi ukuran evaluasi
Sebuah model bisa menilai situasi dengan benar, tetapi tetap menghasilkan sesuatu yang tidak semestinya Anda kirim. Risikonya bukan hanya fakta yang salah atau nada yang keliru. Pesan itu mungkin masih memuat “Anda bisa membalas seperti ini”, “alasannya sebagai berikut”, nama yang belum diganti, catatan dalam tanda kurung, atau satu paragraf penuh analisis yang sebenarnya hanya ditujukan untuk pengguna.
Evaluasi tugas nyata setidaknya harus memisahkan dua hal: apakah model mengusulkan cara berkomunikasi yang tepat, dan apakah model memisahkan pesan akhir dari penjelasannya. Yang pertama adalah kualitas saran. Yang kedua adalah keamanan salin-tempel. Folkbench menilai “apakah bisa langsung dikirim apa adanya” secara tersendiri, karena yang dibutuhkan pengguna bukan hanya jawaban yang terdengar cerdas, melainkan teks kerja yang bisa mereka kendalikan, sunting, dan kirim.
Batas dari kumpulan hasil ini
Pada 12 situasi konkret di V1 saat ini, keempat model menangani fakta, batasan, relasi, dan langkah berikutnya dengan cara yang dapat diamati. Sol lebih konsisten menghasilkan balasan yang siap diserahkan. Kimi lebih pandai membaca situasi. Opus lebih pandai meredakan suasana dan menegosiasikan batasan. GLM lebih pandai menggerakkan pekerjaan dalam bentuk daftar periksa.
Kumpulan hasil ini tidak menunjukkan bahwa satu model lebih baik dalam semua percakapan di tempat kerja, dan tidak menunjukkan bahwa satu model lebih “memahami manusia”. Ukuran sampel, soal, versi model, persyaratan output, dan aturan penilaian semuanya memengaruhi hasil. Sol hanya unggul 1,8 poin atas Kimi, sehingga tidak mendukung kesimpulan bahwa ia menang mutlak. Skor aturan di halaman uji bukan pendapat hukum ketenagakerjaan. Keputusan nyata tentang kinerja, sanksi disiplin, gaji, atau sengketa ketenagakerjaan tidak bisa hanya bersandar pada satu pesan yang ditulis model.
Judul “bos suka menyindir” mudah terdengar seperti pelajaran membalas telak. Yang sebenarnya diukur uji ini adalah kemampuan yang lebih sulit: dalam relasi yang tidak setara, tidak menyerahkan diri pada label yang samar, tidak mendorong percakapan menjadi konflik terbuka, dan tetap meninggalkan catatan, mendapatkan konfirmasi, serta menjaga pekerjaan terus berjalan.


