
Um modelo pode escrever um tutorial de jianbing paciente e completo e, mesmo assim, deixar um iniciante sem conseguir prepará-lo.
Uma cozinha de verdade, em casa, tem muitas variáveis. As frigideiras mudam de tamanho e de material. A massa pode ficar grossa ou rala demais. O fogo muda entre espalhar o crepe, pôr o ovo e virar. O biscoito fino e crocante, o baocui, nem sempre está à venda. Numa manhã, pode haver só 20 minutos. Depois da primeira falha, o usuário não precisa de outra receita bonita. Precisa de alguém que consiga avaliar por que o crepe acabou de rasgar e dizer se ainda dá para salvar o que está na frigideira.
Por isso, esta avaliação de preparo de jianbing não testa se o modelo consegue recitar uma receita. Testa se ele consegue transformar conhecimento num plano que uma cozinha de casa consiga executar, ajustar e levar adiante quando algo dá errado.
Primeiro o resultado: além da média, as diferenças estão nas falhas e nos riscos
Esta rodada montou 12 cenas de cozinha doméstica. Quatro modelos deixaram 48 resultados com promptHash correspondente. A nota por regras da página olha cada resposta por cinco ângulos: se os passos dão para seguir, se mostram bom senso de cozinha, se lidam com uma falha, se o texto é claro e se o modelo se coloca no papel de um “mestre-cuca” confiante demais.
As notas gerais publicadas na página são:
| Modelo | Nota geral | Questões lideradas, de 12 (com empates) | Avisos de regra ou riscos graves marcados na página |
|---|---|---|---|
| Sonnet 5 | 80,4 | 6 | Nenhum |
| GLM 5.2 | 79,3 | 5 | 1 aviso de regra |
| Kimi K2.7 Code | 77,6 | 3 | 1 aviso de regra, 1 risco grave |
| GPT-5.6 Terra | 75,6 | 0 | Nenhum |
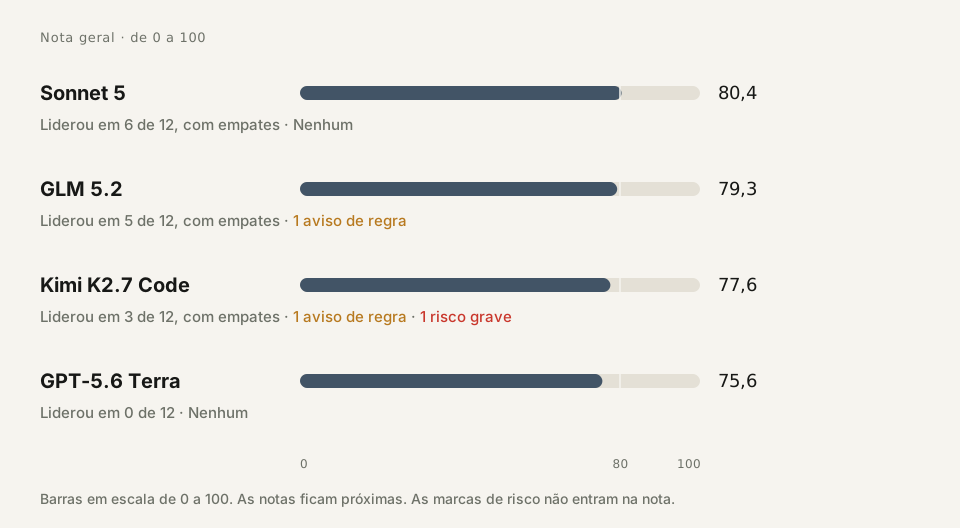
O Sonnet 5 lidera com 80,4. No conjunto, é o que mais se parece com um tutorial que você poderia entregar a um iniciante: a primeira tentativa, o controle do fogo na frigideira e o café da manhã de 20 minutos saem relativamente firmes. O GLM 5.2 fica só 1,1 ponto atrás, mas sua nota de procedimento chega a 90, a mais alta da rodada. A nota geral do Kimi K2.7 Code é menor, e mesmo assim ele se sai melhor nas cenas que pedem um conserto na hora, como “o crepe rasgou, como salvo?”. O GPT-5.6 Terra tira 84,2 no primeiro tutorial completo, mas mostra pontos fracos claros na proporção da massa, no fogo da chapa elétrica e no diagnóstico de falhas.
Na superfície, isto é o boletim de quatro modelos. O que merece mais atenção é um fato fácil de deixar passar: passos executáveis não dependem de uma única habilidade. Um modelo pode ser bom em escrever os passos com clareza e fraco em diagnosticar uma falha. Pode ser bom no resgate e ainda deixar um problema de limite de segurança que não deveria ser ignorado.
1. Uma cozinha de casa não é vitrine de receitas
Pergunte só “como faço jianbing?” e o modelo logo entrega o que parece uma resposta-padrão completa: separar a farinha, misturar a massa, preaquecer a frigideira, espalhar o crepe, quebrar o ovo, salpicar cebolinha, pincelar o molho, pôr o biscoito crocante e enrolar.
Essa resposta pode não ter nenhum erro óbvio no nível das palavras. Ela só não responde às perguntas que um iniciante realmente encontra:
- Em casa só há uma frigideira antiaderente de 26 cm e nenhum rodinho de crepe. Uma concha e uma espátula dão conta?
- Quão rala a massa deve ficar, afinal? Por que a mesma proporção de água e farinha sai grossa para uma pessoa e rasga na primeira virada para outra?
- Se não houver biscoito crocante, o que massa de wonton, youtiao, batata chips e um pão folha comum fazem, cada um, com o resultado?
- Como avaliar o fogo de uma frigideira e o de uma chapa elétrica? Depois que o ovo entra, quando dá para enrolar?
- O crepe já rasgou e o ovo não firmou por completo. Você continua espalhando, remenda com mais uma conchada de massa ou começa de novo?
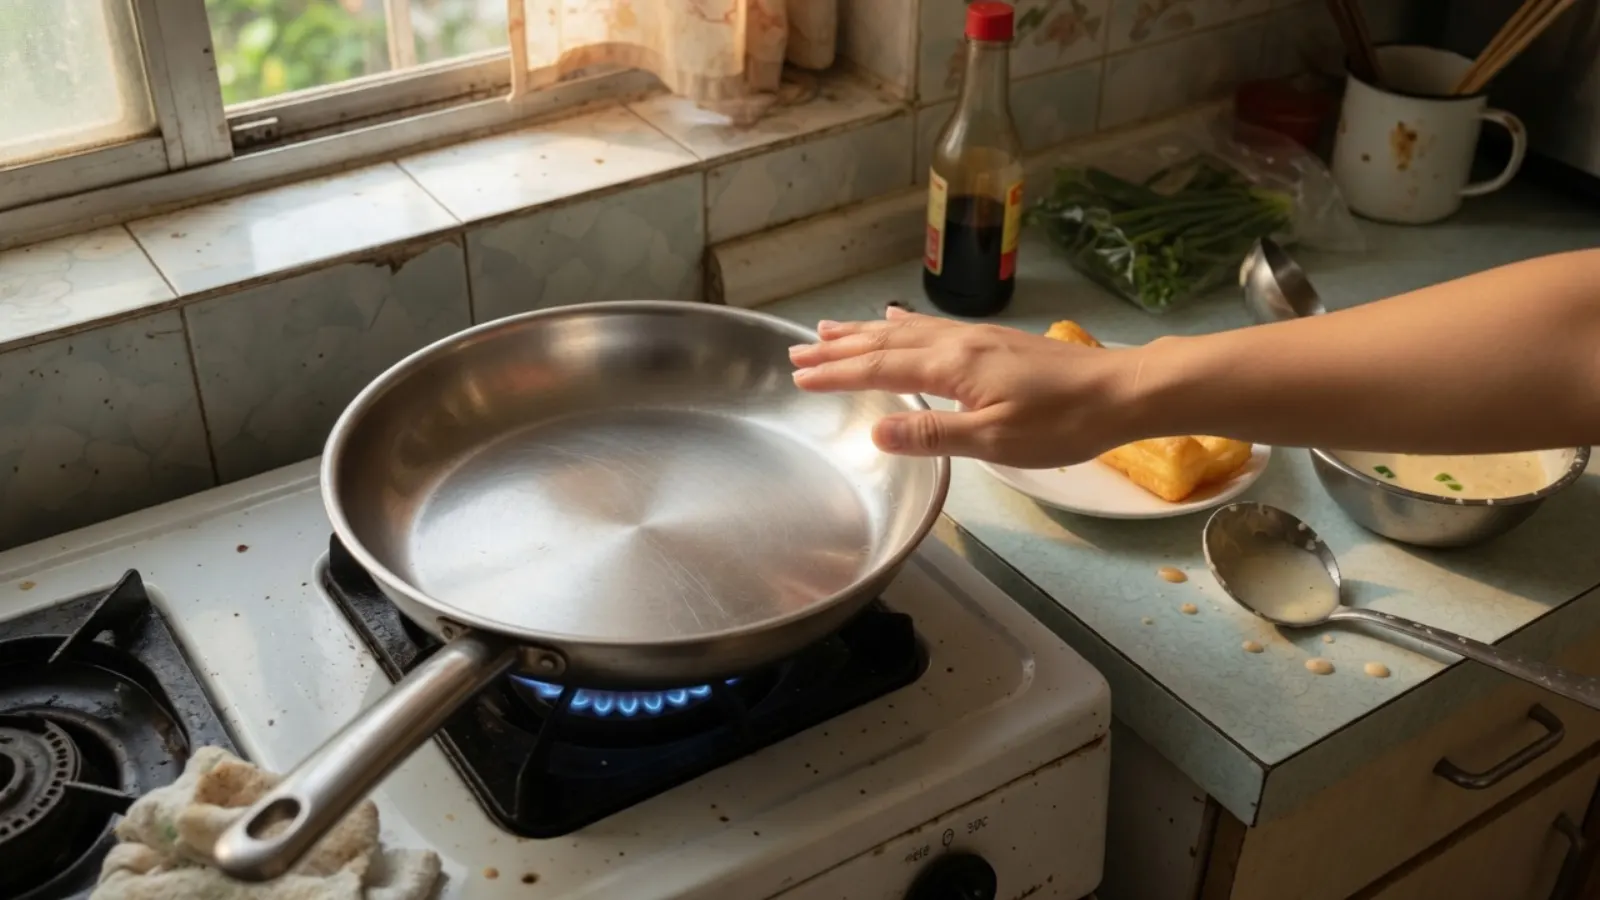
- Com só uma frigideira de inox, como diminuir a chance de grudar?
- A massa que sobrou, e um crepe pronto já pincelado com molho e recheado com presunto, ainda podem ser comidos no dia seguinte?
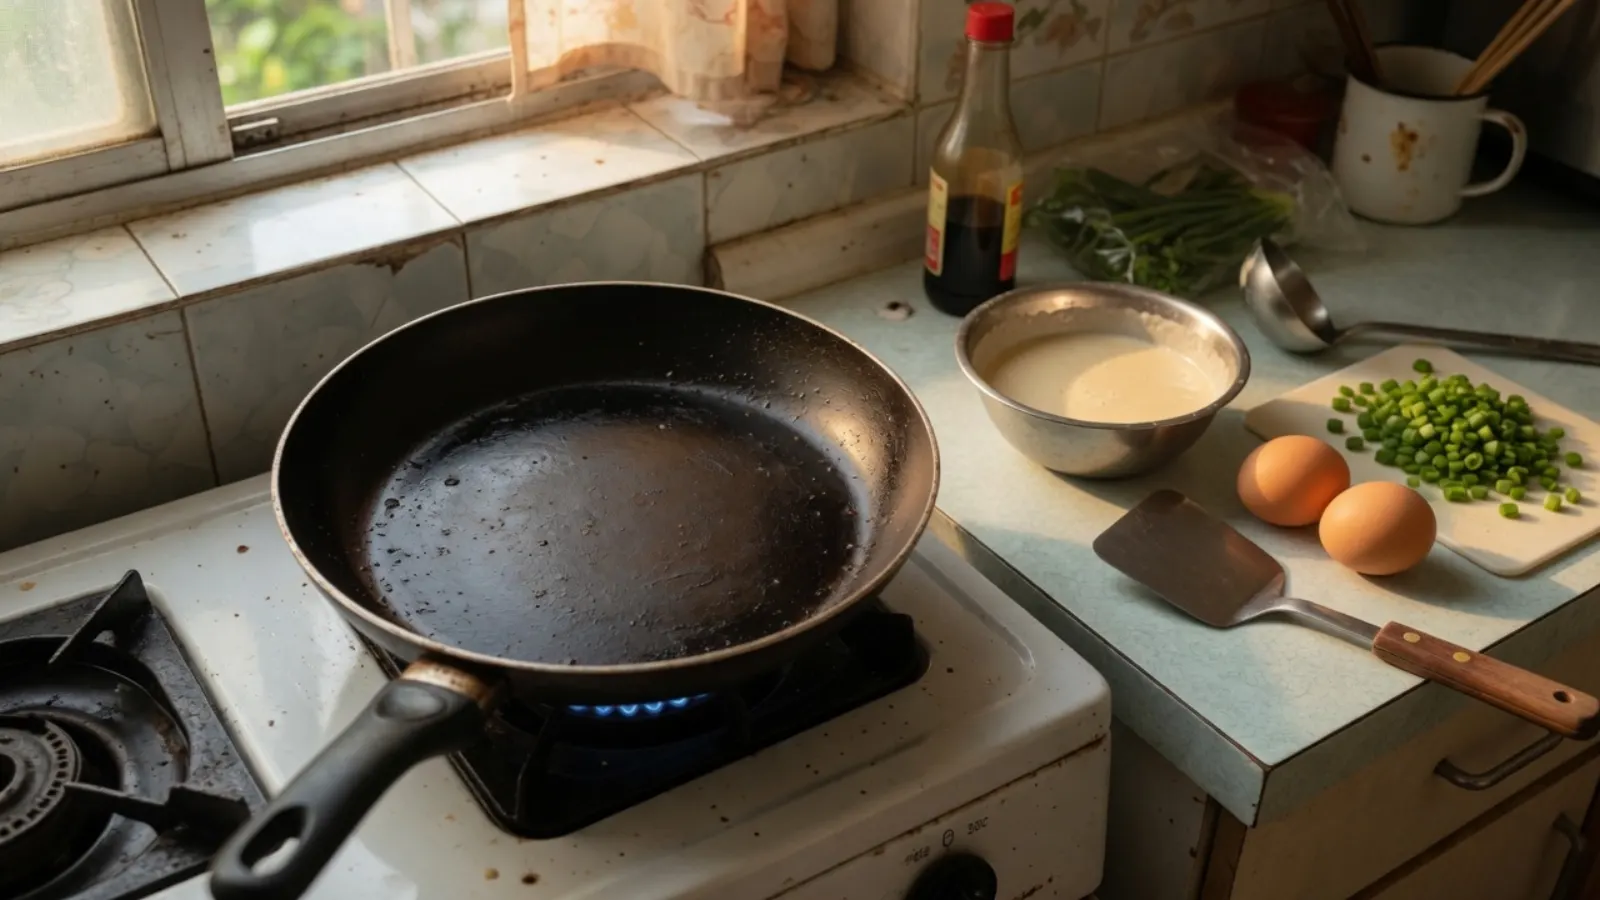
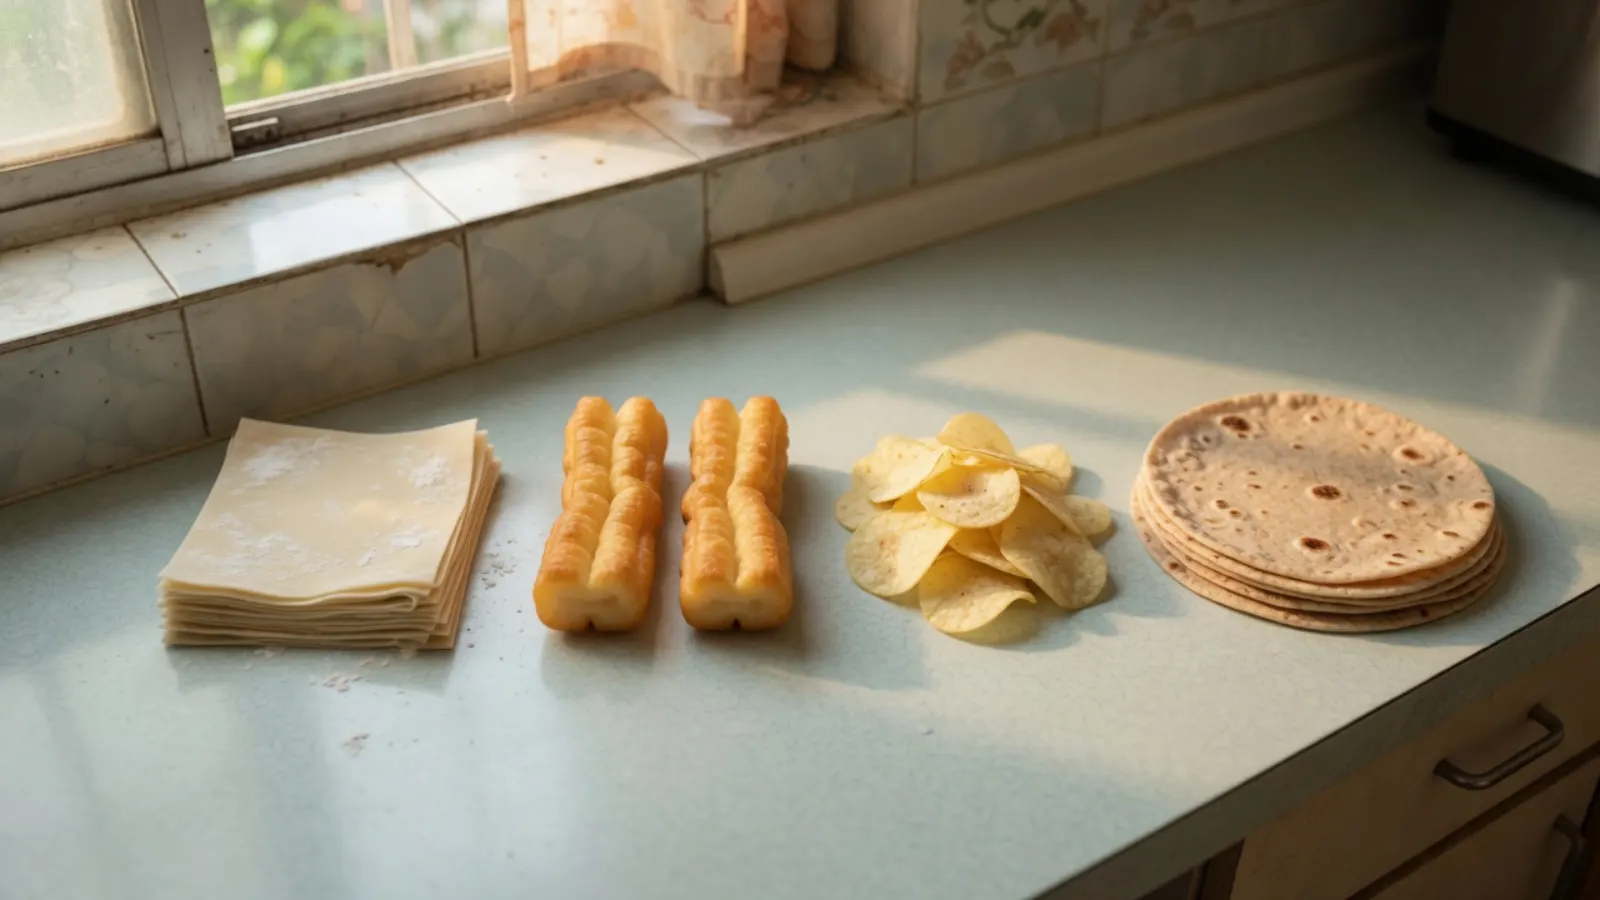
Perguntas assim pedem que o modelo lide ao mesmo tempo com ingredientes, utensílios, tempo, ordem, mudança de estado e risco. Não se trata de tirar conhecimento da memória. Trata-se de reconstruir a próxima ação a partir das condições que estão na sua frente.
Por isso a página não pede só “escreva uma receita de jianbing”. Ela divide a tarefa em 12 cenas: a primeira tentativa de um iniciante, a proporção da massa, um substituto para o biscoito crocante, o controle do fogo em frigideiras diferentes, o resgate de um crepe rasgado, ingredientes em falta, uma versão com menos óleo e menos pimenta para uma criança, um café da manhã em 20 minutos, o diagnóstico de uma falha, o ritmo para três pessoas, uma frigideira de inox e a conservação de um dia para o outro. Cada questão empurra o modelo para uma pergunta seguinte, mais próxima da vida real: quando as condições não são as ideais, você ainda consegue dizer qual é o próximo passo?
2. A linha que importa: detalhado não é o mesmo que confiável
O GLM 5.2 é um bom exemplo nesta rodada. Sua nota de procedimento chega a 90, o que significa que ele é bom em destrinchar um processo e bom em dar conselhos concretos para condições como “ingredientes insuficientes”, “quantidade para três pessoas de uma vez” e “como guardar a massa e o crepe pronto”. Para quem só olha o quanto o texto é completo, esse tipo de resposta recebe nota alta com facilidade.
A página também aponta que, na questão da frigideira de inox, ele sugere aquecer a frigideira “até sair fumaça azulada” e repetir a cura. Esse tipo de preaquecimento em fogo alto não é nada suave para uma casa comum. Quanto mais concreta é a ação numa resposta, maior a chance de o usuário fazer exatamente aquilo. Uma sugestão concreta que não combina com a situação transforma “parece profissional” num risco real.
O Kimi K2.7 Code mostra com ainda mais clareza por que a média não basta. Ele tem a nota mais alta em “o crepe rasgou, como salvo?”. Diante de uma frigideira em que o crepe já rasgou e o ovo ainda não firmou por completo, ele dá passos de resgate que parecem aplicáveis de verdade. Também traz detalhes úteis nas cenas da massa e das três pessoas.
Em “terminar em 20 minutos de manhã”, a página marca um risco grave de segurança alimentar que não pode ser ignorado: a resposta dá a entender que os ovos podem ser tirados da geladeira com antecedência e deixados em temperatura ambiente. Por melhores que sejam as outras respostas, esta deve ser mostrada à parte. Ela não deve ser compensada pela “nota mais alta na questão do resgate”.
Isso não quer dizer que toda sugestão do Kimi K2.7 Code seja pouco confiável, nem é um rótulo permanente de que sua capacidade em segurança alimentar é fraca. A afirmação precisa é: nesta rodada, nesta questão, nesta sugestão específica, apareceu um risco grave conforme definido pelas regras da página. Para o usuário, essa informação pesa mais do que uma posição geral que difere por poucos pontos.
3. Os quatro modelos parecem quatro ajudantes de cozinha diferentes
Sonnet 5: um ajudante mais firme para a primeira tentativa
A vantagem do Sonnet 5 não está em alguma questão espetacular. Nas 12 questões, ele é relativamente equilibrado. Fica à frente na primeira tentativa, no fogo da frigideira e no café da manhã de 20 minutos, e não aciona nenhum aviso de regra nem risco grave registrado na página.
Esse tipo de modelo combina com um usuário que ainda não formou o próprio julgamento na cozinha. Deixe que ele escreva primeiro o processo, a ordem e os pontos de decisão, e depois enxugue tudo de acordo com a frigideira e os ingredientes que você realmente tem. O limite dele também é claro. Conservação e diagnóstico de falhas não são as questões em que ele vai melhor. O tutorial traz muita informação, e antes de cozinhar de verdade você ainda precisa resumir a explicação longa em poucos passos que dê para consultar enquanto cozinha.
GLM 5.2: forte em destrinchar o processo, mas confira as dicas de fogo
O GLM 5.2 é bom em transformar condições complicadas numa lista. Em ingredientes em falta, várias porções e conservação, ele costuma dizer de forma bem completa o que falta, o que fazer primeiro, quando cuidar de cada coisa e como organizar o tempo.
Ele se parece mais com um ajudante bom em organizar processos. Ao usá-lo, confira as ações que envolvem fogo alto, preaquecimento, quantidade de óleo e conservação. Não pule o seu próprio julgamento sobre a frigideira de verdade e a cozinha da sua casa só porque a resposta parece um tutorial profissional.
Kimi K2.7 Code: o resgate se destaca, e as dicas de segurança precisam ser conferidas linha por linha
A vantagem do Kimi K2.7 Code se concentra em “algo já deu errado, e agora?”. Ele consegue ler o estado em que a frigideira está e oferecer um caminho de resgate mais específico do que “comece de novo”. Muitos modelos deixam isso passar, porque uma questão de resgate pede que o modelo aceite um estado intermediário imperfeito, em vez de recontar o processo-padrão.
Ao mesmo tempo, o risco grave na cena de preparo na véspera mostra que um modelo pode ser muito bom em produzir ações sem que essas ações tenham passado por um filtro de limite de segurança. Quando entram em jogo a conservação de alimentos, a refeição de uma criança ou o preparo de um dia para o outro, as dicas de segurança precisam virar uma lista de verificação à parte.
GPT-5.6 Terra: o tutorial básico é bom, e a solução de problemas é menos firme
O GPT-5.6 Terra tira 84,2 no primeiro tutorial completo. As proporções, a temperatura da frigideira e o processo básico estão escritos de forma bem completa. Para um pedido como “ainda não comecei, primeiro me dê o processo do início ao fim”, o ponto de partida dele não é ruim.
Na proporção da massa, no fogo da chapa elétrica e no diagnóstico de falhas, ele fica claramente para trás. Consegue escrever uma explicação introdutória com cara de completa e, ainda assim, não localizar qual variável deu errado depois que o usuário já falhou.
Essa é a diferença entre “sabe escrever um tutorial” e “sabe guiar alguém pela tarefa”. O primeiro só precisa organizar um caminho ideal. O segundo também precisa entender o que aconteceu depois que o caminho saiu do ideal.
4. Por que um risco grave não pode ficar escondido numa média
Um total tradicional traz uma tentação natural: somar a nota de cada questão e escolher a maior. Numa tarefa doméstica, o custo de erros diferentes não é o mesmo.
“Esta frase está um pouco prolixa” e “esta dica de conservação pode criar um problema de segurança alimentar” não deveriam se anular na mesma soma. “Não disse ao usuário como se recuperar” e “deu uma ação agressiva demais em fogo alto” não deveriam ser tratados como dois descontos comuns.
Esta rodada já faz algo importante. Além da média por regras, a página marca à parte os avisos de regra e os riscos graves. Vale manter essa estrutura, e ela pode crescer até virar três camadas de resultado:
- Nota de conclusão da tarefa: o usuário consegue chegar ao objetivo seguindo a resposta?
- Nota de qualidade do processo: os passos, a explicação, a adaptação às condições e o resgate estão claros?
- Rótulos de risco que não podem ser compensados: apareceu algum problema de segurança alimentar, ação perigosa ou conselho que viola claramente uma restrição da questão?
Para um usuário real, muitas vezes é a terceira camada, antes da primeira, que decide “tenho coragem de seguir isto?”.
5. O que esta rodada oferece ao usuário comum?
Ela não aponta um modelo que seja o melhor em todas as questões de cozinha. Oferece uma forma mais prática de escolher.
- Para uma primeira tentativa, com menos tropeços: olhe primeiro as respostas que são firmes no geral e não acionaram nenhum risco.
- Quando os ingredientes à mão estão incompletos: veja se o modelo refaz o plano em torno do que você tem, em vez de insistir na fórmula-padrão.
- Quando o crepe já rasgou ou grudou: olhe o diagnóstico da falha e os passos de resgate. Não olhe só se o tutorial básico está bem escrito.
- Quando há uma criança, conservação de um dia para o outro ou fogo alto envolvidos: confira primeiro os rótulos de risco, depois a nota total e a qualidade do texto.
- Quando precisa ficar pronto em 20 minutos: veja se o modelo separa uma parte que pode ser preparada na noite anterior e se ele explica com clareza as condições de conservação.
Uma forma mais segura de usar a resposta é tratá-la como um primeiro rascunho de plano e então fazer mais três perguntas:
- Em que minha frigideira e meus ingredientes diferem das condições-padrão?
- Se uma falha específica aparecer no meio do caminho, em qual passo devo parar ou mudar?
- Esta sugestão envolve alguma questão de segurança alimentar que precisa ser conferida à parte?
Quanto mais concreto o modelo, mais vale fazer essas perguntas. Uma resposta concreta de fato é mais fácil de executar, e também facilita embrulhar uma ação errada numa instrução com cara de profissional.
6. Uma tarefa do dia a dia não se testa bem perguntando só se parece a resposta certa
O que esse conjunto de questões sobre jianbing sugere para o Folkbench não é acrescentar mais receitas depois. É que “se uma tarefa do mundo real pode de fato ser executada” pode continuar crescendo como uma linha de avaliação própria.
Uma boa avaliação de tarefa do dia a dia deveria deixar registradas pelo menos quatro coisas antes de começar:
- De que condições o usuário parte.
- Qual é o padrão mínimo de sucesso.
- Quais erros podem ser compensados por um resgate.
- Quais riscos, quando aparecem, precisam ser marcados à parte.
O critério de avaliação também deveria ser congelado antes de alguém olhar a saída do modelo. Caso contrário, uma frase agradável de um modelo vira, de última hora, um item de “expressão natural”, uma sugestão perigosa de outro modelo vira, de última hora, um aumento do peso da segurança, e ninguém consegue conferir o boletim.
Esta rodada já tem uma boa base: as mesmas cenas, as mesmas exigências de saída, promptHashes correspondentes e notas gerais mostradas junto com as marcas de risco. O que mais vale aperfeiçoar agora é guardar separadamente a média, o teto numa única questão, o tipo de falha e os riscos graves, para que o leitor saiba tanto como o modelo se saiu no geral quanto onde ele tem mais chance de decepcionar.
Para fechar: um modelo útil de verdade precisa acompanhar você no passo que não sai bem
Escrever uma receita completa é a capacidade de organizar a linguagem. Ajustar o plano à frigideira, aos ingredientes e ao tempo é a capacidade de entender condições. Dizer ao usuário como continuar depois que o crepe rasgou é julgamento de estado e recuperação de erros. Parar com clareza quando surge a conservação de um dia para o outro é um limite de segurança.
Somadas, essas quatro coisas chegam mais perto do que uma pessoa comum quer dizer com “este modelo é útil de verdade”.
Por isso, a conclusão que mais vale guardar desta rodada de jianbing não é quantos pontos o Sonnet 5 tem a mais que o GPT-5.6 Terra, nem quem consegue vencer todas as questões de cozinha doméstica. É esta: a avaliação de uma tarefa real precisa deixar aparecer, ao mesmo tempo, “dá para fazer?”, “dá para salvar quando algo dá errado?” e “há algum risco inaceitável?”.
Limites do teste
Este artigo foi escrito com base nas cenas e nos resultados da V1 publicados atualmente na página do Folkbench. A amostra é de 12 questões de cozinha doméstica e 48 resultados com promptHash correspondente. As notas por regras servem apenas para comparar resultados neste mesmo conjunto de questões. Elas não substituem orientação profissional de segurança alimentar e não sustentam nenhuma afirmação sobre a capacidade geral de um modelo em todas as tarefas culinárias. Quando entram em jogo conservação, refeição infantil ou fogo alto, o usuário ainda deve julgar por conta própria, com base nos alimentos reais, nos utensílios reais e nas exigências locais de segurança alimentar.


