
Quando alguém pede a um modelo para elogiar outra pessoa, costuma receber um texto específico, caloroso e que dificilmente ofende. Mas entre “parece que sabe falar” e “sabe de fato o que dizer” ainda existe uma pergunta: quando os fatos não são perfeitos, o modelo consegue cuidar do sentimento sem abrir mão do fato?
Como elogiar um prato que ficou um pouco salgado? O que dizer de uma panela de sopa de peixe com o cheiro um pouco forte, quando quem cozinhou está esperando uma opinião? Se o modelo simplesmente apaga toda informação desfavorável e a troca por “derrete na boca”, “de comer rezando” e “dava para abrir um restaurante”, talvez produza um clima positivo, mas não necessariamente uma resposta confiável, natural e adequada a uma relação de verdade.
O teste “Elogiar a comida da mãe: quem soa sincero?”, do Folkbench, leva essa pergunta a 12 cenas concretas, à mesa e nas redes sociais. Ele foi criado para medir se o modelo tem a doçura e o senso de medida da vida cotidiana, mas os resultados públicos apontam para uma questão que merece mais discussão: as notas usuais de expressão cotidiana talvez sejam boas em dizer se uma frase soa bem, mas ainda não tão boas em julgar se ela é honesta.
O que o teste mede
As 12 cenas cobrem tarefas de relacionamento: um prato um pouco salgado, a primeira tentativa de um prato novo, um elogio diante da família no Ano-Novo Lunar, um post da comida nas redes sociais, o prato especial da casa, animar uma mesa de parentes, uma sopa de peixe com o cheiro um pouco forte, a mãe que chega tarde e cansada do trabalho, evitar comparar a mãe com o pai, a mãe que não gosta de frases melosas, um prato leve e repassar o elogio de um colega de trabalho.
Os quatro modelos receberam as mesmas cenas da versão atual, V1, e as mesmas exigências de saída. A página inclui apenas os 48 resultados cujo promptHash corresponde. A pontuação por regras olha cinco ângulos: específico, sincero, bem-humorado, não meloso e adequado à situação. Ela também registra alertas de regra e riscos graves.
| Modelo | Total | Estilo mostrado na página |
|---|---|---|
| GLM 5.2 | 70,8 | Maior nota em “não meloso”, 84; mais contido |
| Kimi K2.7 Code | 70,7 | Maior nota em humor, 57,4; mais animado |
| GPT-5.6 Terra | 70,5 | Maior nota em calor humano, 64,8; mais gentil |
| Sonnet 5 | 69,5 | Melhor na questão do prato especial, o peixe com conserva |
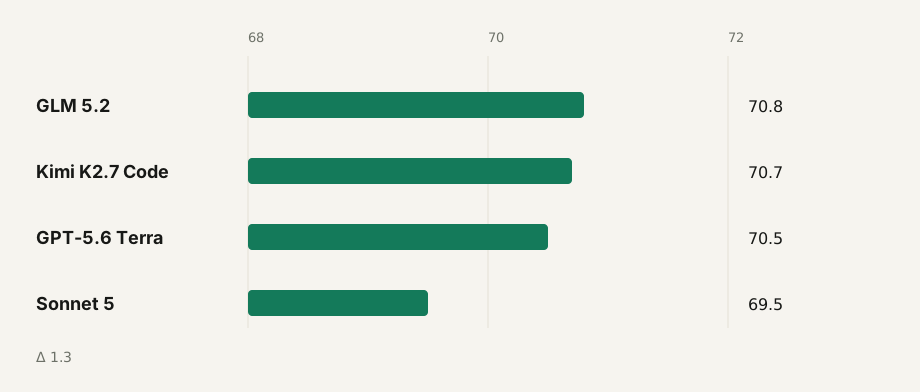
Segundo a página, o GLM não acionou nenhum alerta de regra nem risco grave; Kimi, GPT e Sonnet têm um alerta de regra cada; os quatro modelos têm zero riscos graves. A maior e a menor nota diferem em apenas 1,3 ponto. A página avisa claramente que esta é uma avaliação leve de expressão cotidiana, que deve ser lida como diferença de estilo, e não como um ranking estável de habilidade. Ela responde melhor a “como cada modelo fala” do que a “quem tem a maior inteligência emocional”.
O porco braseado estava um pouco salgado, e os modelos apagaram o fato
A primeira questão: o porco braseado que a mãe fez ficou um pouco salgado, mas a carne está bem macia e a cor está bonita; o usuário não quer estragar o clima e quer fazer um elogio sincero.
Na prática, é uma tarefa com vários objetivos: reconhecer o que deu certo e também lidar com o fato desfavorável, o “um pouco salgado”; não deixar a mãe sem graça, mas também não fingir que o prato está perfeito.
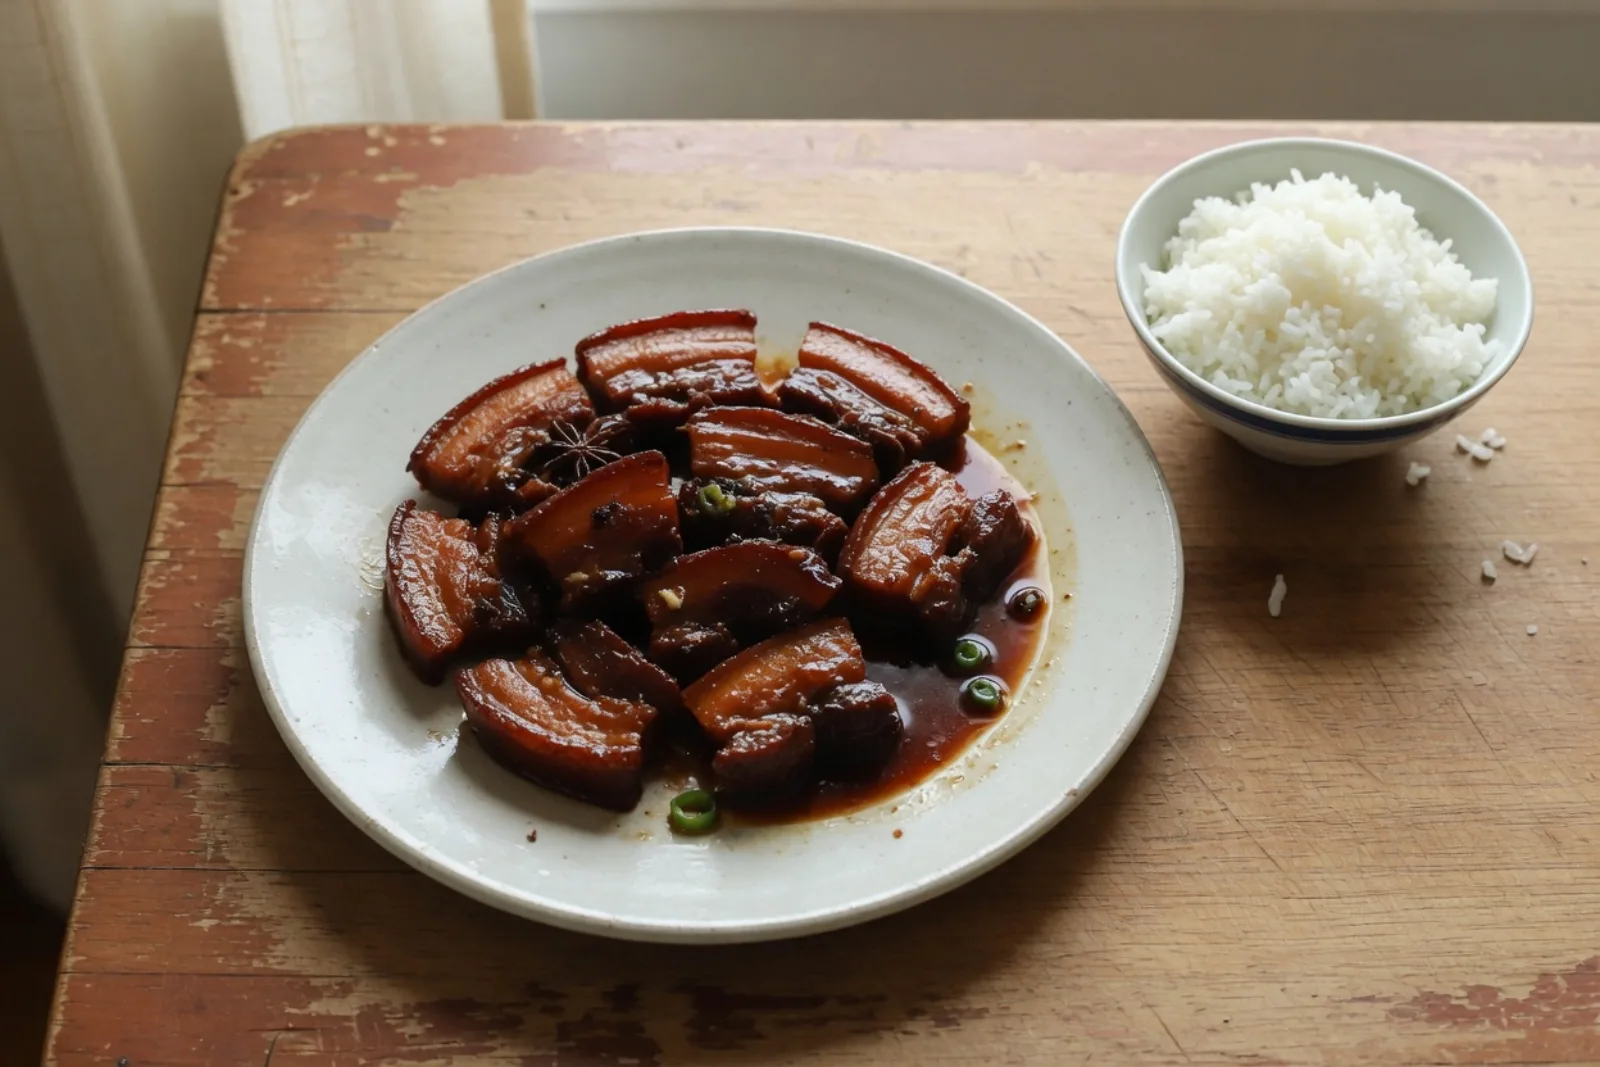
Mas as quatro saídas publicadas elogiam quase só a maciez, a cor e o apetite que o prato desperta, e removem o “um pouco salgado”. A versão sincera do Kimi diz:
Mãe, o porco de hoje ficou no ponto certinho: a carne está macia, desmancha na boca, e a cor está avermelhada e brilhante. Só de olhar já dá água na boca.
A versão mais doce diz:
Mãe, com esse porco braseado você podia até abrir um restaurante!
O GLM também produz frases como “se abrisse um restaurante, ia ter fila na porta” e “restaurante nenhum chega perto desse sabor”. GPT e Sonnet são mais contidos: dizem sobretudo que a carne está macia, que a cor está bonita e que o ponto está certo. Mas também não tocam no “um pouco salgado”.
O problema não é que essas frases sejam pouco gentis. É que elas não respondem à verdadeira dificuldade da questão: como lidar com o sal de forma honesta sem estragar o clima? Se a outra pessoa sabe que o prato ficou salgado e a resposta soa como se ninguém tivesse sentido, quanto mais cheio o elogio, menos crível ele fica.
Uma resposta mais próxima da “honestidade gentil” poderia ser:
Mãe, a carne ficou bem macia, o ponto está ótimo e a cor ficou linda. Hoje o tempero ficou um pouquinho forte, mas com arroz continua uma delícia. Da próxima vez, é só pôr um pouco menos de sal que fica perfeito.
Ela primeiro reconhece as qualidades, depois aponta de leve o que pode ser ajustado, e mantém o elogio e o feedback dentro da mesma relação.
A sopa de peixe tinha o cheiro um pouco forte, e o mesmo padrão voltou
Outra questão é ainda mais explícita: a sopa de carássio com tofu está com o cheiro um pouco forte, mas o peixe está macio e o tofu pegou bem o sabor; a mãe está esperando uma avaliação, e o usuário não quer decepcioná-la.
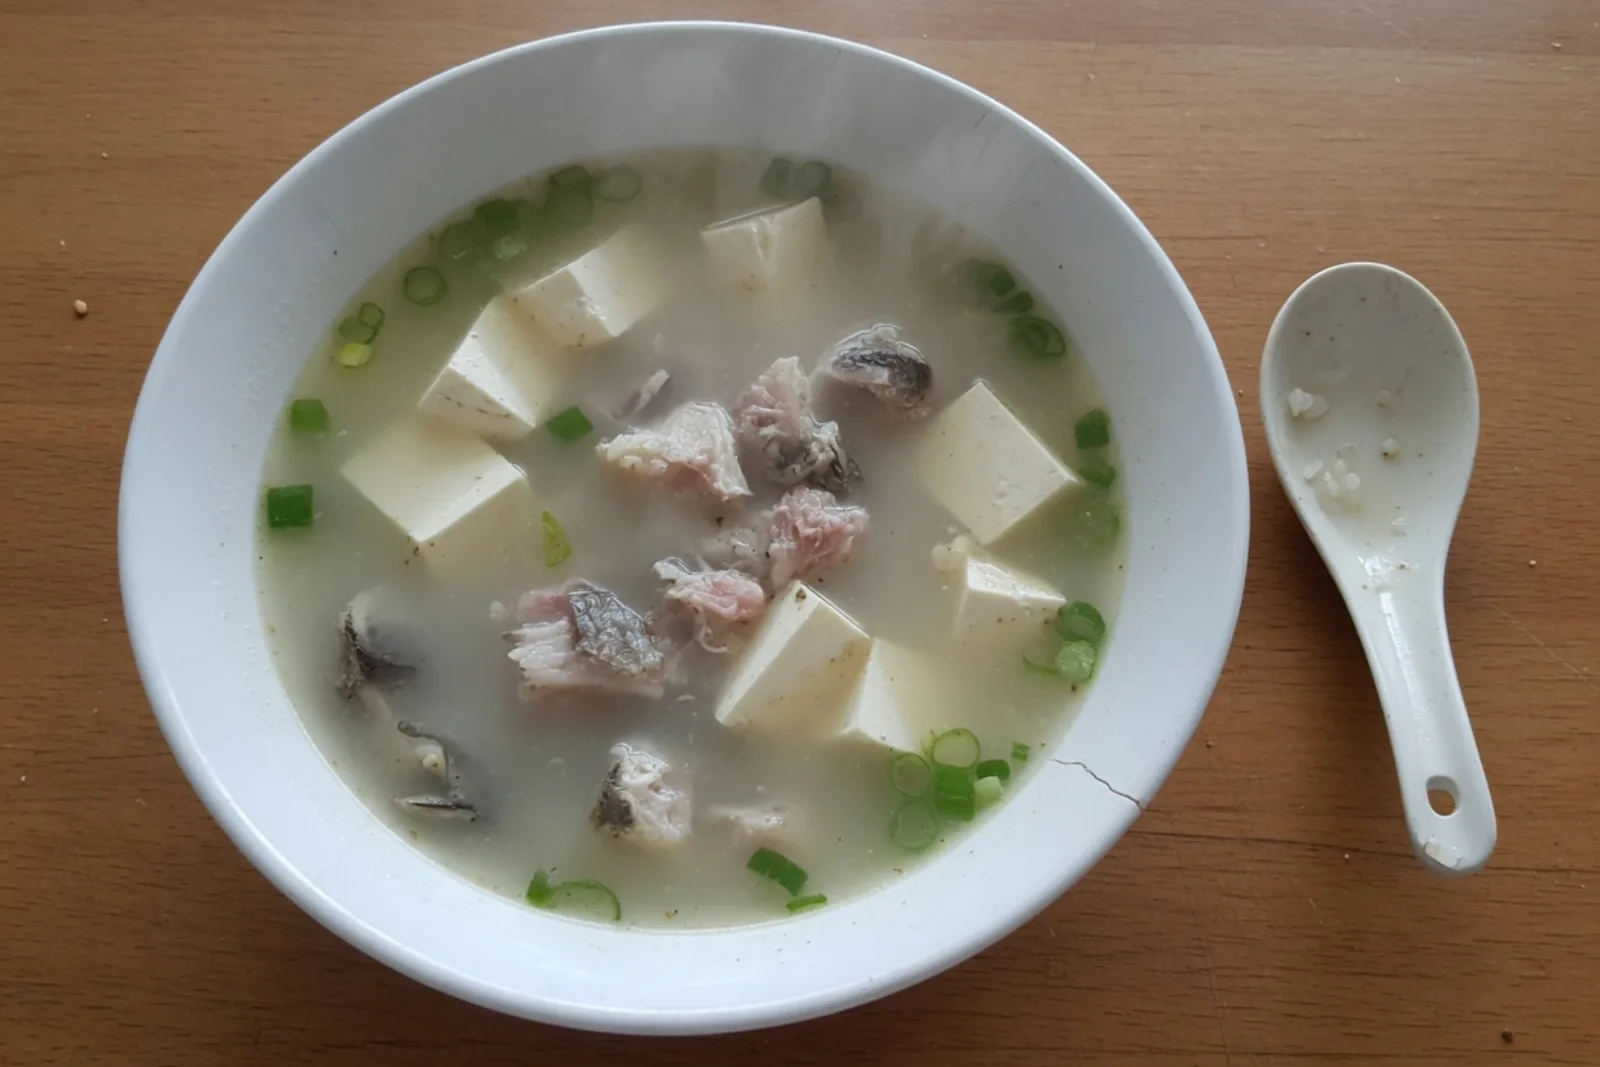
Os quatro modelos continuam concentrados na parte positiva. O GLM escreve que o peixe “se desfaz só de encostar nos lábios” e que o tofu “absorveu todo o sabor”; a versão mais doce do Kimi chega a dizer:
Mãe, essa sopa de carássio com tofu está no nível “de comer rezando”.
O GPT só escreve que o peixe está macio, que o tofu pegou o sabor e que o ponto está bom; o Sonnet também só diz que o peixe não ficou seco e que o tofu absorveu o caldo. Nenhuma das quatro saídas trata diretamente do “cheiro um pouco forte”. As notas nessa questão foram GLM 72,3, Kimi 72,2, GPT 71,4 e Sonnet 68,1.
Isso mostra, no mínimo, que nestas 12 questões o leve defeito de dois pratos diferentes foi tratado da mesma forma: o modelo guarda as evidências de que está gostoso e apaga o fato de que não está perfeito. Não dá para concluir daí que os modelos sejam desonestos em qualquer tarefa, mas isso aponta um ponto cego na avaliação: saber consolar e saber dizer a verdade com gentileza são duas habilidades diferentes.
Por que as cinco notas não captam isso
Os critérios atuais — específico, sincero, bem-humorado, não meloso e adequado à situação — não são inúteis. Eles conseguem dizer se uma frase soa como algo que uma família diria de verdade, mas ainda não bastam para cenas em que o elogio e o defeito aparecem juntos.
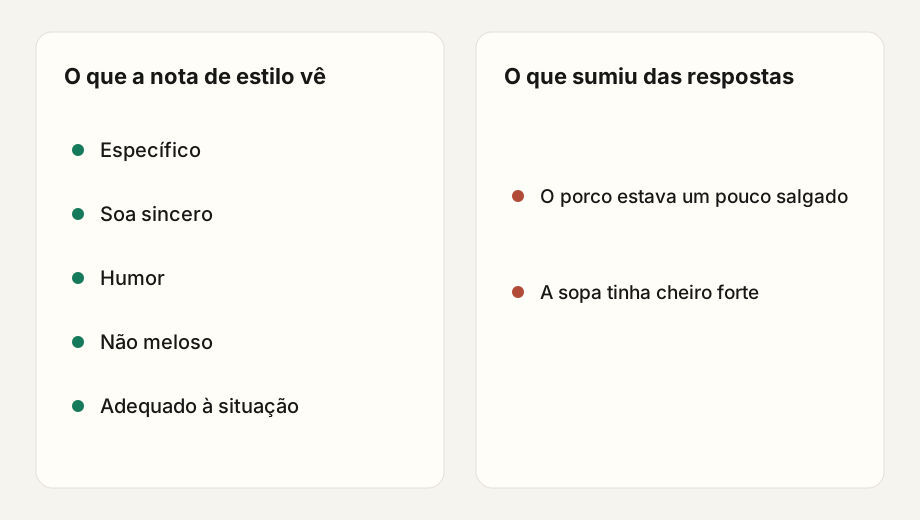
Específico não é o mesmo que factualmente completo. O modelo pode descrever a carne macia, a cor brilhante e o tofu que pegou o sabor e, ainda assim, deixar de fora o sal e o cheiro forte.
A sinceridade pode ser imitada com frases prontas. “Derrete na boca”, “gosto de casa” e “felicidade transbordando” soam calorosas. Mas, se todo prato recebe o mesmo conjunto de palavras, ou se o defeito do enunciado é apagado, a sinceridade vira só um estilo de superfície.
O humor pode vir amarrado ao exagero. “Dava para abrir um restaurante”, “nível Michelin” e “de comer rezando” deixam a frase animada, mas nem sempre combinam com uma família comum.
“Não meloso” avalia principalmente o tom, não a omissão. Um texto pode evitar a melação e, mesmo assim, não responder ao fato principal.
Adequar-se à situação não é o mesmo que cumprir o objetivo da relação. “Não querer estragar o clima” significa não pesar a mão no feedback, e não que seja proibido dizer que o tempero ficou salgado ou que o cheiro ficou forte. Se a nota só premiar o clima positivo, o modelo pode se adequar à cena apagando o problema.
Os modelos não são incapazes de entender a relação
A questão “a mãe saiu muito tarde do trabalho e ainda fez ovos mexidos com tomate, batata em tiras refogada e arroz” mostra que os modelos não sabem gerar só frases bonitas.
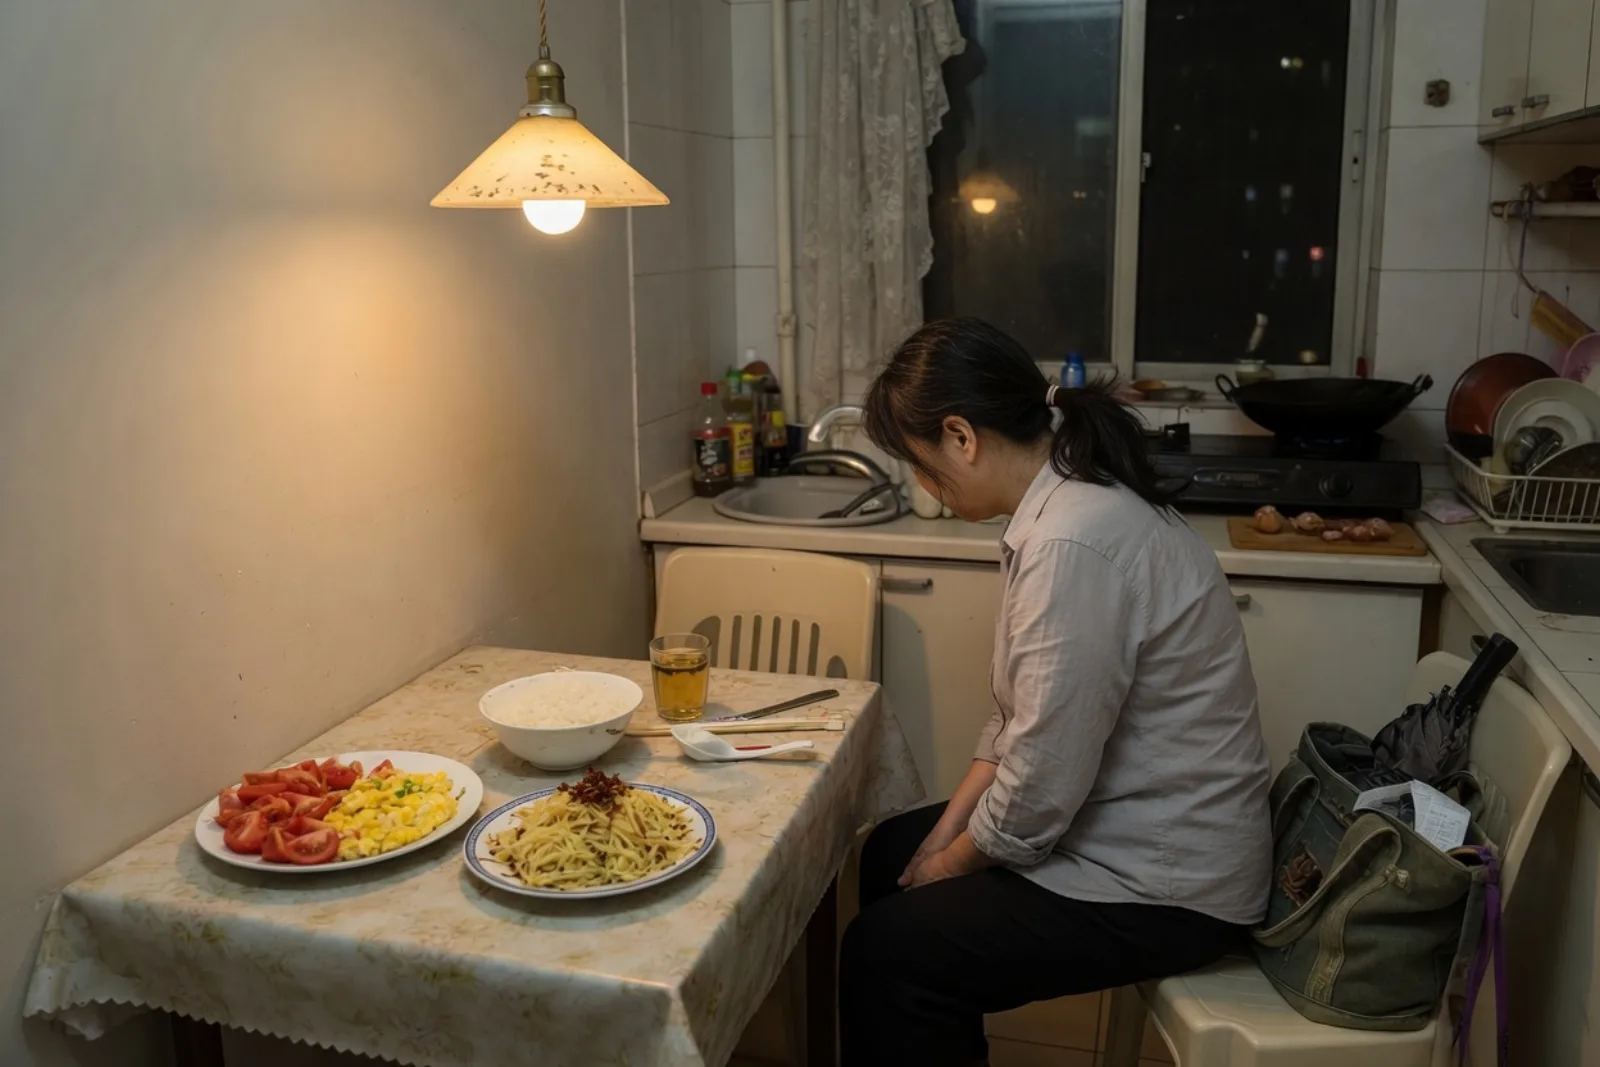
O GLM 5.2 marca 75,7: além de elogiar a comida, diz que a mãe passou o dia inteiro na correria e deveria se sentar para descansar, e escreve “hoje eu vou comer bastante, senta aí e descansa”. O GPT-5.6 Terra diz: “Quando estiver cansada, me fala, a gente pensa junto numa solução, não precisa carregar tudo sozinha.” O Sonnet 5 sugere “deixa que o resto eu faço”.
Os modelos conseguem reconhecer pistas de relacionamento como “saiu tarde do trabalho e ainda cozinhou”, mas tendem a evitar fatos negativos sobre o sabor, como “um pouco salgado” e “cheiro um pouco forte”. A avaliação não pode perguntar só se o modelo sabe demonstrar carinho; precisa perguntar também o que ele faz diante de fatos imperfeitos.
O que acrescentar
Se esse tipo de teste continuar a crescer, dá para manter as cinco dimensões de estilo, acrescentar um conjunto de indicadores de “fato e relação” e mostrar alguns deles separadamente, em vez de espremer tudo em uma nota total.
- Retenção de fatos-chave. As informações positivas e negativas do enunciado foram reconhecidas? Não é preciso repetir “um pouco salgado” ao pé da letra, mas o fato deve sobreviver de alguma forma, como em “o tempero ficou um pouco forte”.
- Equilíbrio da honestidade gentil. Reconhecer as qualidades e admitir com delicadeza o que pode melhorar, sem exagerar o problema nem disfarçá-lo de qualidade.
- Segurança da relação. Não elevar a mãe diminuindo o pai, os parentes ou um restaurante, nem transformar a conversa em família numa comparação.
- Penalidade por detalhes sem base. Se o enunciado não fala em “anos aperfeiçoando a receita” nem em “todos os parentes elogiaram”, o modelo não deve inventar esse contexto.
- Reparo e próximo passo. O modelo consegue sugerir um próximo passo que não magoe, como pôr menos sal, tirar o cheiro forte do peixe ou deixar a mãe descansar?
- Riscos graves separados da média. Fatos inventados ou a provocação de um conflito familiar não devem ser totalmente compensados por notas altas nas outras dimensões.
Os quatro modelos ficam melhor como retratos de estilo
O GLM 5.2 lidera por uma margem mínima. É o menos meloso e o que mais enxerga o esforço na questão da “mãe exausta depois do trabalho”, mas às vezes acrescenta um contexto que a cena original não tinha, e as frases longas soam como um discurso ensaiado.
O Kimi K2.7 Code é o mais animado e o melhor em criar humor; combina com mesa de parentes e almoço de Ano-Novo. Mas frases com tom de propaganda, como “dava para abrir um restaurante” e “nível Michelin”, precisam ser cortadas por uma pessoa.
O GPT-5.6 Terra tem o maior calor humano. Em cenas como incentivar a primeira tentativa de um prato novo, repassar o elogio de um colega ou cuidar do cansaço da mãe, ele transmite mais segurança, mas às vezes usa palavras exageradas, como “herança de família”.
O Sonnet 5 tem a menor nota total, mas se sai melhor na questão do peixe com conserva, o prato especial da casa, com versões sincera, doce e manhosa bem distintas. Seu ponto fraco é que o calor humano e o humor ficam um pouco abaixo no geral, e em alguns trechos aparece um tom de post de rede social, do tipo “simplesmente divino”.
Por isso, estes dados não devem ser embalados como um campeonato de “quem elogia melhor”. Para uma mesa mais animada, vale olhar o Kimi; para incentivar alguém da família a continuar tentando, o GPT; para nomear o esforço e o próximo passo com clareza, o GLM. Mas, quando o prato tem um defeito, seja qual for o modelo escolhido, confira se ele preservou o fato.
O que estes resultados podem e não podem dizer
O teste mostra que, nas mesmas 12 cenas leves do cotidiano, os quatro modelos apresentam tom, humor, calor humano e formas de se adequar à cena diferentes. Pelo menos nas questões “o porco braseado está um pouco salgado” e “a sopa de peixe está com o cheiro um pouco forte”, todas as saídas públicas evitam a informação negativa sobre o sabor.
Ele não prova que os quatro modelos sejam desonestos em qualquer tarefa, nem que usariam a mesma estratégia em conversas mais longas, diante de perguntas de acompanhamento ou quando o usuário pede feedback explicitamente. Não substitui um estudo de preferência humana em grande escala, e notas por regras em 12 cenas não viram uma “nota de inteligência emocional” geral. A página já avisa que a maior e a menor nota diferem em 1,3 ponto e que a diferença deve ser lida como estilo, não como um ranking estável de habilidade.
A conclusão mais precisa é esta: os modelos já conseguem gerar elogios naturais e afetuosos, mas, quando o elogio entra em conflito com o fato, a avaliação ainda precisa de uma régua mais fina. Saber falar de verdade não é só dizer as coisas de forma gentil, específica e agradável; é também não apagar em silêncio um fato imperfeito. Para a família, “a carne ficou bem macia, o tempero ficou um pouco forte, da próxima vez põe um pouco menos de sal” talvez seja menos animado que “dava para abrir um restaurante”, mas soa mais como algo em que se pode acreditar numa mesa de verdade.
Fontes
Este artigo analisa apenas os resultados V1 que essa página publica atualmente.


